Start / Magazin / KI, Automatisierung & Reporting
Nano Banana 2.1 im Test: Etiketten, Gesichter, Text im Bild
ArtikelKI, Automatisierung & Reporting07.10.2026/img/magazin/nano-banana-2-1-test-etiketten-gesichter-text-im-bild.webp Mario WormuthSEO, GEO & KI-Automatisierung
36 Min. Lesezeit
Alles auf einen Blick
- Nano Banana 2.1 ist seit 06.10.2026 verfügbar, basiert auf Gemini 3.6 Flash und ersetzt Nano Banana 2. Das alte Modell gemini-3.1-flash-image schaltet Google am 29.10.2026 ab.
- In meinem Test (80 Punkte ohne die Etikett-Aufgaben) liegen Nano Banana 2 (75), Pro (79) und 2.1 (75) eng beieinander. Bei Text und Produkttreue sehe ich für 2.1 keinen Sprung. Googles eigene Zahlen und die vorläufige Arena sehen 2.1 vorn, dort geht es aber um Gesamteindruck.
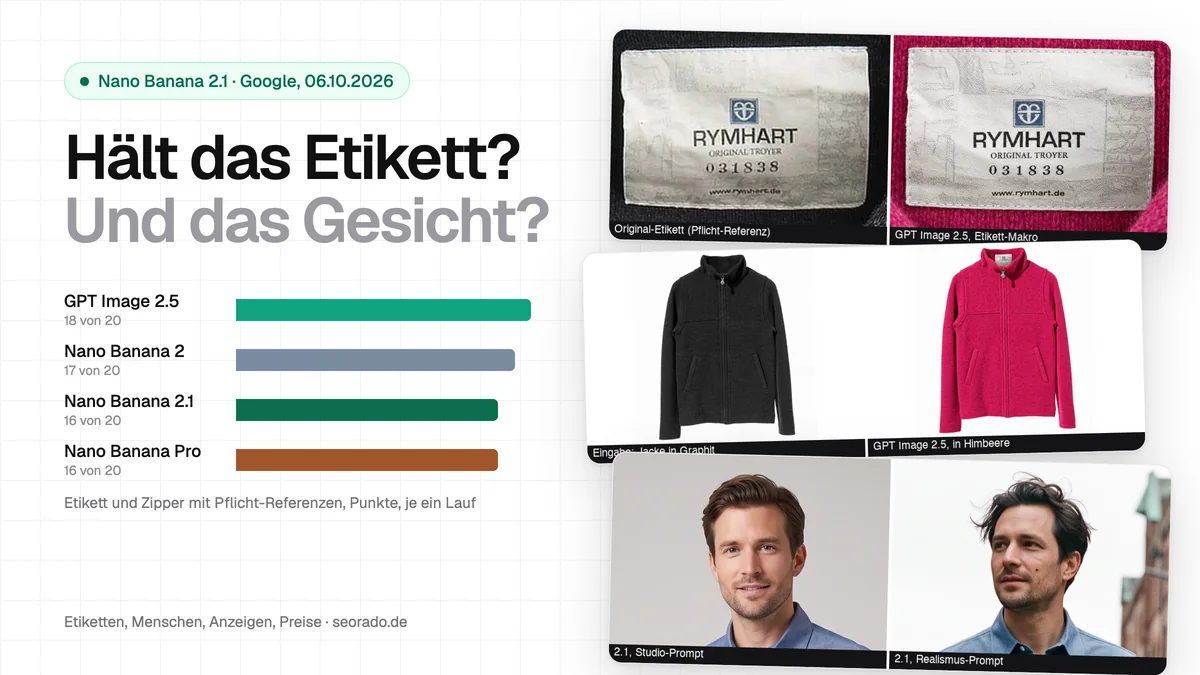
- Etikett und Logo: Mit einem Foto und einem Prompt stimmen bei keinem Modell Schrift und Emblem, auch wenn die Wörter oft stimmen (erster Test, auch bei GPT Image 2.5). Mit Pflicht-Referenzen, fester Regel und Makro klappt es: Etikett-Makro und Zipper-Makro sind bei allen vier getesteten Modellen neben dem Original nicht auffällig (GPT Image 2.5 Sunburst, Nano Banana 2.1, Nano Banana 2, Pro).
- Die Ganzansicht bleibt das Problem: Mit denselben Referenzen trifft GPT Image 2.5 Sunburst das Etikett im Ganzbild fast (6 von 8 Punkten für Etikett und Zipper), die Google-Modelle erreichen 4 bis 5. Ein Buchstabe fehlt auch bei GPT („ORIGNAL“). In Magnific kostet GPT 600 statt 100 Credits.
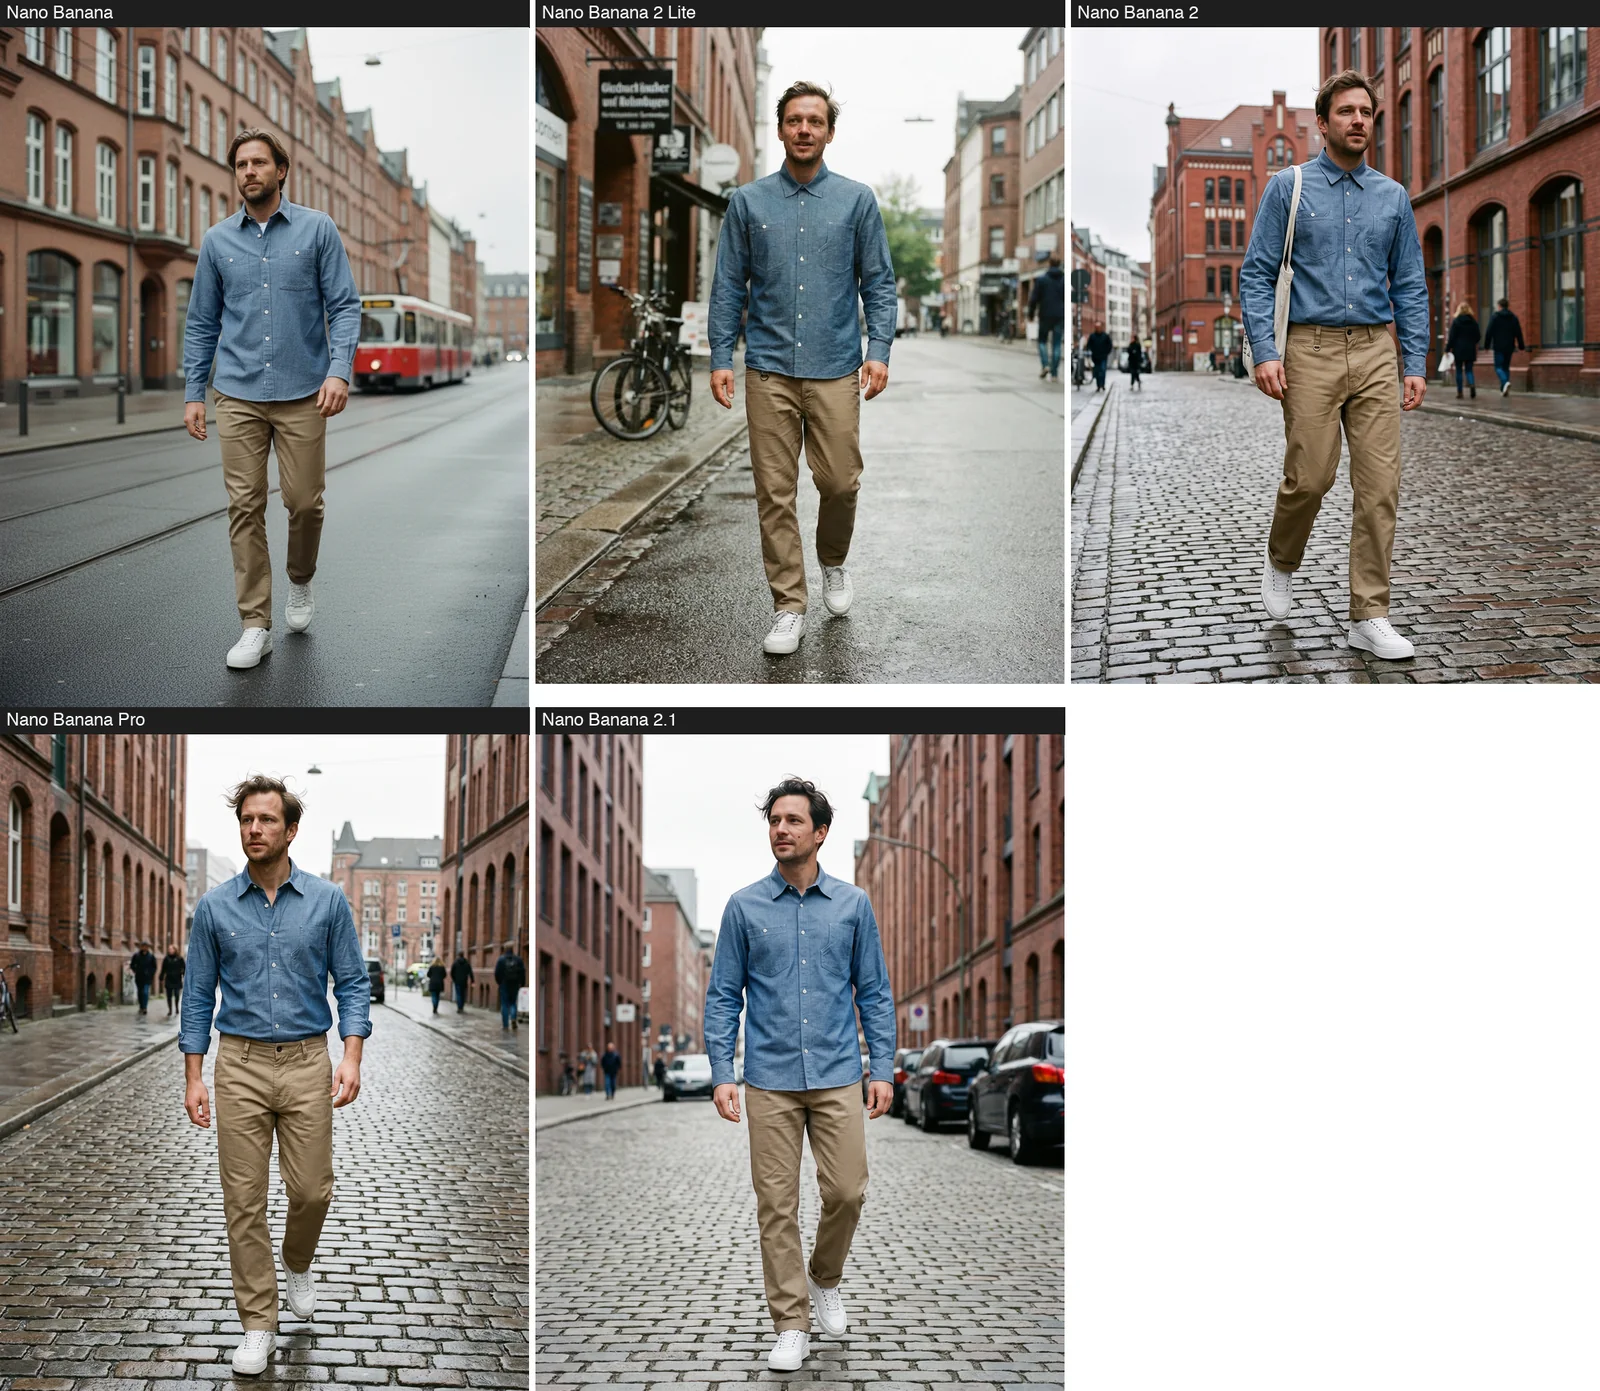
- Menschen: Ein Studio-Prompt liefert bei allen Modellen glatte Katalog-Gesichter. Derselbe Auftrag mit Straße, Bartschatten, losen Strähnen, Filmkorn und „keine Retusche“ liefert Bilder, die für mich deutlich weniger plastisch wirken.
- Der API-Preis halbiert sich: 0,0336 $ je 1K-Bild gegen 0,067 $ bei Nano Banana 2. Bei 4K korrigierte Google den Preis am 07.10. von 0,0756 $ auf 0,113 $. In Magnific kostet 2.1 mit 100 Credits dagegen ein Drittel mehr als Nano Banana 2 und Pro mit je 75.
- RYMHART ist mein Testfeld, kein Praxisfall: Produkt- und Personenfotos entstehen dort nach wie vor in echter Handarbeit, der Fotograf arbeitet im Haus, KI-Bilder kommen dafür aktuell nicht zum Einsatz. Ich nehme die Produkte, weil Logos und Details ein hartes Testbeispiel sind und ich dafür kein fremdes Material brauche. Ich selbst nutze KI-Bilder dagegen immer, wo kein echtes Produkt und kein echtes Gesicht stimmen muss. Mein Test bestätigt die Grenze zum Teil: Makros gelingen, die Ganzansicht und Menschen nicht fehlerfrei.
- Für Blog, Magazin, Webseite und YouTube gilt dasselbe wie für Shops: Layouts, Infografiken und Titelbilder gelingen gut, ein exakter Satz im Bild nicht. Beim Thumbnail-Test schrieb nur Pro den ganzen Satz fehlerfrei, 2.1 hängte ein Ausrufezeichen an und verformte ein K.
- Nano Banana 2 erfand in meinen Anzeigen eine Zeile („Handarbeit aus dem Norden. 100% Wolle.“) und schrieb einmal „SOMNTAG“. Prüfe KI-Anzeigen auf Aussagen, die du nicht beauftragt hast.
Inhaltsverzeichnis13 Abschnitte
- Was Google am 06.10. gebracht hat
- So habe ich getestet
- Befund 1: Logo und Schrift stimmen nur mit der richtigen Methode
- Befund 2: Menschen, die nicht plastisch aussehen
- Befund 3: Anzeigen, Infografiken und Text im Bild
- Befund 4: Zählen, Karten, Personen, Autos
- Befund 5: Thumbnails, Titelbilder und Hintergründe
- Welches Modell für welche Aufgabe?
- Was es kostet: API günstig, Magnific teurer
- Was die Community sagt
- Meine Empfehlung
- Häufige Fragen
- Quellen
Am 06. Oktober 2026 hat Google Nano Banana 2.1 veröffentlicht, sein neues Bildmodell. Es betrifft jeden, der Bilder für eine Seite oder einen Kanal braucht: Shops mit Produktfotos und Anzeigen, Blogs und Magazine mit Titelbildern, Infografiken und Porträts, Webseiten mit Hero- und Hintergrundbildern, YouTuber mit Thumbnails. Vier Fragen zählen überall: Bleibt Text im Bild richtig, zum Beispiel ein Etikett? Sehen Menschen endlich aus wie Menschen und nicht wie Plastik? Schreibt das Modell deutsche Texte fehlerfrei? Und was kostet das? Ich habe das gleich am Starttag mit Fotos des RYMHART-Troyers geprüft und mit Aufgaben aus Blog, Magazin und YouTube. Vorab zwei Dinge. Erstens: RYMHART ist hier mein Testfeld, kein Praxisfall. Bei RYMHART arbeite ich, und dort entstehen Produkt- und Personenfotos nach wie vor in echter Handarbeit, mit dem Fotografen im Haus. KI-Bilder setzt RYMHART dafür aktuell nicht ein. Ich teste als seorado KI-Modelle und nehme dafür die Produkte von RYMHART, weil Logos und Details wie Etikett und Reißverschluss ein hartes Testbeispiel sind und ich dafür kein fremdes Material verwenden muss. Zweitens muss ich meine erste Auswertung der Etiketten korrigieren: Sie prüfte nur die Wörter, und neben dem Original passten Schrift und Emblem nicht. Deshalb habe ich den Test mit der Methode aus meinen Magnific-Spaces-Tests wiederholt, und dazu GPT Image 2.5 in der Variante Sunburst geprüft. Das Ergebnis in einem Satz: Beim Etikett hält 2.1 mit, solange es groß im Bild ist, nach dem Umfärben auf Pink schafft es kein Modell, und bei Menschen entscheidet der Prompt mehr als die Modellversion.
Mit KI-Unterstützung habe ich 125 Bilder erzeugen und nach festen Kriterien auswerten lassen, 117 mit fünf Google-Modellen (Nano Banana 2.1, Nano Banana 2, Nano Banana Pro, Nano Banana 2 Lite und das erste Nano Banana) und 8 mit GPT Image 2.5 Sunburst. Dazu kommen Googles eigene Angaben mit Screenshots, die Preise, ein Praktikertest mit 419 Bildern, sieben YouTube-Videos, Reddit-Threads in r/GeminiAI, Hacker News und X. Du bekommst eine Auswahlhilfe nach Aufgabe, einen Kostenrechner und ein Werkzeug, das deinen Bild-Prompt auf Plastik-Auslöser prüft.
Transkript des Videos lesen
Google hat Nano Banana 2.1 veröffentlicht. Ich teste neue Bildmodelle gern an einem harten Fall: dem Troyer von RYMHART, mit Etikett und Reißverschluss-Anhänger. RYMHART ist dabei nur mein Testfeld. Die Produktfotos dort macht der Fotograf im Haus, in echter Handarbeit. Mein erster Test war falsch ausgewertet. Die Wörter standen im Bild, aber Schrift und Emblem passten nicht zum Original. Das habe ich korrigiert. Dann habe ich die Methode mit Magnific Spaces nachgebaut: große Detailfotos als Pflicht-Referenz, eine feste Regel, dass nichts neu gezeichnet werden darf, und GPT 2.5 in der Variante Sunburst auf Max. Das Ergebnis im Makro: Etikett und Anhänger stimmen bei allen vier Modellen. Anders sieht es bei der ganzen Jacke aus. Dort ist das Etikett nur ein kleiner Ausschnitt. GPT kommt auf 6 von 8 Punkten, Nano Banana 2 auf 5, 2.1 und Pro nur auf 4. Bei den Google-Modellen sind zweite Zeile und Webadresse unlesbar. Bei Menschen zählt der Prompt mehr als das Modell: Mit Straße, Bartschatten und Filmkorn sehen die Gesichter deutlich weniger nach Plastik aus. Der API-Preis liegt bei rund 3 Cent pro Bild, halb so hoch wie bei Nano Banana 2. Mein Fazit: Logos und Etiketten als Makro mit Pflicht-Referenz erzeugen und im Gesamtbild immer gegen das Original prüfen. Bei RYMHART bleibt es bei echter Handarbeit. Ich nutze KI-Bilder dort, wo kein echtes Produkt und kein echtes Gesicht stimmen muss.
Was Google am 06.10. gebracht hat
Google nennt Nano Banana 2.1 sein neues Modell zum Erzeugen und Bearbeiten von Bildern. Laut Googles Ankündigung auf X liegt es „across the board“ vor den früheren Modellen, mit Fortschritten bei visuellem Design, maskenbasierter Bearbeitung und Motivkonsistenz. Der Start läuft laut Googles zweitem Post in der Gemini-App, im AI Mode der Suche, in Google AI Studio, Flow, Stitch, Google Ads und der Gemini Enterprise Platform. Einen Blogpost gab es am Starttag nicht. Die Fakten stehen in der Modellkarte und in der API-Dokumentation.
- Basis: Gemini 3.6 Flash. Auf X fragte ein Nutzer, ob 2.1 nicht auf Gemini 4 Argon basieren müsste. Nein, Argon ist weiter nur für ausgewählte Partner zugänglich, mehr dazu im Beitrag zu Gemini 4 Argon.
- Modell-ID: gemini-nano-banana-2.1, in der API allgemein verfügbar. Nano Banana 2 (gemini-3.1-flash-image) ist laut Google ab sofort veraltet und wird am 29.10.2026 abgeschaltet.
- Funktionen: bis zu 14 Referenzbilder (vier Figuren und zehn Objekte), 1K, 2K und 4K, extreme Formate von 1:8 bis 8:1, Google-Suche und Bildersuche als Quelle, drei Denkstufen (minimal, medium, high) mit medium als Standard.
- Zugang: Die API hat für 2.1 keinen kostenlosen Tarif. Zu Deutschland sagt Google nichts. Die Hilfeseite zur Bilderstellung im AI Mode nennt Deutschland nicht, ein Reddit-Nutzer schreibt dagegen: „I'm in EU and just saw it used in my generations.“ Ich habe über Magnific von Deutschland aus getestet.
Der Preis: halbiert beim Bild, teurer bei Eingabe und Denken
Google nennt auf der Preisseite für 2.1 pro Bild 0,0336 $ (1K), 0,0504 $ (2K) und 0,113 $ (4K). Bei Nano Banana 2 sind es 0,067, 0,101 und 0,151 $, bei Pro 0,134 $ (1K und 2K) und 0,24 $ (4K). Der 4K-Preis von 2.1 hat sich in den ersten 24 Stunden geändert: Am 06.10. stand auf der Seite noch 0,0756 $ (2.520 Tokens), am 07.10. steht dort 0,113 $ (3.780 Tokens). The Decoder nannte am Starttag für 4K noch 7,56 Cent und „roughly half“ weniger als bisher. Das ist damit überholt: Bei 4K liegt der Vorteil gegenüber Nano Banana 2 bei rund 25 Prozent.
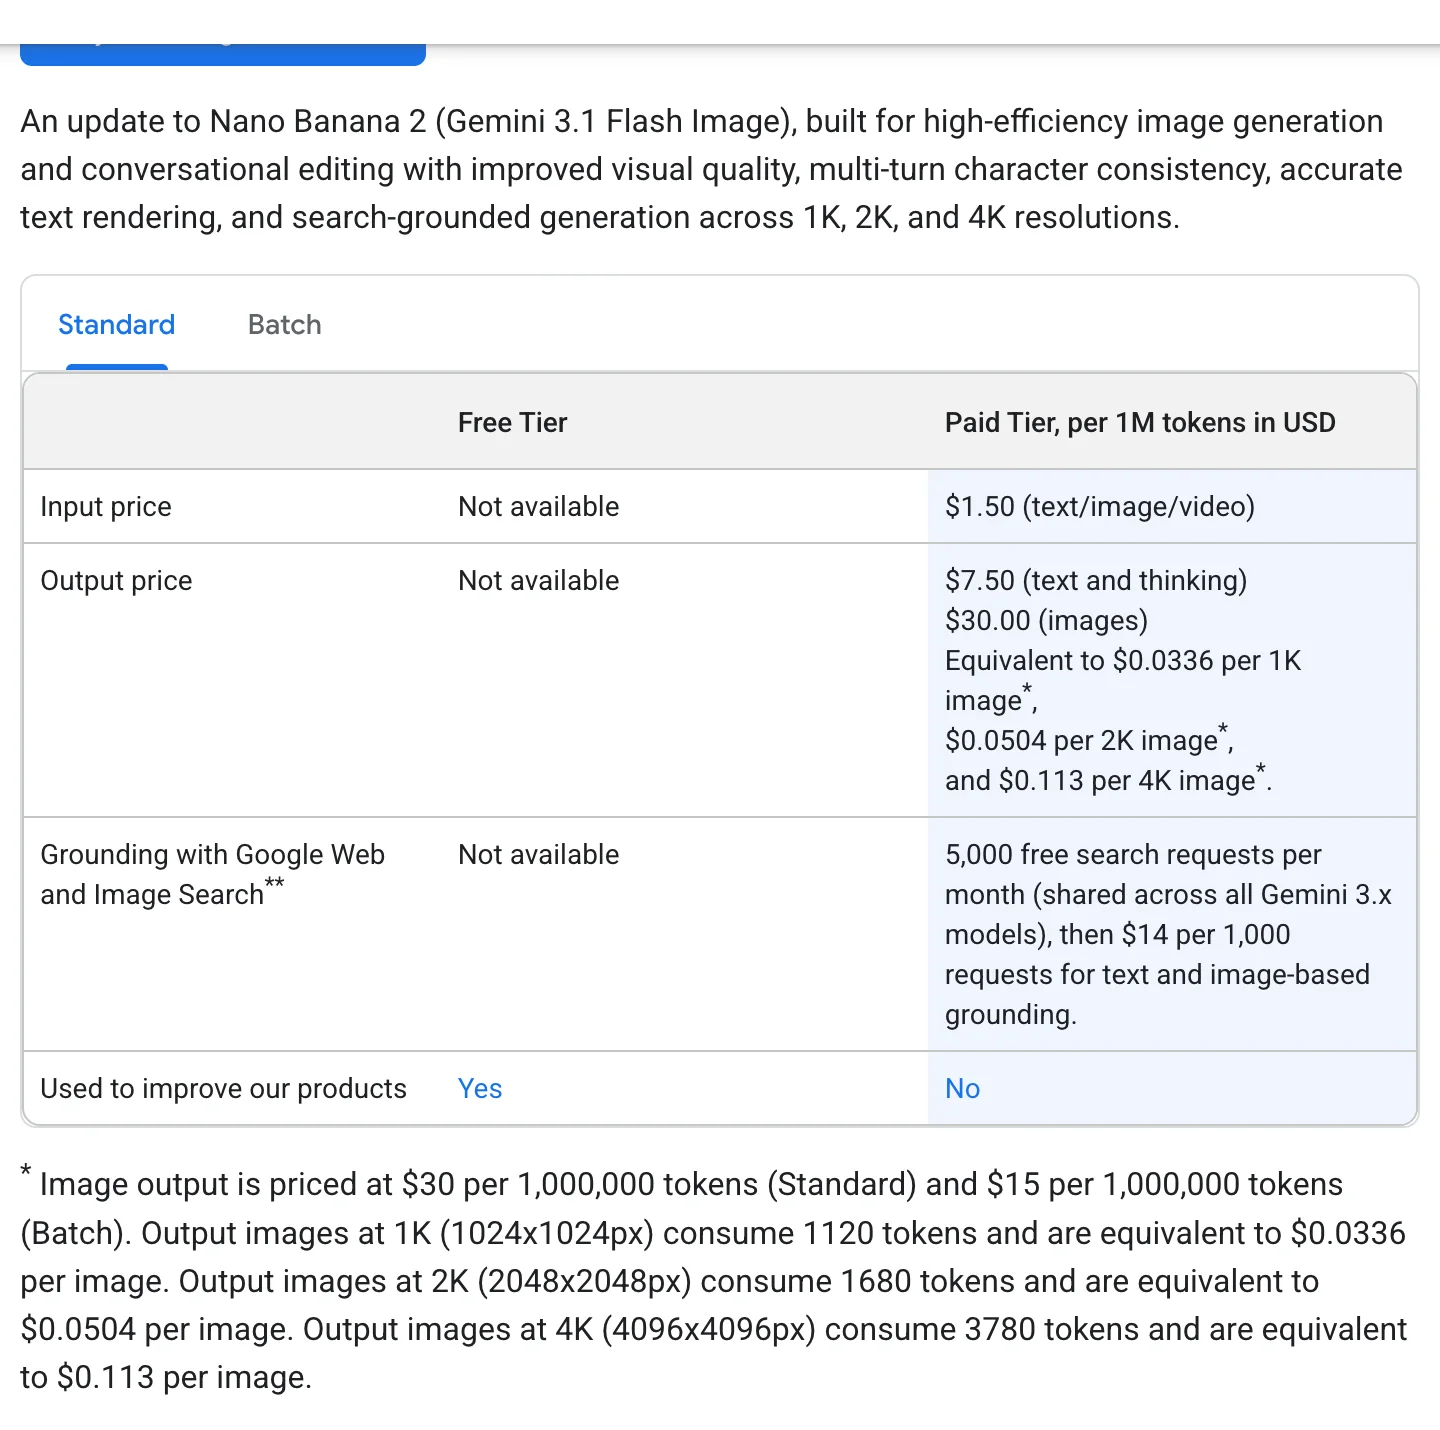
Der Bildpreis ist nur ein Teil der Rechnung. Die Eingabe kostet bei 2.1 1,50 $ je Million Tokens, bei Nano Banana 2 steht auf derselben Seite 0,50 $. Dazu kommen die Tokens fürs Denken, und weil „medium“ der neue Standard ist, denkt das Modell mehr als vorher. Der Tester JP Caparas hat das über die Gemini API gemessen: Ein 1K-Bild kostet inklusive Eingabe und Denken im Durchschnitt 0,046 $ bei medium (0,038 $ bei minimal, 0,053 $ bei high), bei Nano Banana 2 mit hohem Denken 0,073 $ und bei Pro 0,140 $. Der Vorteil gegenüber Nano Banana 2 liegt dort bei rund 28 Prozent bei hohem Denken, nicht bei 50. Die Rechnung kannst du unten mit deinen Zahlen nachstellen.
Googles eigene Messwerte
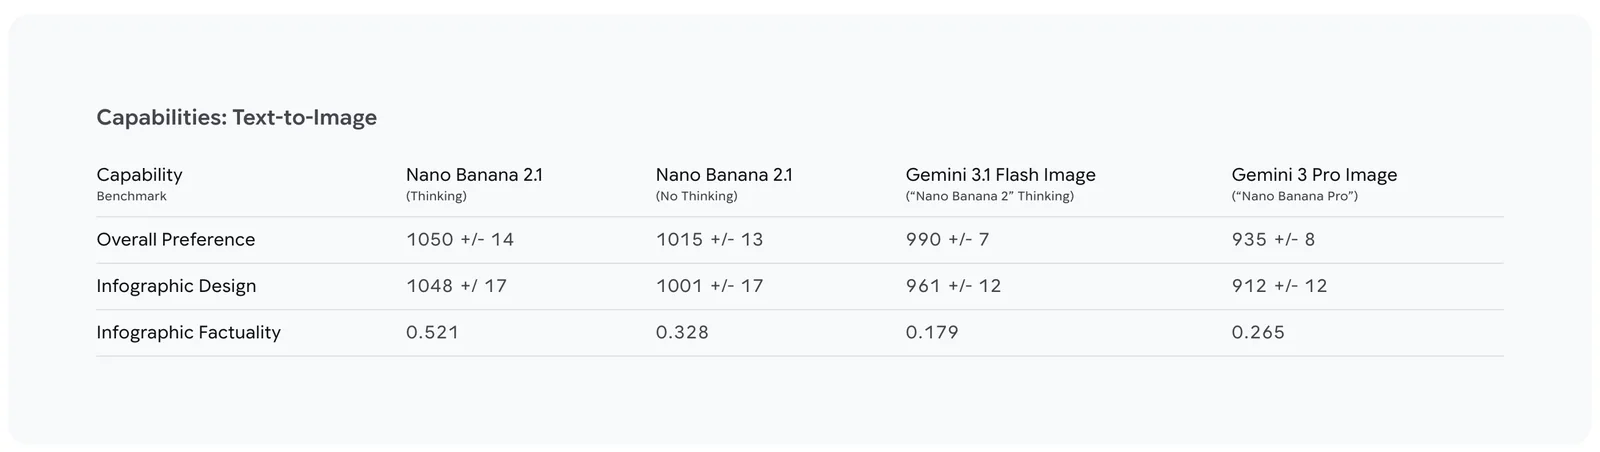
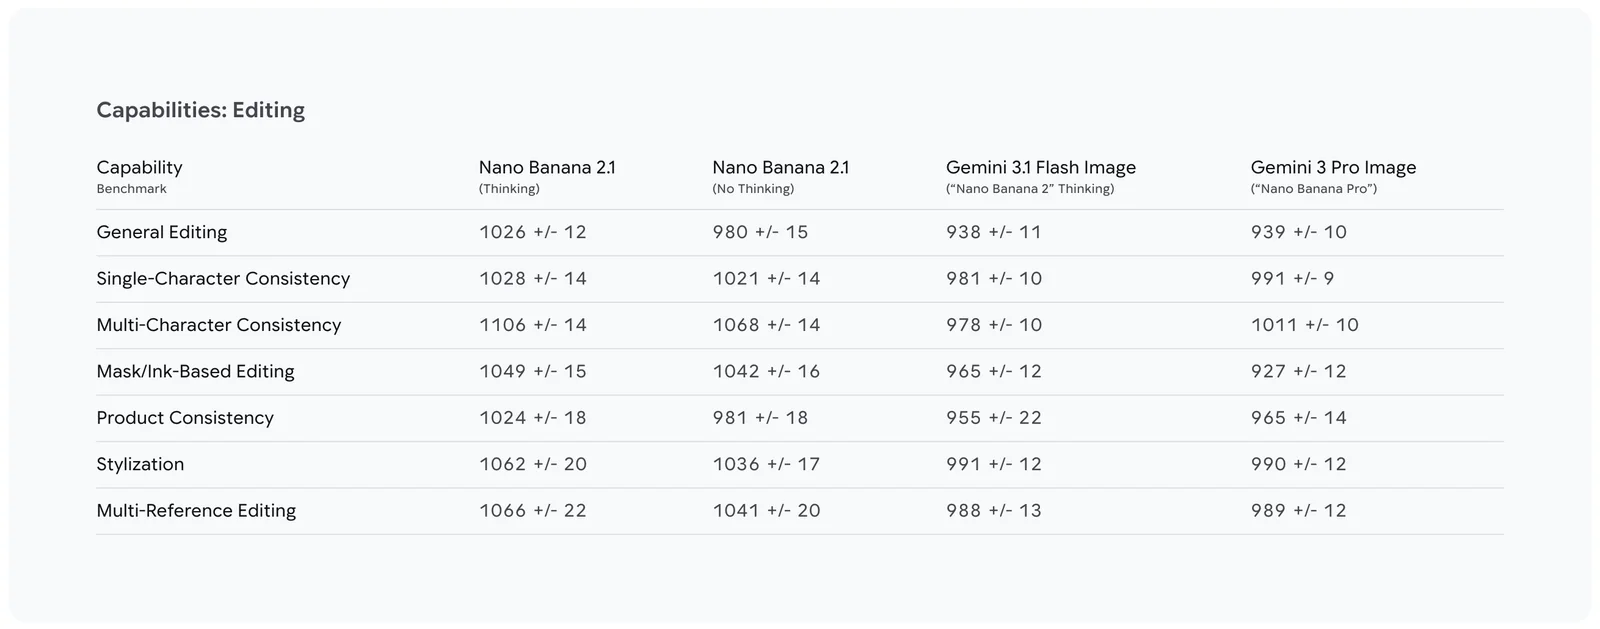
Die Modellkarte vergleicht 2.1 nur mit Googles eigenen Modellen. Die Methode ist ein Vergleich von Bildpaaren durch Menschen, daraus wird eine Elo-Zahl berechnet (je höher, desto öfter bevorzugt), dazu ein automatischer Bewerter für Faktentreue. Bei „Overall Preference“ steht 2.1 mit Denken bei 1050, Nano Banana 2 bei 990 und Pro bei 935. Bei der Faktentreue von Infografiken sind es 0,521 gegen 0,179 und 0,265.
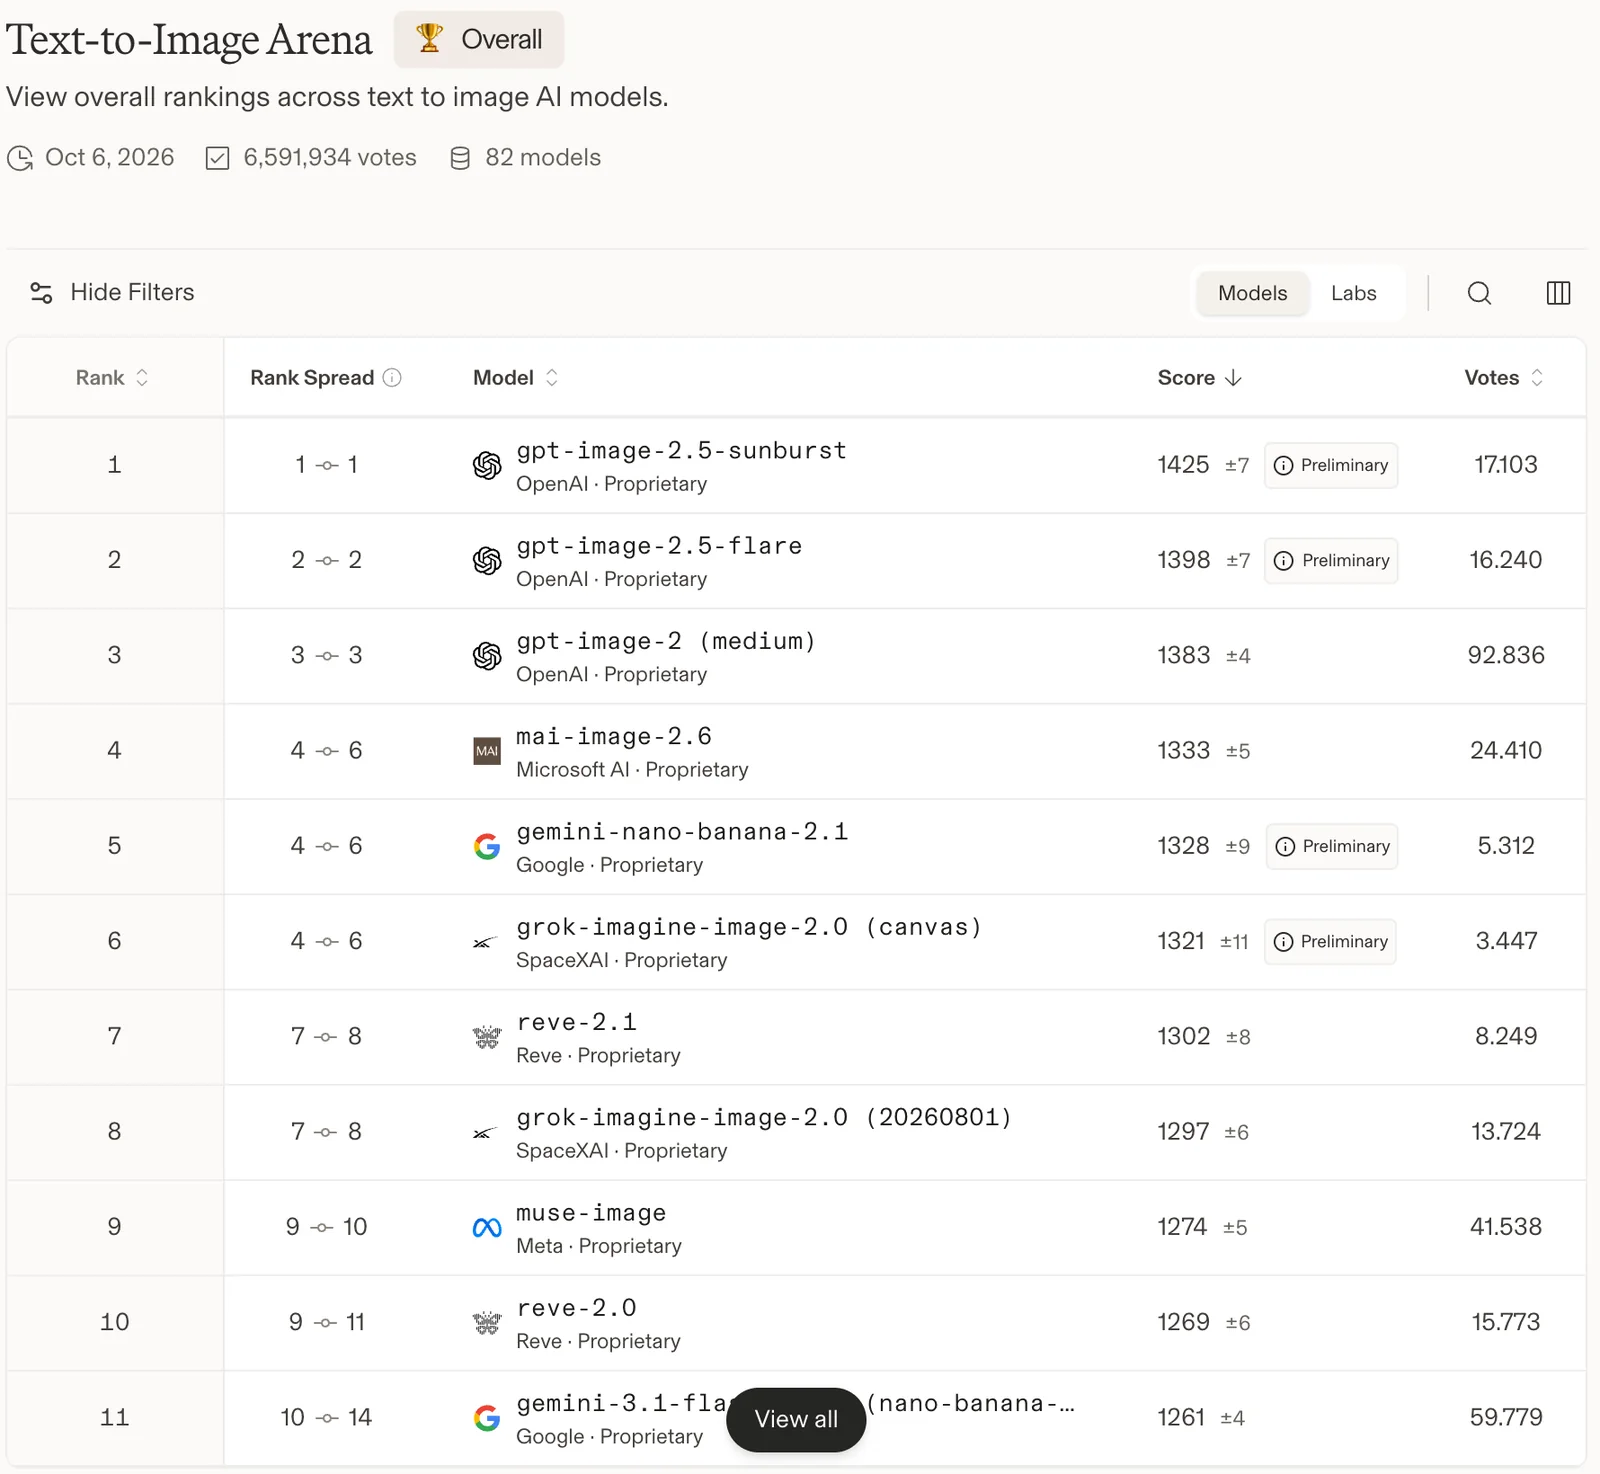
Unabhängig gibt es am ersten Tag wenig. In der Text-zu-Bild-Arena steht 2.1 auf Platz 5 mit 1328 Punkten bei 5.312 Stimmen, Nano Banana 2 steht bei 1261. Der Eintrag ist als „Preliminary“ markiert. Vor 2.1 stehen drei OpenAI-Modelle (vorn GPT Image 2.5 Sunburst mit 1425) und mai-image-2.6 von Microsoft mit 1333. In der Bildbearbeitung liegt 2.1 laut Arena auf Platz 6 mit 1428 Punkten bei 12.985 Stimmen. Bei Artificial Analysis war 2.1 am Starttag noch nicht gelistet. The Decoder schrieb zum Start, in der Praxis liefere Nano Banana Pro oft noch deutlich bessere Bilder, bezogen auf einen einzelnen Vergleichsprompt in Flow.
So habe ich getestet
Die Tests liefen über Magnific, nicht über die Gemini API. Wie Magnific zusammen mit Claude für Produktfotos und Anzeigen arbeitet, zeigt der Beitrag zu Magnific Spaces. Magnific führt „Google Nano Banana 2.1“ im Katalog, kennzeichnet es aber intern als nicht allgemein freigegeben. Ob dahinter exakt Googles API-Modell mit denselben Einstellungen läuft, kann ich von außen nicht prüfen. Bilder in 2K, wo Magnific eine Auswahl bot. Nano Banana und Lite liefern dort nur rund 900 Pixel Breite, die anderen drei 1.856 bis 2.048 Pixel, das erschwert den Vergleich bei kleiner Schrift.
- Referenzen: öffentliche Produktfotos des RYMHART-Troyers in Marine (Freisteller und Detailbild), dazu Hemd, Chino und Sneaker aus dem Shop. Für die Wiederholung mit Pflicht-Referenzen die Detailfotos aus meinem Magnific-Space: Jacke in Graphit, Etikett im Kragen, Etikett-Makro, Zipper-Makro und eine pinke Farbvorlage. Für ein großes Etikett nahm ich zusätzlich eine Kaffeetüte „RÖSTKANTE“ (erfundene Marke aus meinem Labor).
- Aufgaben: Etikett in der Nahaufnahme und nach dem Umfärben, Anprobe, Menschenbilder, Infografik, Diagramm, Preistabelle, Karten, Meta-Anzeigen, Display-Anzeige, Auto mit Kennzeichen, Zählen, YouTube-Thumbnail und ein Hintergrundbild für Webseiten. Dazu eine Wiederholung der Etikett-Aufgaben mit Pflicht-Referenzen (ganze Jacke, Kragen-Nahaufnahme, Etikett-Makro, Zipper-Makro). Prompts und Kriterien habe ich vor der Auswertung festgelegt.
- Auswertung: je ein Lauf pro Prompt und Modell. Pro Aufgabe gibt es feste Ja-Nein-Kriterien (zum Beispiel „Stempel fehlerfrei“), die Sichtprüfung stützt sich auf Vergrößerungen. Die Punkte hat meine KI-Hilfe nach Sichtung der Bilder und ihrer Vergrößerungen vergeben, die Bilder stehen im Beitrag, urteile selbst. Gesichter und Gesamteindruck sind Eindruck und nicht in den Punkten. Bei Etiketten und Logos gilt der strenge Maßstab: Wortlaut, Schriftbild und Emblem im gleichen Maßstab neben dem Original, unlesbar zählt als Fehler.
- Aufwand: 125 Bilder, zusammen 13.870 Credits in Magnific (Kontostand vor und nach dem Test). 2.1 kostete 100 Credits je 2K-Bild, Nano Banana 2 und Pro je 75, GPT Image 2.5 Sunburst auf Stufe max 600.
Grenzen der Daten
- Je ein Lauf pro Prompt und Modell. Zwei Punkte Unterschied sind mit so wenigen Läufen kein sicherer Vorsprung, Zufall spielt hinein.
- Magnific statt Gemini API, und das Modell in Magnific ist als intern gekennzeichnet. GPT Image 2.5 gibt es dort nicht in 4:5, ich nahm 3:4. GPT lief nur bei den Etikett-Aufgaben mit. Den Space „Farbwechsel“ selbst konnte ich mit meinem Zugang nicht öffnen, ich habe seine Referenzen und Regeln nachgebaut, die Regeltexte sind meine Fassung. Das Etikett-Makro ist nur 233 x 170 Pixel groß, der Zipper 110 x 226 Pixel.
- Die erste Etikett-Auswertung war zu nachsichtig und ist aus den Gesamtpunkten herausgenommen.
- Die Punkte messen, ob etwas stimmt (Text, Zahl, Etikett), nicht, wie schön ein Bild ist. Das ist die Lücke zu Googles Elo-Werten und zur Arena, die den Gesamteindruck bewerten.
- Die Testbilder zeigen erfundene Personen. Einzelne Feinheiten wie die Prägung am Sneaker habe ich nicht geprüft.
Auf den sieben gewerteten Aufgaben ohne Etikett, die alle fünf Modelle bekamen (35 Punkte), liegen Nano Banana 2 und Pro mit je 35, Lite mit 34 und 2.1 mit 33 eng beieinander, das erste Nano Banana kommt auf 19. Über alle Aufgaben mit den drei Hauptmodellen (80 Punkte) sind es 75 für Nano Banana 2, 79 für Pro und 75 für 2.1. Der Praktikertest von JP Caparas (Gemini API, 34 Aufgaben, zwei Proben je Konfiguration, Bewertung durch zwei Modell-Richter) kommt zu einem ähnlichen Bild: Bei den Checklisten liegt 2.1 vorn, aber nur zwei bis vier Prozentpunkte vor den anderen, „inside the noise“. Erst im direkten Vergleich zweier Bilder gewinnt 2.1 deutlich (33 Siege, 8 Niederlagen und 22 Gleichstände gegen Pro). Das passt dazu, dass 2.1 vor allem im Gesamteindruck punktet und weniger bei der Genauigkeit.
Befund 1: Logo und Schrift stimmen nur mit der richtigen Methode
Das ist die Frage von allen, die Produkte zeigen: Bleiben Etikett, Logo und Beschriftung auf meinem Produkt echt? Für Blogs und Magazine gilt dasselbe für jeden Schriftzug und jedes Logo im Bild. Mein erster Test hat diese Frage zu nachsichtig beantwortet. Das muss ich korrigieren.
Erster Test: ein Foto, ein Prompt, die Wörter stimmen nur scheinbar
Im ersten Durchlauf bekam jedes Modell das Produktfoto des RYMHART-Troyers in Marine und einen Prompt: eine Nahaufnahme des Kragens mit Etikett und Reißverschluss, später der ganze Troyer in Pink. Ich habe geprüft, ob die Wörter „RYMHART“, „ORIGINAL TROYER“ und „050030“ im Bild stehen. Sie standen oft richtig da, und ich habe das „fehlerfrei“ genannt. Das war zu wenig. Legst du das Etikett neben das Original, passt es nicht: Im Original sind die zweite Zeile und die Nummer in einer Serifenschrift gesetzt, bei den Modellen weicht das Schriftbild ab oder die Zeile ist verwaschen. Das Emblem des Originals ist ein kleines blaues Quadrat mit einem Monogramm aus zwei gespiegelten Formen, die Modelle zeichnen stattdessen ein Wappen mit Kreuz oder ein anderes Zeichen. Auch GPT Image 2.5 Sunburst schreibt den Text sauber, setzt aber ein Wappen mit Kreuz.
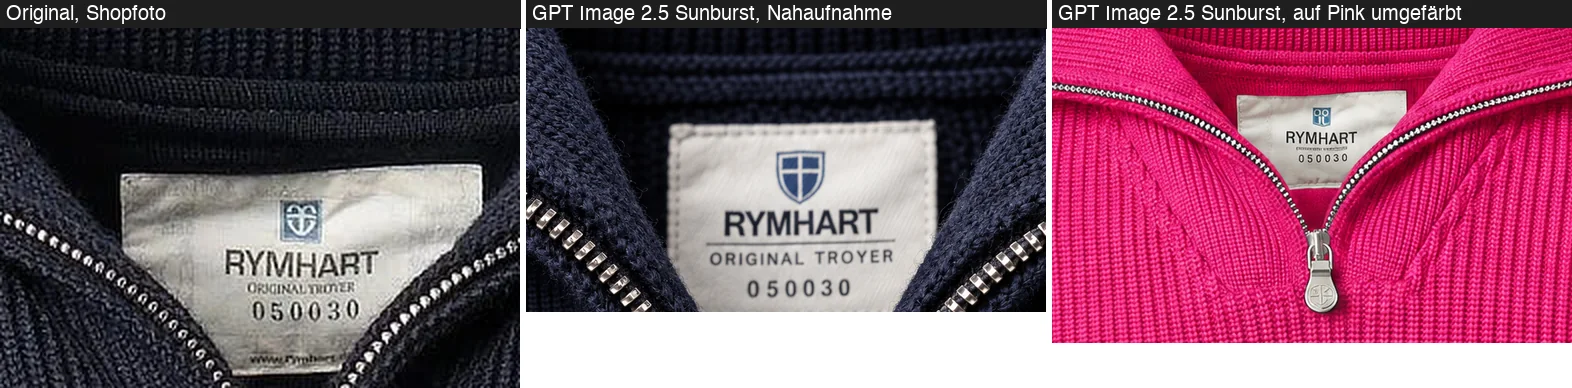
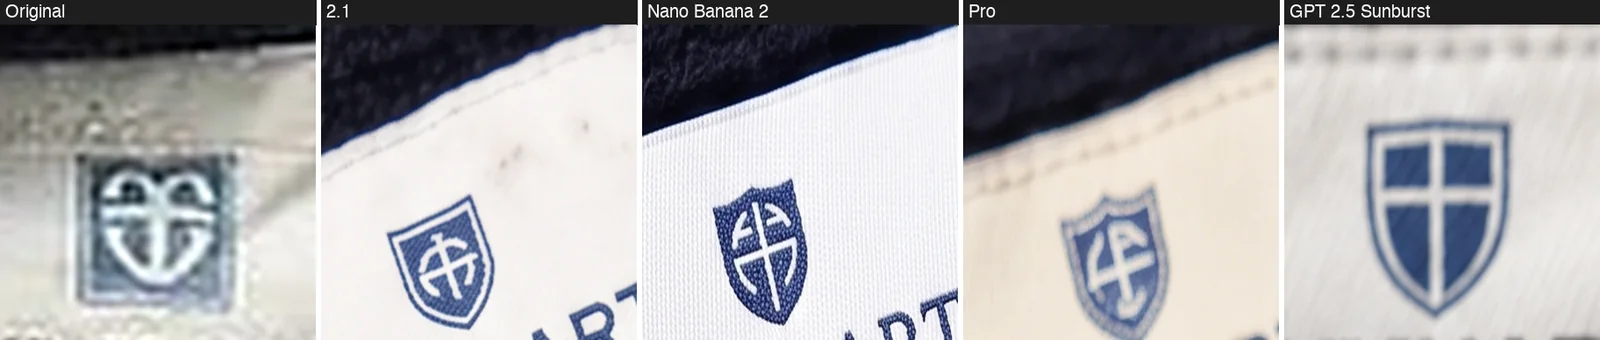
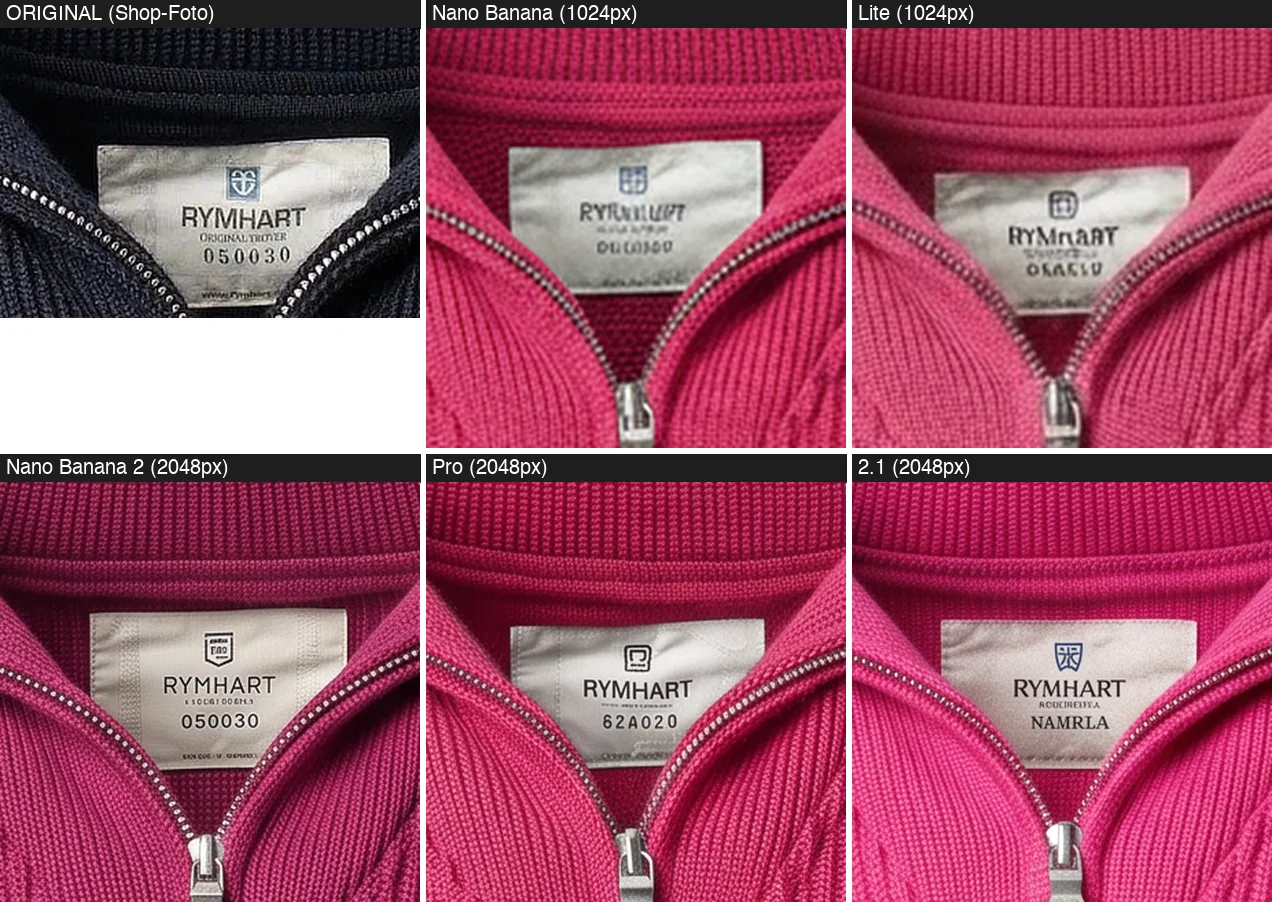
Nach dem Umfärben war es schlimmer: Das Etikett war nur noch rund 9 Prozent der Bildbreite breit (188 Pixel bei 2.048 Pixeln, per Skript gemessen), Nano Banana und Lite verfälschten schon den Markennamen, und die zweite Zeile war bei keinem Modell lesbar. Das passt zur Modellkarte, die selbst von schlecht gerenderter Kleinschrift spricht („Poor text rendering in small text (often blurry in 1k model)“). Dieser erste Test lief außerdem ohne die Methode aus meinen Magnific-Spaces-Tests. Er zeigt, wie die meisten KI-Bilder entstehen, und dass das für Logos nicht reicht.
Die Methode: Pflicht-Referenzen, feste Regeln, Makros
Im Space „Farbwechsel“, dessen Aufbau der Beitrag zu Magnific Spaces zeigt, klappt dasselbe. Er beruht auf vier Dingen und einer Arbeitsweise:
- Pflicht-Referenzen: Detailfotos von Logo und Zipper, groß im Bild: das Etikett im Kragen, das Etikett als Makro, der Zipper-Anhänger als Makro und am Kragen.
- Eine feste Regel-Textnode: Sie beginnt mit „PRODUCT FIDELITY (NON-NEGOTIABLE)“ und legt fest, was nie verändert werden darf: Wortlaut, Schrift, Emblem, Gravur. Sie sagt auch, dass nichts neu gezeichnet, neu gesetzt oder übersetzt werden darf.
- Eine Farbvorlage statt einer Farbbeschreibung: ein Pullover in Himbeere für den Farbwechsel.
- Das richtige Modell: GPT 2.5 in der Variante Sunburst, Qualität max, 2K. In Magnific beschreibt das Menü Sunburst mit „Preserves faces, logos and products across edits“.
- Makros getrennt von der Ganzansicht: Im Makro füllen Logo und Zipper das Bild, im Ganzbild sind sie nur wenige Pixel groß.
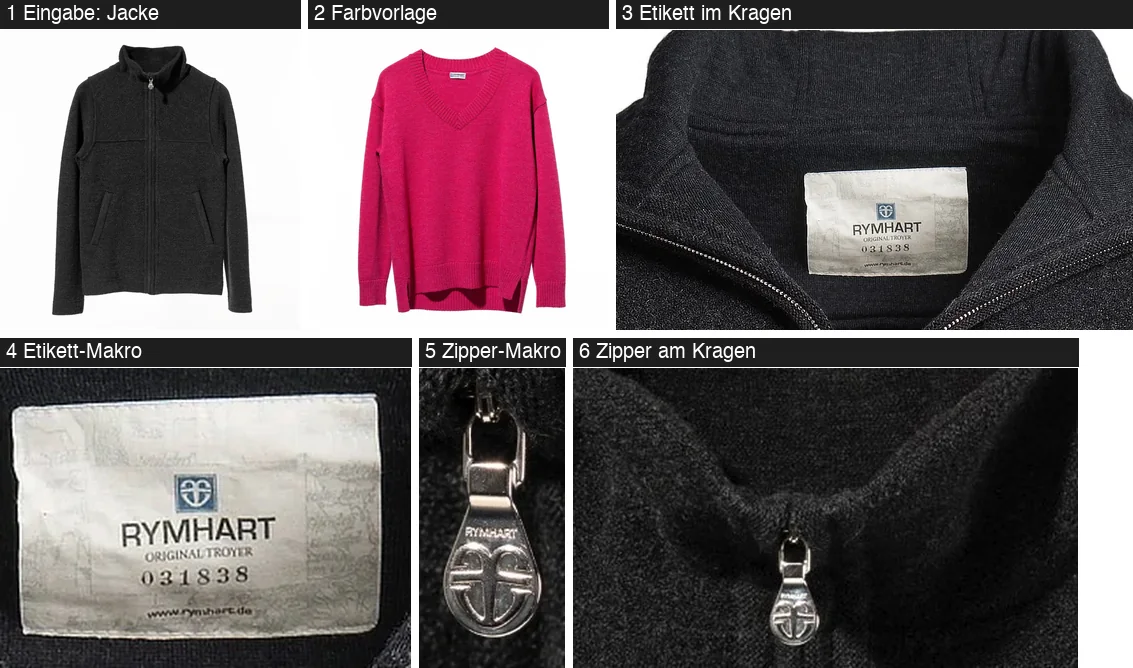
Den Space selbst konnte ich mit meinem Magnific-Zugang nicht öffnen, er liegt in einem anderen Konto. Ich habe deshalb dieselben Referenzen und Regeln nachgebaut und über den Zugang der übrigen Tests gefahren, vier Aufgaben mit je vier Modellen. Es ist die RYMHART-Jacke in Graphit statt des Troyers, weil nur für sie die Detailfotos vorliegen. Der Regeltext (auf Englisch, wie im Space) sagt im Kern:
PRODUCT FIDELITY (NON-NEGOTIABLE). The RYMHART details must be exact copies of the reference images, never redrawn. [...] Do not invent, retype, restyle or translate any text or logo. If a detail is too small to render sharply, keep it as a faithful miniature copy of the reference instead of changing it.
Ergebnis: Makros klappen bei allen vier, die Ganzansicht nicht
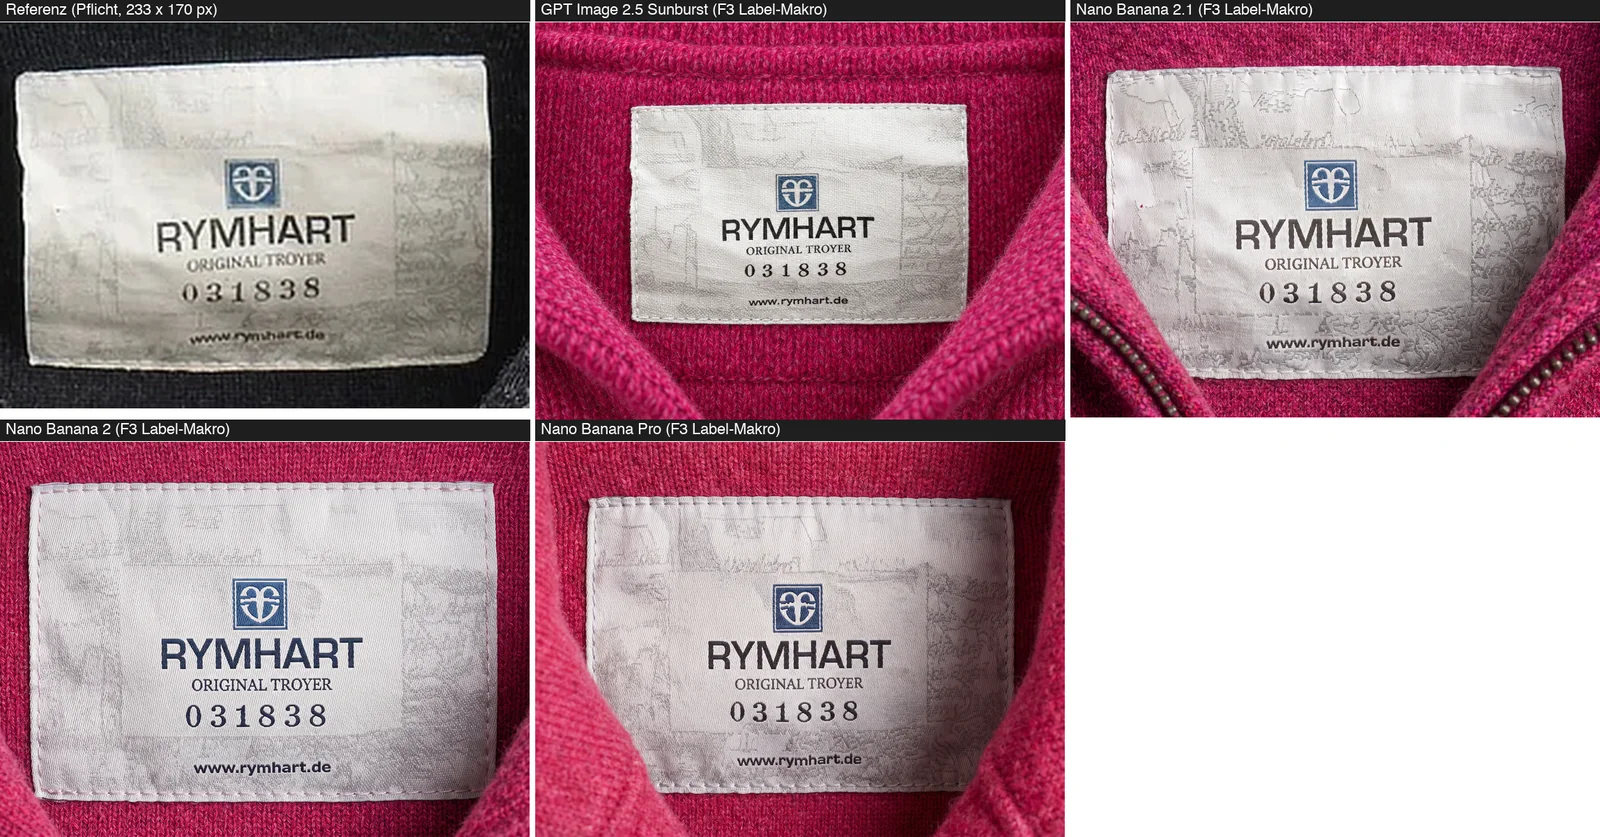
Etikett als Makro (4 von 4 Punkten bei jedem Modell). Wortmarke, „ORIGINAL TROYER“ in kleinen Serifenversalien, „031838“ in gesperrten Serifenziffern, Webadresse und das blaue Emblem stimmen bei GPT Image 2.5 Sunburst, Nano Banana 2.1, Nano Banana 2 und Pro. Neben dem Original fällt nichts auf, die Nachbildungen sind sogar schärfer als die kleine Referenz.
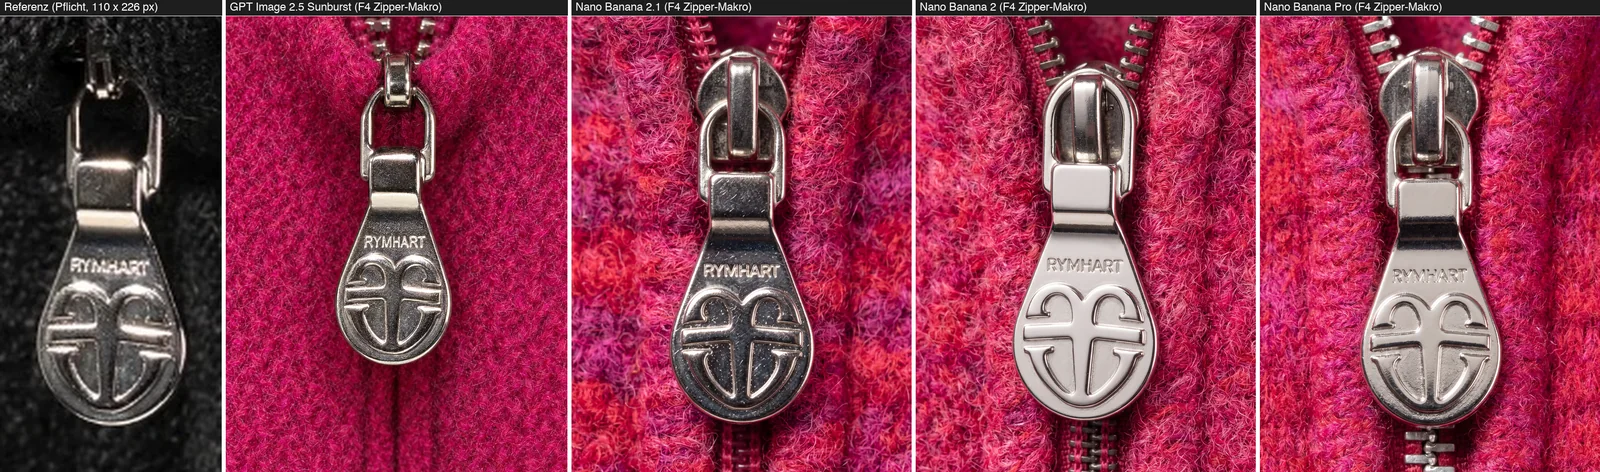
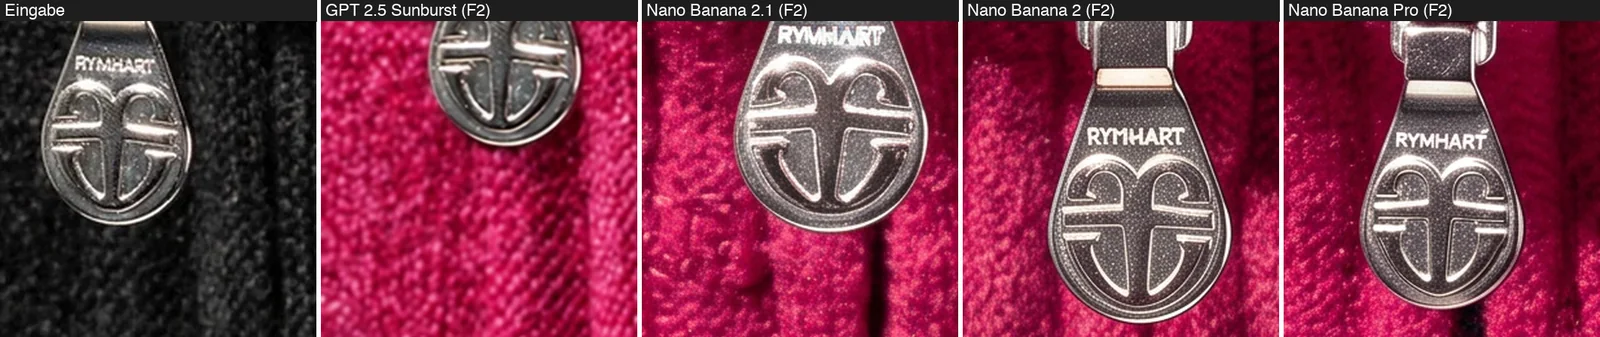
Zipper-Anhänger als Makro (4 von 4 bei jedem Modell). Tropfenform, die Gravur „RYMHART“ und das Emblem aus zwei gespiegelten Formen mit Querbalken sind bei allen vier da. Bei Nano Banana 2 und Pro ist das Emblem etwas offener gezeichnet, bei GPT Image 2.5 und 2.1 liegt es am nächsten an der Referenz. Das habe ich nicht gewertet.
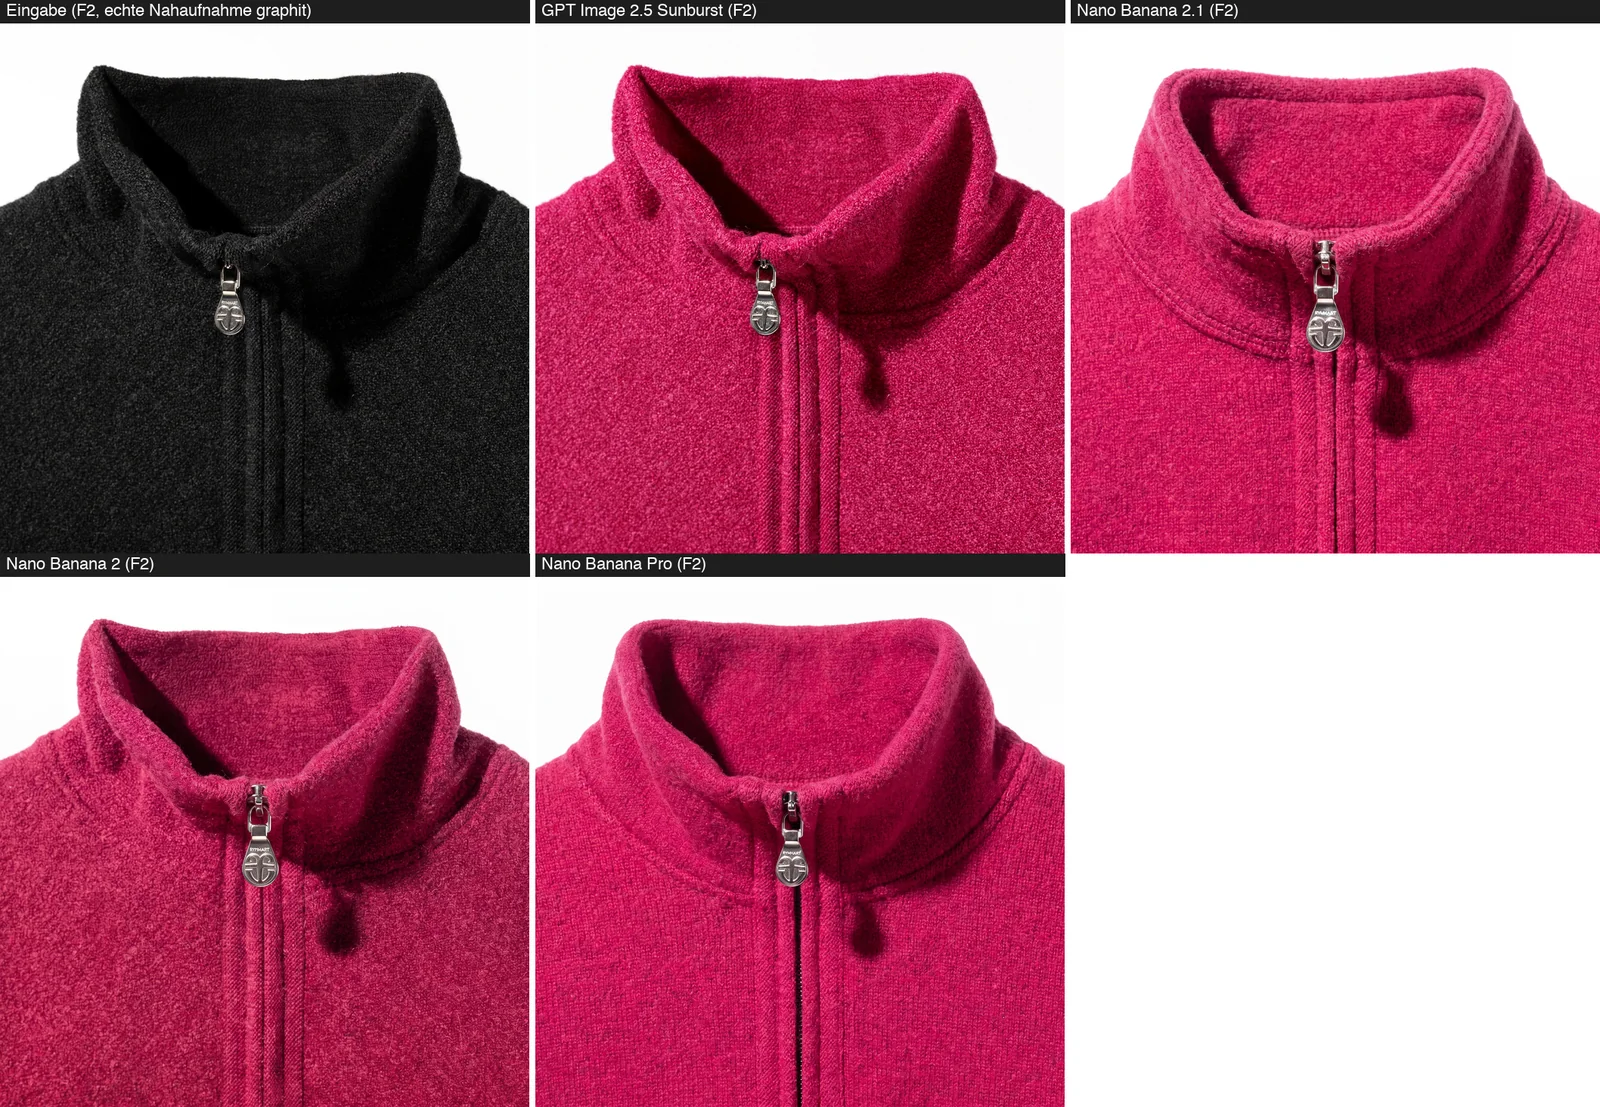
Kragen-Nahaufnahme in Himbeere (4 von 4 bei jedem Modell). Der Anhänger zeigt bei allen „RYMHART“ und das Emblem. Auffällig ist etwas anderes: GPT Image 2.5 behält die Form von Kragen und Eingabe am genauesten, die Google-Modelle falten den Kragen anders und verändern die Öffnung, obwohl der Prompt „Reproduce it exactly“ verlangt.
Ganze Jacke in Himbeere (Etikett und Zipper im Gesamtbild: GPT 6 von 8, Nano Banana 2 5, 2.1 und Pro je 4). Hier trennen sich die Modelle, obwohl Referenzen und Regeln dieselben waren. Das Etikett ist im Gesamtbild nur rund 16 bis 18 Prozent der Bildbreite breit, der Zipper ein kleiner Punkt.
- GPT Image 2.5 Sunburst: Emblem, Wortmarke, Nummer „031838“ und Webadresse stimmen, in der zweiten Zeile fehlt ein Buchstabe („ORIGNAL TROYER“). Der Anhänger trägt das richtige Emblem, „RYMHART“ ist nicht lesbar.
- Google-Modelle: Wortmarke und Nummer stimmen, die zweite Zeile und die Webadresse sind bei allen drei unlesbar. Das Emblem im Etikett weicht bei 2.1 und Pro ab, nur bei Nano Banana 2 sieht es richtig aus. Das Emblem am Anhänger ist bei allen erfunden.
- Form der Jacke: GPT bleibt bei der geschlossenen Eingabe. Die Google-Modelle öffnen den Reißverschluss und zeigen das Etikett im Krageninneren.
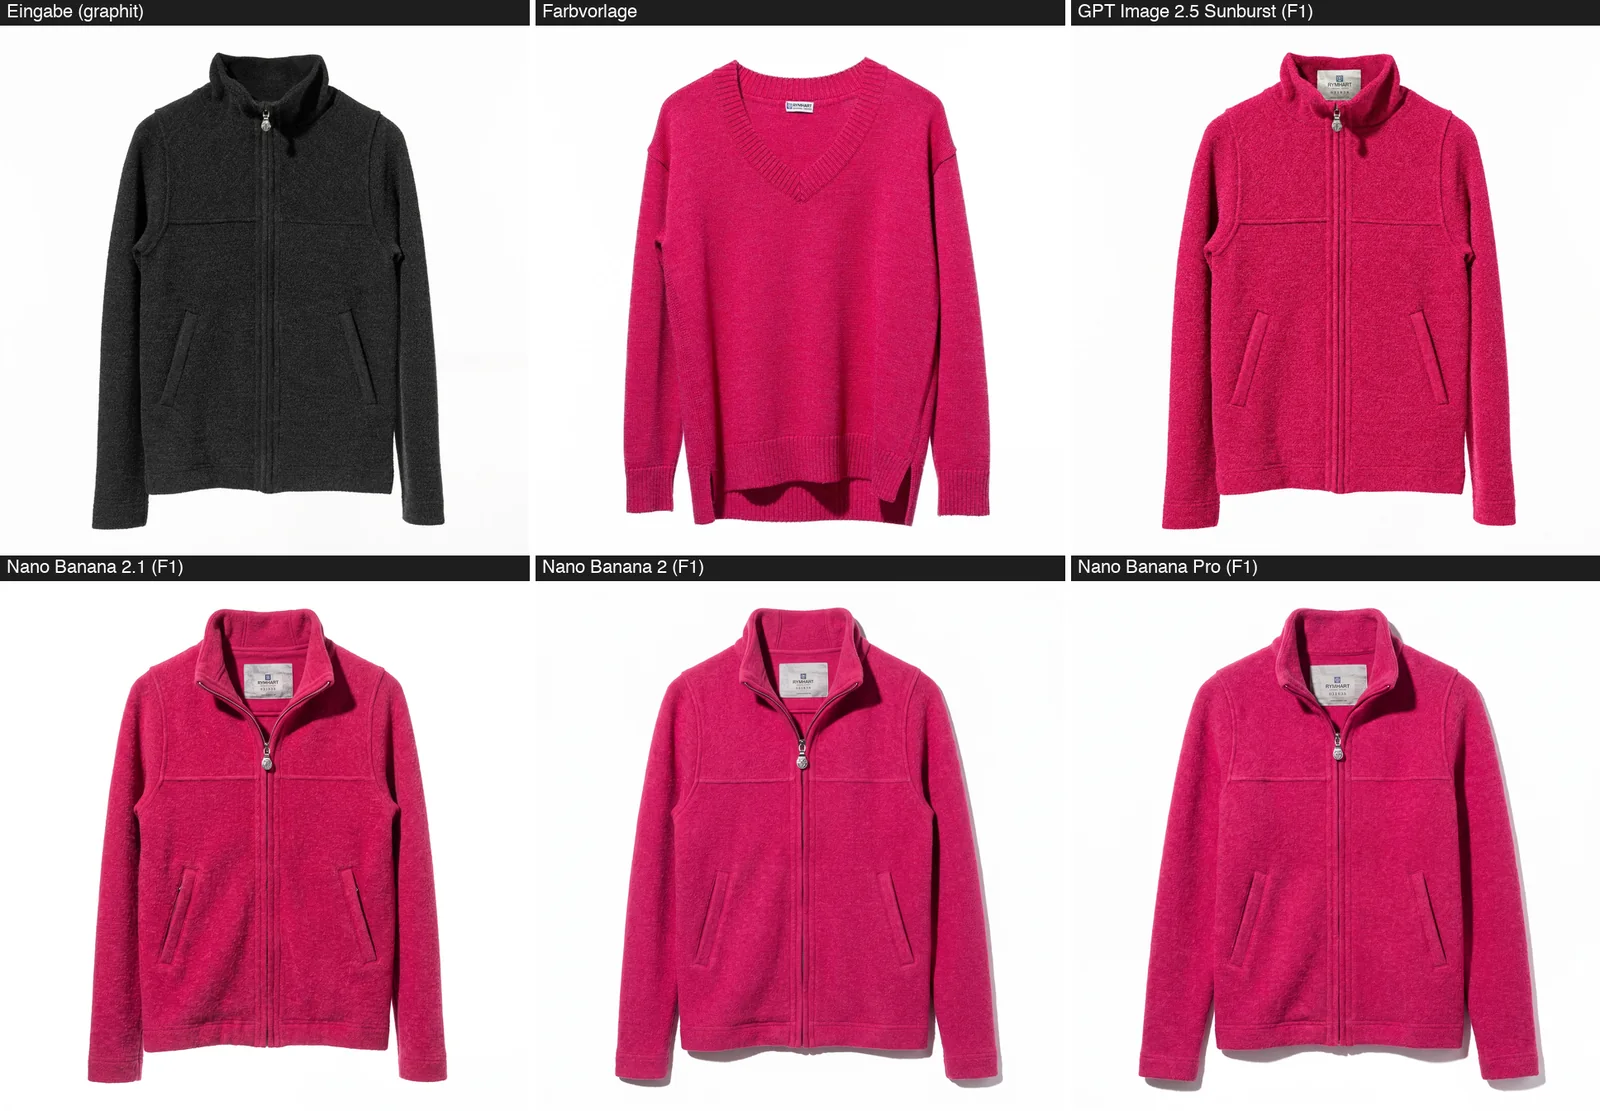
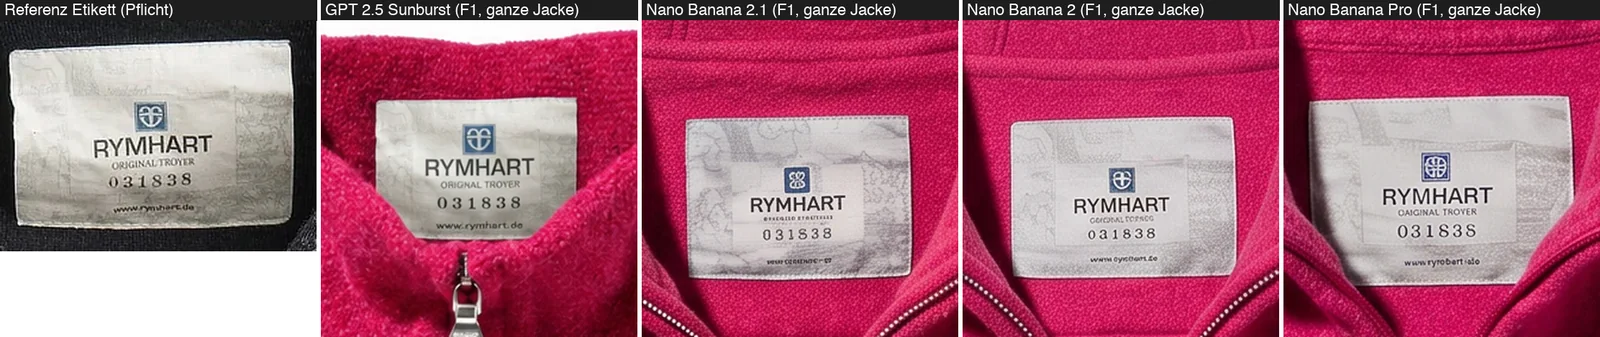
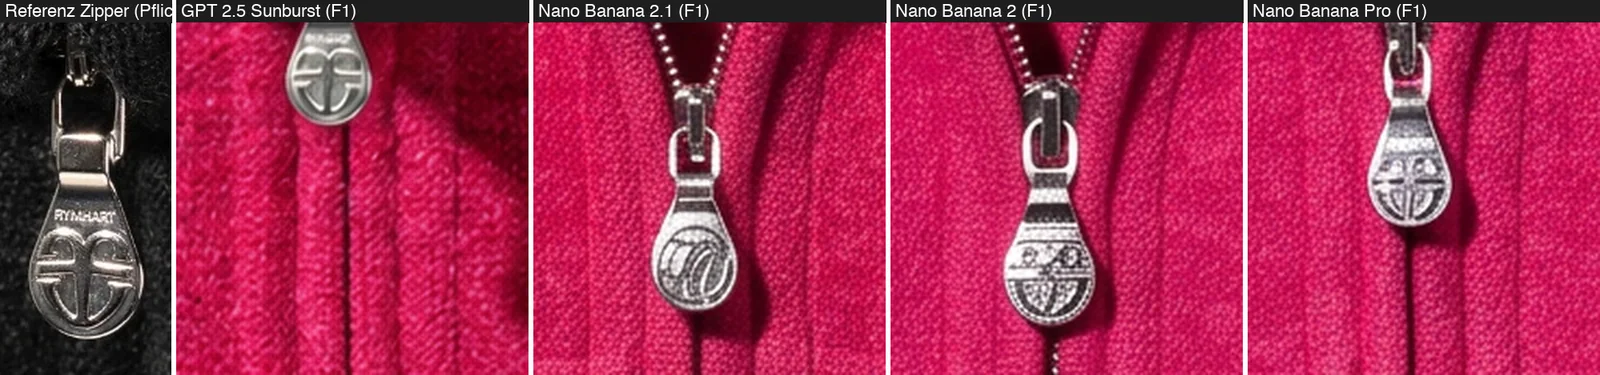
Insgesamt kommen GPT Image 2.5 Sunburst auf 18, Nano Banana 2 auf 17, 2.1 und Pro auf je 16 von 20 Punkten. Der Unterschied entsteht allein in der Ganzansicht. Erkenntnis für die Praxis: Die Methode macht aus „stimmt nicht“ „stimmt im Makro“. Für das Gesamtbild reicht sie nicht, auch nicht mit dem besten Modell.
Was du jetzt tun kannst
- Gib Logo und Etikett als große, scharfe Referenz mit, nicht nur als Teil des Produktfotos. Schon 233 x 170 Pixel reichten im Test.
- Lege Regeln als festen Text fest: Wortlaut, Schriftbild, Emblem und „nie neu zeichnen“. Wiederverwenden kannst du den Text für jede Farbe und jedes Produkt.
- Erzeuge Makros von Logo und Zipper als eigene Bilder und nimm sie nicht aus der Ganzansicht.
- Prüfe Etiketten Zeichen für Zeichen im gleichen Maßstab gegen das Original: Schrift und Emblem, nicht nur die Wörter.
- Für die Ganzansicht ist GPT 2.5 Sunburst mit Qualität max der nächste Kandidat, in Magnific mit 600 Credits je 2K-Bild. Setze das Etikett am Ende als Ausschnitt aus dem Original ein, wenn es exakt stimmen muss.
Dazu eine Warnung vor dem schnellen Einstellen: Der Magnific-Agent hatte beim ersten Aufbau des Space Flare und Medium eingestellt statt Sunburst und Max. Kontrolliere das Modell und die Qualität nach jedem Aufbau.
Befund 2: Menschen, die nicht plastisch aussehen
Mich stört bei KI-Modellfotos, Porträts und Titelbildern seit Langem, dass die Menschen plastisch wirken. Auch am Starttag schreibt ein Tester im Video, die Hauttextur habe weiter „a little bit of that plasticky look“ (smallzero). Ich habe deshalb denselben Auftrag zweimal gestellt: ein Mann trägt das Hemd, die Chino und die Sneaker aus drei Shopfotos. Einmal als Studio-Prompt („Ganzkörper-Fotomodell, neutraler Studiohintergrund, Produktdetails originalgetreu“), einmal als Realismus-Prompt (Hamburger Straße bei bedecktem Himmel, Poren, ungleichmäßiger Teint, Bartschatten, lose Strähnen, kein Beauty-Filter, keine Retusche, 35-mm-Film mit Filmkorn).
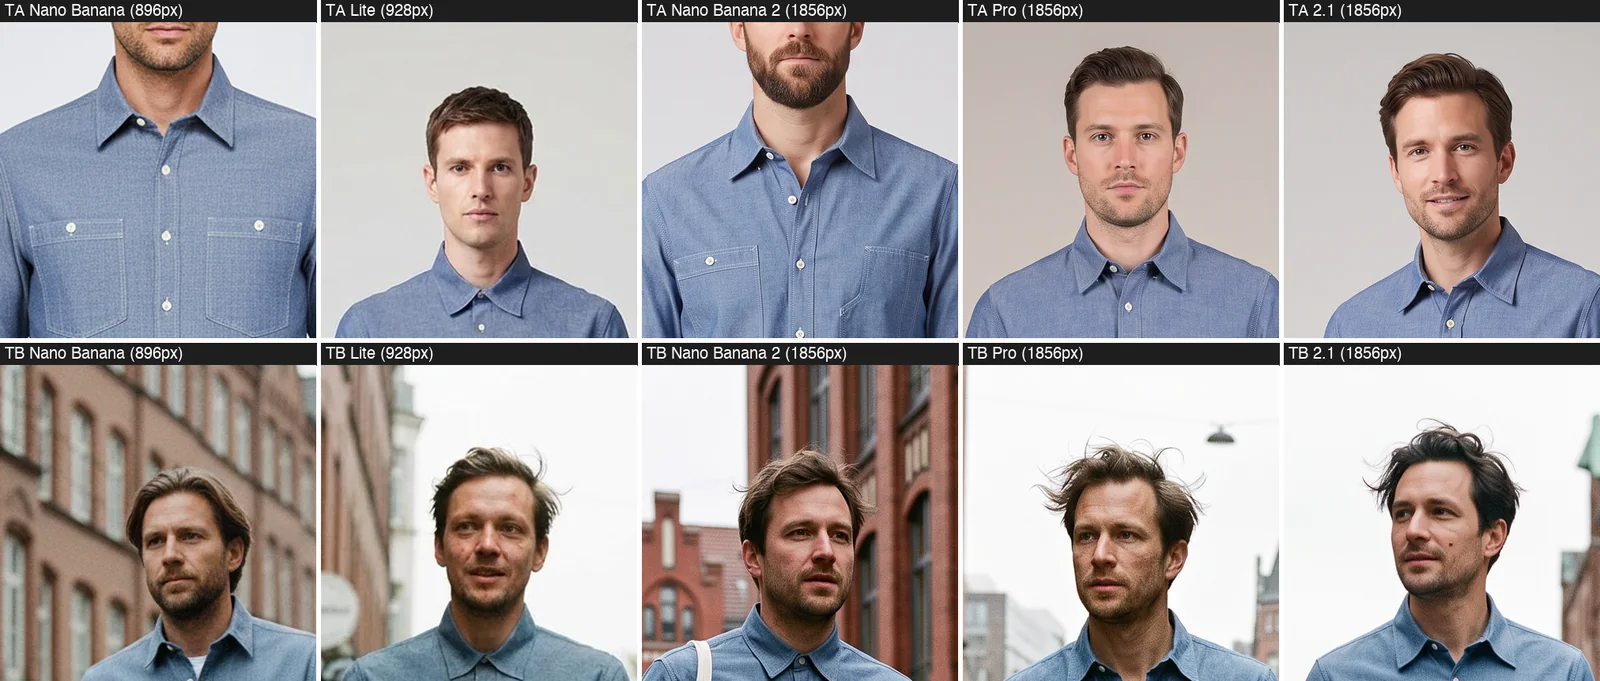
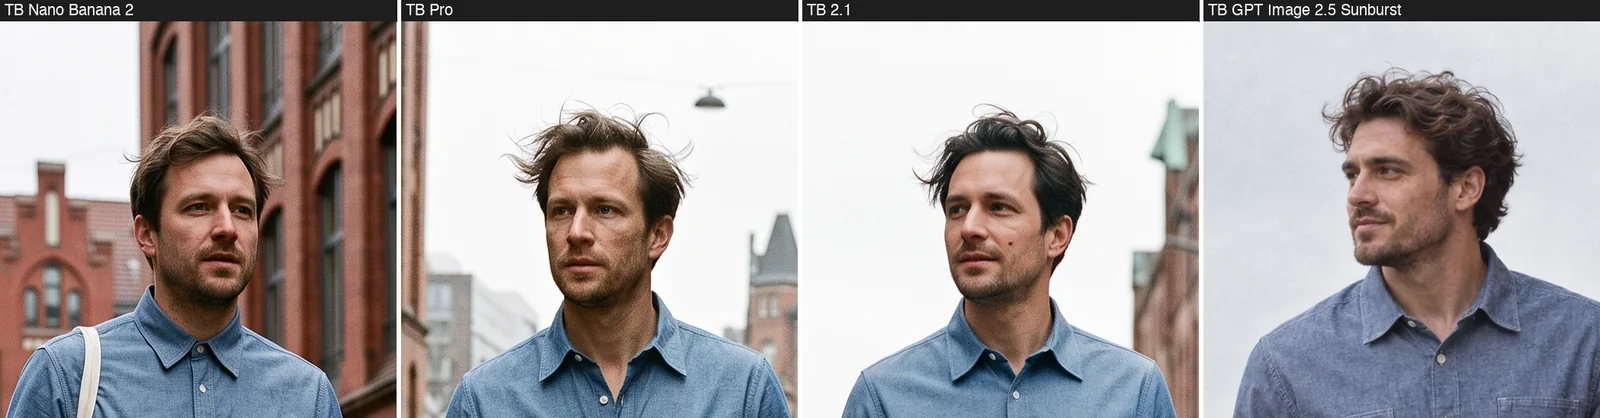
Mein Eindruck: Im Studio-Prompt wirken die Gesichter bei Lite, Pro und 2.1 glatt, symmetrisch und wie aus einem Katalog. Mit dem Realismus-Prompt ändert sich bei allen fünf Modellen sichtbar etwas, bei Pro und 2.1 am deutlichsten: abstehende Haare, ungleichmäßiger Teint, ein Muttermal. Die Bilder wirken auf mich deutlich weniger plastisch. Das ist ein Eindruck, kein Messwert. Urteile selbst an den Bildern.
Die Community sieht es ähnlich: Johanna Hendrix hat 14 Prompts über OpenRouter gefahren und kommt zu 2.1 zu dem Satz: „once again, Nano Banana 2.1 wins on maybe how natural it looks.“ Das Bild kostete laut OpenRouter-Anzeige im Video 3,6 Cent (YouTube). Auf Reddit klingt es anders: In r/GeminiAI schreibt ein Nutzer zu Nano Banana 2.1 in der Gemini-App, die Chat-Modelle schrieben seine Prompts um („Thinking models (Pro 3.1 and Flash 3.8 Thinking) rewrite my prompts blatantly“). Ob das auch für die API zutrifft, ist offen. Wichtig für dich: Wer 2.1 über die Gemini-App nutzt, bekommt womöglich einen anderen Prompt als den, den er tippt.
Alle fünf Modelle hielten bei der Anprobe die Merkmale der Referenzen: Hemd mit zwei Brusttaschen und Knöpfen, beige Chino mit Ring am Bund, weiße Sneaker. Dass die beiden Brusttaschen unterschiedlich aussehen, liegt am Original.
GPT Image 2.5 Sunburst habe ich mit demselben Realismus-Prompt ebenfalls laufen lassen. In meinem Eindruck sieht das Gesicht am gepflegtesten aus: lockiges Haar, Bartschatten, gleichmäßig ausgeleuchtet, wie aus einem Lookbook. Pro und 2.1 wirken rauer und zerzauster. Ob das für dich weniger plastisch ist, musst du an den Bildern entscheiden.
Der Realismus-Prompt als Werkzeug
Aus diesem Test habe ich ein Werkzeug gebaut. Es baut dir einen Realismus-Prompt aus Motiv, Ort, Licht und Kamera und prüft danach deinen eigenen Prompt auf Wörter, die im Test zum Katalog-Look geführt haben („perfekt“, „makellos“, „Studio“, „professionell“, „ultra realistisch“), und auf sechs Hinweise, die dem Modell sagen, wie ein echtes Foto aussieht: Haut, Haare, Licht, Kamera, Retusche, Ort. Die Wortliste ist eine Heuristik aus meinem Test, keine Messung.
Dein Prompt (zum Kopieren)
Eigenen Prompt prüfen
Grundlage ist mein Test mit zwei Prompts für dasselbe Foto (Studio-Prompt gegen Realismus-Prompt, je ein Lauf pro Modell) und die Wortliste dahinter ist eine Heuristik aus diesem Test, keine Messung. Kein Wort garantiert ein Ergebnis. Die Prüfung erkennt verneinte Wörter ("keine Retusche", "nicht perfekt") und zählt sechs Hinweise: Haut, Haare, Licht, Kamera, Retusche, Ort.
Alle Bilder von Nano Banana 2.1 tragen laut Googles Anleitung ein unsichtbares SynthID-Wasserzeichen. Content Credentials (C2PA) nennt nur die Cloud-Dokumentation, ob sie in der Gemini-App und API gesetzt werden, ist nicht belegt.
Befund 3: Anzeigen, Infografiken und Text im Bild
Text im Bild gehört bei Shops, Blogs und Magazinen zum Alltag: Meta-Anzeigen, Display-Banner, Infografiken im Artikel, Preistabellen, Titelbilder. Ich habe vier Meta-Anzeigen mit dem echten Troyer als Referenz bauen lassen (Feed, Story, Testimonial, Angebot). Es sind reine Testbilder, keine laufenden Kampagnen. Mehr zu den Anzeigenformaten im Vergleich von Google Ads, Meta Ads und ChatGPT Ads.
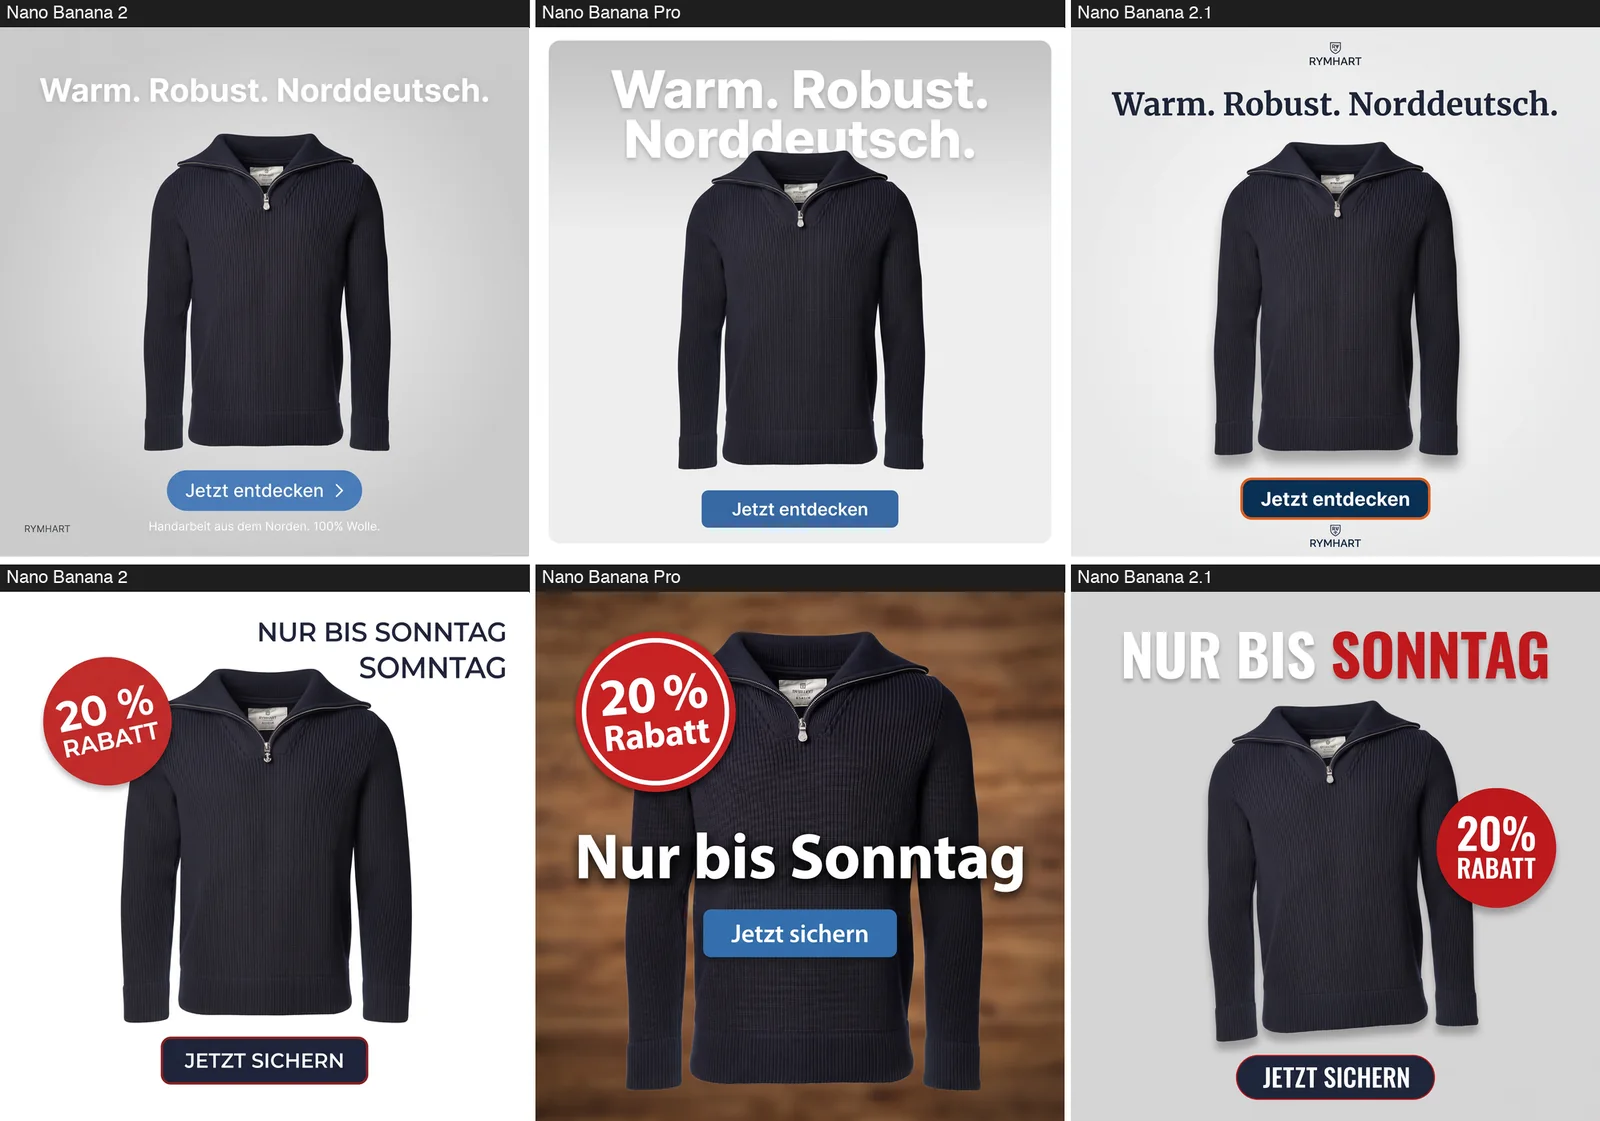
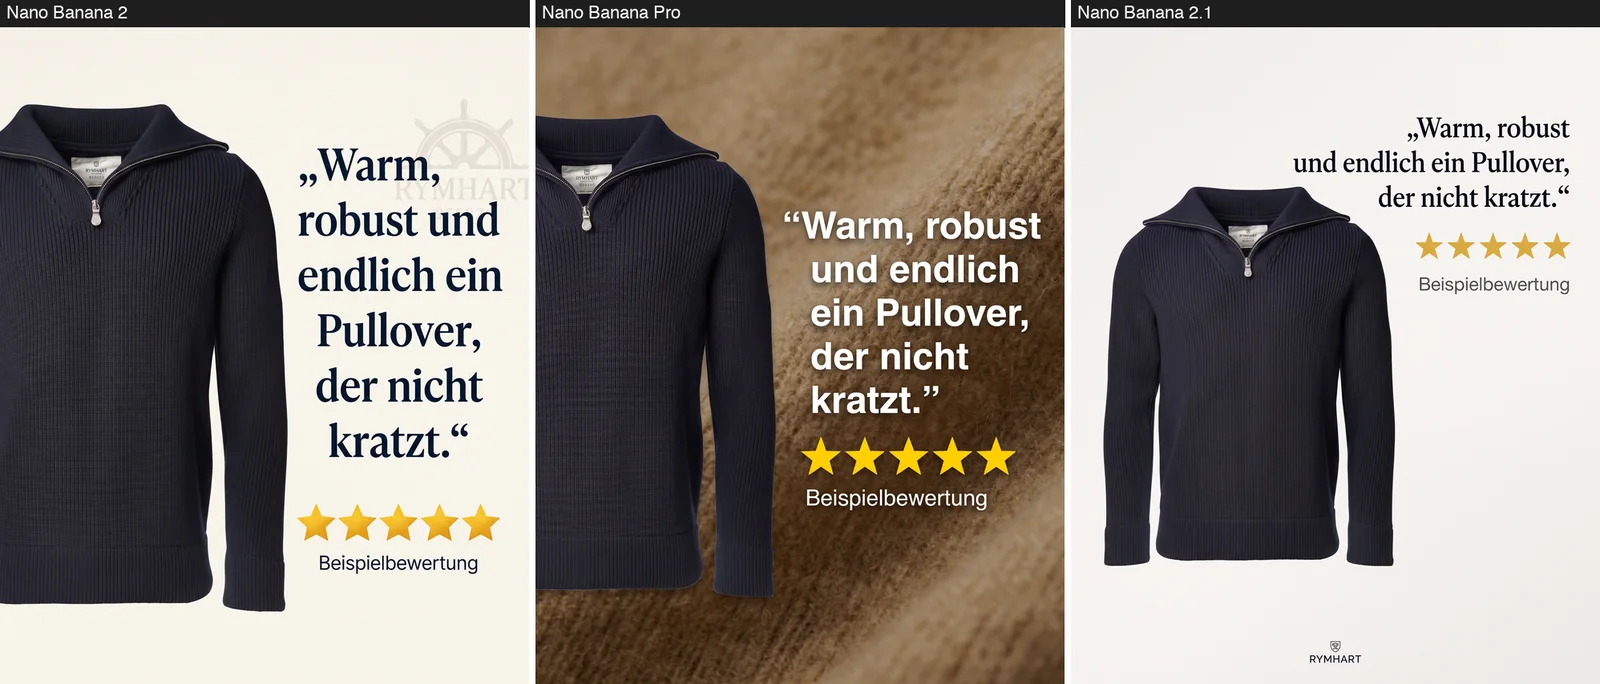
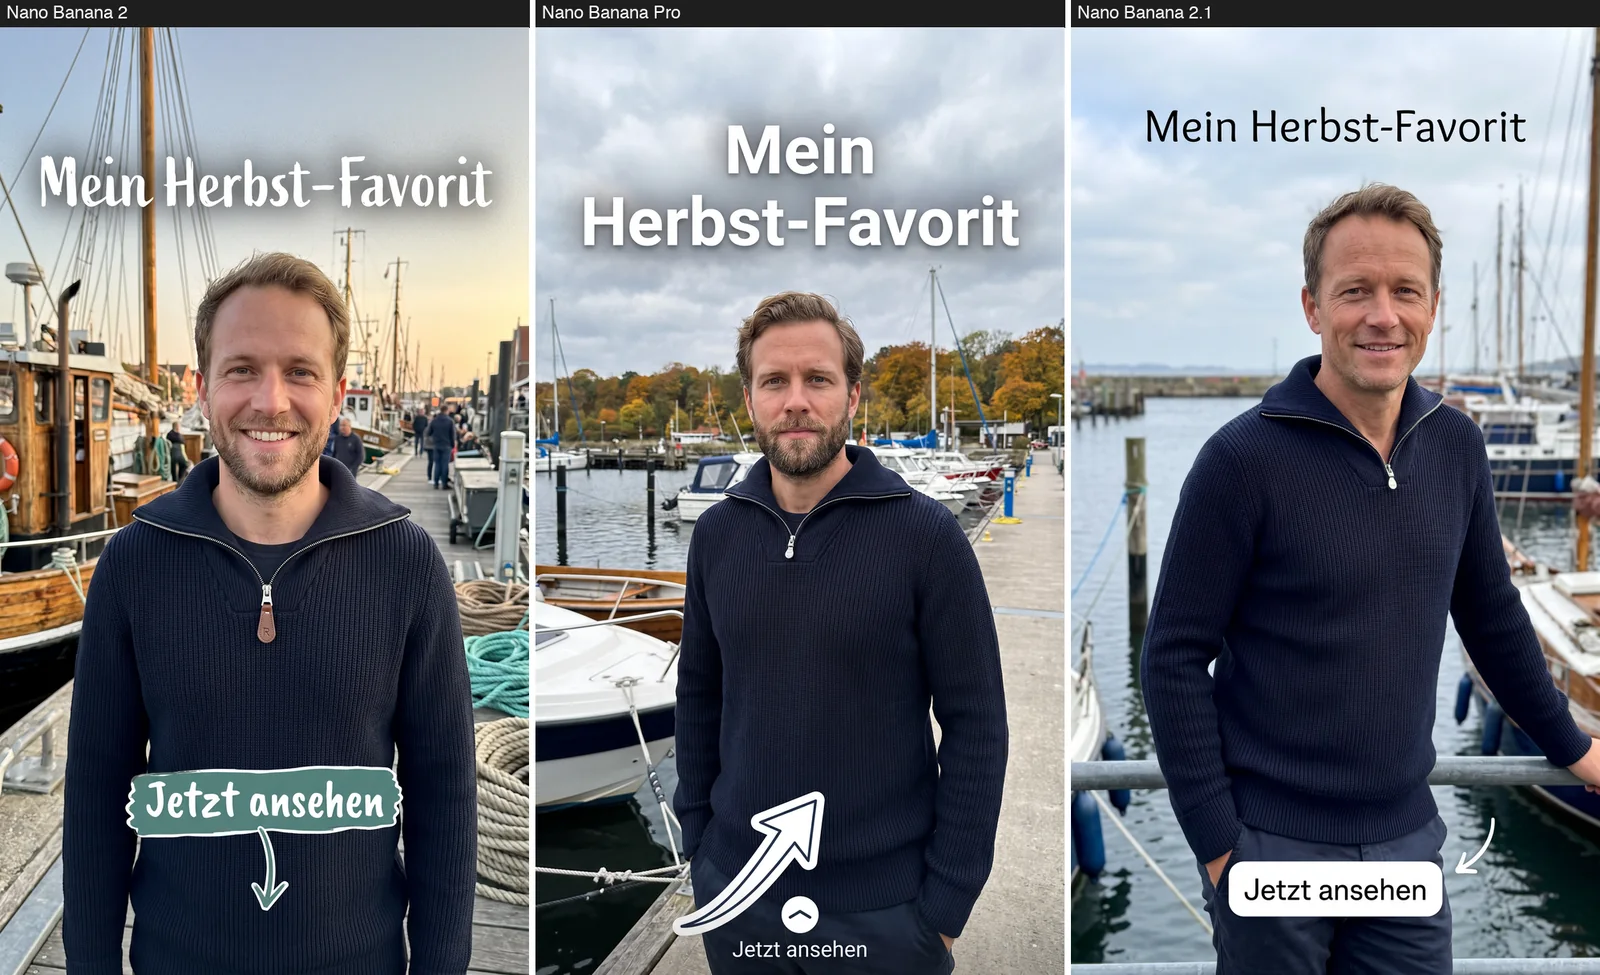
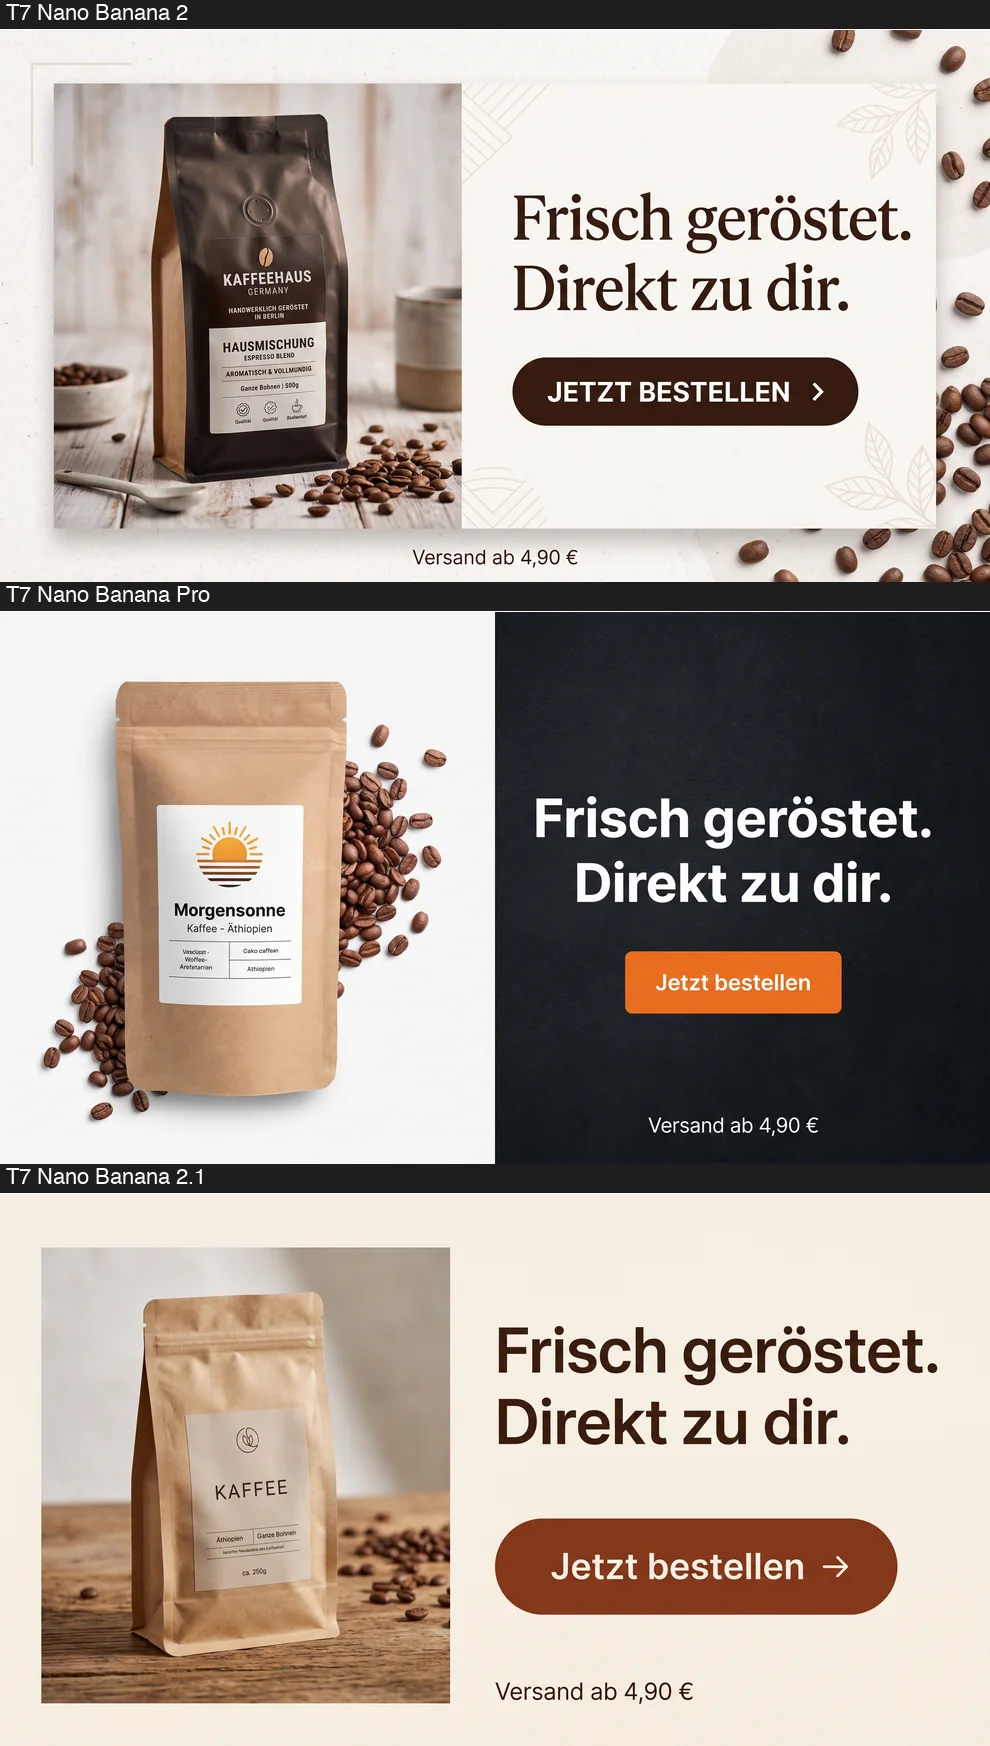
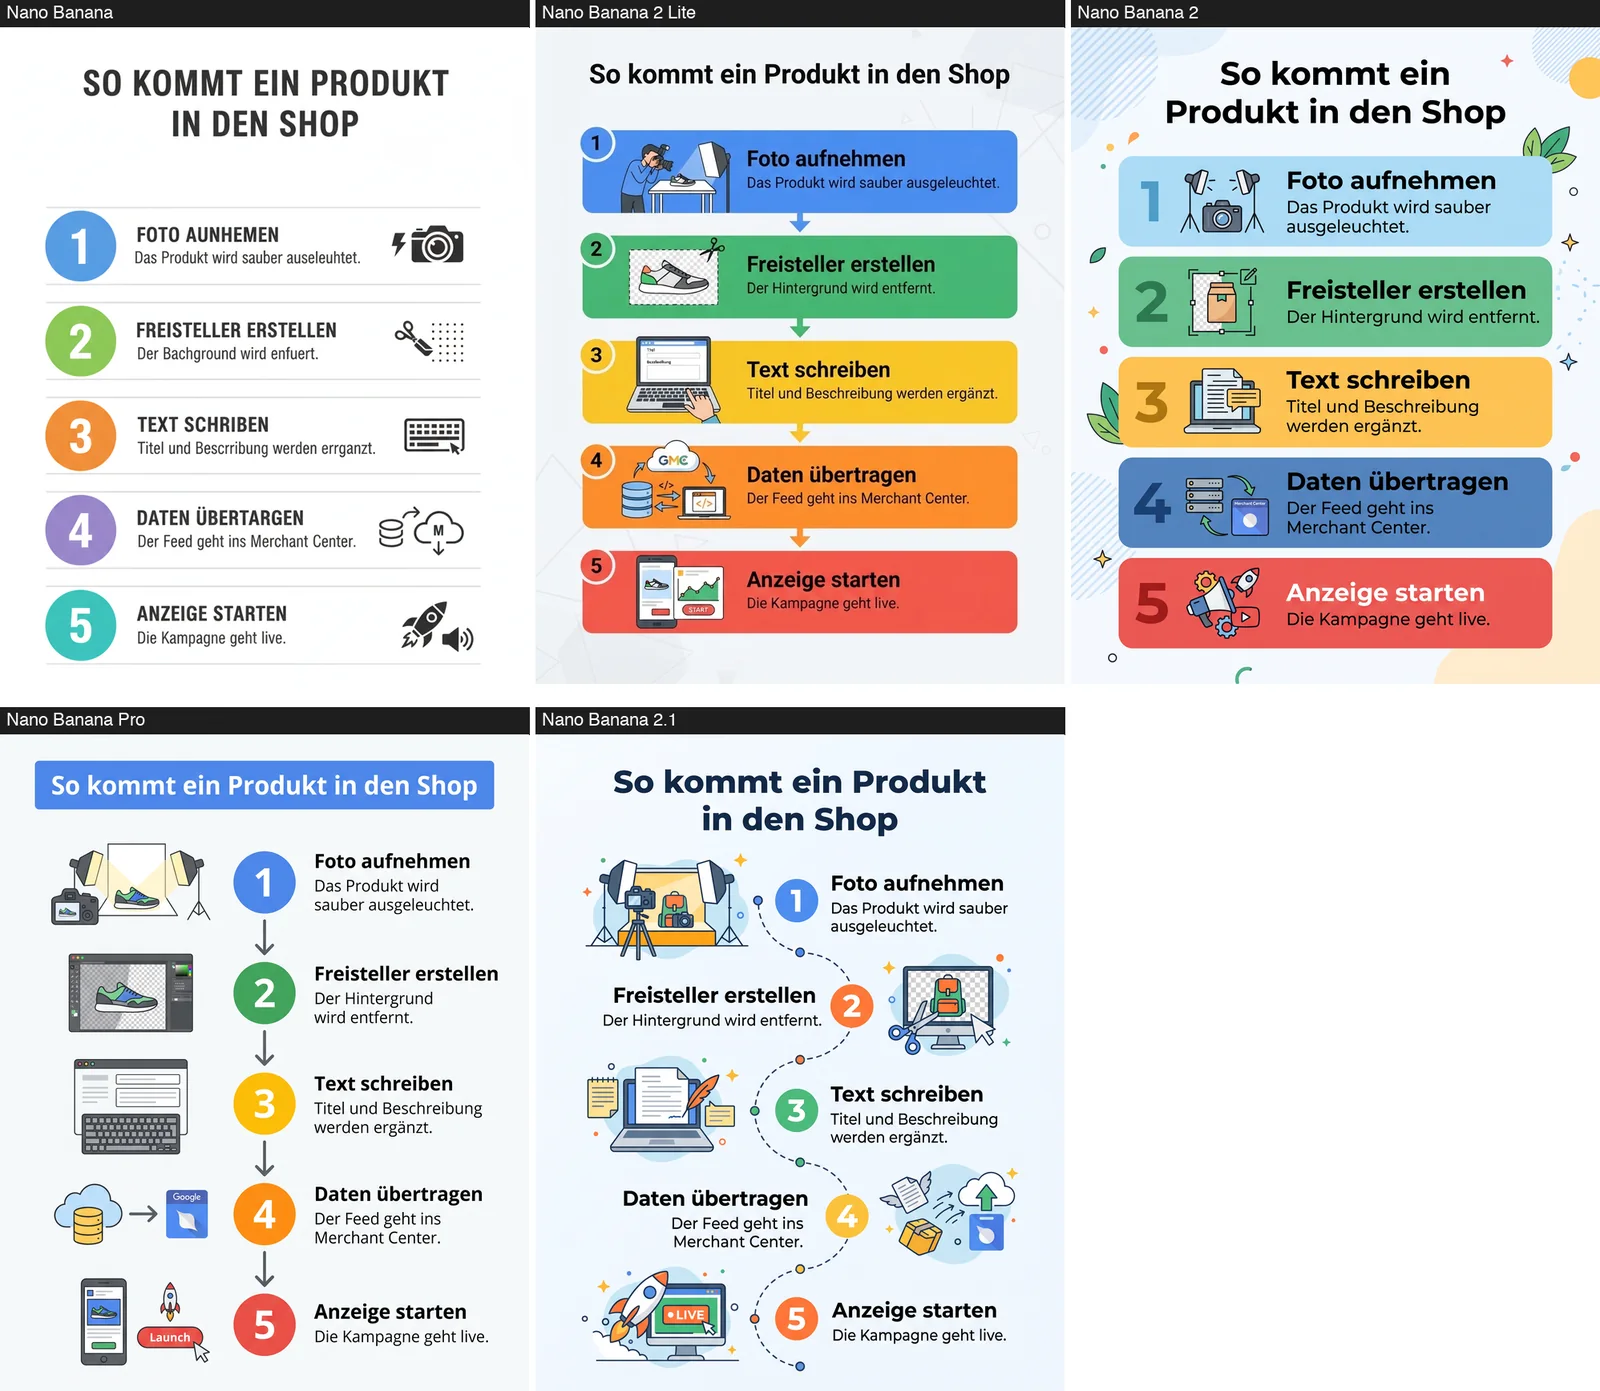
Pro und 2.1 schreiben alle Texte in den vier Anzeigen fehlerfrei (Headline, Button, Zitat, Sticker). Nano Banana 2 liefert in der Feed-Anzeige die erfundene Zeile „Handarbeit aus dem Norden. 100% Wolle.“ und schreibt in der Angebotsanzeige „SOMNTAG“. Der erfundene Materialhinweis ist der gefährlichere Fehler. Ein Tippfehler fällt auf, eine plausible falsche Aussage zu Material, Herkunft oder Größe rutscht durch. In einem Artikel wäre das die erfundene Zahl in der Infografik. 2.1 hat in den vier Troyer-Anzeigen nichts dazuerfunden, schreibt „20% RABATT“ aber ohne Leerzeichen (nicht in den Punkten). Auch JP Caparas beobachtet, dass 2.1 Satzzeichen weglässt und ungefragte Untertitel ergänzt. Ohne Referenz erfinden alle drei Modelle: In der Display-Anzeige für Kaffee, bei der ich keine Tüte vorgegeben hatte, zeigt jede Tüte ein ausgedachtes Etikett („KAFFEEHAUS GERMANY“, „Morgensonne“, „KAFFEE“), bei Nano Banana 2 mit dem Tippfehler „HANDWERKLICH“.
Bei Diagramm, Infografik und Preistabelle sieht es ähnlich aus: Nano Banana 2, Pro und 2.1 bestehen alle zwölf Prüfpunkte (Titel, Werte, Achsen, Schritte, Preise). Das ursprüngliche Nano Banana macht Tippfehler („AUNHEMEN“, „500 B Speicher“). Das ist ein deutlicher Fortschritt gegenüber der ersten Generation, aber keiner zwischen Nano Banana 2 und 2.1.
Über Merchant Center und Google Ads: Google nennt Google Ads im Start von 2.1, zu einer konkreten Funktion für Werbetreibende habe ich am Starttag nichts Belegtes gefunden. KI-erzeugte Produktbilder müssen im Merchant Center laut Hilfeseite den IPTC-Tag „trainedAlgorithmicMedia“ behalten. Ob die API-Ausgabe diesen Tag selbst setzt, ist nicht belegt. Wie Produktbilder in Google-Listings wirken, zeigt der Shop-Test zu Produktkarussells.
Befund 4: Zählen, Karten, Personen, Autos
Hier sind die Fehler der Modelle am deutlichsten. Jedes macht in meinem Test mindestens einen Fehler, den ein Mensch sofort sieht.
- Zählen: „genau 3 Tassen, 2 Teller, 1 Vase mit 4 Tulpen“. 2.1 zeigt vier Teller, Pro drei, Nano Banana 2 fünf Tulpen. Alle zählen die Tassen und die Vase richtig.
- Genau vier Personen: 2.1 zeigt fünf, alle anderen vier.
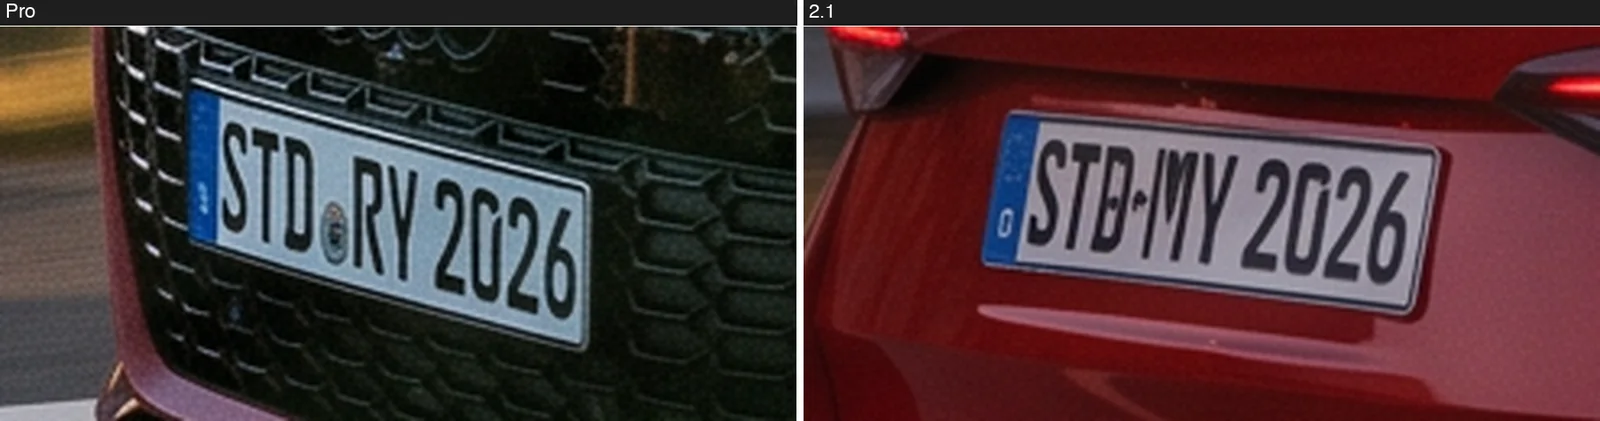
- Kennzeichen „STD-RY 2026“: Nur Pro schreibt es richtig. 2.1 bildet es verfälscht ab, Nano Banana 2 liest „STD BY 2826“. Außerdem zeigt Nano Banana 2 ein erkennbares Opel-Emblem, obwohl ich „ohne erkennbare Marke“ verlangt hatte.
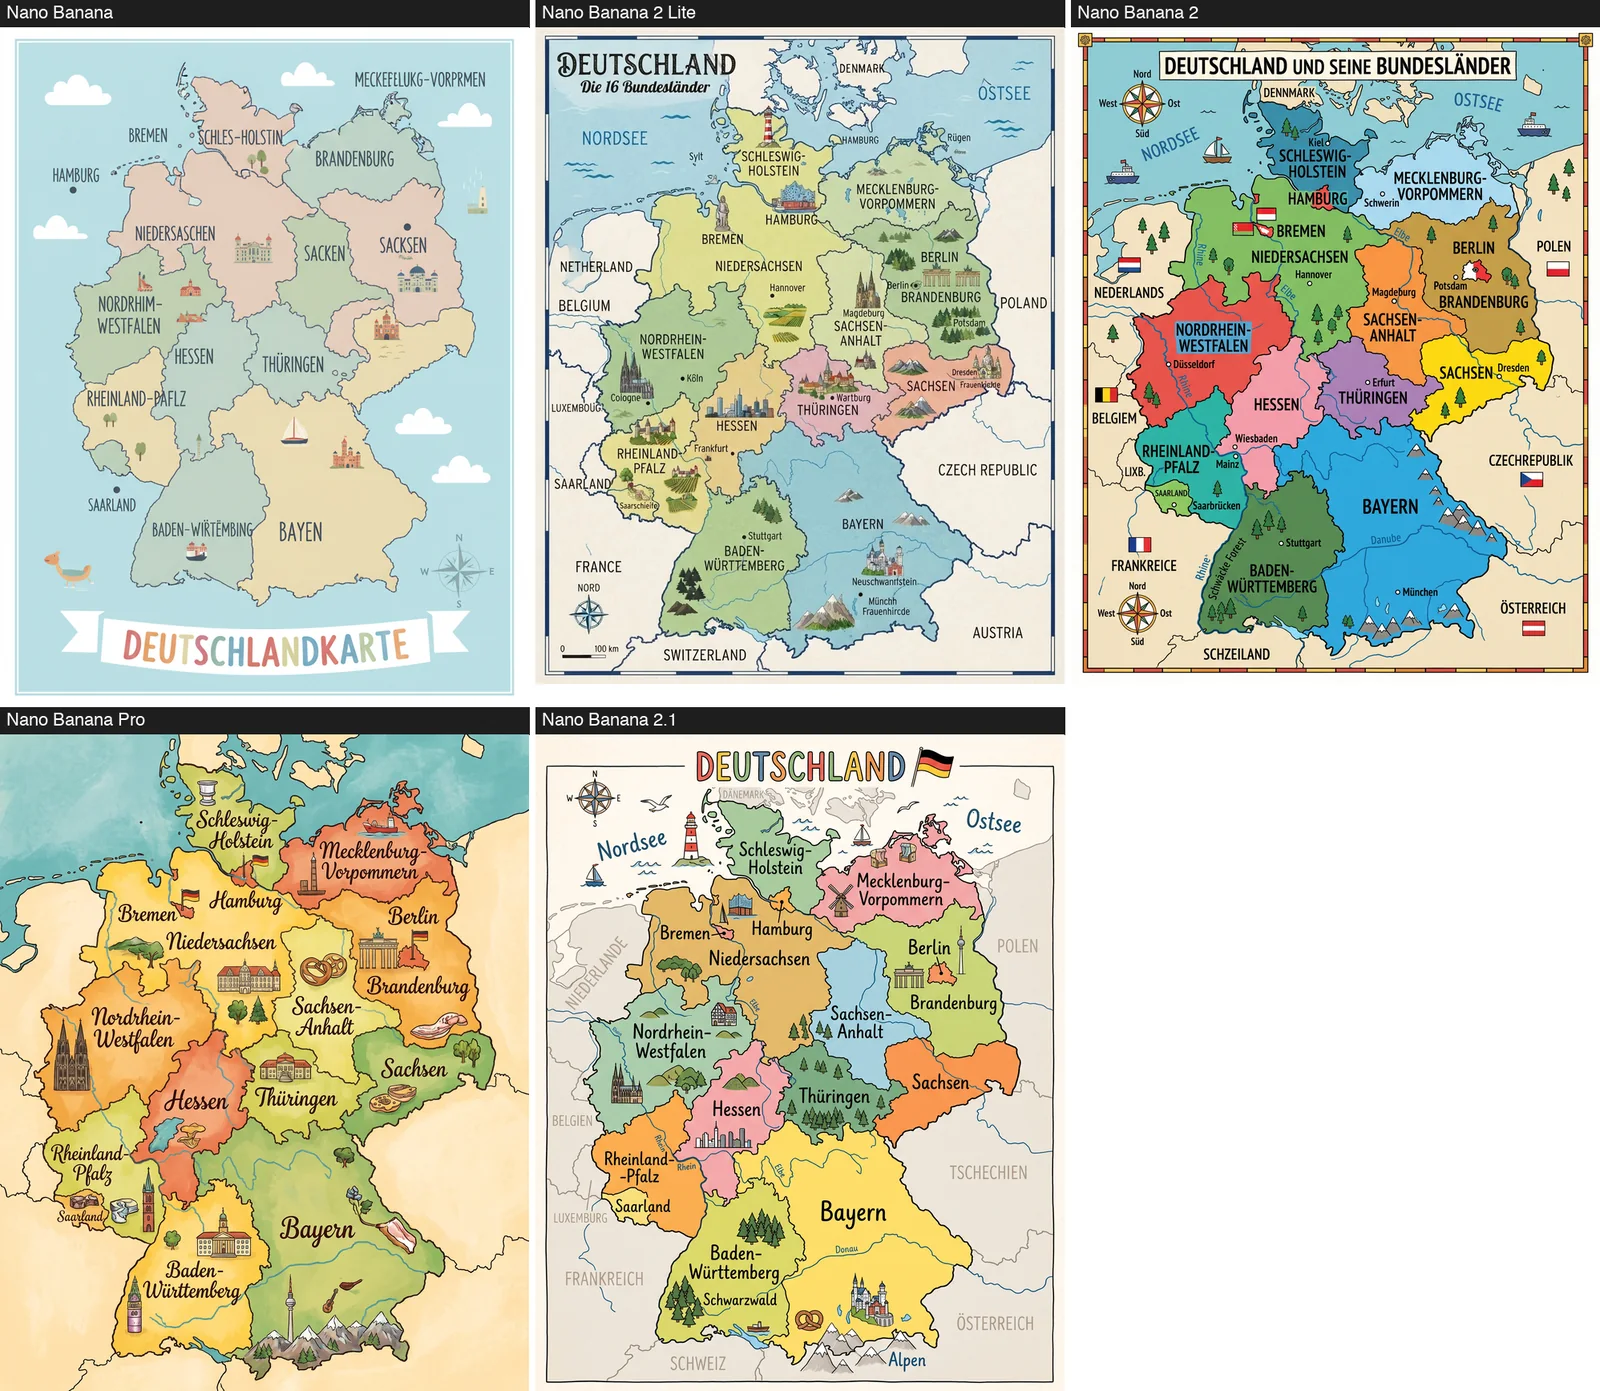
- Deutschlandkarte mit 16 Ländern: Alle 16 Namen schreiben Lite, Nano Banana 2 und Pro richtig, 2.1 setzt bei Rheinland-Pfalz einen zweiten Bindestrich und beschriftet einen Fluss in Bayern als „Elbe“. Nano Banana 2 schreibt die Nachbarländer falsch („BELGIEM“, „SCHZEILAND“). Das erste Nano Banana macht aus „Mecklenburg-Vorpommern“ „MECKEFELUG-VORPRMEN“.
- Karte Norddeutschland: alle drei Hauptmodelle beschriften Hamburg, Bremen, Stade, Cuxhaven, Hannover und Kiel richtig und halten die Reihenfolge an der Elbe.
Befund 5: Thumbnails, Titelbilder und Hintergründe
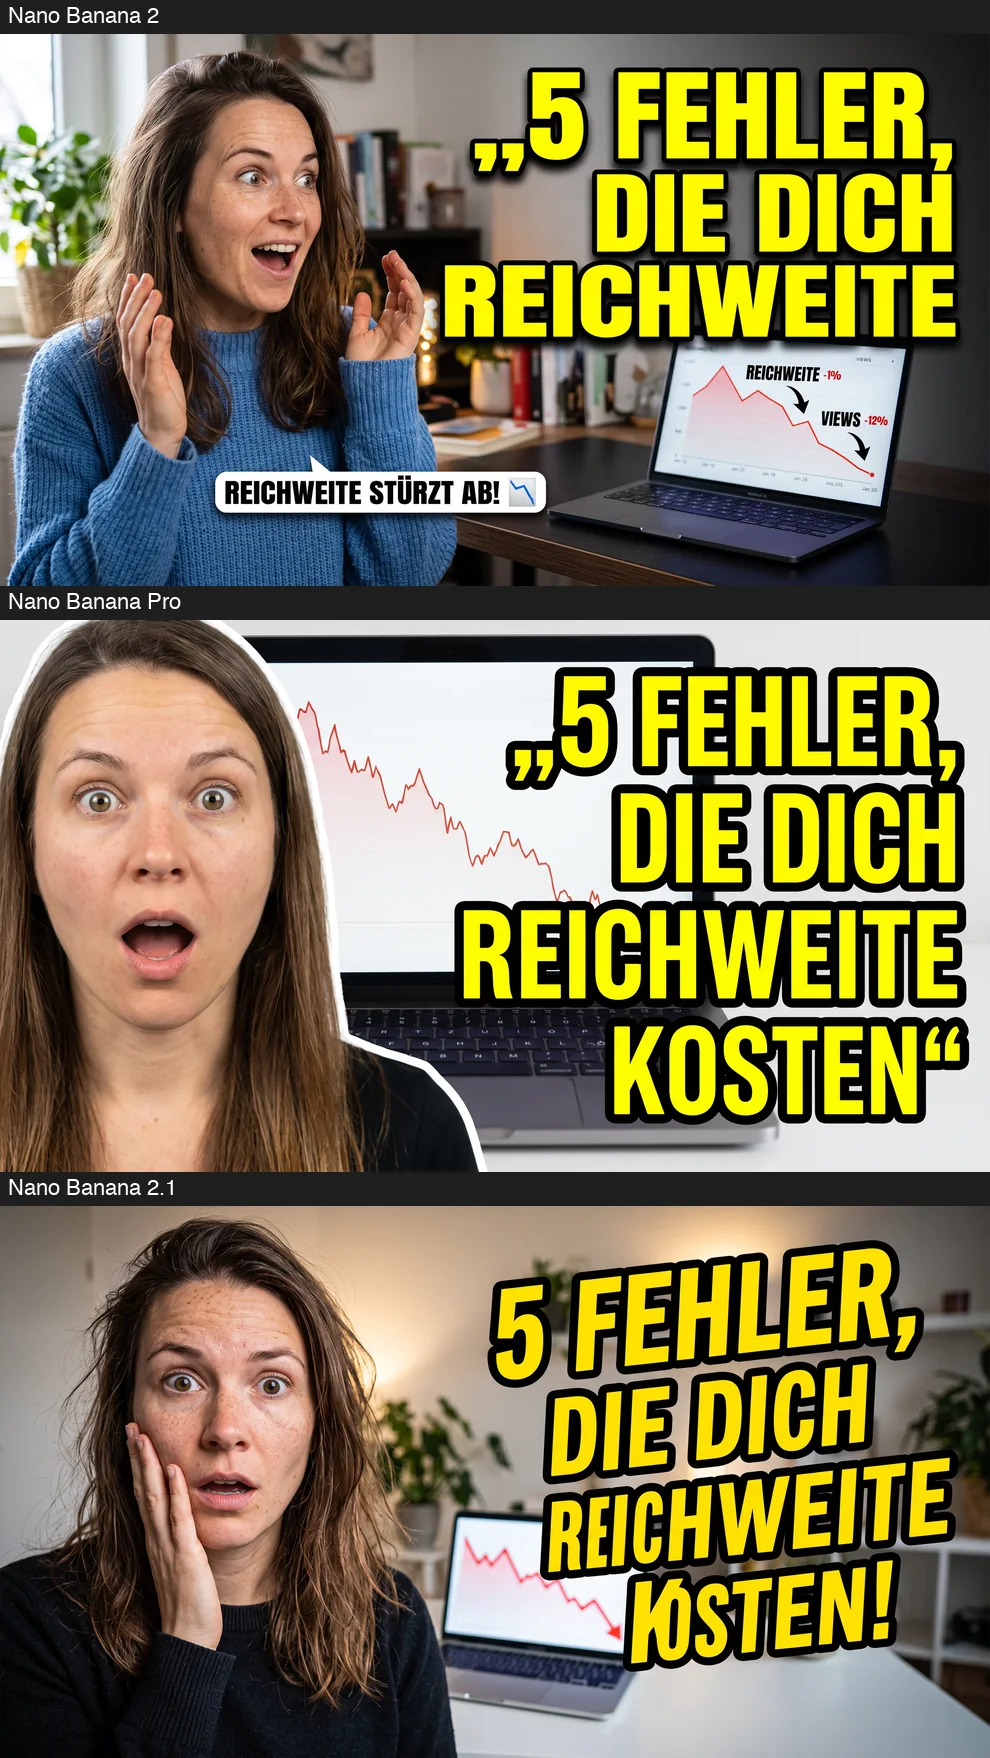
Nano Banana nutzen nicht nur Shops, sondern auch Blogs, Magazine, Webseiten und YouTuber. Deshalb habe ich einen typischen Creator-Auftrag nachgeschoben: ein YouTube-Thumbnail mit überraschtem Gesicht, einem großen gelben Satz („5 FEHLER, DIE DICH REICHWEITE KOSTEN“) und einem Laptop mit fallendem Diagramm. Die Kriterien standen vorher fest: Wortlaut exakt, Laptop mit fallendem Diagramm, bei 320 Pixel Breite lesbar.
Nur Pro schreibt den ganzen Satz fehlerfrei und bekommt alle drei Punkte. Nano Banana 2 lässt das letzte Wort „KOSTEN“ weg, erfindet dafür eine Sprechblase („REICHWEITE STÜRZT AB!“) und Beschriftungen im Diagramm („VIEWS -12%“). 2.1 schreibt alle Wörter, hängt aber ein Ausrufezeichen an und verformt das K in „KOSTEN“. Beide kommen auf 2 von 3 Punkten. Die Anführungszeichen aus meinem Prompt haben Nano Banana 2 und Pro mit ins Bild gesetzt, die habe ich nicht gewertet. Das Gesicht wirkt bei 2.1 am wenigsten nach Katalog (zerzauste Haare, Sommersprossen), das ist mein Eindruck. Auch Paul J Lipsky ließ ein Thumbnail mit eigenem Foto erzeugen und sah 2.1 dort vorn.
Was du jetzt tun kannst
- Lass das Modell Gesicht, Szene und Hintergrund erzeugen und setze den Satz selbst im Bildprogramm. Dann fehlt kein Wort, und das Modell erfindet keinen Zusatztext.
- Halte Text im Bild kurz. Je weniger Wörter, desto seltener passiert ein Fehler, und das Thumbnail bleibt auch klein lesbar.
- Kontrolliere Thumbnails, Titelbilder und Infografiken Wort für Wort, bevor du veröffentlichst.
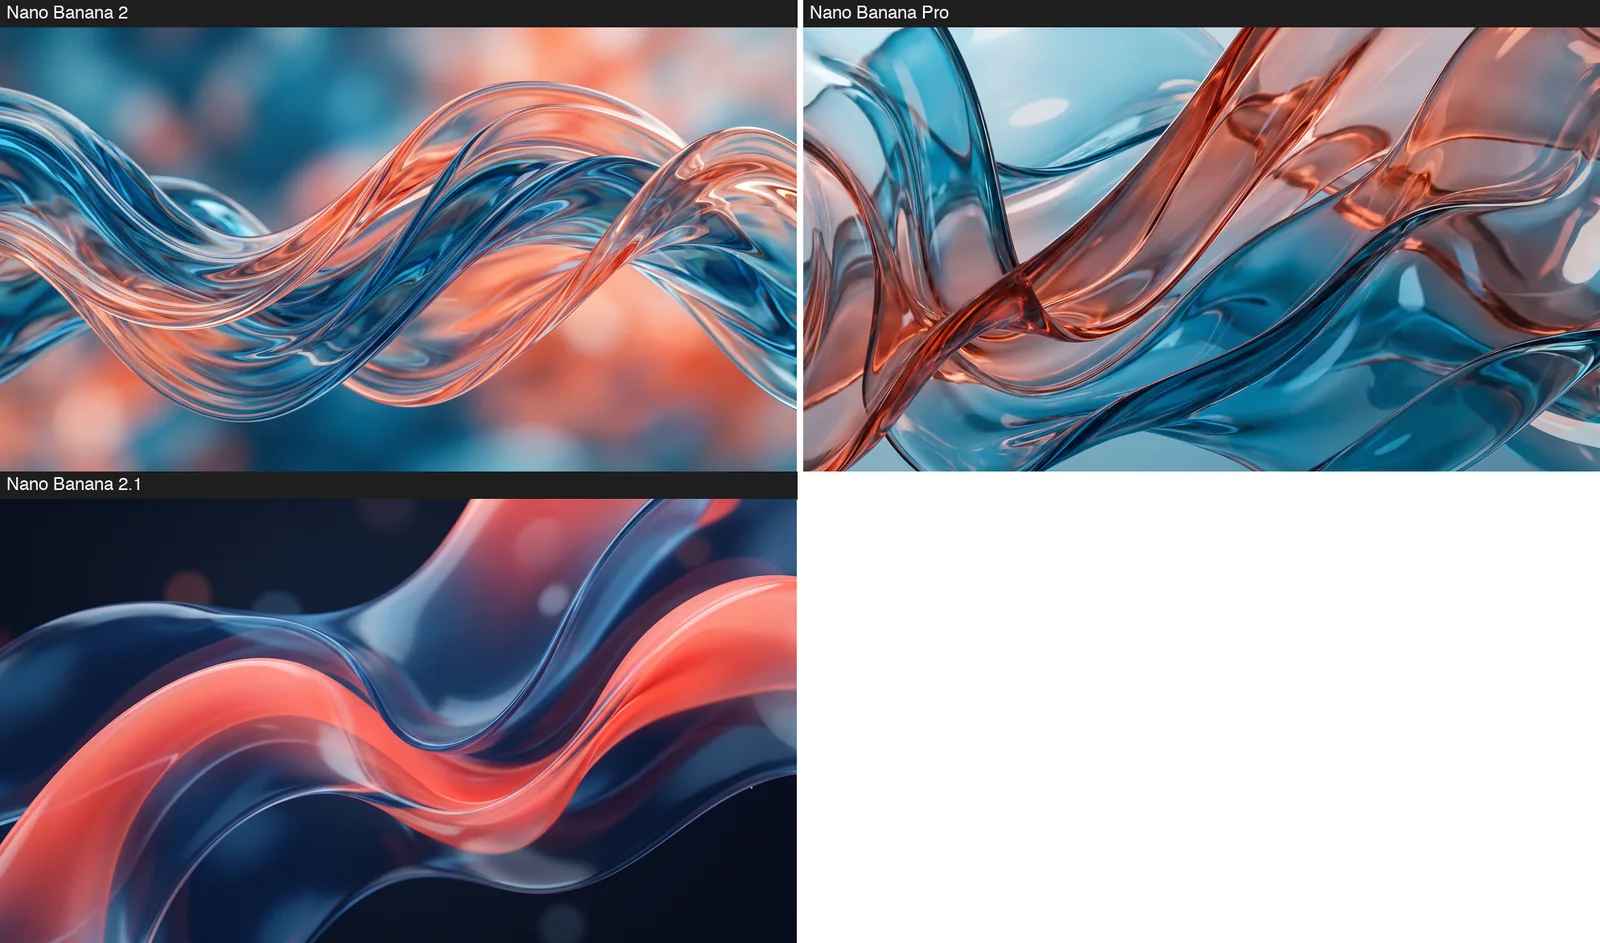
Für abstrakte Hintergründe ohne Text, etwa für Webseiten, Blogs oder Magazin-Header, gibt es dagegen wenig zu verlieren: Alle drei Modelle lieferten ein Bild ohne Text. Nano Banana 2 zeichnet weiche blau-korallfarbene Glasbänder mit unscharfem Licht, Pro hellere und kantigere Glasflächen, 2.1 einen dunkelblauen Hintergrund mit einem korallroten Band. Das ist Geschmack. Entscheiden würde ich hier über den Preis.
Welches Modell für welche Aufgabe?
Aus den Ergebnissen habe ich eine Auswahlhilfe gebaut. Wähle eine Aufgabe, sieh die Punkte aller getesteten Modelle und lass dir das günstigste Modell mit der höchsten Punktzahl nennen. Der Befund unter dem Ergebnis sagt, woran die Punkte hängen.
| Aufgabe | Punkte möglich | Nano Banana 2.1 | Nano Banana 2 | Nano Banana Pro | Nano Banana 2 Lite | Nano Banana (2.5) | GPT Image 2.5 Sunburst |
|---|---|---|---|---|---|---|---|
| Etikett als Makro (Pflicht-Referenzen, Regeln) | 4 | 4 | 4 | 4 | nicht getestet | nicht getestet | 4 |
| Zipper-Anhänger als Makro (Pflicht-Referenzen, Regeln) | 4 | 4 | 4 | 4 | nicht getestet | nicht getestet | 4 |
| Kragen-Nahaufnahme in neuer Farbe (Pflicht-Referenzen) | 4 | 4 | 4 | 4 | nicht getestet | nicht getestet | 4 |
| Ganze Jacke in neuer Farbe: Etikett und Zipper im Gesamtbild | 8 | 4 | 5 | 4 | nicht getestet | nicht getestet | 6 |
| Produkt in neue Szene setzen, Referenzbild | 12 | 12 | 12 | 12 | nicht getestet | nicht getestet | nicht getestet |
| Mehrere Teile anziehen: Hemd, Chino, Sneaker | 6 | 6 | 6 | 6 | 6 | 6 | nicht getestet |
| Deutscher Text in Diagramm, Infografik und Tabelle | 12 | 12 | 12 | 12 | 11 | 6 | nicht getestet |
| Deutschlandkarte mit allen 16 Bundesländern | 16 | 15 | 16 | 16 | 16 | 6 | nicht getestet |
| Anzeige mit Text und Produkt (Meta, Display) | 19 | 19 | 17 | 19 | nicht getestet | nicht getestet | nicht getestet |
| Auto mit lesbarem Kennzeichen | 1 | 0 | 0 | 1 | nicht getestet | nicht getestet | nicht getestet |
| Zählen: 3 Tassen, 2 Teller, 1 Vase mit 4 Tulpen | 4 | 3 | 3 | 3 | nicht getestet | nicht getestet | nicht getestet |
| Gruppe aus genau vier Personen | 1 | 0 | 1 | 1 | 1 | 1 | nicht getestet |
| YouTube-Thumbnail mit Gesicht, Text und Diagramm | 3 | 2 | 2 | 3 | nicht getestet | nicht getestet | nicht getestet |
| Karte Norddeutschland mit sechs Orten | 3 | 3 | 3 | 3 | nicht getestet | nicht getestet | nicht getestet |
Preisgrundlage der Empfehlung: Google-Preisliste für ein 1K-Bild (Nano Banana 2.1 und Lite 0,0336 $, Nano Banana 2 0,067 $, Nano Banana Pro 0,134 $, Nano Banana 0,039 $), umgerechnet mit dem EZB-Referenzkurs vom 06.10.2026 (1 € = 1,1269 $). GPT Image 2.5 Sunburst lief nur bei den vier Etikett-Aufgaben (Pflicht-Referenzen) mit und hat in der Auswahlhilfe keinen Dollar-Preis, in Magnific kostet es 600 Credits je 2K-Bild auf Stufe max. Nicht jede Aufgabe lief mit allen sechs Modellen. Mit einem Lauf je Prompt und Modell zeigen zwei Punkte Unterschied noch keinen sicheren Vorsprung.
Wo mehrere Modelle gleich viele Punkte haben, ist das günstigste das Standardmodell. Das ist in meinem Test fast immer 2.1 oder Lite. Wo ein Modell klar zurückliegt (erstes Nano Banana bei Text, Karten und Diagrammen), siehst du es sofort. Die Tabelle unter dem Werkzeug zeigt alle Punkte auf einmal.
Was es kostet: API günstig, Magnific teurer
Für die API gilt: 2.1 ist bei 1K und 2K deutlich günstiger als Nano Banana 2 und Pro, bei 4K nur noch rund ein Viertel günstiger als Nano Banana 2. In Magnific ist es umgekehrt: 2.1 braucht 100 Credits je 2K-Bild, Nano Banana 2 und Pro je 75 (Nano Banana 2 Lite 60, das erste Nano Banana 50). Wer Bilder im Abo über Magnific erzeugt, zahlt mit 2.1 also ein Drittel mehr Credits je Bild. Ob das ein Einführungspreis ist, ist offen.
Rechne mit deinen Zahlen. Wichtig sind die Fehlversuche: Wer drei Versuche je fertigem Bild braucht, zahlt dreimal den Bildpreis. Das wiegt mehr als der Unterschied von 0,0336 zu 0,067 $.
Rechenweg: fertige Bilder mal Versuche mal Preis je erzeugtem Bild, umgerechnet mit dem EZB-Referenzkurs vom 06.10.2026 (1 € = 1,1269 $). Listenpreis je Bild (1K / 2K / 4K): Nano Banana 2.1 0,0336 / 0,0504 / 0,113 $, Nano Banana 2 0,067 / 0,101 / 0,151 $, Pro 0,134 / 0,134 / 0,24 $. Der Listenpreis erfasst nur die Bildausgabe, Eingabe und Denken kommen dazu. Deshalb gibt es die zweite Rechenart mit den Durchschnittskosten, die der Tester JP Caparas am 07.10.2026 über die Gemini API gemessen hat (1K, Listenpreise inklusive Eingabe und Denken): 2.1 minimal 0,038 $, medium 0,046 $, high 0,053 $, Nano Banana 2 mit hohem Denken 0,073 $, Pro 0,140 $. Für Nano Banana 2 liegt nur der Wert mit hohem Denken vor. Magnific rechnet mit Credits statt Dollar: 2.1 kostet dort 100 Credits je 2K-Bild, Nano Banana 2 und Pro je 75 (Magnific-Kostenrechner, 06.10.2026, Format 4:5). Zum Vergleich kostet GPT Image 2.5 Sunburst dort 600 Credits auf Stufe max und 180 auf medium (Kostenrechner, 07.10.2026), im Rechner ist es nicht enthalten. Batch-Preise (halber Preis), Preise von Drittanbietern und Suchgrounding sind nicht eingerechnet.
Was die Community sagt
Alle Stimmen stammen aus den ersten 24 Stunden. Der Rollout war noch im Fluss, und viele Berichte beziehen sich auf Gemini-App und Flow statt auf die API.
- Der gründlichste Test: JP Caparas hat 34 Aufgaben mit sechs Konfigurationen über die Gemini API gefahren (419 Bilder, zwei Modell-Richter). Das Fazit des Tests: Beim Gesamteindruck ist 2.1 das beste Nano Banana, bei Text liegt Pro vorn („Text is where 2.1 loses.“). Pro bekam 98,3 Prozent der Textstellen exakt richtig, 2.1 mit hohem Denken 92,5 Prozent. Beim Periodensystem schlug 2.1 Pro klar. Empfohlen wird der Umstieg, mit Pro als Rückfall für Texte, die nicht falsch sein dürfen.
- YouTube: Paul J Lipsky (von OpenArt gesponsert) fand den ersten Test schwach für 2.1, bei Infografik und Thumbnail lag es vorn. AgentenFabrik nennt 2.1 ein „starkes Modell in der Bildbearbeitung“, für Text zu Bild sei es „nicht stark“. AI Jitan Lab sieht GPT Image 2.5 bei der gleichen Figur über mehrere Bilder vorn, lobt aber den halbierten Preis. In der Arena stehen vier Modelle vor 2.1: drei von OpenAI und mai-image-2.6 von Microsoft.
- Reddit (r/GeminiAI): überwiegend negativ, vor allem aus der Gemini-App. Mehrere Nutzer schreiben, die Prompttreue sei schlechter als bei Nano Banana 2 („Does not listen to prompts even remotely.“). Ein Nutzer berichtet dagegen: „Character consistency definitely improved.“ Ein einzelnes Bild habe aber 10 bis 15 Prozent seines Pro-Kontingents verbraucht. Beachte: Tester über API oder Drittplattformen urteilen im Schnitt freundlicher als App- und Flow-Nutzer. Das ist eine Beobachtung, kein Beweis.
- Hacker News: Ein Nutzer testet einen Makro-Prompt zum Uhrmacher und schreibt: „All the usual issues seem basically resolved.“ Ein Einzeltest.
- LinkedIn: Am Abend des Starts fand die Suche nur drei Beiträge, darunter ein Hinweis auf den Test von JP Caparas und eine Zusammenfassung der Preisangaben. Eigene Messungen waren nicht dabei.
Mein Eindruck aus Community und eigenem Test deckt sich: 2.1 ist beim Gesamteindruck, bei Diagrammen und beim Preis (API) stark, bei exakten Vorgaben (Zahlen, Kennzeichen, Etikett, Personenzahl) nicht verlässlicher als seine Vorgänger.
Meine Empfehlung
Zuerst die Einordnung: RYMHART ist hier mein Testfeld. Bei RYMHART entstehen Produkt- und Personenfotos nach wie vor in echter Handarbeit, mit dem Fotografen im Haus. Logos und Menschen sind für KI schwer darzustellen, und es funktioniert nur halb gut. Genau deshalb sind Etikett, Emblem und Zipper ein hartes Testbeispiel, und ich kann dafür eigene Produkte nutzen, ohne mit fremdem Material zu arbeiten. Mein Test bestätigt die Grenze zum Teil. Mit Pflicht-Referenzen, fester Regel und Makro stimmen Etikett und Zipper bei allen vier getesteten Modellen. In der Ganzansicht, in der Logo und Anhänger klein sind, stimmt es auch bei GPT Image 2.5 Sunburst nicht fehlerfrei, und bei Menschen bleibt die Darstellung schwierig. Ich selbst nutze KI-Bilder dagegen immer, genau dort, wo kein echtes Produkt und kein echtes Gesicht stimmen muss: Hintergründe, Illustrationen, Infografiken, Titelbilder.
Nutze Nano Banana 2.1 als Standard für Szenen, Layouts, Titelbilder und Infografiken in Shop, Blog, Magazin und Webseite, wenn du über die API arbeitest. Du zahlst für ein 1K-Bild rund die Hälfte von Nano Banana 2 und rund ein Viertel von Pro. Wer in der API noch gemini-3.1-flash-image einsetzt, muss bis zum 29.10.2026 umziehen. Beim Umzug gilt eine neue Standard-Denkstufe (medium). Setze „minimal“, wenn du Tempo und Preis willst, und „high“ bei Zahlen und Beschriftungen.
Alles, was exakt stimmen muss, brauchst du nicht dem Modell zu überlassen: Etiketten, Logos, Artikelnummern, Preise im Bild, Kennzeichen und der Satz auf deinem Thumbnail. Logos und Etiketten gelingen im Makro mit Pflicht-Referenzen und festen Regeln, im Gesamtbild nicht fehlerfrei. Setze diese Elemente aus dem Original ein oder prüfe sie Zeichen für Zeichen im gleichen Maßstab gegen das Original. Bei Menschenbildern lohnt der Realismus-Prompt mehr als der Wechsel des Modells. Und prüfe KI-Anzeigen auf Aussagen, die du nicht beauftragt hast.
Willst du über Magnific arbeiten, rechne mit dem Credit-Preis nach: Dort ist Nano Banana 2 für denselben Zweck günstiger. Und wenn dein Alltag aus Kleingedrucktem im Bild besteht, ist Pro im Test die sicherere Wahl, bei etwa drei- bis vierfachen Kosten je 1K-Bild gegenüber 2.1. Für Etikett und Logo im Gesamtbild war GPT Image 2.5 Sunburst im Test am nächsten dran, kostet in Magnific aber 600 Credits je 2K-Bild.
Häufige Fragen
Was ist Nano Banana 2.1?
Nano Banana 2.1 ist Googles neues Modell zum Erzeugen und Bearbeiten von Bildern, veröffentlicht am 06.10.2026. Es basiert auf Gemini 3.6 Flash, ersetzt Nano Banana 2 und läuft in der Gemini-App, im AI Mode, in AI Studio, Flow, Stitch, Google Ads und per API.
Ist Nano Banana 2.1 besser als Nano Banana Pro?
Nach Googles Modellkarte und der vorläufigen Arena gefällt 2.1 den Bewertern öfter als Pro. In meinem Test mit festen Prüfkriterien liegen sie eng beieinander (84 gegen 87 von 90 Punkten), Pro ist bei Kennzeichen, Thumbnail-Satz und Kleingedrucktem sicherer. The Decoder sieht Pro in der Praxis oft noch besser. Für die API ist 2.1 bei 1K nach Listenpreis rund viermal günstiger, inklusive Eingabe und Denken rund dreimal.
Was kostet Nano Banana 2.1?
Über die Gemini API 0,0336 $ je 1K-Bild, 0,0504 $ je 2K-Bild und 0,113 $ je 4K-Bild (Stand 07.10.2026), dazu Eingabe und Denken (1,50 $ und 7,50 $ je Million Tokens). Im Batch halb so viel. Einen kostenlosen API-Tarif gibt es nicht. In Magnific sind es 100 Credits je 2K-Bild.
Kann ich Nano Banana 2.1 in Deutschland nutzen?
Über die API und Plattformen wie Magnific ja. Für die Gemini-App und den AI Mode nennt Google keine Länder für 2.1, die Hilfeseite zur Bilderstellung im AI Mode führt Deutschland nicht auf. Ein Reddit-Nutzer berichtet, er sehe 2.1 in der EU in seinen Bildern.
Verändert 2.1 Etiketten und Logos auf Produktfotos?
Ja, wenn du ein Foto und einen Prompt gibst: Die Wörter stimmen oft, Schrift und Emblem nicht. Mit Pflicht-Referenzen (Etikett und Zipper als Makro), einer festen Regel und einem Makro-Bild stimmten Etikett und Zipper im Test bei allen vier Modellen. Im Gesamtbild, in dem Etikett und Anhänger klein sind, blieben Fehler: Bei GPT Image 2.5 Sunburst fehlte ein Buchstabe, bei den Google-Modellen waren die zweite Zeile und die Webadresse unlesbar.
Wie bringe ich Logo und Etikett richtig ins Bild?
Gib das Logo als große, scharfe Referenz mit, lege Wortlaut, Schrift und Emblem in einer festen Regel fest („nie neu zeichnen“), erzeuge Logo und Zipper als eigene Makro-Bilder und prüfe sie im gleichen Maßstab neben dem Original. In meinen Tests hat sich das als Magnific-Space mit GPT 2.5 Sunburst und Qualität max bewährt (Beitrag zu Magnific Spaces).
Setzt RYMHART KI-Bilder ein?
Nein, aktuell nicht. Produkt- und Personenfotos entstehen bei RYMHART nach wie vor in echter Handarbeit, der Fotograf arbeitet im Haus. Dass RYMHART-Produkte in diesem Test auftauchen, liegt an mir: Ich teste als seorado KI-Modelle, und Logos und Details sind ein hartes Testbeispiel. Ich selbst nutze KI-Bilder dagegen immer, für Grafiken, Titelbilder und Hintergründe, bei denen kein echtes Produkt und kein echtes Gesicht stimmen muss.
Ist GPT Image 2.5 besser als Nano Banana 2.1?
Bei Etikett und Zipper im Gesamtbild ja: 6 gegen 4 von 8 Punkten bei gleichen Referenzen und Regeln. Im Makro liegen beide gleichauf (je 4 von 4), und Fehler gibt es auch bei GPT (ein fehlender Buchstabe im Etikett). In der Arena führt GPT Image 2.5 die Text-zu-Bild-Rangliste an. In Magnific kostet es 600 Credits je 2K-Bild, 2.1 kostet 100.
Wie vermeide ich den Plastik-Look bei Menschen?
Beschreibe eine echte Situation statt eines Studios: Ort, Licht, Kamera (zum Beispiel 35 mm Film), Hauttextur, lose Haare und „keine Retusche“. Vermeide Wörter wie „perfekt“, „makellos“ und „ultra realistisch“. Das Werkzeug oben prüft deinen Prompt.
Muss ich von Nano Banana 2 umziehen?
In der API ja, spätestens zum 29.10.2026, denn dann wird gemini-3.1-flash-image abgeschaltet. Tausche die Modell-ID gegen gemini-nano-banana-2.1 und lege die Denkstufe fest, weil „medium“ der neue Standard ist.
Quellen
- Google: Modellkarte Nano Banana 2.1, Gemini API: Preise, Changelog, Abkündigungen, Anleitung zur Bilderzeugung, Ankündigung auf X und Rollout-Post (alle abgerufen am 06. und 07.10.2026)
- Rangliste: Arena, Text zu Bild und Bildbearbeitung (Stand 06.10.2026, Abruf 07.10.2026)
- Presse: The Decoder, Search Engine Roundtable, Android Authority (alle 06.10.2026)
- Praktikertest: JP Caparas, Nano Banana 2.1 benchmarked against every Nano Banana before it (Oktober 2026, abgerufen am 07.10.2026)
- Produktfotos: RYMHART, Troyer schwer ungefüttert (abgerufen am 06.10.2026). Die Preise der Rechner beruhen auf der Google-Preisliste vom 07.10.2026, die Credits auf dem Kostenrechner von Magnific vom 06.10.2026, der Dollar-Kurs auf dem EZB-Referenzkurs vom 06.10.2026 (1 € = 1,1269 $)
- YouTube: Paul J Lipsky, AI Video School, Johanna Hendrix, smallzero, AgentenFabrik, AI Jitan Lab (alle 06.10.2026)
- Reddit (r/GeminiAI): Nano Banana 2.1, Nano Banana 2.1 is rolling out now, Some More Updates (05. und 06.10.2026). Hacker News: Nano Banana 2.1. X: Frage zur Basis des Modells
- Eigener Test: Magnific, 125 Bilder vom 06. und 07.10.2026 mit den Modellen Nano Banana, Nano Banana 2 Lite, Nano Banana 2, Nano Banana Pro, Nano Banana 2.1 und GPT Image 2.5 (Variante Sunburst, Qualität max, Etikett-Aufgaben), Punkte aus festen Kriterien, je ein Lauf pro Prompt und Modell. Referenzen und Regeln der Wiederholung nach dem Space „Farbwechsel“
Hinweis zur Recherche: Ein ausgebliebener Fund beweist keine Nichtexistenz. Die X-Suche war am Starttag nicht nutzbar (Fehlermeldung), deshalb habe ich die Posts von Google und die Antworten gelesen. Auf LinkedIn zeigte die Inhaltssuche am Abend des Starts nur drei Beiträge.
Geschrieben von
Mario WormuthSEO, GEO und KI-Automatisierung für Online-Shops. Ich teste, worüber ich schreibe, zuerst auf eigenen Seiten und in Kundenprojekten wie RYMHART und Opal-Schmiede.
Das für deinen Shop umsetzen?
Drei Fragen, sofort eine Einschätzung, danach drei konkrete Punkte von mir persönlich. Kostenlos.
Weitere Artikel
aus dem Magazin.
Alle Artikel
Textwasserzeichen bei Claude, ChatGPT und Gemini: Vergleich
Die meisten Produktbeschreibungen aus meinem Test mit KI sind kürzer als 200 Tokens. Genau an dieser Zahl zieht die EU eine Linie: Der Verhaltenskodex zur Kennzeichnung nennt Text unter 200 Tokens „sehr kurz“ und …
Heatmap-Tools 2026: 10 Anbieter von kostenlos bis bezahlt
Hotjar nimmt keine neuen Konten mehr an, und bei Smartlook war der 31. Mai 2026 der letzte Bestelltag. Trotzdem führen vier von sechs deutschsprachigen Vergleichslisten zu Heatmap-Tools Smartlook noch als wählbares …
Die 10 besten kostenlosen SEO-Tools 2026 im Check
Von 30 Tools und Funktionen, die als kostenlos laufen, bestehen am 5. Oktober 2026 genau 22 meinen Kostenlos-Check. Acht fliegen raus. Ubersuggest, AnswerThePublic und AlsoAsked erlauben je 3 Suchen pro Tag. …