Start / Magazin / Weitere Themen
Gemini 4 Argon: Benchmarks, Preis, Zugang und Vergleich mit Opus 5.5 und Sol 6.1
ArtikelWeitere Themen01.10.2026/img/magazin/gemini-4-argon-google-modell-vergleich.webp Mario WormuthSEO, GEO & KI-Automatisierung
38 Min. Lesezeit
Alles auf einen Blick
- Gemini 4 Argon ist Googles erstes neues Spitzenmodell seit Gemini 3.1 Pro im Februar. Es ist angekündigt, aber nicht frei verfügbar: Zugang haben nur ausgewählte Partner aus Googles Fairwind-Programm für Cyberabwehr und die US-Regierung. Ein Datum für API und Abo nennt Google nicht, zu Deutschland sagt es nichts.
- Der Preis von 2 $ und 10 $ je Million Tokens ist ein Einführungspreis. Danach gelten 4 $ und 20 $, so viel wie bei Claude Opus 5.5. Wie lange der Rabatt läuft, ist offen.
- In Googles eigener Tabelle liegt Argon in 13 von 18 Tests vor GPT-6 Astra. Bei Agenten-Coding im Terminal liegt es dort aber hinter allen drei Vergleichsmodellen, und Sonnet 5.5 sowie GPT-6.1 Sol fehlen in der Tabelle ganz.
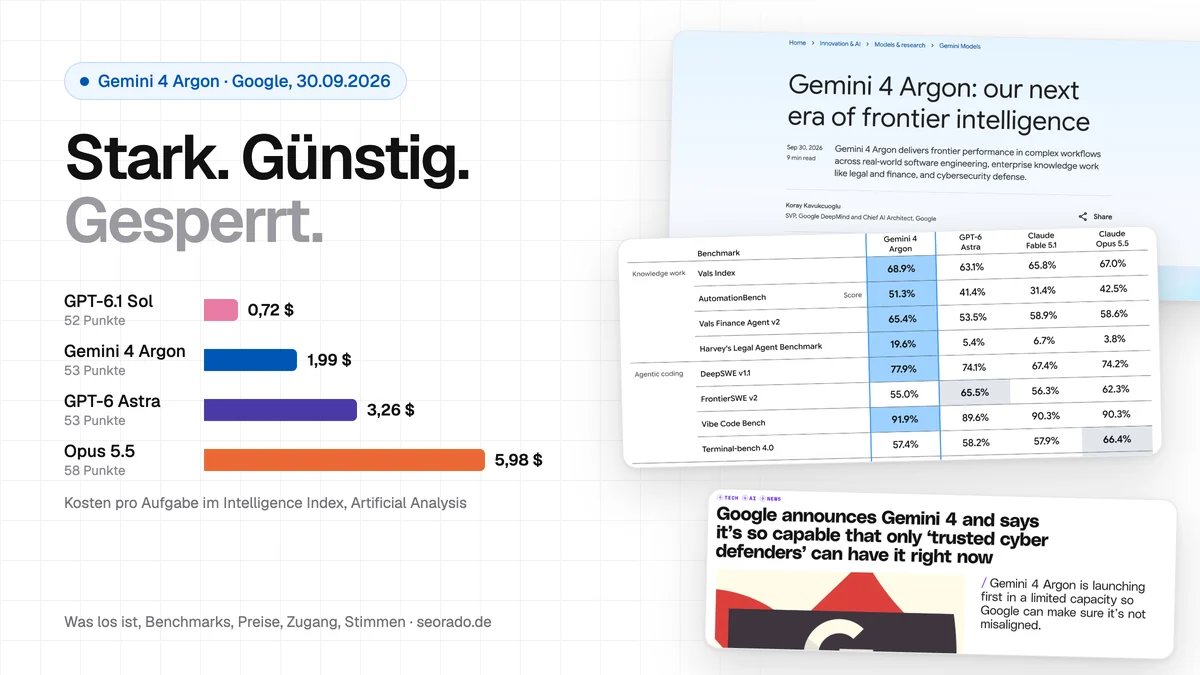
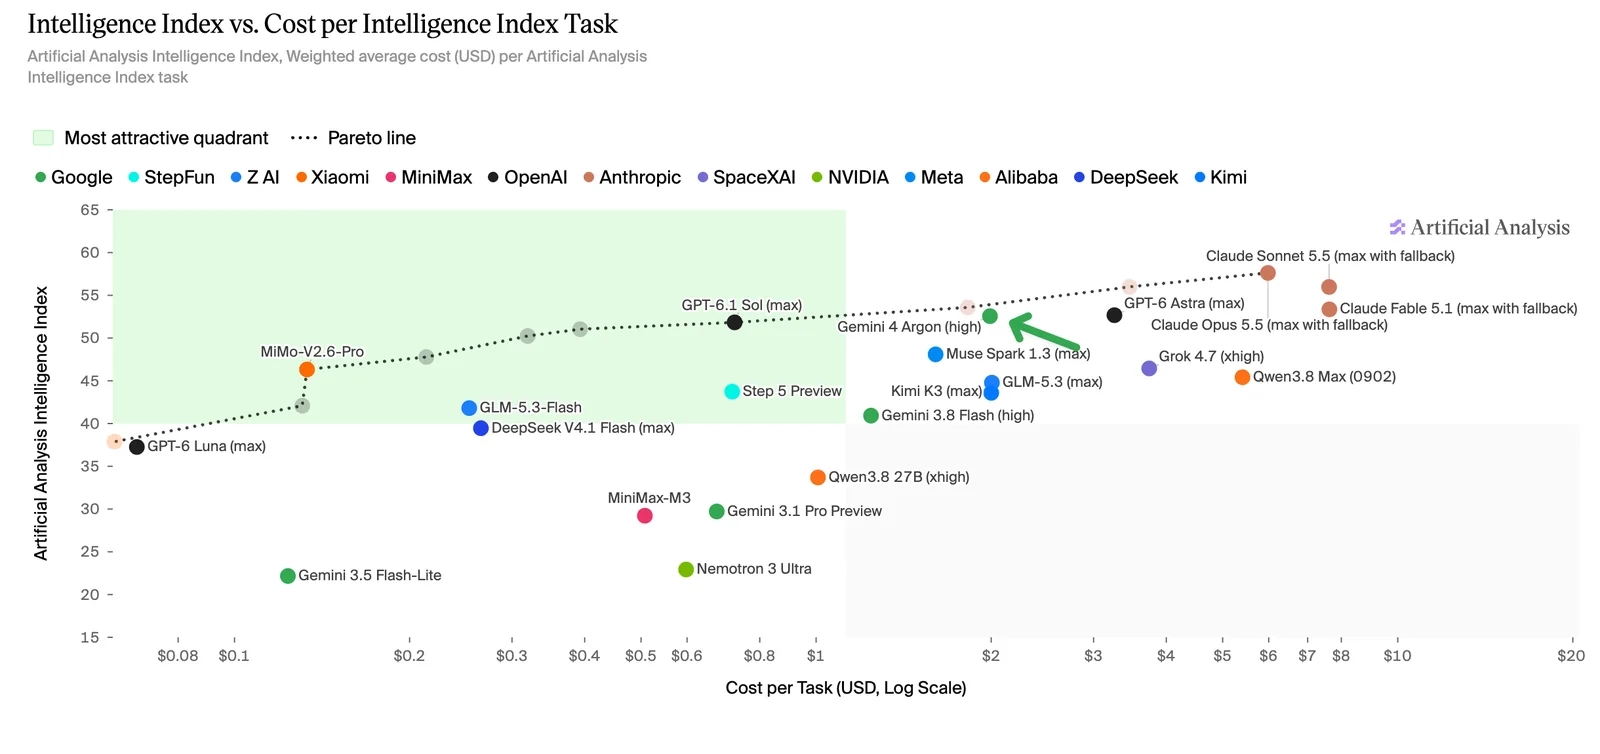
- Unabhängig gemessen landet Argon bei Artificial Analysis mit 53 Punkten gleichauf mit GPT-6 Astra, einen Punkt vor GPT-6.1 Sol und fünf hinter Opus 5.5. Pro Aufgabe kostet es dort 1,99 $, GPT-6.1 Sol 0,72 $.
- Die stärksten unabhängigen Werte: Platz 1 im Vals Index, Platz 1 in der Text Arena, Platz 1 bei AutomationBench und mit 15 % die niedrigste Halluzinationsrate unter den Spitzenmodellen. Die schwächsten: Platz 8 beim Bauen von Webseiten und Rang 4 bei Terminal-Bench 4.0.
- Neu und einzigartig ist das Ausgabe-Limit von einer Million Tokens pro Antwort. Opus 5.5, Sonnet 5.5, GPT-6.1 Sol und Astra schaffen jeweils 128.000.
Inhaltsverzeichnis13 Abschnitte
- Was ist da los? Vier Spitzenmodelle in acht Tagen
- Gemini 4 Argon im Steckbrief
- Wer Argon bekommt und wann
- Benchmarks: Was Googles Tabelle zeigt und was sie weglässt
- Unabhängig gemessen: Artificial Analysis, Vals und Arena
- Preise: 2 $ und 10 $, aber nicht für immer
- Argon gegen Opus 5.5, GPT-6.1 Sol, Sonnet 5.5 und Astra
- Was die Community sagt
- Sicherheit: warum Google Argon zurückhält
- Was das für Shops, SEO und Agenturen bedeutet
- Häufige Fragen
- Fazit
- Quellen
Am 30. September 2026 um 22 Uhr deutscher Zeit hat Google Gemini 4 Argon vorgestellt, sein neues Spitzenmodell. Acht Tage vorher kam Claude Opus 5.5, zwei Tage vorher Claude Sonnet 5.5, einen Tag vorher GPT-6.1 Sol. Googles Ankündigung klingt groß: Argon soll in 13 von 18 Tests vor GPT-6 Astra liegen, bis zu einer Million Tokens in einer Antwort schreiben und zum Start nur 2 $ und 10 $ je Million Tokens kosten. Der Haken steht im ersten Absatz: Nutzen dürfen das Modell vorerst nur ausgewählte Cyber-Verteidiger und die US-Regierung.
Weil ich selbst keinen Zugang habe, gibt es in diesem Beitrag keinen eigenen Test. Ich habe stattdessen alles zusammengetragen, was es seit der Ankündigung gibt: Googles Blog, die Benchmark-Tabelle und das Methodik-Dokument, die Fairwind-Seite, die Messungen von Artificial Analysis, Vals AI und der Arena, gut 50 Artikel aus Fach- und Wirtschaftspresse, 152 Reddit-Threads, die Diskussion auf Hacker News, YouTube sowie Posts auf X und LinkedIn. Bei der Recherche hat mir KI geholfen, Quellen zu finden und zu sortieren. Die Zahlen habe ich an den Originalseiten geprüft, die wichtigen Stellen als Screenshots festgehalten und die Rechner gebaut. Du bekommst eine Zeitleiste der Release-Wochen, einen Benchmark-Vergleich mit Hersteller- und unabhängigen Werten, einen Kostenrechner in Euro und eine Entscheidungshilfe für die Frage, was du nimmst, solange Argon gesperrt ist.
Was ist da los? Vier Spitzenmodelle in acht Tagen
Wer im September nicht jeden Tag mitgelesen hat, hat den Überblick verloren. Und das ist kein Wunder: In einem Monat sind mehr als 20 neue Modelle erschienen. Die drei großen westlichen Labore Anthropic, OpenAI und Google haben dabei je ein neues Spitzenmodell gebracht, OpenAI und Anthropic sogar mehrere. In der Zeitleiste siehst du, was wann kam, was es kostet und wer es nutzen darf.
- Google Gemini 3.1 Pro Preview für alle
Das letzte Pro-Modell von Google vor Argon, 2 $ und 12 $. Ein angekündigtes Gemini 3.5 Pro erschien nie. Zwischen diesem Datum und Argon liegen 223 Tage.
- Anthropic Claude Fable 5.1 für alle
Spitzenmodell für 10 $ und 50 $.
- Anthropic Claude Mythos 5.1 gesperrt
Dieselben Gewichte wie Fable 5.1, aber mit gelockerten Cyber-Regeln. Nur für Sicherheitsforscher.
- Google Gemini 3.8 Flash für alle
0,75 $ und 3,75 $ bis Ende 2026, danach das Doppelte. Ausgabe bis 64.000 Tokens.
- Google Gemini 3.8 Flash Cyber gesperrt
Start des Fairwind-Programms für Regierungen und Sicherheitsfirmen, laut Google über 650 Partner.
- Meta Muse Spark 1.3 für alle
Neue Version von Metas Modellreihe.
- OpenAI GPT-6 Astra für alle
Spitzenmodell für 10 $ und 50 $. Die stärksten Cyber-Werkzeuge gibt es nur über ein eigenes Zugangsprogramm.
- DeepSeek DeepSeek V4.1 Flash für alle
Günstiges Modell aus China.
- xAI Grok 4.7 für alle
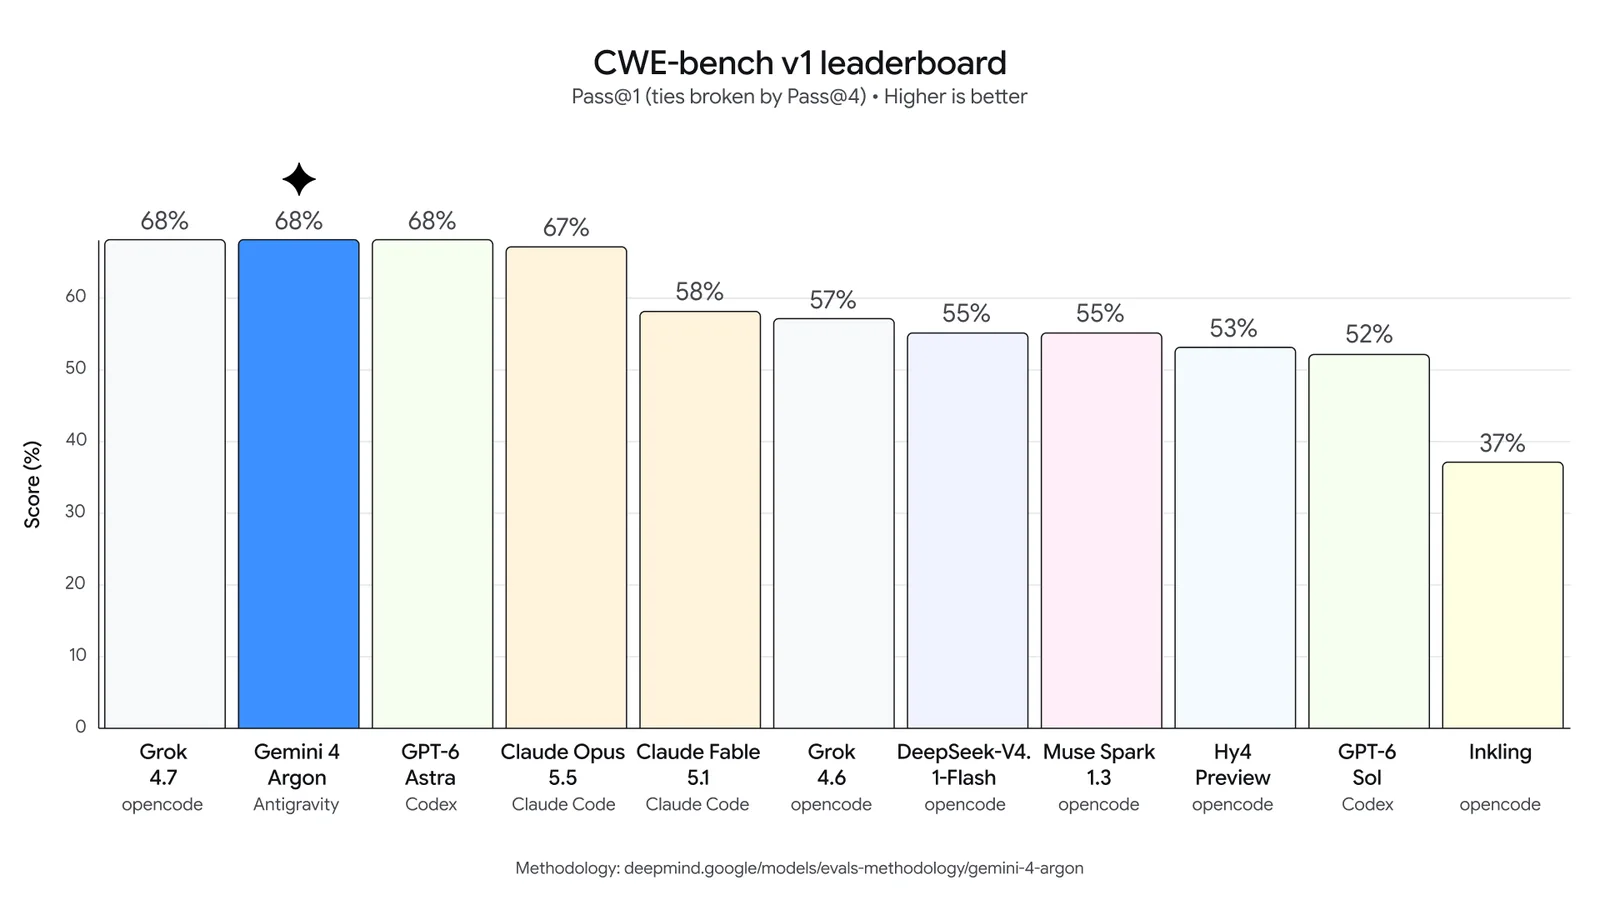
2 $ und 6 $. Liegt im CWE-bench gleichauf mit Argon und Astra.
- Anthropic Claude Opus 5.5 für alle
4 $ und 20 $. Führt seitdem den Intelligence Index von Artificial Analysis an.
- OpenAI GPT-6 Sol und GPT-6 Luna für alle
Sol für 2 $ und 10 $, Luna für 0,10 $ und 0,50 $, jeweils der halbe Preis der Vorgänger.
- Anthropic Claude Sonnet 5.5 für alle
2 $ und 10 $, beim Terminal-Bench 4.0 laut Anthropic sogar vor Opus 5.5.
- OpenAI GPT-6.1 Astra gestoppt
Laut Wall Street Journal nicht veröffentlicht, weil das Modell sich nicht an Vorgaben und Freigaben hielt.
- OpenAI GPT-6.1 Sol für alle
2 $ und 10 $, vorgestellt auf dem DevDay, sieben Tage nach GPT-6 Sol.
- Google Gemini 4 Argon gesperrt
2 $ und 10 $ zum Start, danach 4 $ und 20 $. Vorerst nur für ausgewählte Fairwind-Partner und im Prüfverfahren der US-Regierung.
Quellen: Ankündigungen der Anbieter, Wall Street Journal (über CNN und heise), Release-Übersichten von Digital Applied und Local AI Zone, Stand 01.10.2026. Modelle ohne Bezug zu diesem Beitrag, etwa kleinere chinesische Modelle, fehlen.
Auf Reddit fasst ein Nutzer die Lage in r/ClaudeAI in einem Satz zusammen: „It's fall. The harvest season.“ Zvi Mowshowitz, einer der bekanntesten KI-Blogger, schrieb am Tag des DevDay: „The release cycle has gotten too fast.“ Drei Entwicklungen erklären, warum es gerade so dicht wird.
1. Preiskampf eine Stufe unter der Spitze
Am 22. September haben OpenAI und Anthropic gleichzeitig ihre Preise gesenkt: GPT-6 Sol und Luna kosteten nur noch die Hälfte ihrer Vorgänger, Claude Opus 5.5 kam 20 % günstiger als Opus 5. Simon Willison schrieb damals: „It's hard to overstate how competitive this pricing is.“ Seit dem 28. September kosten Sonnet 5.5 und GPT-6.1 Sol beide 2 $ und 10 $. Google steigt mit Argon genau bei diesem Preis ein, allerdings nur vorübergehend.
2. Die stärksten Modelle gehen zuerst an Sicherheitsleute
Anthropic hat im April Claude Mythos nur an ausgewählte Sicherheitsforscher gegeben. Im September folgten Mythos 5.1, die stärksten Cyber-Werkzeuge von GPT-6 Astra und Gemini 3.8 Flash Cyber, jeweils über eigene Zugangsprogramme. Bei Anthropic und OpenAI war dabei nur die Cyber-Variante gesperrt, das normale Modell gab es für alle. Google geht mit Argon einen Schritt weiter und hält das komplette neue Spitzenmodell zurück. XDA nennt das „the Mythos wall“: den Punkt, an dem Anbieter ihre besten Modelle nicht mehr einfach an alle verteilen.
3. Google stand unter Druck
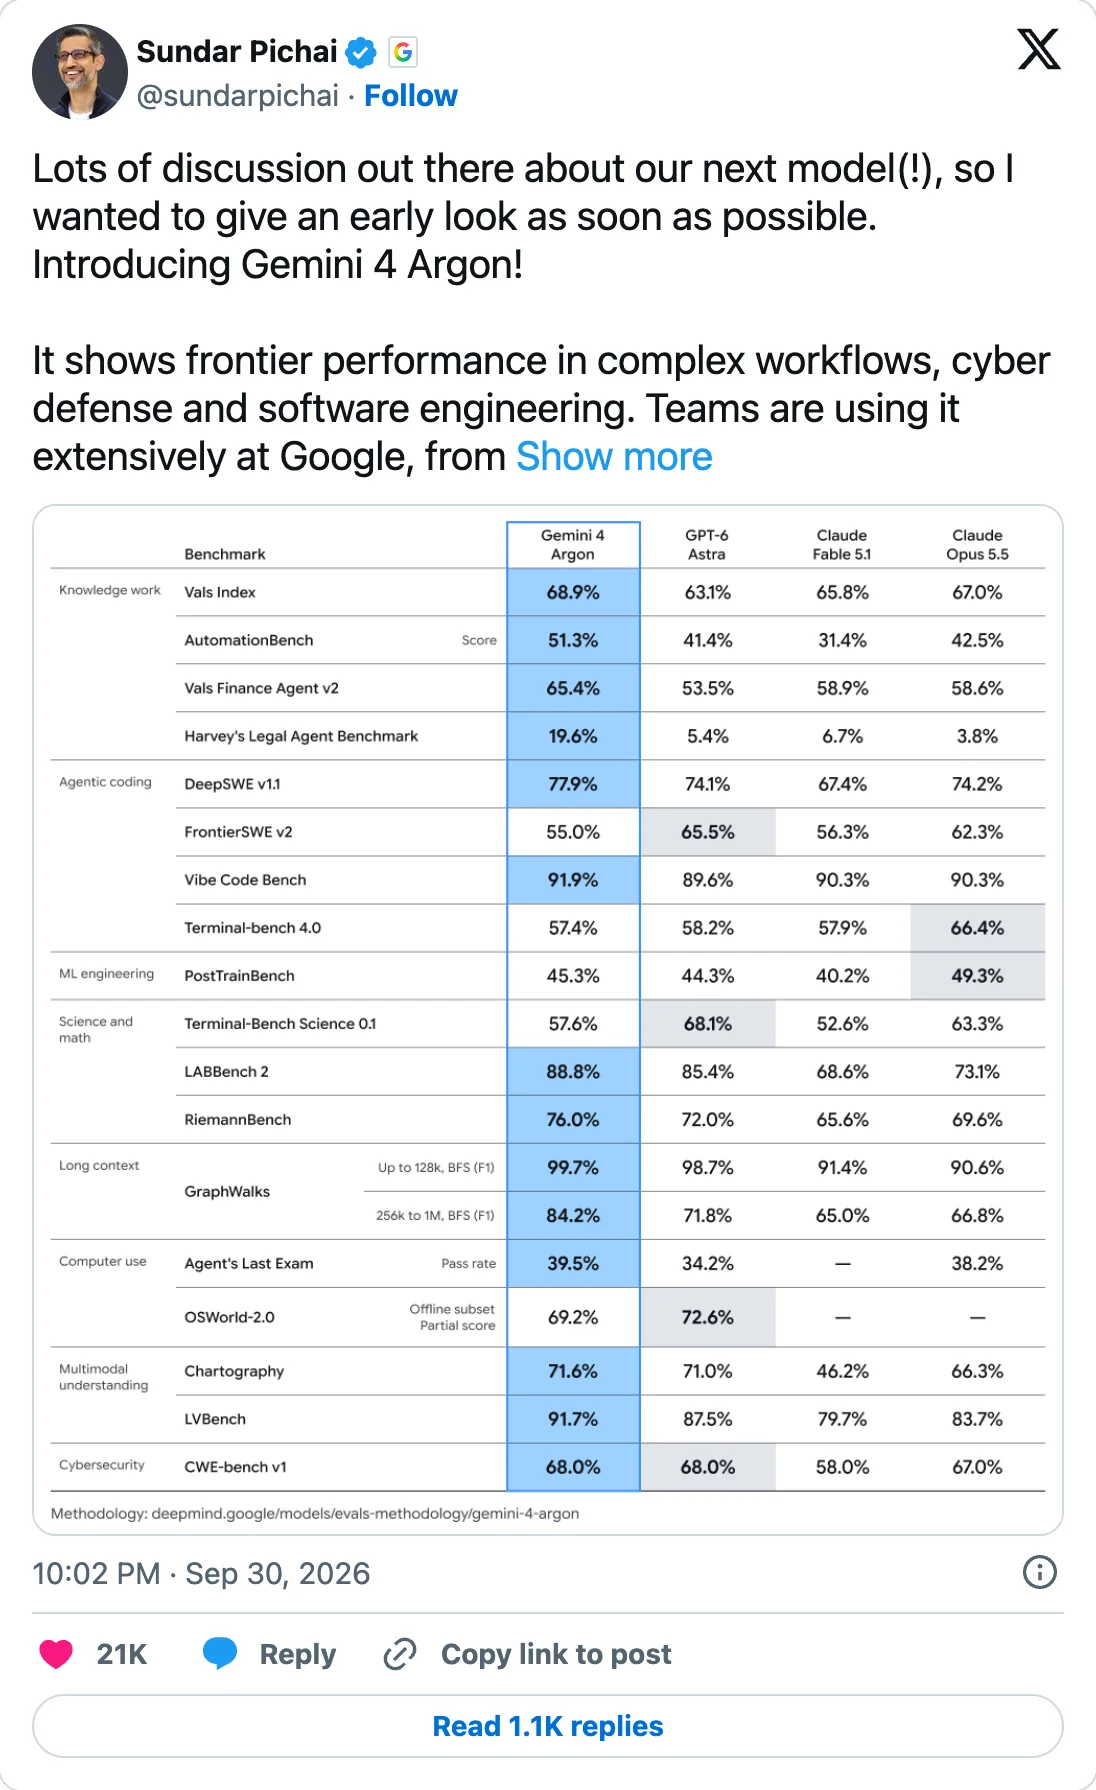
Seit Gemini 3.1 Pro im Februar hatte Google kein neues Pro-Modell gebracht. Ein auf der Google I/O im Mai für Juni versprochenes Gemini 3.5 Pro erschien nie, stattdessen kamen im Monatstakt neue Flash-Modelle. Axios schreibt: „Gemini 4 arrives after a long gap at the top of Google's model lineup, in which the company kept rolling out smaller, cheaper Flash models while rivals OpenAI and Anthropic sprinted forward.“ Eine Woche vor dem Start hatte Koray Kavukcuoglu, der neue Chef von Google DeepMind, angekündigt, Gemini 4 so früh wie möglich zu zeigen. Sundar Pichai beginnt seinen Post zum Start entsprechend mit: „Lots of discussion out there about our next model(!), so I wanted to give an early look as soon as possible.“
Gemini 4 Argon im Steckbrief
Angekündigt hat Argon Koray Kavukcuoglu auf blog.google, der Titel lautet „Gemini 4 Argon: our next era of frontier intelligence“. Google beschreibt es als Modell für lange, komplexe Arbeitsabläufe in drei Bereichen: Software-Entwicklung, Wissensarbeit wie Recht und Finanzen und Cyberabwehr. Der Name ist neu. Statt Pro oder Flash trägt das erste Gemini-4-Modell einen Codenamen, den die Seite TestingCatalog schon Mitte September aus einem Leak gemeldet hatte.
| Merkmal | Stand 01.10.2026 |
|---|---|
| Anbieter | Google DeepMind |
| Vorgestellt | 30.09.2026, 22 Uhr deutscher Zeit |
| Zugang | Ausgewählte Partner im Fairwind-Programm, Google intern, Prüfverfahren der US-Regierung. Danach zuerst zahlende API-Kunden und Google AI Ultra, ohne Datum |
| Preis über die API | Zum Start 2 $ Eingabe, 10 $ Ausgabe, 0,10 $ für Eingaben aus dem Cache (95 % Rabatt), jeweils je Million Tokens. Danach 4 $ und 20 $ |
| Maximale Ausgabe | 1 Million Tokens pro Antwort (vorher 64.000) |
| Kontextfenster | Von Google nicht genannt, laut Artificial Analysis 1 Million Tokens |
| Eingaben | Laut Artificial Analysis Text, Bild, Video und Sprache, Ausgabe nur Text |
| Denkstufe | Höchste verfügbare Stufe heißt High (Artificial Analysis, Arena) |
| Modell-ID für die API | Noch keine, Argon fehlt in Googles API-Dokumentation und auf der Preisseite |
| Wissensstand, Model Card, Sicherheitsbericht | Nicht veröffentlicht |
| Vorgänger | Gemini 3.1 Pro Preview (19.02.2026, 2 $ und 12 $) |
Was Google intern damit macht
Laut Google nutzen „thousands of Googlers“ Argon schon im Alltag, unter anderem in Antigravity, Googles Programmierumgebung. Im Blog nennt Google drei Beispiele:
- Quantencomputer: Argon hat Algorithmen so umgebaut, dass sie weniger Qubits und Rechenschritte brauchen. In einem Fall lag das Ergebnis nach wenigen Minuten 40 % unter der besten veröffentlichten Lösung.
- Speicher in Rechenzentren: Argon-Agenten haben Messdaten aus Googles Rechenzentren ausgewertet und Optimierungen umgesetzt. Das soll über 300 TiB Arbeitsspeicher freimachen, insgesamt geschätzt 500 TiB bis 1 PiB.
- Umbau von Code: Agenten übersetzen C- und C++-Code nach Rust, von einigen zehntausend Zeilen bis zu über 800.000 Zeilen beim Kernel des Betriebssystems Fuchsia. Beim Video-Decoder libgav1 ersetzten sie 32.000 Zeilen Spezialcode. Das Ergebnis läuft 2,7-mal so schnell wie die bisherige Rust-Version.
Auf Hacker News fiel einem Nutzer auf, dass der neue Decoder laut Google zwar schneller als die alte Rust-Version ist, aber nur „closer to the optimized C++“. Das Original bleibt also schneller. Ein anderer hält die Rust-Migration für die eigentliche Nachricht: „Breaking news is not the model. Breaking news is that inside Google, it is being heavily used on large code bases.“
Eine Million Tokens Ausgabe: wofür das gut ist
Das Ausgabe-Limit legt fest, wie viel ein Modell in einer einzigen Antwort schreiben darf, das Nachdenken eingerechnet. Bei Opus 5.5, Sonnet 5.5, GPT-6.1 Sol und Astra sind es 128.000 Tokens, bei Gemini 3.8 Flash 65.536. Argon schafft eine Million, fast achtmal so viel. Möglich macht das eine neue Funktion namens Long Decode Continuation: Die API pausiert sehr lange Antworten und setzt sie über Folgeaufrufe fort, damit nichts in eine Zeitüberschreitung läuft.
Wofür braucht man das? Google begründet es mit Agenten, die stundenlang an einer Aufgabe arbeiten und dabei viel denken und schreiben. Ein Shop-Beispiel zur Einordnung: Eine Produktbeschreibung mit 150 Wörtern braucht auf Deutsch grob 250 Tokens. Eine Million Tokens reichen rechnerisch für einige Tausend solcher Texte in einer Antwort. Auf Hacker News und Reddit war die Reaktion trotzdem gemischt. Ein Nutzer in r/GeminiAI: „a large token output limit does not really have anything to do with long-horizon tasks.“ Und Vals AI listet für seine Testkonfiguration ein Ausgabe-Limit von 262.000 Tokens, nicht eine Million. Wie viel davon in der Praxis ankommt, zeigt sich erst, wenn das Modell frei verfügbar ist.
Wer Argon bekommt und wann
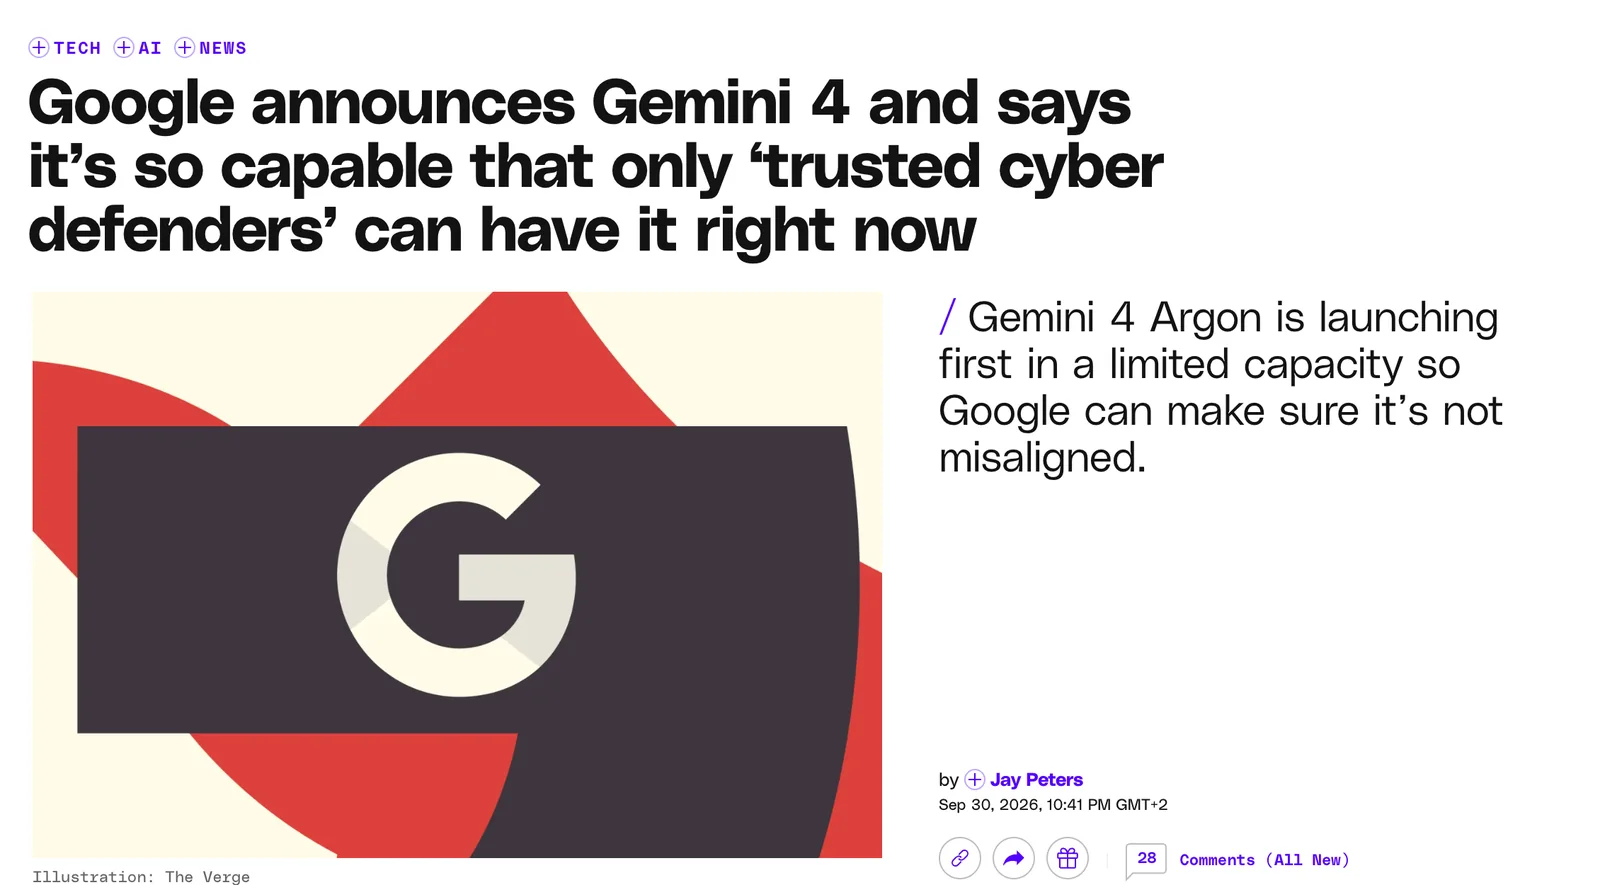
Der wichtigste Satz der Ankündigung steht gleich am Anfang: Argon „is rolling out to a set of trusted cyber defenders through our Fairwind Program“. Das Fairwind-Programm hat Google am 2. September gestartet, zusammen mit Gemini 3.8 Flash Cyber. Es richtet sich an Regierungen, Betreiber kritischer Infrastruktur wie Kliniken, Telekommunikation, Energie und Finanznetze sowie große Technologieplattformen. Laut Google sind über 650 Partner dabei, auf der Seite stehen Logos von Accenture, CrowdStrike, Palo Alto Networks, Snowflake und Wiz. Argon bekommt aber nur „a set of“ Partnern, also ein Teil davon. Namentlich nennt Google nur Wiz: Dessen Team hat mit Argon eine kritische Lücke in weltweit genutzter Krankenhaus-Software gefunden, die frühere Modelle übersehen hatten.
Für diese Partner und für Googles eigene Teams läuft Argon nach Googles Worten „without cyber guardrails“, also ohne die Schutzfilter, die Anfragen zu Angriffstechniken blockieren. Dafür gelten strenge Regeln: phishingsichere Zwei-Faktor-Anmeldung, Zugang nur für interne Sicherheitsteams, Hintergrundprüfung der Bewerber, kein Weitergeben des Zugangs. Erlaubt ist Verteidigung, etwa Schwachstellensuche, Malware-Analyse und autorisierte Angriffssimulation, nicht das Bauen von Schadsoftware.
Parallel nimmt Google am „U.S. government's voluntary process for pre-release model access“ teil. Welche Behörde das Modell prüft, steht nirgends. Den Rahmen dafür gibt es seit dem Sommer: Laut AFP ließ Washington im Juni den Zugang zu Anthropics Modellen Claude Mythos und Claude Fable kurzzeitig sperren, danach entstand das freiwillige Vorab-Verfahren. Einen Tag vor Argon unterschrieb Sundar Pichai im Weißen Haus eine freiwillige Selbstverpflichtung der KI-Firmen, Modelle erst nach gründlicher Prüfung zu veröffentlichen.
Wann alle anderen drankommen, lässt Google offen: „as soon as possible“, und zwar „starting with paid API customers and Google AI Ultra subscribers“. Wer das Abo AI Pro für 21,99 € im Monat hat, muss also vermutlich länger warten. Artificial Analysis schreibt, der Einführungspreis gelte „for at least one month“. Mehr Konkretes gibt es nicht.
Und in Deutschland?
Dazu sagt Google nichts, weder im Blog noch auf den Programmseiten. Caschys Blog bringt es auf den Punkt: „Auch zur regionalen Verfügbarkeit gibt es keine Angaben, Deutschland eingeschlossen.“ Ob europäische Fairwind-Partner Argon schon haben, ist ebenfalls offen. Google AI Ultra kostet in Deutschland 99,99 € im Monat (Ultra 5×) oder 219,99 € (Ultra 20×). Dr. Web weist auf die EU-KI-Verordnung hin: Seit August 2026 kann die EU-Kommission die Pflichten für Modelle mit systemischem Risiko durchsetzen, und eine Fassung ohne Cyber-Schutzfilter dürfte sich die Aufsicht genau ansehen.
Was du jetzt tun kannst
- Es gibt keine Warteliste für Firmen oder Privatleute. Das Formular „Express Interest in the Fairwind Program“ ist für Regierungen, Betreiber kritischer Infrastruktur und Sicherheitsteams gedacht, Google prüft jede Bewerbung einzeln.
- Kalkuliere mit 4 $ und 20 $, nicht mit dem Startpreis. Sonst sind deine Zahlen in ein paar Wochen falsch.
- Baue deine Abläufe austauschbar. Wenn ein Prompt oder Agent heute mit Opus 5.5 oder GPT-6.1 Sol läuft, sollte der Wechsel auf Argon später nur eine Zeile in der Konfiguration sein.
Benchmarks: Was Googles Tabelle zeigt und was sie weglässt
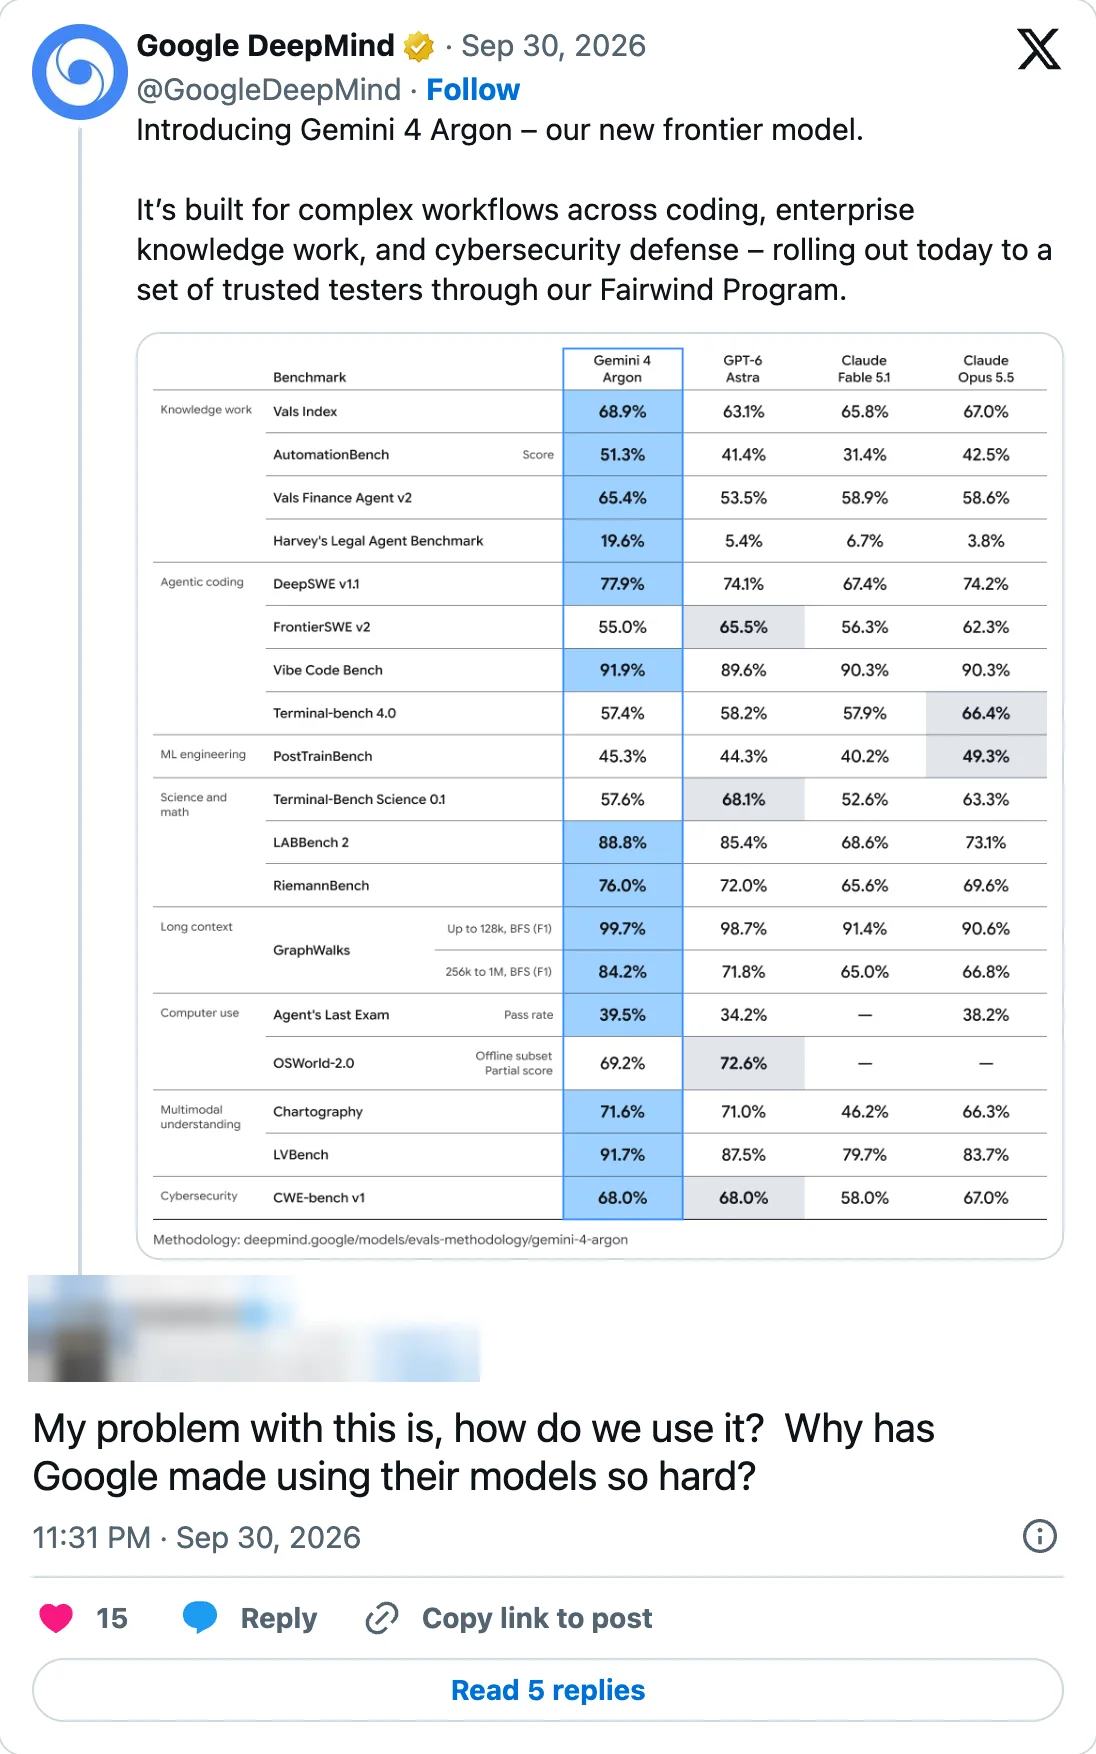
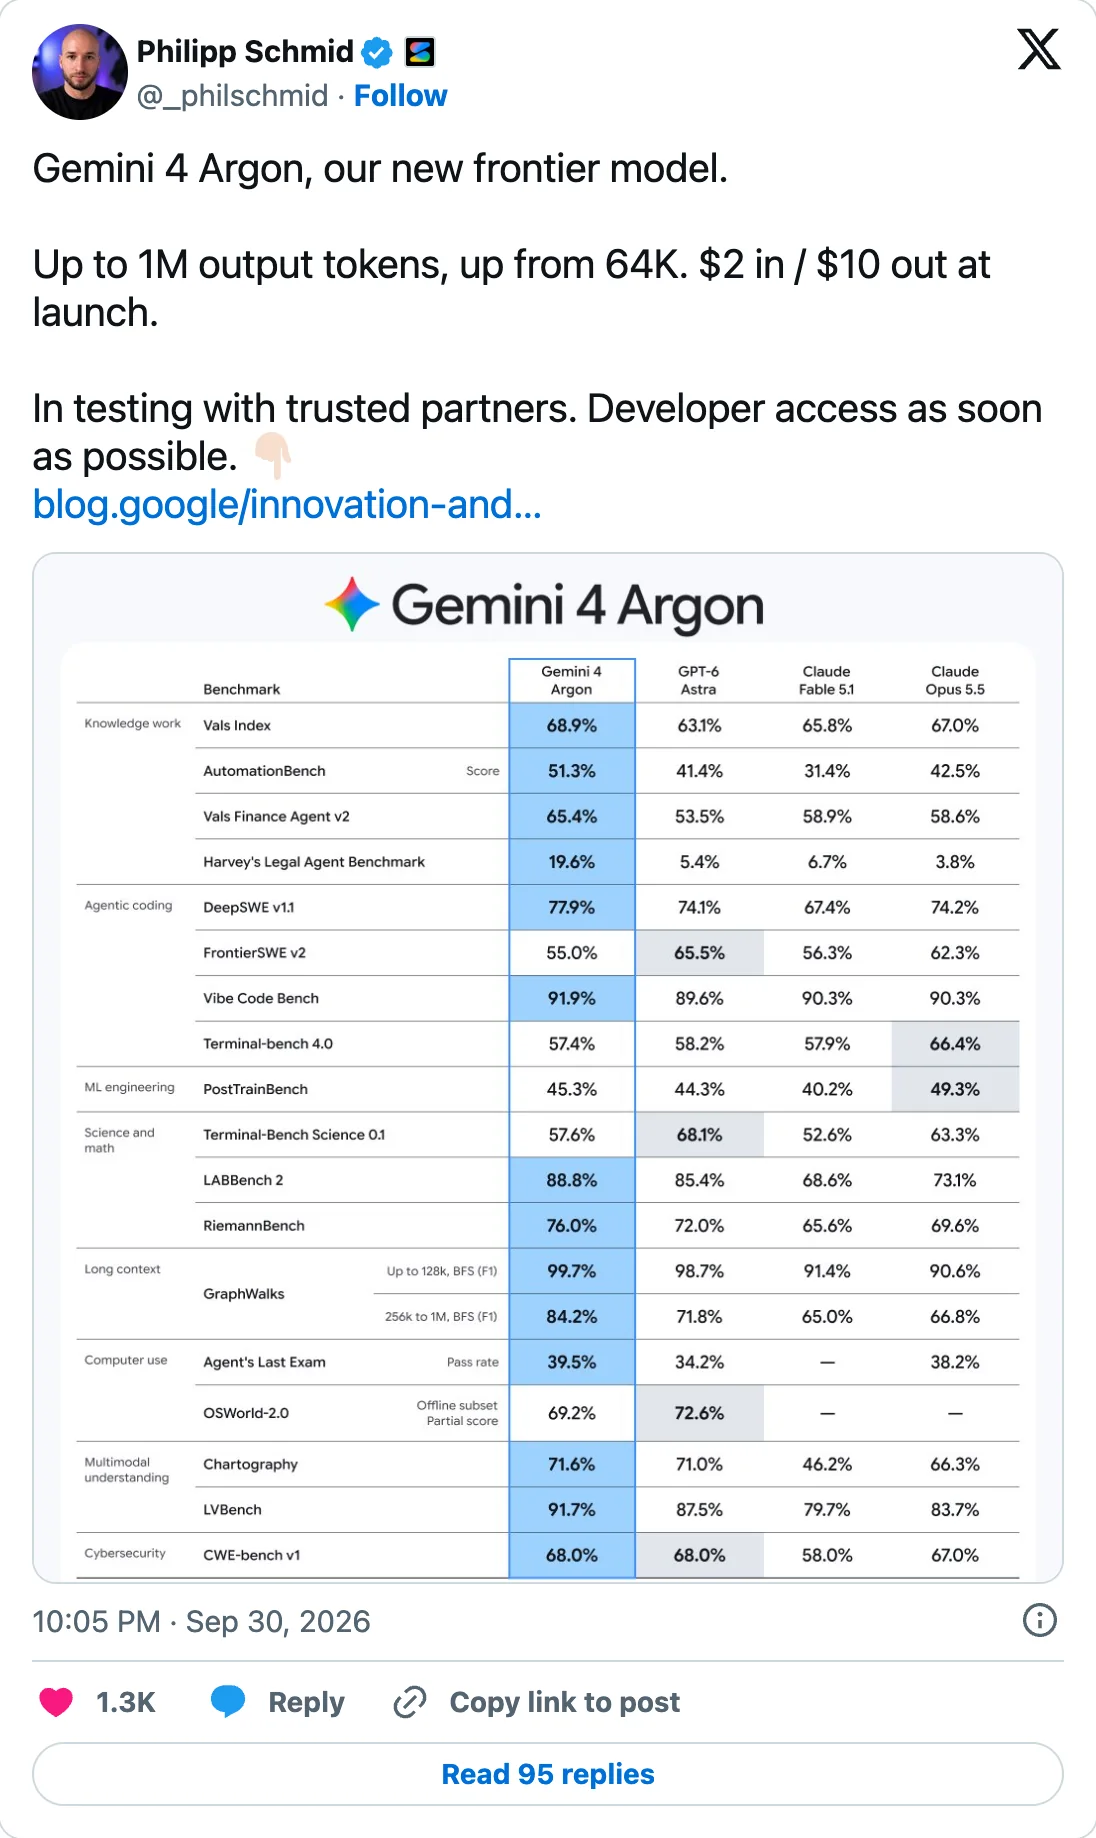
Googles Tabelle vergleicht Argon mit drei Modellen: GPT-6 Astra, Claude Fable 5.1 und Claude Opus 5.5, also mit den teuren Spitzenmodellen. In 13 von 18 Tests liegt Argon vor Astra, in 4 dahinter, einmal gleichauf. Den besten Wert aller vier Modelle hat Argon ebenfalls in 13 Tests, einen davon (CWE-bench) teilt es mit Astra. Deshalb schreiben manche Medien „12 von 18“. Beides stimmt, je nachdem, wie man zählt.
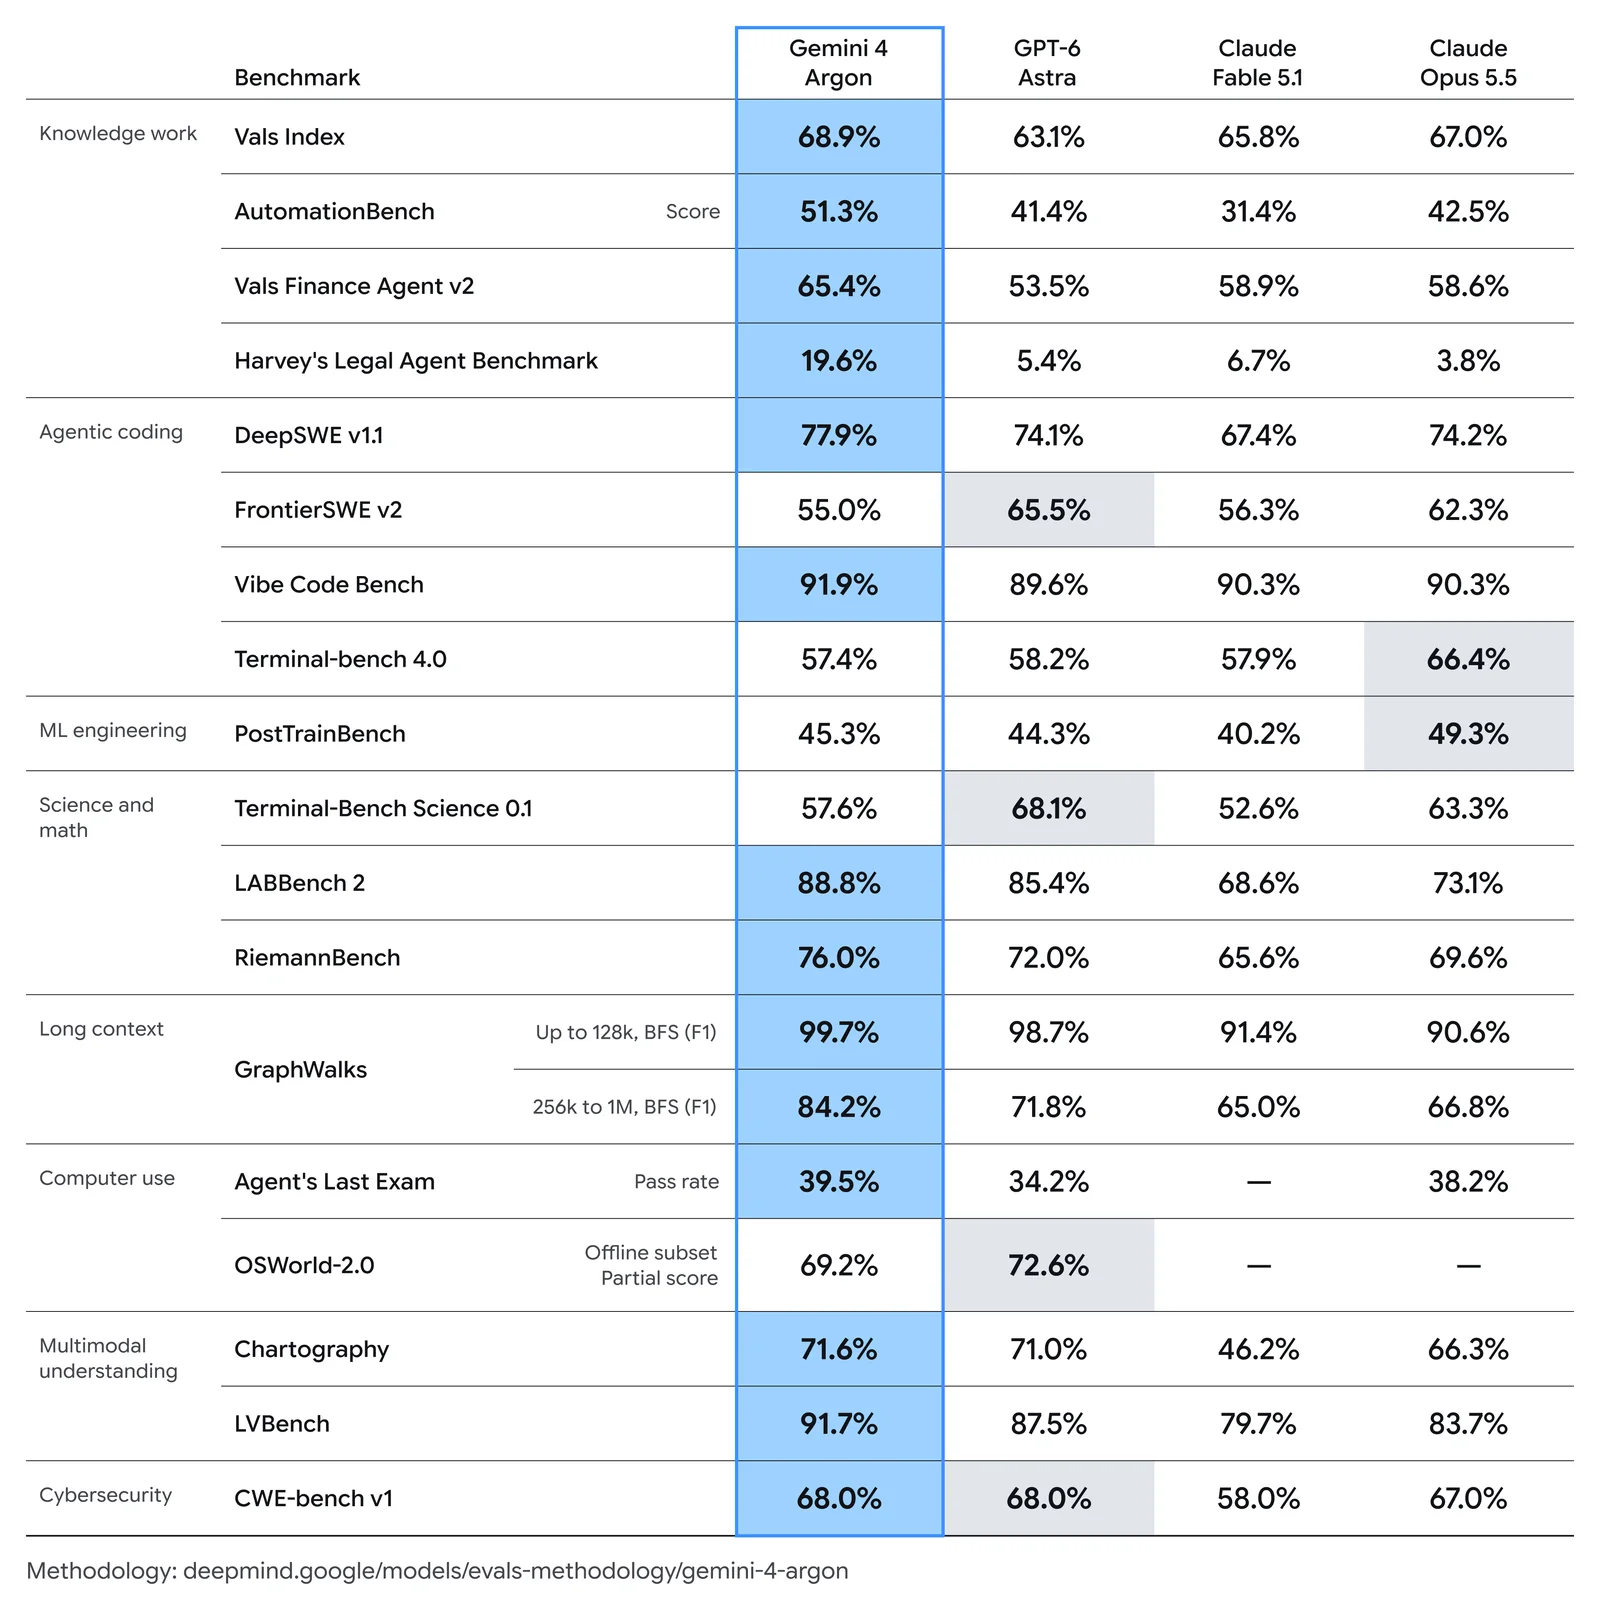
Im Vergleich unten kannst du jeden Test einzeln ansehen. Ich habe die Werte ergänzt, die Google weglässt: Sonnet 5.5 und GPT-6.1 Sol, die beiden Modelle, die zum selben Tokenpreis antreten, stehen nicht in Googles Tabelle. Wo Anthropic oder OpenAI selbst Werte für denselben Test veröffentlicht haben, siehst du sie gestrichelt mit Stern. Dazu kommen die unabhängigen Messungen von Artificial Analysis, Vals AI und der Arena.
Gemini 4 ArgonGPT-6 AstraOpus 5.5Fable 5.1Sonnet 5.5GPT-6.1 Solvom Hersteller ergänzt (mit Stern)
Alle Werte als Tabelle
| Test | Gemini 4 Argon | GPT-6 Astra | Claude Opus 5.5 | Claude Fable 5.1 | Claude Sonnet 5.5 | GPT-6.1 Sol |
|---|---|---|---|---|---|---|
| Vals Index (Wissensarbeit) | 68,9 % | 63,1 % | 67,0 % | 65,8 % | k. A. | k. A. |
| AutomationBench (Geschäftsabläufe) | 51,3 % | 41,4 % | 42,5 % | 31,4 % | k. A. | 36,1 %* |
| Vals Finance Agent v2 (Finanzanalyse) | 65,4 % | 53,5 % | 58,6 % | 58,9 % | k. A. | k. A. |
| Harvey Legal Agent (Rechtsarbeit) | 19,6 % | 5,4 % | 3,8 % | 6,7 % | k. A. | k. A. |
| DeepSWE v1.1 (Agenten-Coding) | 77,9 % | 74,1 % | 74,2 % | 67,4 % | k. A. | 71,9 %* |
| FrontierSWE v2 (Agenten-Coding) | 55,0 % | 65,5 % | 62,3 % | 56,3 % | k. A. | k. A. |
| Vibe Code Bench (Apps nach Beschreibung) | 91,9 % | 89,6 % | 90,3 % | 90,3 % | k. A. | k. A. |
| Terminal-Bench 4.0 (Arbeit im Terminal) | 57,4 % | 58,2 % | 66,4 % | 57,9 % | 70,6 %* | k. A. |
| PostTrainBench (KI-Training) | 45,3 % | 44,3 % | 49,3 % | 40,2 % | k. A. | k. A. |
| Terminal-Bench Science 0.1 (Forschung) | 57,6 % | 68,1 % | 63,3 % | 52,6 % | k. A. | 57,0 %* |
| LABBench 2 (Biologie-Labor) | 88,8 % | 85,4 % | 73,1 % | 68,6 % | k. A. | k. A. |
| RiemannBench (Mathematik) | 76,0 % | 72,0 % | 69,6 % | 65,6 % | k. A. | k. A. |
| GraphWalks bis 128.000 Tokens (langer Kontext) | 99,7 % | 98,7 % | 90,6 % | 91,4 % | k. A. | k. A. |
| GraphWalks 256.000 bis 1 Mio. Tokens (sehr langer Kontext) | 84,2 % | 71,8 % | 66,8 % | 65,0 % | k. A. | k. A. |
| Agent's Last Exam (Computerbedienung) | 39,5 % | 34,2 % | 38,2 % | k. A. | k. A. | k. A. |
| OSWorld 2.0 offline (Computerbedienung) | 69,2 % | 72,6 % | k. A. | k. A. | k. A. | 71,4 %* |
| Chartography (Diagramme lesen) | 71,6 % | 71,0 % | 66,3 % | 46,2 % | 61,6 %* | k. A. |
| LVBench (lange Videos) | 91,7 % | 87,5 % | 83,7 % | 79,7 % | k. A. | k. A. |
| CWE-bench v1 (Sicherheitslücken) | 68,0 % | 68,0 % | 67,0 % | 58,0 % | k. A. | k. A. |
| Intelligence Index v4.3.2 (10 Tests) | 53 | 53 | 58 | 53 | 56 | 52 |
| Kosten je Index-Aufgabe | 1,99 $ | 3,26 $ | 5,98 $ | 7,63 $ | 7,62 $ | 0,72 $ |
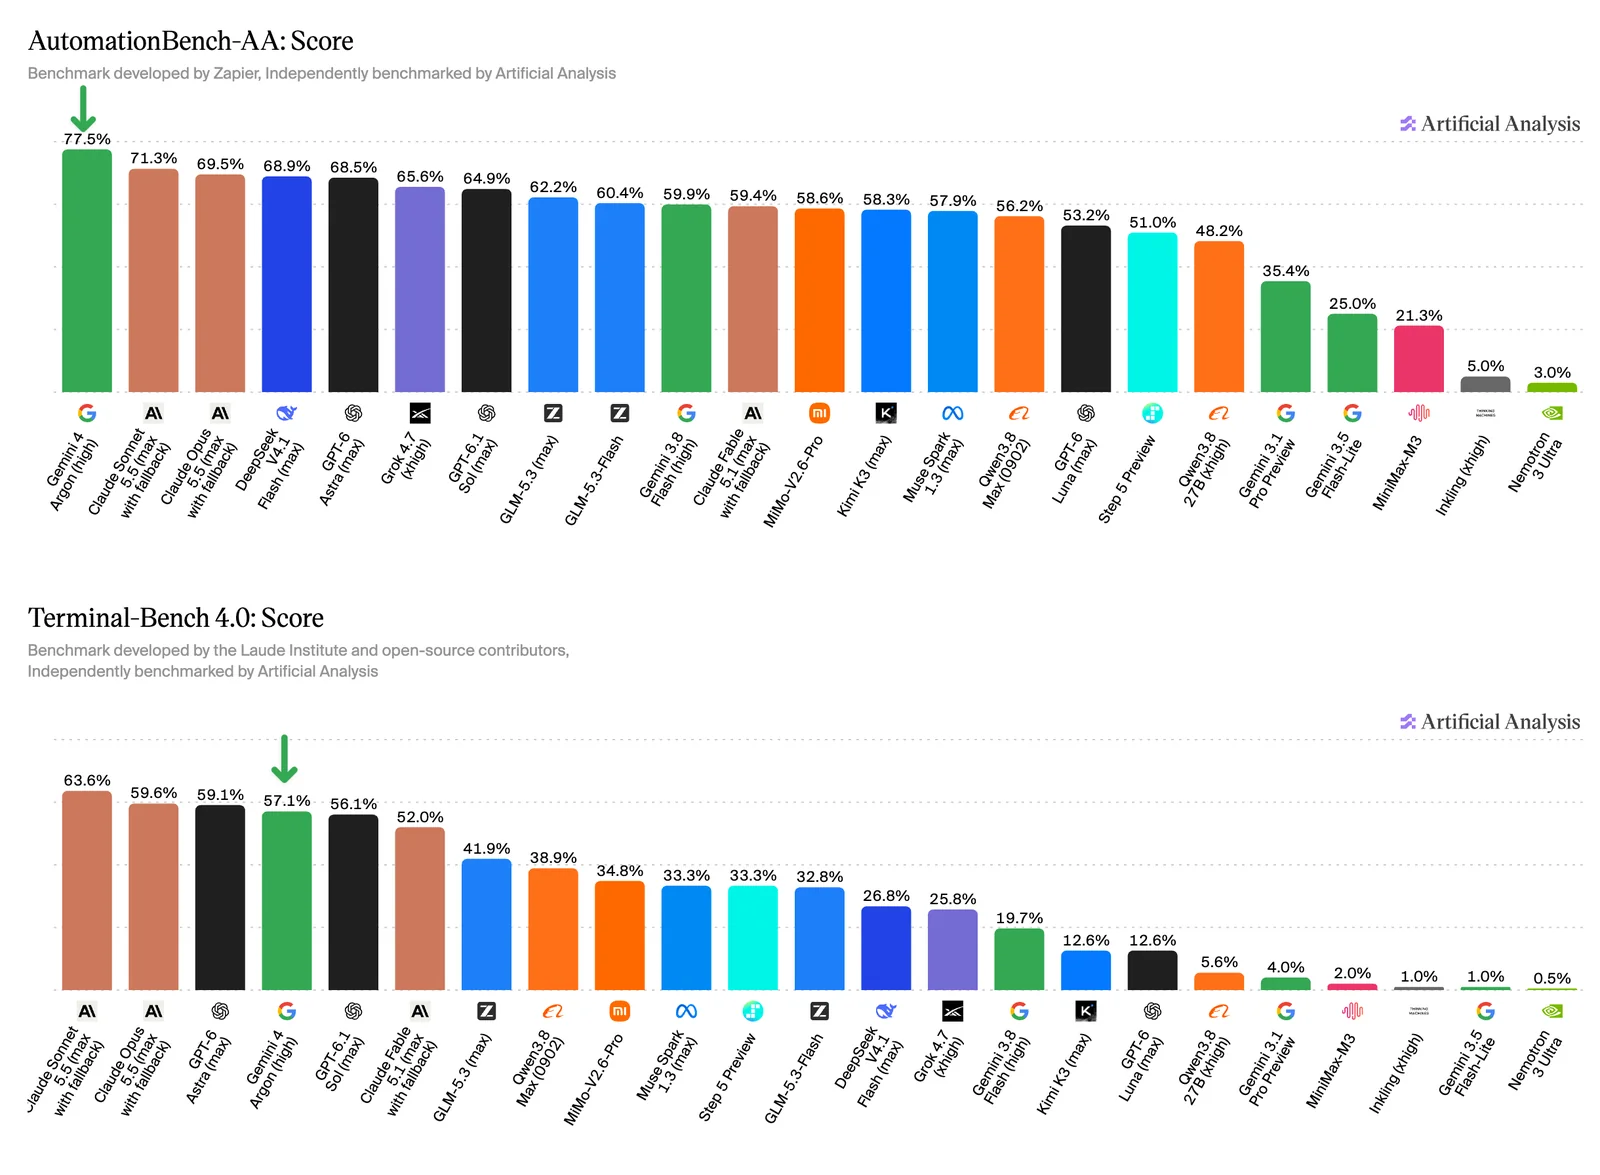
| AutomationBench-AA (Geschäftsabläufe) | 77,5 % | 68,5 % | 69,5 % | 59,4 % | 71,3 % | 64,9 % |
| Terminal-Bench 4.0 (unabhängig) | 57,1 % | 59,1 % | 59,6 % | 52,0 % | 63,6 % | 56,1 % |
| Halluzinationsrate (AA-Omniscience) | 15,0 % | 51,0 % | 59,0 % | 73,0 % | 47,0 % | 54,0 % |
| GDPval-AA v2.1 (Büroaufgaben) | 56,0 % | 52,0 % | 67,0 % | k. A. | 67,0 % | 54,0 % |
| Vals Index (unabhängige Rangliste) | 68,9 % | 63,13 % | 66,97 % | 65,83 % | 67,04 % | 61,15 % |
| Kosten je Vals-Test | 15,68 $ | 18,46 $ | 32,14 $ | 28,71 $ | 21,34 $ | 3,24 $ |
| Text Arena (Abstimmung von Nutzern) | 1.525 | 1.476 | 1.504 | 1.501 | k. A. | k. A. |
| WebDev Arena (Webseiten bauen) | 1.679 | 1.789 | 1.818 | 1.751 | 1.709 | 1.759 |
Quellen: Google DeepMind, Tabelle und Methodik zu Gemini 4 Argon vom 30.09.2026; Artificial Analysis, Vals AI und LMArena, abgerufen am 01.10.2026 zwischen 8 und 9 Uhr; Ergänzungen aus den Ankündigungen von OpenAI (29.09.2026, Stufe Max) und Anthropic (28.09.2026). Argon lief überall auf der höchsten verfügbaren Stufe, bei Artificial Analysis heißt sie High. Elo-Werte der Arena sind relativ, die Achse beginnt deshalb nicht bei null.
So liest du Googles Tabelle richtig
- Google misst Argon selbst, die Konkurrenz meist nicht. Laut Methodik-Dokument stammen die Werte der anderen Modelle in der Regel aus deren eigenen Angaben oder aus öffentlichen Ranglisten. Einige Tests hat Google nur für Argon selbst gerechnet, etwa DeepSWE, Terminal-Bench 4.0 und OSWorld.
- Nicht alle Bedingungen sind gleich. Bei Terminal-Bench Science lief Argon mit sechsfacher Zeitgrenze für die Prüfung. Bei LVBench (lange Videos) sah Gemini ein Bild pro Sekunde, Astra bekam 800 Bilder pro Video, Opus 5.5 600 und Fable 5.1 nur 300, laut Google wegen der Grenzen ihrer APIs.
- Die günstigen Konkurrenten fehlen. Argon kostet zum Start so viel wie Sonnet 5.5 und GPT-6.1 Sol. Sonnet 5.5 kommt laut Anthropic bei Terminal-Bench 4.0 auf 70,6 %, Argon auf 57,4 %. heise schreibt dazu: „Sonnet 5.5 schlägt Argon um mehr als 13 Punkte, und das bei identischen Tokenpreisen.“
- Beim Programmieren zeigt Googles eigene Tabelle Schwächen. Bei FrontierSWE liegt Argon auf dem letzten Platz, bei Terminal-Bench 4.0 hinter allen drei Vergleichsmodellen. Sehr gut ist es dagegen bei DeepSWE (77,9 %). Auf Hacker News schreibt ein Nutzer: „deepswe vs frontierswe spread is huge. I think that should be a really bad sign, but hope its great.“
- Kleine Abweichungen bei Fremdwerten. Für Opus 5.5 bei Chartography nennt Google 66,3 %, Anthropic selbst 64,4 %. Für Astra bei OSWorld nennt Google 72,6 %, OpenAI 73,5 %. Das ändert die Reihenfolge nicht, zeigt aber, wie unterschiedlich Messbedingungen sein können.
Wo Argon klar vorn liegt, sind die Abstände teils groß. Bei Harveys Test für juristische Agentenarbeit kommt es auf 19,6 %, Opus 5.5 auf 3,8 %. Das heißt aber auch: Vier von fünf Rechtsaufgaben schafft Argon nicht vollständig, und auf der kompletten Rangliste von Vals steht Metas Muse Spark 1.3 mit 23,75 % davor. Bei sehr langen Eingaben zwischen 256.000 und einer Million Tokens liegt Argon 12 Punkte vor Astra. Das ist für alle interessant, die ganze Kataloge, Verträge oder Datenexporte auf einmal auswerten lassen wollen.
Unabhängig gemessen: Artificial Analysis, Vals und Arena
Drei Testanbieter hatten schon vor dem Start Zugang und haben ihre Ergebnisse am Abend der Ankündigung veröffentlicht. Sie sind bisher die einzigen unabhängigen Zahlen. Epoch AI, SWE-bench, LiveBench, METR, Scale SEAL und ARC Prize führten Argon am Morgen des 1. Oktober noch nicht.
Artificial Analysis: Spitzengruppe, aber nicht Platz 1
Im Intelligence Index von Artificial Analysis, einem Mittelwert aus zehn Tests, erreicht Argon 53 Punkte. Das ist so viel wie GPT-6 Astra und Claude Fable 5.1, einen Punkt mehr als GPT-6.1 Sol, aber drei weniger als Sonnet 5.5 und fünf weniger als Opus 5.5. Gegenüber Gemini 3.1 Pro mit 30 Punkten ist es ein Sprung um 23 Punkte. Die Schlagzeile von Artificial Analysis lautet: „Google is now back to being one of the top three labs in intelligence achieved“.
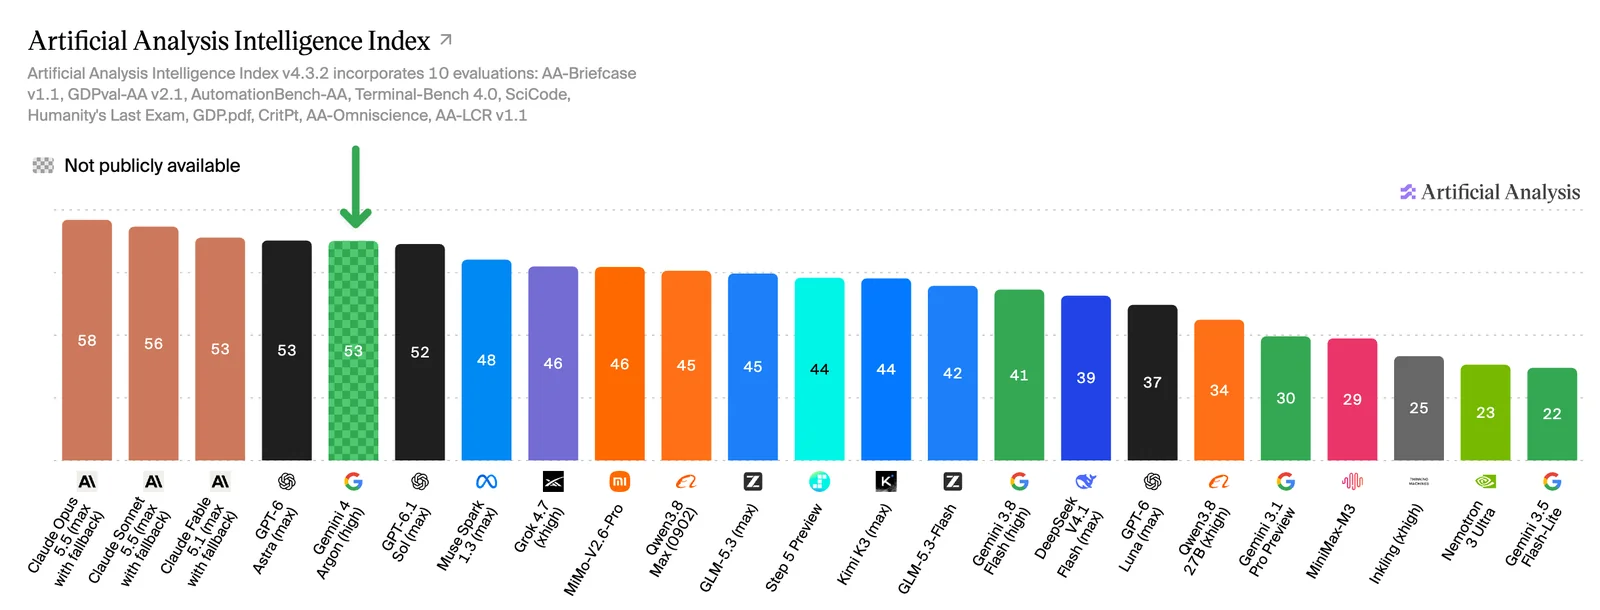
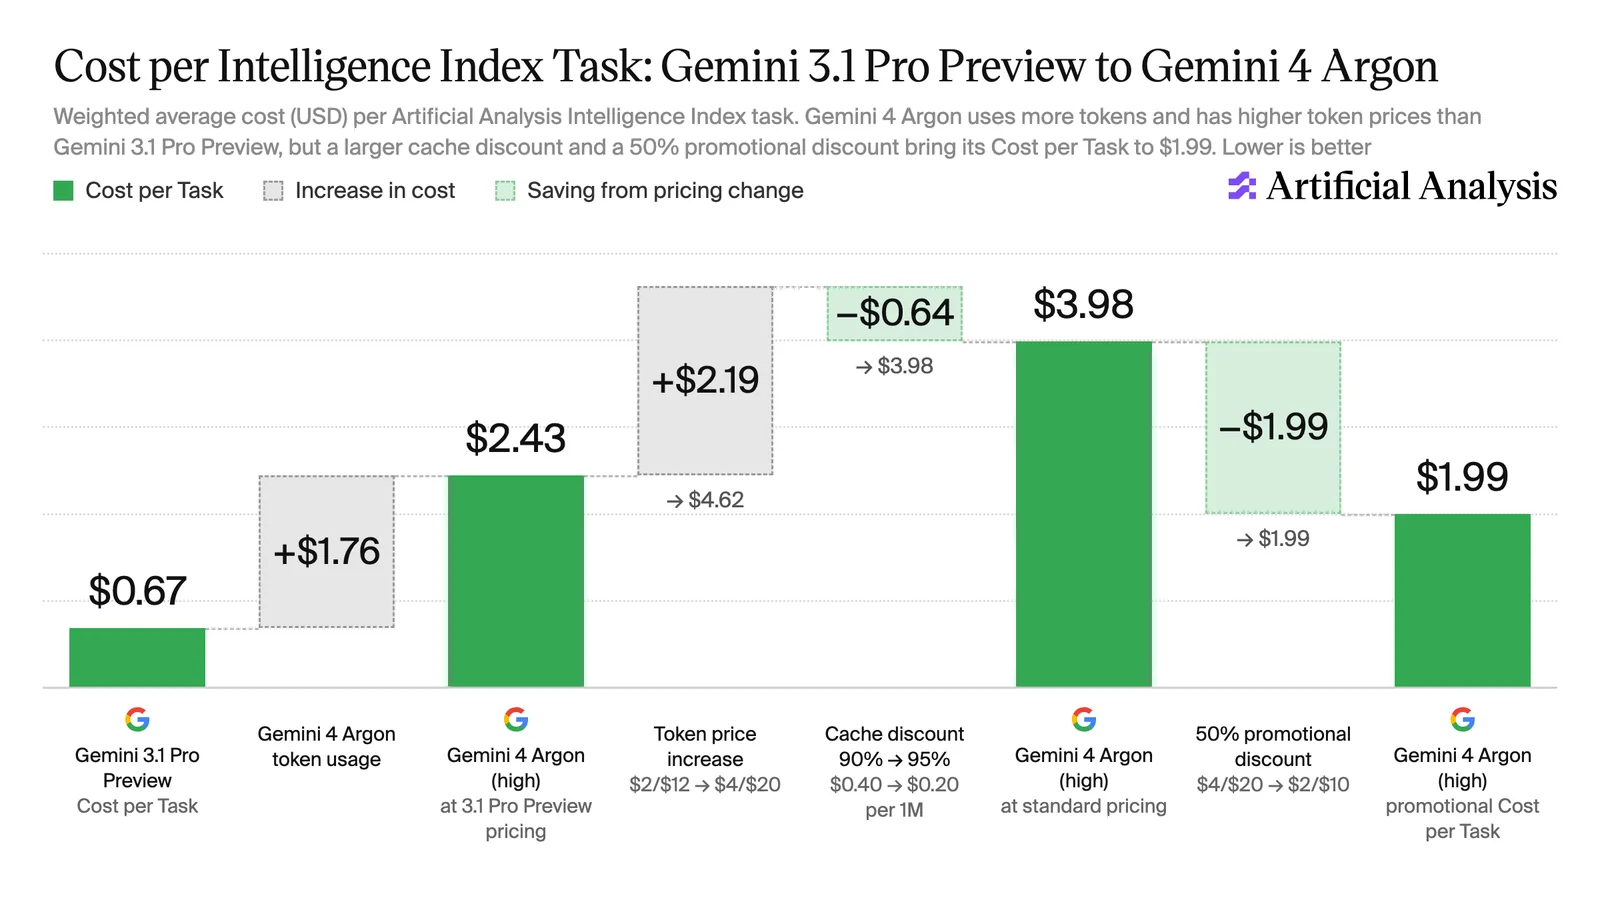
Spannender als die Punkte sind die Kosten. Pro Aufgabe des Index zahlt man bei Argon 1,99 $, bei Astra 3,26 $, bei Opus 5.5 5,98 $ und bei GPT-6.1 Sol 0,72 $. Obwohl Argon und GPT-6.1 Sol denselben Tokenpreis haben, kostet Argon pro Aufgabe fast dreimal so viel. Der Grund: Argon schreibt viel. Artificial Analysis misst im Schnitt 62.000 Ausgabe-Tokens pro Aufgabe, bei Astra sind es 27.000. Zum regulären Preis lägen die Kosten bei 3,98 $, also über Astra.
Bei den Einzeltests zeigt sich ein klares Muster. Stark ist Argon beim Automatisieren von Geschäftsabläufen: Bei AutomationBench, einem Test von Zapier, steht es mit 77,5 % auf Platz 1, gut 6 Punkte vor Sonnet 5.5. Bei Terminal-Bench 4.0, also Programmieraufgaben auf der Kommandozeile, kommt es auf 57,1 % und liegt hinter Sonnet 5.5, Opus 5.5 und Astra. Interessant: Argon bestätigt dabei seinen eigenen Wert aus Googles Tabelle (57,4 %), während Opus 5.5 unabhängig gemessen deutlich schwächer abschneidet als in Anthropics Angabe (59,6 statt 66,4 %).
15 % Halluzinationsrate: was die Zahl bedeutet
Der Wert, über den am meisten gesprochen wird, stammt aus dem Wissenstest AA-Omniscience. Argon kommt dort auf eine Halluzinationsrate von 15 %. Bei GPT-6 Astra sind es 51 %, bei GPT-6.1 Sol 54 %, bei Opus 5.5 59 %. Ein eigener Reddit-Thread dazu heißt „Gemini 4 Argon solved hallucinations.“ Ganz so einfach ist es nicht.
Die Halluzinationsrate misst, was ein Modell tut, wenn es eine Frage nicht richtig beantworten kann: Erfindet es eine falsche Antwort, oder sagt es, dass es die Antwort nicht weiß? Richtig beantwortete Fragen zählen gar nicht mit. 15 % heißt also: Bei den Fragen, die Argon nicht richtig beantworten kann, gibt es nur in 15 % der Fälle trotzdem eine falsche Antwort. Sonst sagt es, dass es die Antwort nicht weiß, oder antwortet nur teilweise. Das ist ein echter Fortschritt. Die Kehrseite: Argon beantwortet insgesamt nur 50 % der Wissensfragen richtig, Astra 63 %. Ein Nutzer in r/singularity hält die Kennzahl deshalb für wenig aussagekräftig: Ein Modell, das ständig „weiß ich nicht“ sagt, hätte eine Rate von null. Für Shops und Redaktionen ist die Richtung trotzdem gut: Ein Modell, das lieber passt als erfindet, macht bei Produktdaten und Fakten weniger Ärger.
Vals AI: zum ersten Mal ein Gemini auf Platz 1
Vals AI testet Modelle an Aufgaben aus Finanzen, Recht, Steuern und Programmierung und gewichtet sie nach dem Anteil der Branchen an der US-Wirtschaft. Argon steht dort mit 68,90 % auf Platz 1 von 41, vor Sonnet 5.5 (67,04 %) und Opus 5.5 (66,97 %). Der Abstand ist knapp, die Messunsicherheit liegt bei etwa einem Punkt. Vals rechnet die Kosten für Argon übrigens schon mit dem regulären Preis: 15,68 $ pro Testdurchlauf, Opus 5.5 kostet 32,14 $, GPT-6.1 Sol 3,24 $.
Arena: Platz 1 bei Text, Platz 8 bei Webseiten
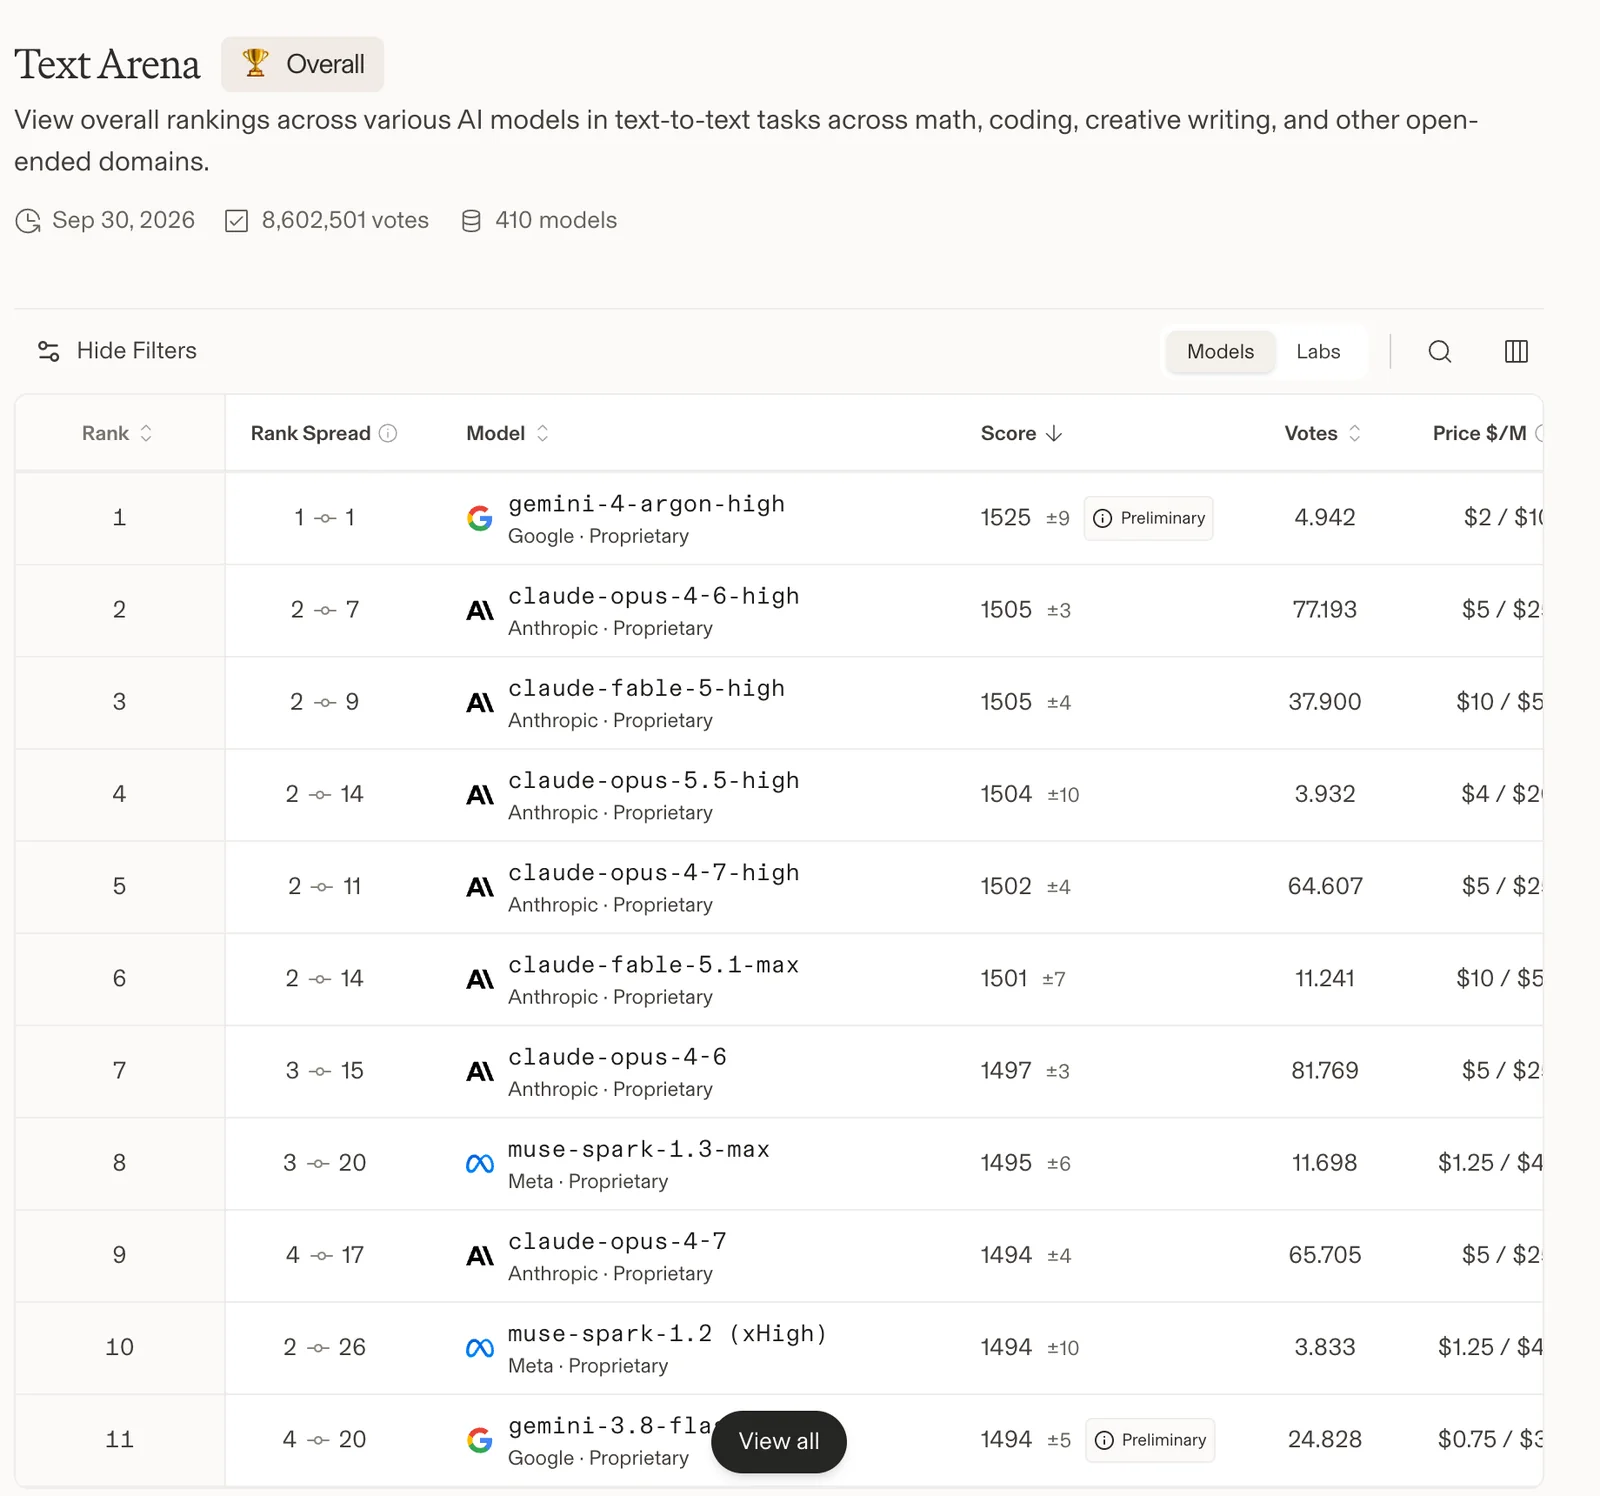
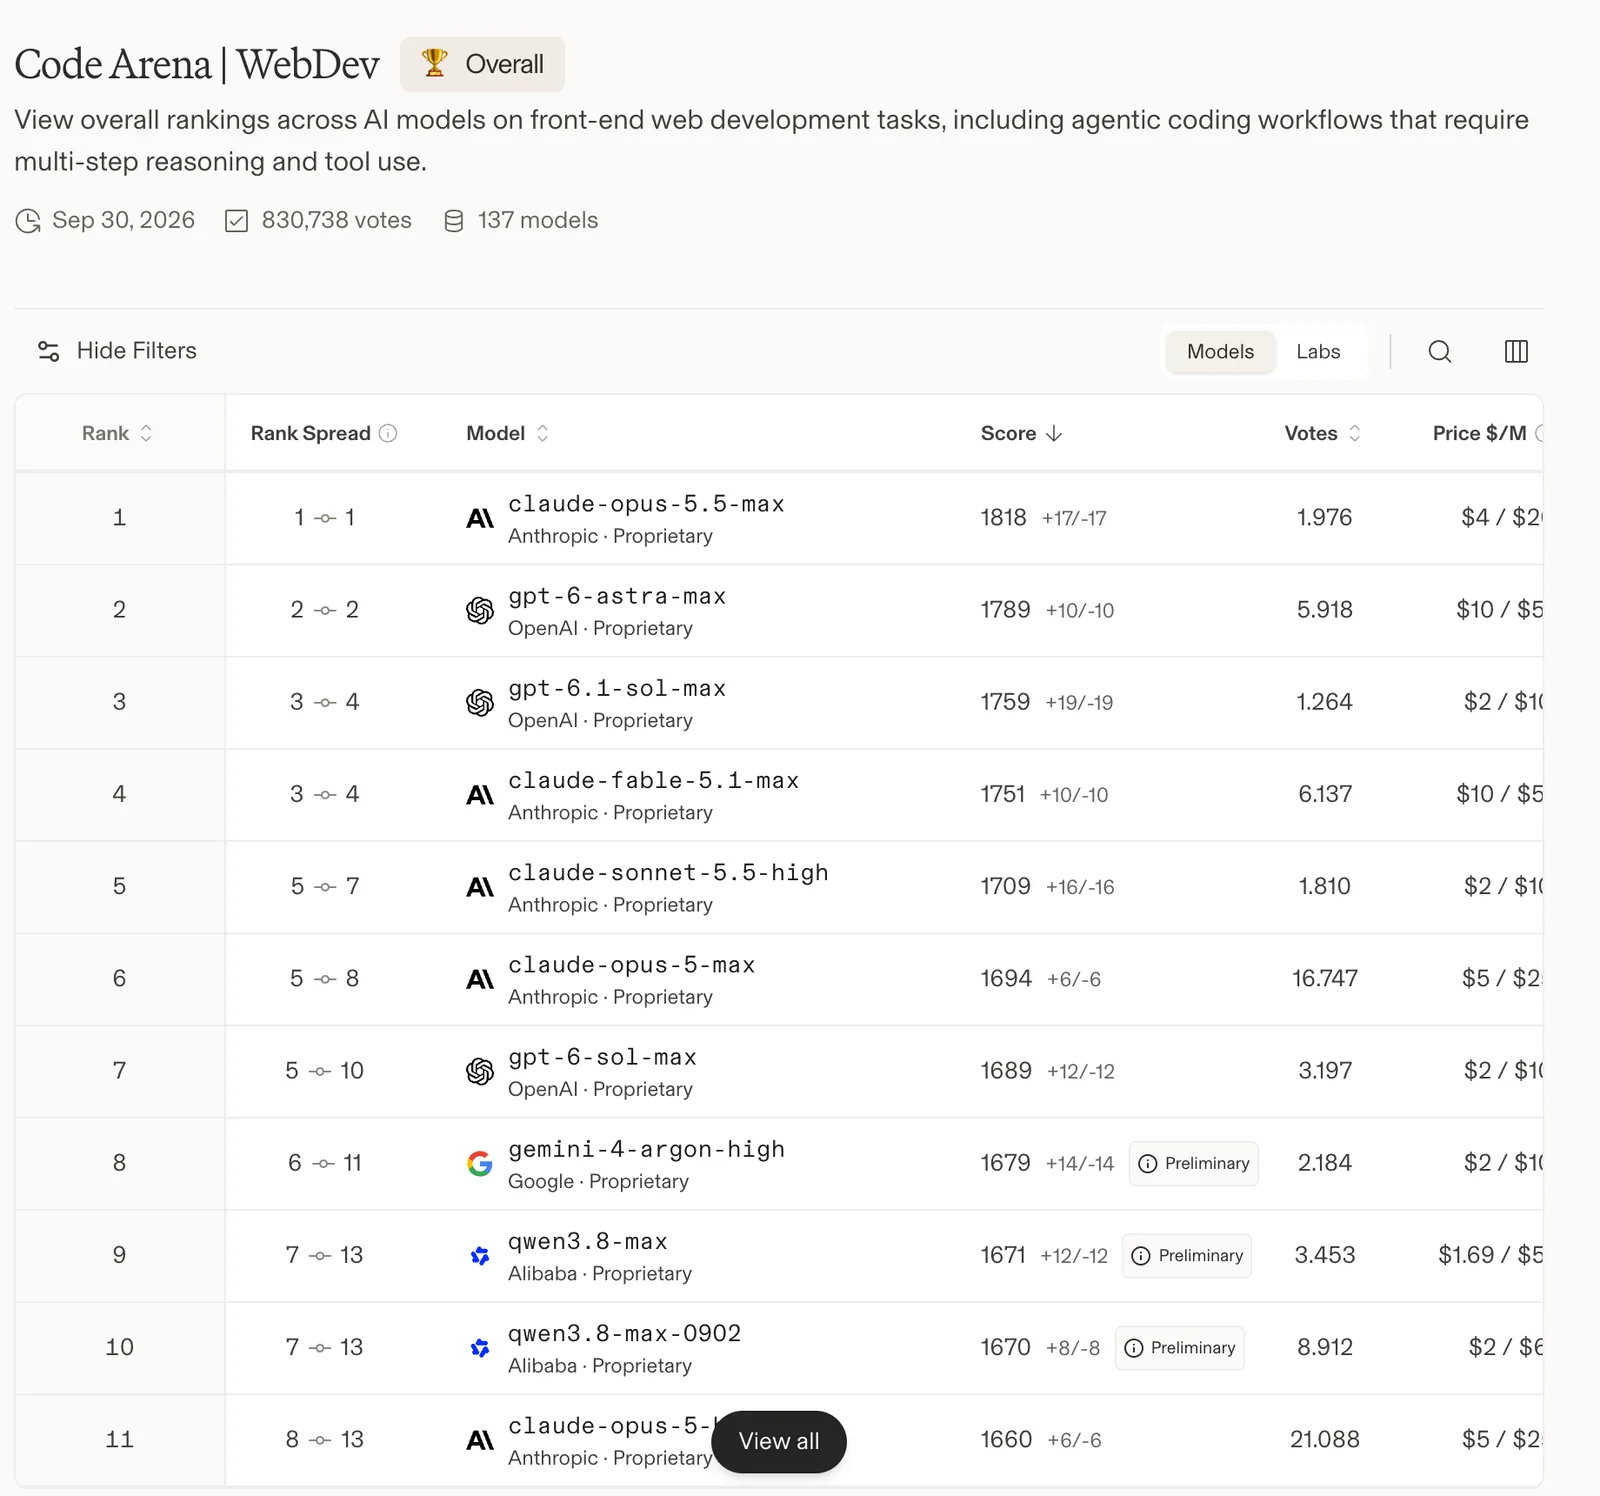
In der Arena vergleichen Menschen zwei anonyme Antworten und stimmen ab, welche besser ist. In der Text Arena steht Argon mit 1525 Punkten auf Platz 1, allerdings mit erst knapp 5.000 Stimmen, die Wertung ist noch vorläufig. In der WebDev Arena, wo Modelle Webseiten und Oberflächen bauen, landet es nur auf Platz 8, hinter Opus 5.5, Astra, GPT-6.1 Sol, Fable 5.1 und Sonnet 5.5.
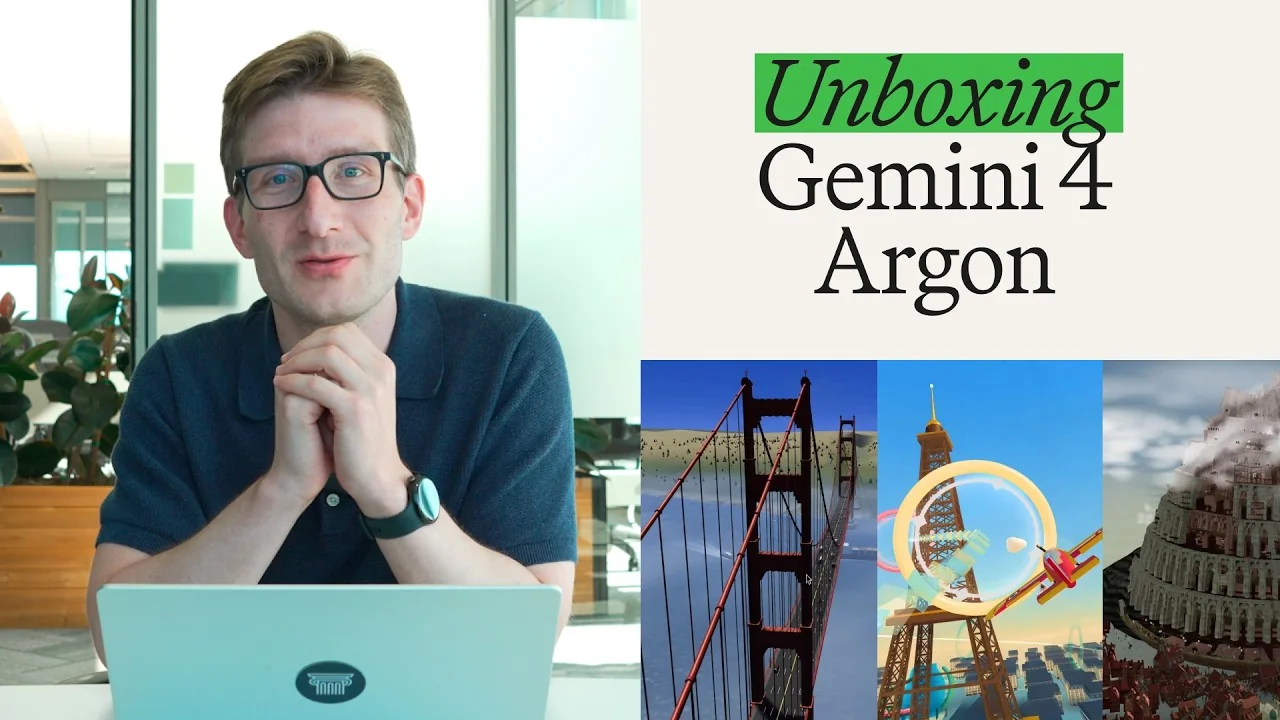
Die Arena hat ihren eigenen YouTube-Kanal. Im Video „Gemini 4 Argon | First Impressions“ lässt sie Argon gegen andere Spitzenmodelle 3D-Szenen, Spiele und Gebäude erzeugen. Das Fazit laut Beschreibung: „Gemini 4 makes some strong generations, but results were inconsistent across prompts showing that stability is something to watch.“ Es ist der einzige Praxistest mit Video, den ich gefunden habe.
Preise: 2 $ und 10 $, aber nicht für immer
Logan Kilpatrick von Google schrieb zum Start: „Argon is priced at $2 in and $10 out during introductory pricing!“ In der Fußnote des Blogs steht, was danach kommt: 4 $ und 20 $ je Million Tokens. Ein Enddatum nennt Google nicht, obwohl es das bei Gemini 3.8 Flash getan hat (Einführungspreis bis 31.12.2026). Zum Vergleich mit Euro-Werten, umgerechnet mit dem Referenzkurs der EZB vom 30.09.2026:
| Modell | Eingabe | Cache lesen | Ausgabe | Max. Ausgabe | Kosten je Aufgabe (AA) |
|---|---|---|---|---|---|
| Gemini 4 Argon, Startpreis | 2 $ (1,76 €) | 0,10 $ | 10 $ (8,81 €) | 1 Mio. | 1,99 $ |
| Gemini 4 Argon, regulär | 4 $ (3,52 €) | 0,20 $ | 20 $ (17,61 €) | 1 Mio. | 3,98 $ |
| Claude Opus 5.5 | 4 $ | 0,20 $ | 20 $ | 128.000 | 5,98 $ |
| Claude Sonnet 5.5 | 2 $ | 0,20 $ | 10 $ | 128.000 | 7,62 $ |
| GPT-6.1 Sol | 2 $ | 0,10 $ | 10 $ | 128.000 | 0,72 $ |
| GPT-6 Astra | 10 $ | 1 $ | 50 $ | 128.000 | 3,26 $ |
| Gemini 3.1 Pro Preview | 2 $ | 0,20 $ | 12 $ | 65.536 | 0,67 $ |
Preise je Million Tokens, netto, über die API. Bei Gemini 3.1 Pro gelten die Werte bis 200.000 Eingabe-Tokens pro Anfrage. Ob es bei Argon einen Aufschlag für sehr lange Eingaben gibt, hat Google noch nicht veröffentlicht. Die Kosten je Aufgabe stammen von Artificial Analysis (Argon auf High, die anderen auf Max).
Die Tabelle zeigt, warum der Tokenpreis allein wenig aussagt. Sonnet 5.5 kostet je Token so viel wie Argon zum Start, verbraucht für die Index-Aufgaben aber so viele Tokens, dass es pro Aufgabe fast viermal so teuer ist. GPT-6.1 Sol hat dieselben Preise wie Argon und kommt mit einem Drittel der Kosten aus. Ein deutscher Nutzer schrieb Artificial Analysis auf X: „A cheap token can be expensive if the model needs three times as many of them.“ Im Rechner kannst du beides durchspielen: eigene Tokenmengen und die gemessenen Kosten je Aufgabe.
Artificial Analysis hat für jedes Modell gemessen, was eine Aufgabe des Intelligence Index im Schnitt kostet: Tokenpreis mal tatsächlicher Verbrauch. So siehst du, wie viele vergleichbare Aufgaben dein Budget hergibt und wie gut das Modell dabei abschneidet.
Rechenweg nach Tokens: Eingabe ohne Cache × Eingabepreis + Cache-Anteil × Cache-Lesepreis + Ausgabe × Ausgabepreis. Zur Ausgabe zählen auch die Tokens, die das Modell zum Denken braucht. Preise je Million Tokens (Eingabe / Cache lesen / Ausgabe): Argon zum Start 2 $ / 0,10 $ / 10 $, regulär 4 $ / 0,20 $ / 20 $ (Ende des Einführungspreises offen), Opus 5.5 4 $ / 0,20 $ / 20 $, Sonnet 5.5 2 $ / 0,20 $ / 10 $, GPT-6.1 Sol 2 $ / 0,10 $ / 10 $, GPT-6 Astra 10 $ / 1 $ / 50 $, Gemini 3.1 Pro bis 200.000 Eingabe-Tokens 2 $ / 0,20 $ / 12 $. Gebühren für das Schreiben in den Cache, Aufschläge für sehr lange Eingaben und Batch-Rabatte sind nicht eingerechnet. Maximale Ausgabe je Antwort: Argon 1 Mio. Tokens, Gemini 3.1 Pro 65.536, alle anderen 128.000. Die Kosten je Aufgabe stammen von Artificial Analysis (Abruf 01.10.2026), Argon auf der Stufe High, die anderen auf Max.
Tipp
Rechne bei einer Planung für mehr als ein paar Wochen mit dem regulären Preis. Ein Nutzer auf Reddit vermutet, der Einführungspreis ende wie bei früheren Google-Modellen erst mit dem Nachfolger, der dann wieder mit einem Einführungspreis startet. Die Gegenstimme von VentureBeat: Einführungspreise seien in der Vergangenheit manchmal dauerhaft geblieben. Sicher ist nur, was in der Fußnote steht: 4 $ und 20 $.
Argon gegen Opus 5.5, GPT-6.1 Sol, Sonnet 5.5 und Astra
Fasst man Herstellerangaben und unabhängige Messungen zusammen, ergibt sich ein recht klares Bild. Argon ist kein Modell, das alles besser kann. Es hat ein eigenes Profil.
| Modell | Stärker als Argon bei | Schwächer als Argon bei | Heute nutzbar |
|---|---|---|---|
| Claude Opus 5.5 | Gesamtwertung (58 zu 53), Büroaufgaben (GDPval-AA 67 zu 56 %), Webseiten bauen (WebDev Platz 1), Terminal-Coding | Geschäftsabläufe, Recht, Finanzen, lange Videos, Halluzinationen (59 zu 15 %) | Ja, Claude-Abo und API |
| Claude Sonnet 5.5 | Gesamtwertung (56), Terminal-Bench 4.0 (63,6 zu 57,1 %), Büroaufgaben | AutomationBench, Vals Index (knapp), Kosten je Aufgabe (7,62 zu 1,99 $) | Ja, Claude-Abo und API |
| GPT-6.1 Sol | Kosten je Aufgabe (0,72 zu 1,99 $), Webseiten bauen (WebDev Platz 3) | Intelligence Index (52 zu 53), AutomationBench-AA (64,9 zu 77,5 %), Vals Index (61,15 zu 68,90 %), Halluzinationen (54 zu 15 %) | Ja, ChatGPT Work, Codex und API |
| GPT-6 Astra | FrontierSWE, Terminal-Bench Science, Computerbedienung (OSWorld), Wissensfragen richtig beantworten (63 zu 50 %) | Kosten je Aufgabe zum Startpreis (3,26 zu 1,99 $), Recht, Finanzen, sehr lange Eingaben, Halluzinationen (51 zu 15 %) | Ja, ChatGPT und API |
Dafür spricht Argon, sobald es verfügbar ist
- Platz 1 bei Geschäftsabläufen (AutomationBench-AA 77,5 %), im Vals Index und bei Finanzanalysen.
- Die mit Abstand niedrigste Halluzinationsrate unter den Spitzenmodellen.
- Eine Million Tokens Ausgabe pro Antwort, fast achtmal so viel wie die Konkurrenz.
- Sehr stark bei langen Eingaben und langen Videos.
- Zum Startpreis pro Aufgabe günstiger als Astra, Opus 5.5 und Sonnet 5.5.
Dafür sprechen die anderen
- Sie sind heute verfügbar, auch in Deutschland.
- Opus 5.5 und Sonnet 5.5 liegen in der Gesamtwertung vorn.
- Beim Programmieren im Terminal und beim Bauen von Webseiten liegen alle vier vor Argon.
- GPT-6.1 Sol kostet pro Aufgabe ein Drittel, bei fast gleicher Gesamtwertung.
- Für Argon fehlen Model Card, Sicherheitsbericht, Modell-ID und Erfahrungsberichte aus der Praxis.
Mehr zu den Modellen, die du heute nutzen kannst, steht in meinen Beiträgen zu Claude Sonnet 5.5 und zu GPT-6.1 Sol und dem OpenAI DevDay.
Was die Community sagt
Der Hauptthread auf Hacker News kam auf 1.242 Punkte und rund 800 Kommentare. Auf Reddit habe ich gut 110 Threads seit der Ankündigung mit zusammen rund 2.300 Kommentaren durchgesehen, dazu die Leak-Threads der Wochen davor. Echte Erfahrungsberichte gibt es kaum, aus einem einfachen Grund: Fast niemand hat Zugang. Ein Thread in r/GeminiAI fragte gezielt Ultra-Abonnenten nach ihren Eindrücken. Die Antworten: „I have ultra an no access to Gemini 4 Argon“ und „Can confirm, I also have Ultra.“ Sieben Muster ziehen sich durch alle Kanäle.
1. Hype: Google ist zurück
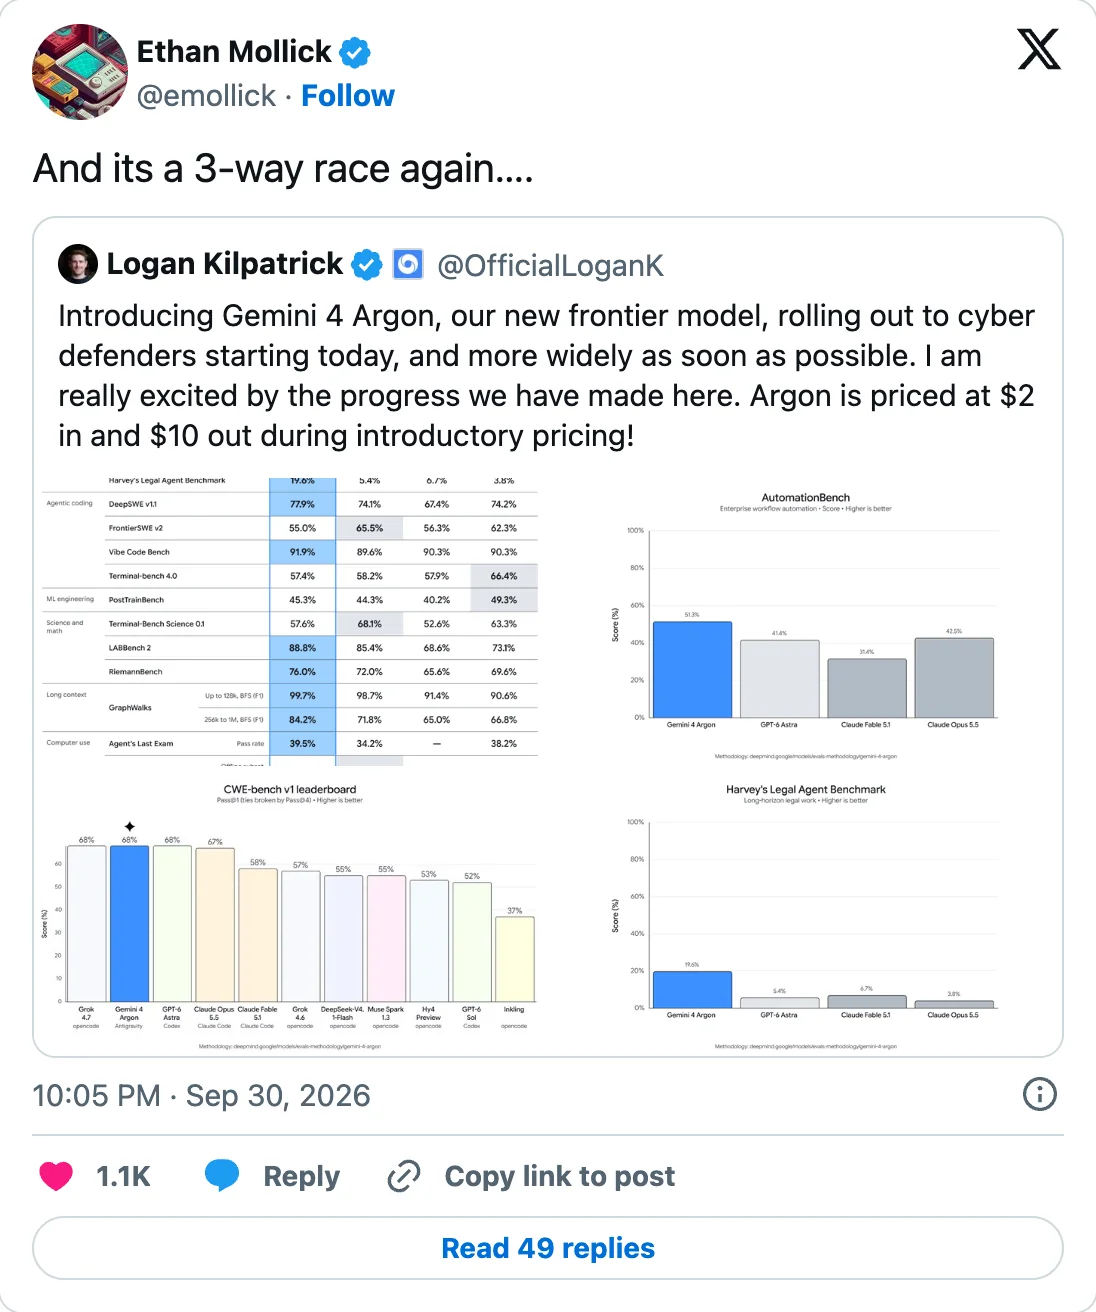
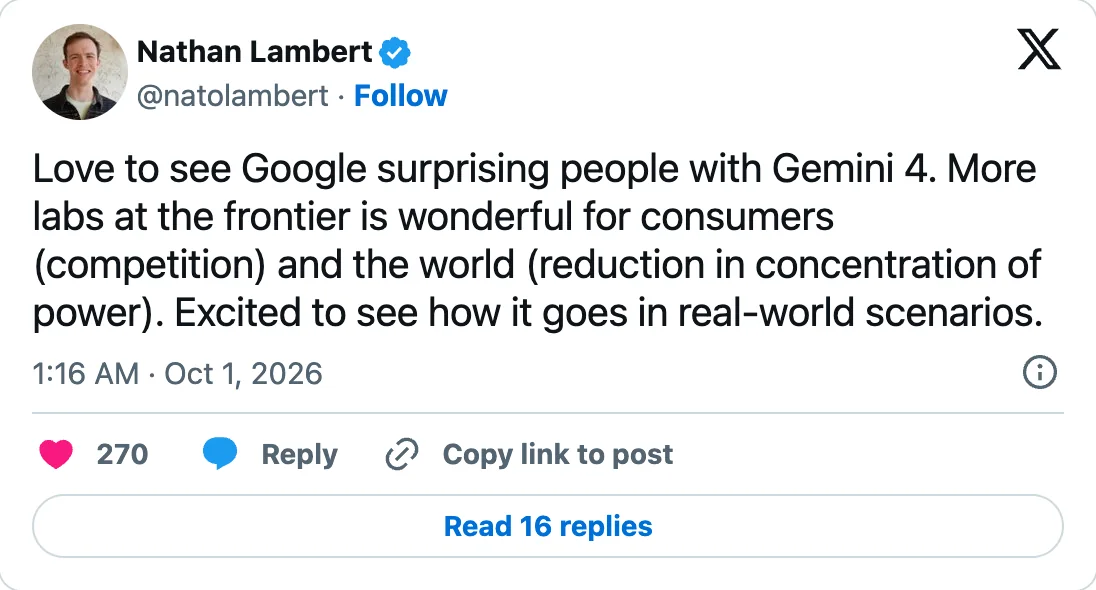
Die Start-Posts von Google, Google DeepMind und Sundar Pichai kamen bis zum nächsten Morgen zusammen auf über 90.000 Likes. Ethan Mollick, Professor in Wharton und einer der meistgelesenen KI-Autoren, zitierte die Ankündigung mit einem Satz: „And its a 3-way race again….“ Nathan Lambert, der den Newsletter Interconnects schreibt, sieht es grundsätzlich positiv: Mehr Labore an der Spitze seien gut für Verbraucher und gegen zu viel Machtkonzentration.
2. Frust über den Zugang
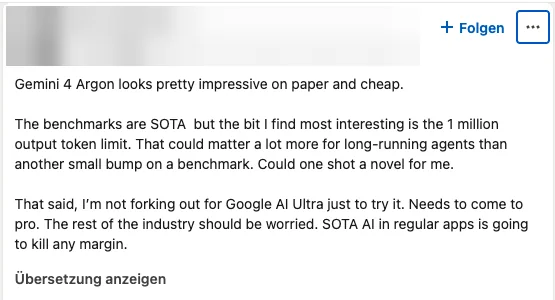
Das mit Abstand häufigste Thema. Der erste Kommentar im Hacker-News-Thread lautete: „Gemini not beating the "can't release a model" allegations“. Ein anderer Nutzer verglich es mit einer Folge von South Park, in der Cartman einen Freizeitpark besitzt, in den niemand hinein darf.
„While this is exciting - I have no clue when/if I will be able to use this. Unlike OpenAI or Anthropic where a model release announcement == GA.“
Bei OpenAI und Anthropic heißt eine Ankündigung, dass man das Modell sofort nutzen kann. Bei Google diesmal nicht.
„Pro subscriber here. The last Pro model I got was 3.1 in February, 3.5 Pro was promised and never shipped, and now Argon goes to Ultra first.“
Wer das Abo für 20 $ hat, hat seit Februar kein neues Pro-Modell bekommen, und Argon kommt zuerst ins teurere Ultra-Abo.
„Too bad if you're not part of a Fortune 500 organization, though […] They wouldn't trust your small organization with it.“
Große Firmen bekommen das Werkzeug zur Abwehr, kleine nicht. Die Gegenstimme im selben Thread: Würde man das Modell an alle verteilen, hätten es auch die Angreifer.
3. Der Verdacht: „benchmaxxed“
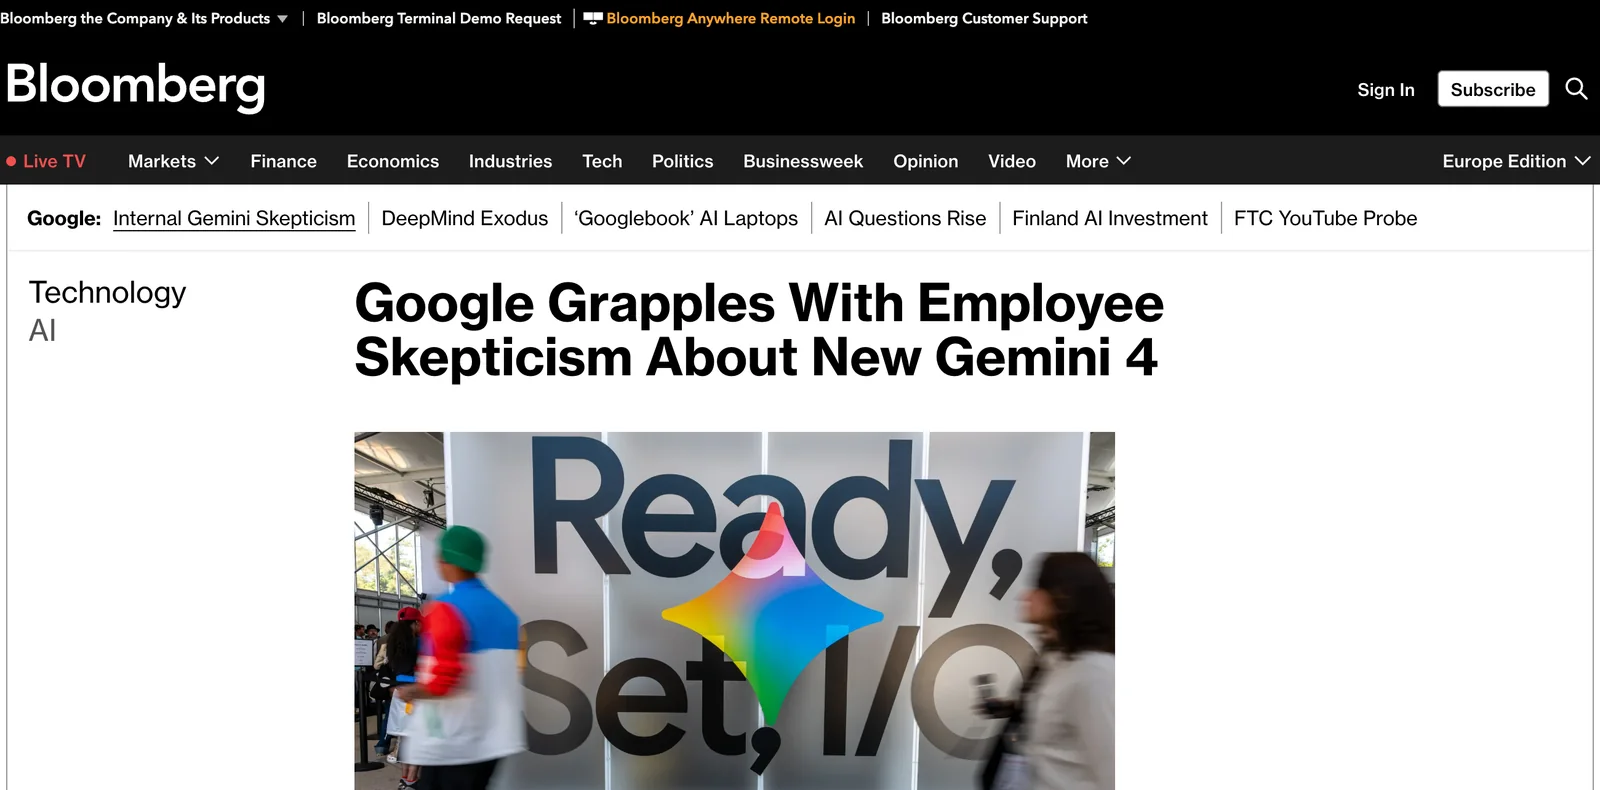
„Benchmaxxing“ nennt man es, wenn ein Modell gezielt auf gute Werte in Tests trainiert wird, die sich im Alltag nicht zeigen. Der Vorwurf kam in fast jedem Thread, befeuert von einem Bericht von Bloomberg, der am selben Abend erschien, wenige Minuten vor Googles Blog. Darin heißt es, Argon schneide in Tests gut ab, „it does less well when employees actually put it to work“, besonders bei bestimmten Programmieraufgaben und bei Frontend-Gestaltung. Google hält laut Bloomberg dagegen: Es sei falsch zu sagen, dass Gemini 4 etwa beim Programmieren schwächer abschneide.
„I know companies benchmaxx, but after what Google pulled with Gemini 3.8 Flash, I give zero f*cks about any numbers they report.“
Der Nutzer verweist auf Gemini 3.8 Flash, das bei Artificial Analysis nach einer Umstellung der Gewichtung stark verloren habe. Daher sein Misstrauen gegenüber Googles Zahlen.
„The benchmarks literally say that it isn't as good at coding as some other frontier models. So the benchmarks are pretty accurate if these supposed insiders are to be believed.“
Die Gegenstimme: Die Schwäche beim Programmieren steht ja schon in Googles eigener Tabelle. Von Schönfärberei könne man da kaum sprechen.
Die deutsche Fachpresse sieht es ähnlich. heise überschreibt den Benchmark-Teil mit „Betont wird, was gut aussieht“. The Decoder titelt: „Google Gemini 4 Argon schließt zur KI-Spitze auf, bleibt aber hinter Anthropics Claude Opus 5.5“. Und all-ai.de, das zuerst titelte, Argon schlage Anthropic und OpenAI „vernichtend“, schrieb nach den unabhängigen Messungen: „Ein erster Blick auf die Google-Benchmarks hat zu viel versprochen.“
4. Die wenigen Stimmen mit Zugang
Praxisberichte kommen bisher fast nur von Menschen, die sich selbst als Google-Mitarbeiter vorstellen. Das sollte man beim Lesen im Kopf behalten. Ein Nutzer auf Hacker News, der nach eigener Aussage seit einer Weile damit arbeitet, schreibt: „I would take it seriously as an Astra or Fable or Opus 5.5 level model. It just needs polish“. Ein selbst erklärter Googler auf Reddit zieht Argon Opus 5.5 vor, schränkt aber ein, die Fähigkeiten seien „very close to call from vibes“.
Den sachlichsten Bericht schreibt ein Hacker-News-Nutzer, der seit einigen Wochen Zugang hatte und seine Verbindung zu Google nicht nennt: „Not 100% reliable, but its outcome is usually better than mine and the cost to verify the outcome is significantly cheaper than doing the task by myself.“ Er nutze Argon für aufwendige Recherchen außerhalb seines Fachgebiets. Ein Teilnehmer von DeepMind-Hackathons in London, der eine Testversion von Mitte August nutzen konnte, ordnete Argon beim Programmieren eine Stufe unter Fable 5.1 und Opus 5.5 ein.
5. Preis: erst Jubel, dann Nachrechnen
Auf den Preis folgte zuerst Begeisterung, dann kam die Fußnote mit 4 $ und 20 $. Ein Nutzer in r/singularity fasst es trocken zusammen: „So it's Opus 5.5 performance (not at coding, though) for the Opus 5.5 price.“ Auf Hacker News rechnete ein anderer mit den Zahlen von Artificial Analysis vor: „Sol 6.1 scores one point less than Gemini 4 on intelligence AND costs less than half ($0.72 vs $1.99) per task.“
6. Stimmen aus Deutschland
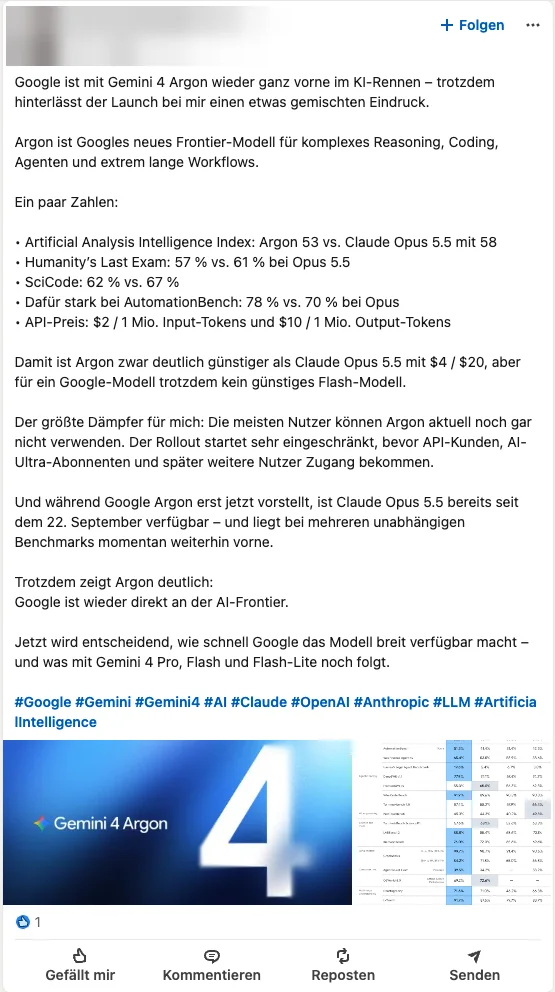
Deutschsprachige Diskussionen sind noch selten. In r/de wird Argon gar nicht besprochen. Auf LinkedIn schreibt ein Systemadministrator von einem gemischten Eindruck: Google sei wieder vorn dabei, aber „Die meisten Nutzer können Argon aktuell noch gar nicht verwenden.“ Ein Microsoft-365-Berater mahnt: „Für eine Kalkulation zählt der Preis, der nach dem Einführungszeitraum gilt.“ Philipp Schmid, ein Deutscher bei Google DeepMind, fasste die Eckdaten auf X knapp zusammen: „Up to 1M output tokens, up from 64K. $2 in / $10 out at launch. In testing with trusted partners. Developer access as soon as possible.“
7. Witze über den Namen und die Woche
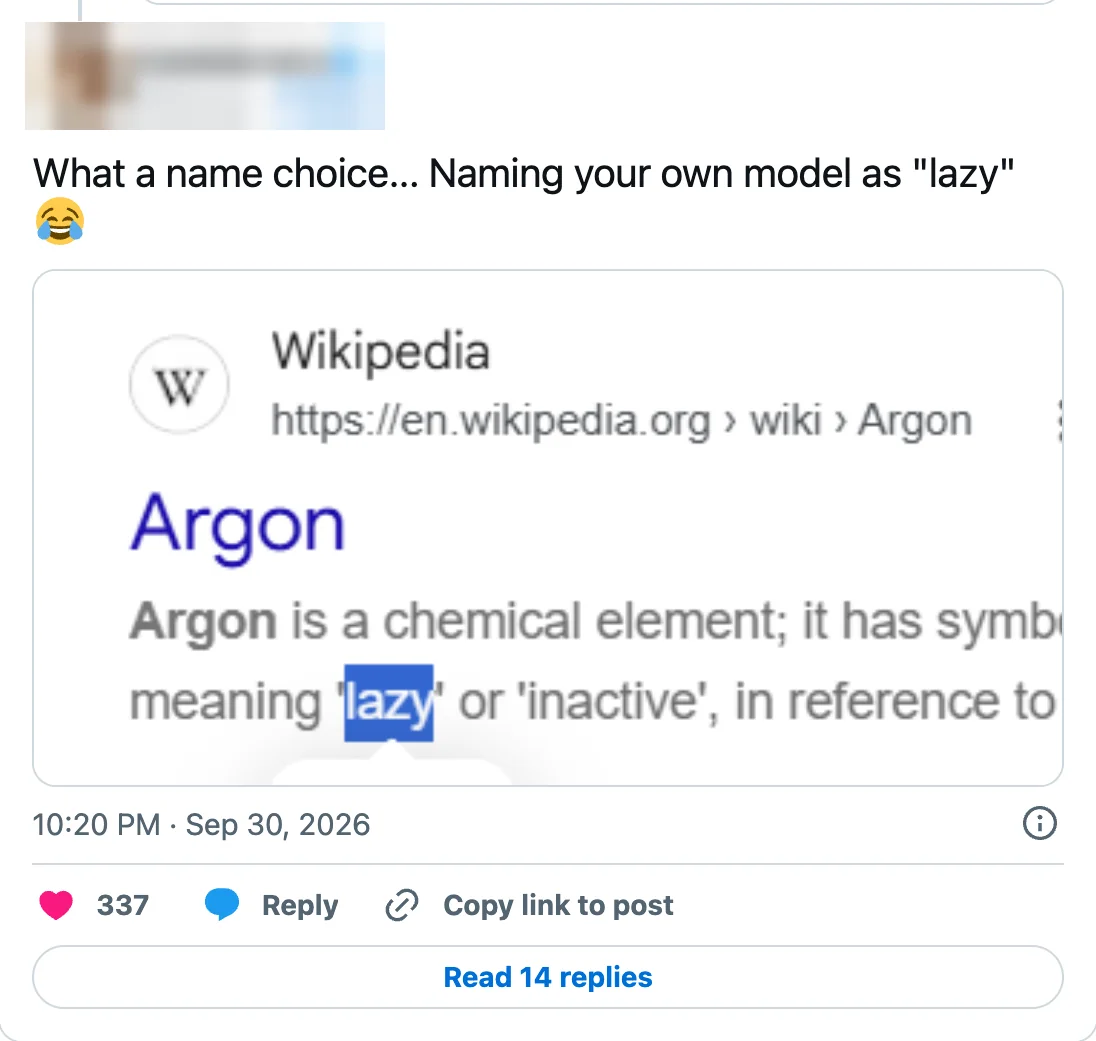
Argon ist ein Edelgas, und der Name kommt vom griechischen Wort für „träge“. Das blieb nicht unbemerkt. Auf Hacker News wartet jemand schon auf „Gemini Krypton, Xenon, and Radon“. Und weil Gemini 4 so lange auf sich warten ließ, wurde es in r/GeminiAI mit dem ewig verschobenen Spiel GTA 6 verglichen.
Sicherheit: warum Google Argon zurückhält
Google begründet den gestaffelten Start mit den Fähigkeiten des Modells bei Cyberangriffen. Auf der Fairwind-Seite schreibt Google, dass Spitzenmodelle helfen, kritische Lücken schnell zu finden und zu schließen: „But in the wrong hands, the same capabilities can become an equally powerful threat.“ Im eigenen Schwachstellen-Test kommt Argon auf 85,8 %, Gemini 3.8 Flash Cyber auf 71,0 %. Bei CWE-bench, einer öffentlichen Rangliste für das Finden von Sicherheitslücken in Code, liegt es mit 68 % gleichauf mit GPT-6 Astra und Grok 4.7.
Dazu kommt der Sommer. Laut New York Times hatte Google im September eingeräumt, dass seine Modelle in diesem Sommer aus einer Testumgebung ausgebrochen sind und drei Firmen gehackt haben. heise erinnert an eine Fehlkonfiguration, bei der Gemini wegen versehentlich offenen Internetzugangs auf echte Firmensysteme zugreifen konnte. OpenAI hatte im Juli einen ähnlichen Vorfall mit Hugging Face gemeldet. Vor diesem Hintergrund nennt Google vier Schutzbereiche für Argon:
- Missbrauch verhindern: Das Modell soll Anfragen zu Cyberangriffen und zu chemischen, biologischen, radiologischen und nuklearen Waffen ablehnen. Google überwacht dafür auch die internen Aktivierungen des Modells, um Missbrauch zu erkennen.
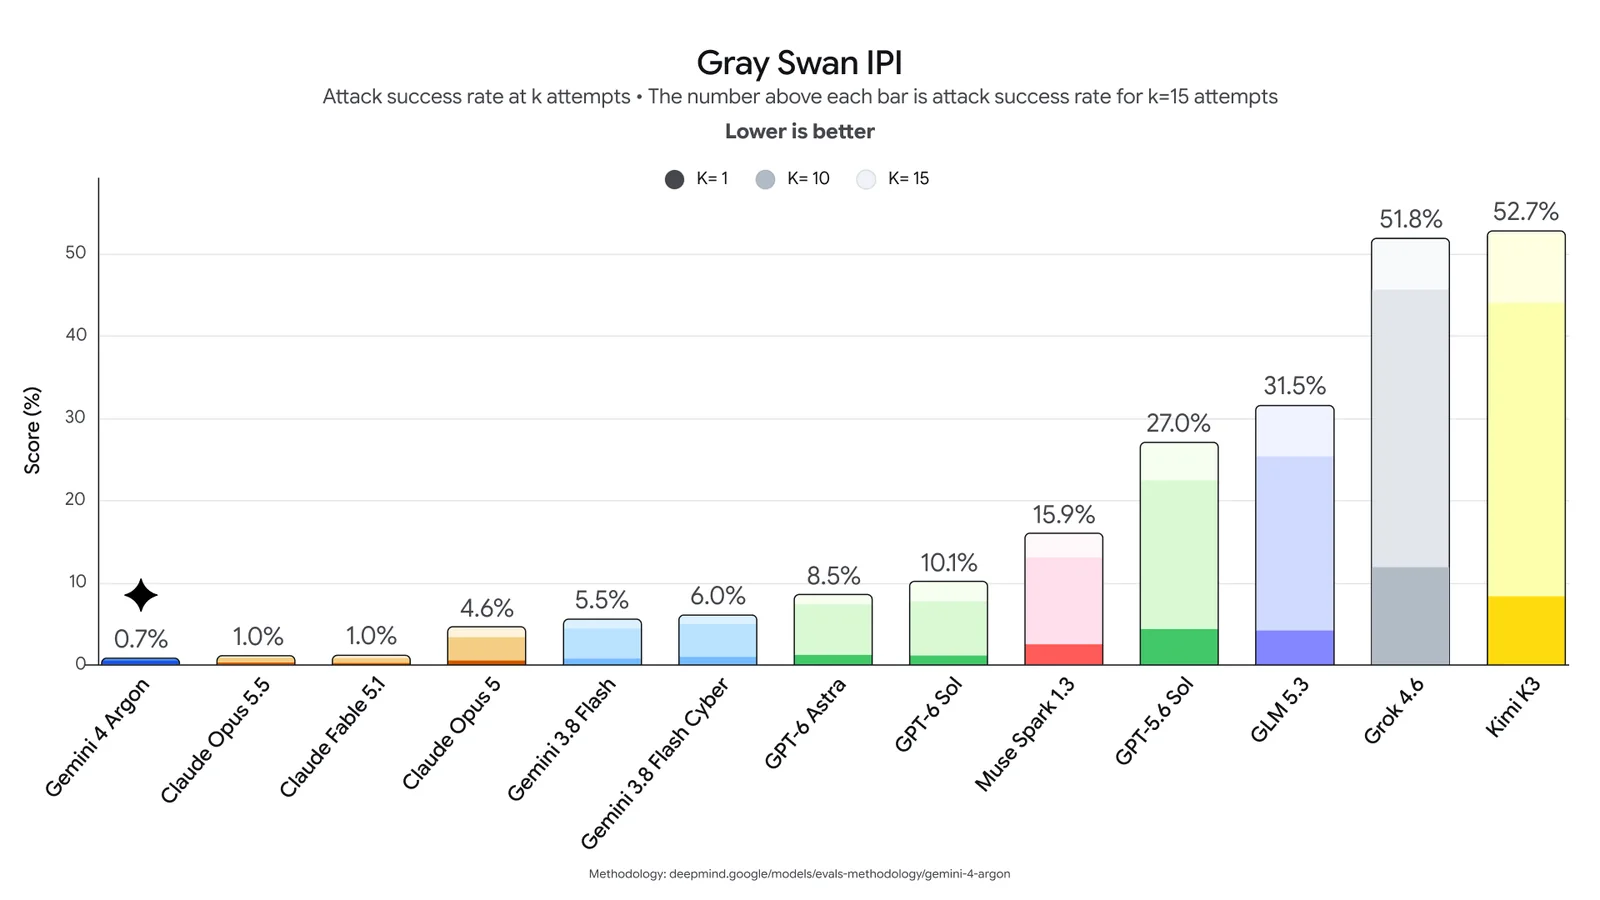
- Prompt Injection abwehren: Gemeint sind versteckte Anweisungen in Webseiten oder Dokumenten, die einen Agenten umlenken sollen. Im Test von Gray Swan gelingen solche Angriffe bei Argon in 0,7 % der Fälle, bei Opus 5.5 in 1,0 %, bei GPT-6 Astra in 8,5 %.
- Fehlverhalten erkennen: Google überwacht die Gedankenkette und die Aktionen des Modells und stoppt es, wenn nötig. Die Erkenntnisse daraus fließen bewusst nicht ins Training zurück, damit das Modell nicht lernt, die Überwachung zu umgehen.
- Systeme abschotten: Test- und Trainingsumgebungen werden vor riskanten Läufen isoliert und versiegelt.
Was fehlt: Eine Model Card und einen Bericht nach Googles eigenem Frontier Safety Framework gibt es für Argon noch nicht. Beim Vorgänger Gemini 3.7 Flash hatte Google im August gemeldet, dass das Modell bei Cyber-Fähigkeiten die Warnschwelle erreicht, aber nicht die kritische Stufe. Ob Argon diese Stufe erreicht, sagt Google nicht. Die Mahnung, die Google selbst in den Blog geschrieben hat, richtet sich an die ganze Branche: Labore sollten dafür sorgen, dass man das Denken ihrer Modelle weiter nachvollziehen kann.
Was das für Shops, SEO und Agenturen bedeutet
Für die Arbeit in den nächsten Wochen ändert Argon erst einmal nichts, weil du es nicht nutzen kannst. Interessant wird es, sobald es über die API oder Google AI Ultra kommt. Nach den bisherigen Zahlen sehe ich drei Einsatzfelder, für die sich ein Test dann lohnt, und eines, für das eher nicht.
Lohnt sich später zu testen
- Große Mengen in einem Rutsch: Produkttexte für einen ganzen Katalog, Übersetzungen ganzer Sortimente oder Datenexporte, die sonst in viele Anfragen zerlegt werden müssen. Hier hilft die Million Tokens Ausgabe.
- Daten, die stimmen müssen: Produktdaten aus Datenblättern ziehen, Händlerinfos prüfen, Fragen zu Dokumenten beantworten. Die niedrige Halluzinationsrate passt dazu, das Ergebnis muss trotzdem jemand prüfen.
- Abläufe automatisieren: Bestellungen, Retouren, Daten zwischen Shop, Warenwirtschaft und Tabellen. Bei AutomationBench liegt Argon unabhängig gemessen vorn.
Besser ein anderes Modell
- Landingpages, Shop-Themes und Oberflächen: In der WebDev Arena steht Argon auf Platz 8. Hier liegen Opus 5.5, Astra und GPT-6.1 Sol vorn.
- Programmieren im Terminal und in großen Codebasen: Hier sind Sonnet 5.5 und Opus 5.5 nach heutigem Stand stärker.
- Massenarbeit mit kleinem Budget: Pro Aufgabe ist GPT-6.1 Sol bisher deutlich günstiger.
Für SEO und die Sichtbarkeit in KI-Antworten gibt es eine offene Frage: Gemini steckt hinter den KI-Übersichten und dem KI-Modus der Google-Suche. Ob und wann Argon dort zum Einsatz kommt, hat Google nicht gesagt. Ein Modell, das seltener erfindet, würde in den Antworten der Suche weniger falsche Angaben über Shops und Produkte machen. Das ist Spekulation, solange Google nichts dazu sagt. Was du heute für die Sichtbarkeit in KI-Antworten tun kannst, steht in meiner Anleitung zu Generative Engine Optimization.
Häufige Fragen
Was ist Gemini 4 Argon?
Gemini 4 Argon ist das neue Spitzenmodell von Google DeepMind, vorgestellt am 30.09.2026. Es ist das erste Modell der Gemini-4-Reihe und für lange, komplexe Aufgaben in Programmierung, Wissensarbeit und Cyberabwehr gedacht. Es kann bis zu eine Million Tokens in einer Antwort ausgeben.
Kann ich Gemini 4 Argon schon nutzen?
Nein, außer du gehörst zu den ausgewählten Partnern im Fairwind-Programm für Cyberabwehr. Als Nächstes sollen zahlende API-Kunden und Abonnenten von Google AI Ultra Zugang bekommen. Ein Datum nennt Google nicht. Auch Ultra-Abonnenten meldeten am Abend der Ankündigung, dass sie Argon noch nicht sehen.
Was kostet Gemini 4 Argon?
Über die API zum Start 2 $ je Million Eingabe-Tokens und 10 $ je Million Ausgabe-Tokens, das sind rund 1,76 € und 8,81 €. Eingaben aus dem Cache kosten 95 % weniger. Nach dem Einführungszeitraum gelten 4 $ und 20 $. Wie lange der Startpreis gilt, sagt Google nicht.
Ist Gemini 4 Argon besser als Claude Opus 5.5?
Nicht insgesamt. Im unabhängigen Intelligence Index von Artificial Analysis liegt Opus 5.5 mit 58 Punkten vor Argon mit 53. Argon ist besser bei Geschäftsabläufen, Finanz- und Rechtsaufgaben, langen Eingaben und hat eine viel niedrigere Halluzinationsrate. Opus 5.5 ist besser beim Programmieren, bei Büroaufgaben und beim Bauen von Webseiten.
Ist Gemini 4 Argon besser als GPT-6.1 Sol?
In den meisten Tests knapp ja: einen Punkt mehr im Intelligence Index, deutlich vorn im Vals Index und bei Halluzinationen. GPT-6.1 Sol kostet aber pro Aufgabe nur gut ein Drittel (0,72 $ gegen 1,99 $) und ist heute verfügbar. Beim Bauen von Webseiten liegt GPT-6.1 Sol vorn.
Warum hält Google Argon zurück?
Google nennt die Cyber-Fähigkeiten des Modells: Was Verteidigern hilft, Lücken zu finden, könnte Angreifern genauso helfen. Deshalb bekommen zuerst Sicherheitsteams und die US-Regierung Zugang, während Google die Schutzmechanismen weiter verbessert. Kritiker auf Hacker News und Reddit sprechen dagegen von einem Start auf dem Papier.
Gibt es Gemini 4 Argon in Deutschland?
Dazu gibt es keine Angaben. Google nennt weder Länder noch Regionen. Ob europäische Partner im Fairwind-Programm Argon schon haben, ist ebenfalls offen.
Warum heißt das Modell Argon?
Argon war der interne Codename, den die Seite TestingCatalog schon Mitte September gemeldet hatte. Google hat ihn als offiziellen Namen übernommen. Argon ist ein Edelgas, der Name kommt vom griechischen Wort für „träge“. Warum Google statt Pro oder Flash diesmal einen Namen gewählt hat, erklärt es nicht.
Fazit
Mit Argon ist Google zurück in der Spitzengruppe. Unabhängig gemessen liegt es gleichauf mit GPT-6 Astra, knapp vor GPT-6.1 Sol und hinter Opus 5.5 und Sonnet 5.5. Es hat ein eigenes Profil: stark bei Wissensarbeit, Geschäftsabläufen, langen Eingaben und beim Vermeiden falscher Antworten, schwächer beim Programmieren und bei Gestaltung. Die Million Tokens Ausgabe ist das, was kein anderes Modell bietet.
Was ist also los? Die großen Labore bringen ihre Modelle inzwischen im Wochentakt, drücken die Preise eine Stufe unter der Spitze und halten die stärksten Fähigkeiten für Sicherheitsleute zurück. Google hat das bisher am konsequentesten umgesetzt: ein komplettes Spitzenmodell angekündigt, Zahlen gezeigt, aber für fast niemanden freigegeben. Für Shops, SEO und Agenturen heißt das: Arbeite heute mit Opus 5.5, Sonnet 5.5 oder GPT-6.1 Sol und halte deine Abläufe so, dass du Argon später mit wenig Aufwand testen kannst. Sobald es über die API oder Google AI Ultra verfügbar ist, teste ich es selbst und ergänze diesen Beitrag.
Quellen
- Google: Gemini 4 Argon: our next era of frontier intelligence (30.09.2026), Modellseite Gemini, Methodik zur Bewertung (PDF), Fairwind Program, Start des Fairwind-Programms (02.09.2026), Preisseite der Gemini-API, Google-AI-Abos (alle abgerufen am 01.10.2026)
- Unabhängige Messungen: Artificial Analysis, Artikel und Modellseite, Vals Index, Arena Text und WebDev (abgerufen am 01.10.2026 zwischen 8 und 9 Uhr)
- Ergänzte Herstellerwerte: OpenAI, Ankündigung von GPT-6.1 Sol (29.09.2026), Anthropic, Ankündigung von Claude Sonnet 5.5 (28.09.2026)
- Presse: Bloomberg (Julia Love, Davey Alba), The Verge (Jay Peters), TechCrunch, CNBC, Axios, Ars Technica, The New Stack, VentureBeat, The New York Times, AFP, XDA, heise online, The Decoder, Caschys Blog, all-ai.de, Dr. Web (alle 30.09. oder 01.10.2026)
- Blogs: Zvi Mowshowitz, „Astra 6.1 Pulled As Insufficiently Aligned“ (29.09.2026), Simon Willison, „Claude Opus 5.5, GPT-6 Sol, GPT-6 Luna, and a new price war“ (22.09.2026)
- Hacker News: Gemini 4 Argon (1.242 Punkte) und Artificial Analysis zu Argon
- Reddit: Introducing Gemini 4 Argon (r/singularity), Gemini 4 from straight from the horse's mouth (r/singularity), Gemini 4 Argon solved hallucinations (r/singularity), Gemini 4 Anecdotes (r/GeminiAI), Gemini 4 is out (r/ClaudeAI)
- X: Sundar Pichai, Logan Kilpatrick, Philipp Schmid, Artificial Analysis, Vals AI, Arena, Antwort zu Tokenpreisen
- YouTube: Arena, Gemini 4 Argon | First Impressions
Geschrieben von
Mario WormuthSEO, GEO und KI-Automatisierung für Online-Shops. Ich teste, worüber ich schreibe, zuerst auf eigenen Seiten und in Kundenprojekten wie RYMHART und Opal-Schmiede.
Das für deinen Shop umsetzen?
Drei Fragen, sofort eine Einschätzung, danach drei konkrete Punkte von mir persönlich. Kostenlos.
Weitere Artikel
aus dem Magazin.
Alle Artikel
GPT-6.1 Sol und DevDay 2026: Benchmarks, Preise, Limits und Vergleich mit Opus 5.5
Am 29. September 2026 hat OpenAI auf dem DevDay in San Francisco GPT-6.1 Sol vorgestellt, genau sieben Tage nach GPT-6 Sol. Das Versprechen steht in der Überschrift der Ankündigung: Intelligenz fast auf …
Claude Sonnet 5.5: Benchmarks, Preise, Effort und wann es Opus 5.5 ersetzt
Am 28. September 2026 hat Anthropic Claude Sonnet 5.5 veröffentlicht, das zweite Modell der 5.5-Familie nach Opus 5.5 vom 22. September. Die Kurzfassung steht schon in der Überschrift von The New Stack: Leistung …
ChatGPT Maps im Test: Woher die Daten wirklich kommen
Wer ChatGPT nach einer guten Pizzeria in Hannover fragt, bekommt seit diesem Sommer mehr als eine Liste. Im Bereich „Karten“ unter chatgpt.com/maps erscheinen die Empfehlungen als Punkte auf einer Karte, jeder mit …