Start / Magazin / Weitere Themen
Claude Sonnet 5.5: Benchmarks, Preise, Effort und wann es Opus 5.5 ersetzt
ArtikelWeitere Themen28.09.2026/img/magazin/claude-sonnet-5-5.webp Mario WormuthSEO, GEO & KI-Automatisierung
24 Min. Lesezeit
Alles auf einen Blick
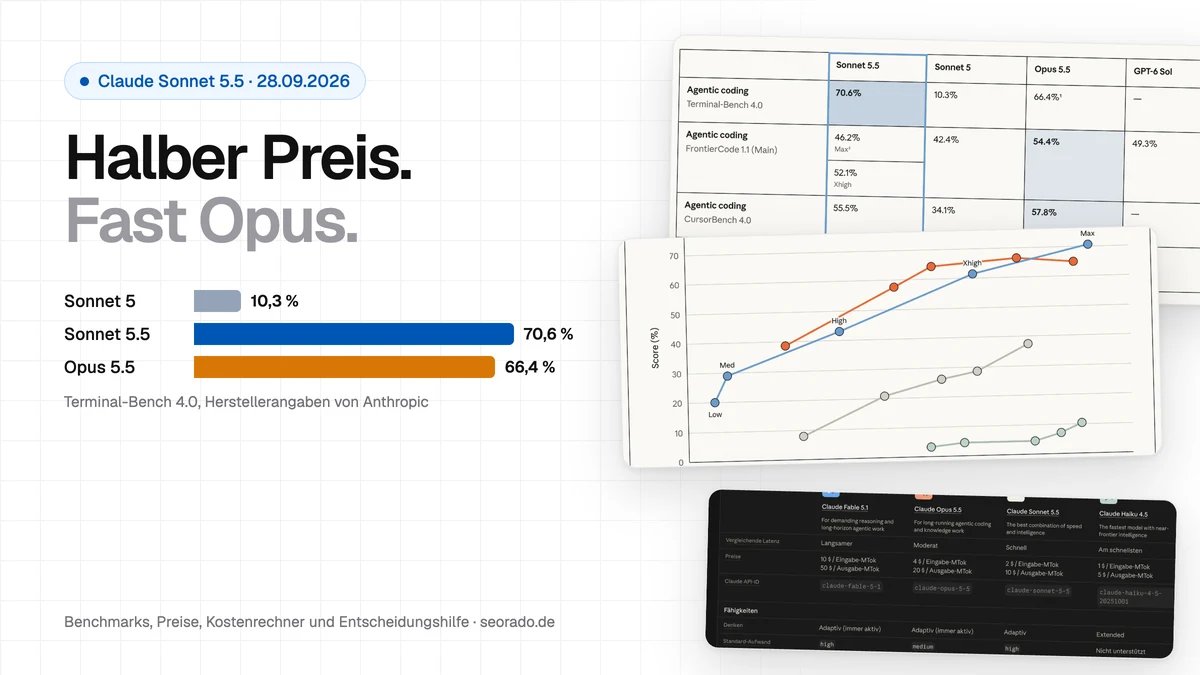
- Sonnet 5.5 erreicht 70,6 % im Agenten-Coding-Test Terminal-Bench 4.0. Sonnet 5 kam auf 10,3 %, Opus 5.5 auf 66,4 %. Bei Wissensarbeit (GDPval-AA) liegt es mit 1.844 Punkten nur zwei Punkte hinter Opus 5.5.
- Der Preis pro Token bleibt bei 2 $ Eingabe und 10 $ Ausgabe je Million, also die Hälfte von Opus 5.5 (4 $ und 20 $). Dazu braucht das Modell laut Anthropic für dieselbe Arbeit weniger Tokens: bis zu 30 % geringere Kosten je Aufgabe und mehr als 30 % schnellere Ausgabe.
- Den größten Preisvorteil gibt es bei niedrigem Effort. Bei Medium, dem Standard in den Claude-Apps und in Claude Code, schlägt Sonnet 5.5 den besten Wert von Sonnet 5 bei weniger als einem Zehntel der Kosten pro Aufgabe. Bei Max kostet es ähnlich viel wie Opus.
- Anthropic schreibt selbst, dass Opus 5.5 bei komplexer, offener Arbeit mit anhaltendem Urteilsvermögen deutlich stärker bleibt. Sonnet 5.5 ist laut Anthropic am besten bei klar umrissenen Alltagsaufgaben, Bugfixes und sauberen Dokumenten, Folien und Tabellen.
- Entwickler müssen beim Umstieg auf ein paar Dinge achten:
thinking: disabledgibt einen Fehler, erzwungene Tool-Auswahl ist nicht mehr möglich, und die Effort-Stufen sind neu kalibriert. - Die Community-Stimmen der ersten Stunde sind positiv und neugierig, aber ohne eigene Messungen. Ein Redditor bringt es auf den Punkt: Terminal-Bench ist nicht dasselbe wie Coding.
Inhaltsverzeichnis15 Abschnitte
- Was Anthropic am 28. September vorgestellt hat
- Die Benchmarks: fast auf Augenhöhe mit Opus 5.5
- Kosten: gleicher Preis pro Token, weniger Tokens pro Aufgabe
- Effort: der wichtigste Regler
- Sonnet oder Opus? Die Entscheidungshilfe
- Was Launch-Partner berichten
- Erste Reaktionen: Reddit und Hacker News
- Was die Fachpresse schreibt
- Video-Test: sieben Videos, komplett aus Code
- Was das für Shops, SEO und Content bedeutet
- Sicherheit und Sperren
- Umstieg per API: Was sich ändert
- Häufige Fragen
- Fazit
- Quellen
Am 28. September 2026 hat Anthropic Claude Sonnet 5.5 veröffentlicht, das zweite Modell der 5.5-Familie nach Opus 5.5 vom 22. September. Die Kurzfassung steht schon in der Überschrift von The New Stack: Leistung nahe an Opus zum halben Preis. Ob das stimmt, hängt davon ab, was du mit dem Modell machst, und genau das schaue ich mir hier an.
Ich habe die Ankündigung, die Preis- und Modell-Dokumentation, die Migrationsanleitung, die Fachpresse, Reddit, Hacker News und ein ausführliches Video-Tutorial durchgesehen und die wichtigen Stellen als Screenshots festgehalten. Du bekommst einen Benchmark-Vergleich zum Durchklicken, einen Kostenrechner mit Beispielen für Shop-Aufgaben, eine Entscheidungshilfe für Sonnet oder Opus und eine Liste der Änderungen für alle, die per API umsteigen. Der Beitrag ist am Erscheinungstag entstanden. Erste Reaktionen aus der Community sind deshalb dabei, aber noch dünn, und ich sage jeweils dazu, was belegt ist und was nicht.
Was Anthropic am 28. September vorgestellt hat
Anthropic beschreibt Sonnet 5.5 als „faster, lower-cost complement“ zu Opus 5.5. Wo Opus für komplexe Arbeit mit sorgfältigem Abwägen gebaut ist, soll Sonnet bei klar umrissenen Alltagsaufgaben glänzen, beim Beheben von Bugs und beim Erstellen sauberer Dokumente, Folien und Tabellen. Dazu kommt ein „sharp eye for design“. Als Beleg für die Bildverarbeitung nennt Anthropic, dass es das erste Sonnet-Modell ist, das Pokémon Rot allein anhand von Screenshots durchgespielt hat.
In einem internen Test gab Anthropic dem Modell die Quartalszahlen und Telefonkonferenz-Protokolle eines börsennotierten Unternehmens plus eine Folienvorlage und ließ einen zehnseitigen Betriebsbericht erstellen. Zwei Experten hielten den ersten Entwurf für versandfertig. Das ist eine Herstellerangabe aus einem einzelnen Test, aber sie zeigt, wohin die Reise geht: Sonnet 5.5 soll Arbeit erledigen, die am Ende in einer Präsentation oder Tabelle landet.
| Steckbrief | Claude Sonnet 5.5 |
|---|---|
| Veröffentlicht | 28.09.2026, zweites Modell der 5.5-Familie nach Opus 5.5 (22.09.2026) |
| Modellname in der API | claude-sonnet-5-5 (ohne Datum) |
| Preis pro Million Tokens | 2 $ Eingabe, 10 $ Ausgabe, 0,20 $ Cache-Lesen |
| Kontextfenster / maximale Ausgabe | 1 Mio. Tokens / 128.000 Tokens |
| Verlässlicher Wissensstand | Juni 2026 |
| Denken | adaptiv, Standard-Effort über die API: high; in Claude-Apps und Claude Code: Medium |
| Verfügbar auf | Claude-Apps, Claude Platform, Amazon Web Services, Google Cloud, Microsoft Azure, mit Zero Data Retention |
| Mindestens verfügbar bis | 28.09.2027 (Zusage von Anthropic für die eigenen Plattformen) |
| Als Nächstes | Haiku 5.5 „in den kommenden Wochen“ |
Die Benchmarks: fast auf Augenhöhe mit Opus 5.5
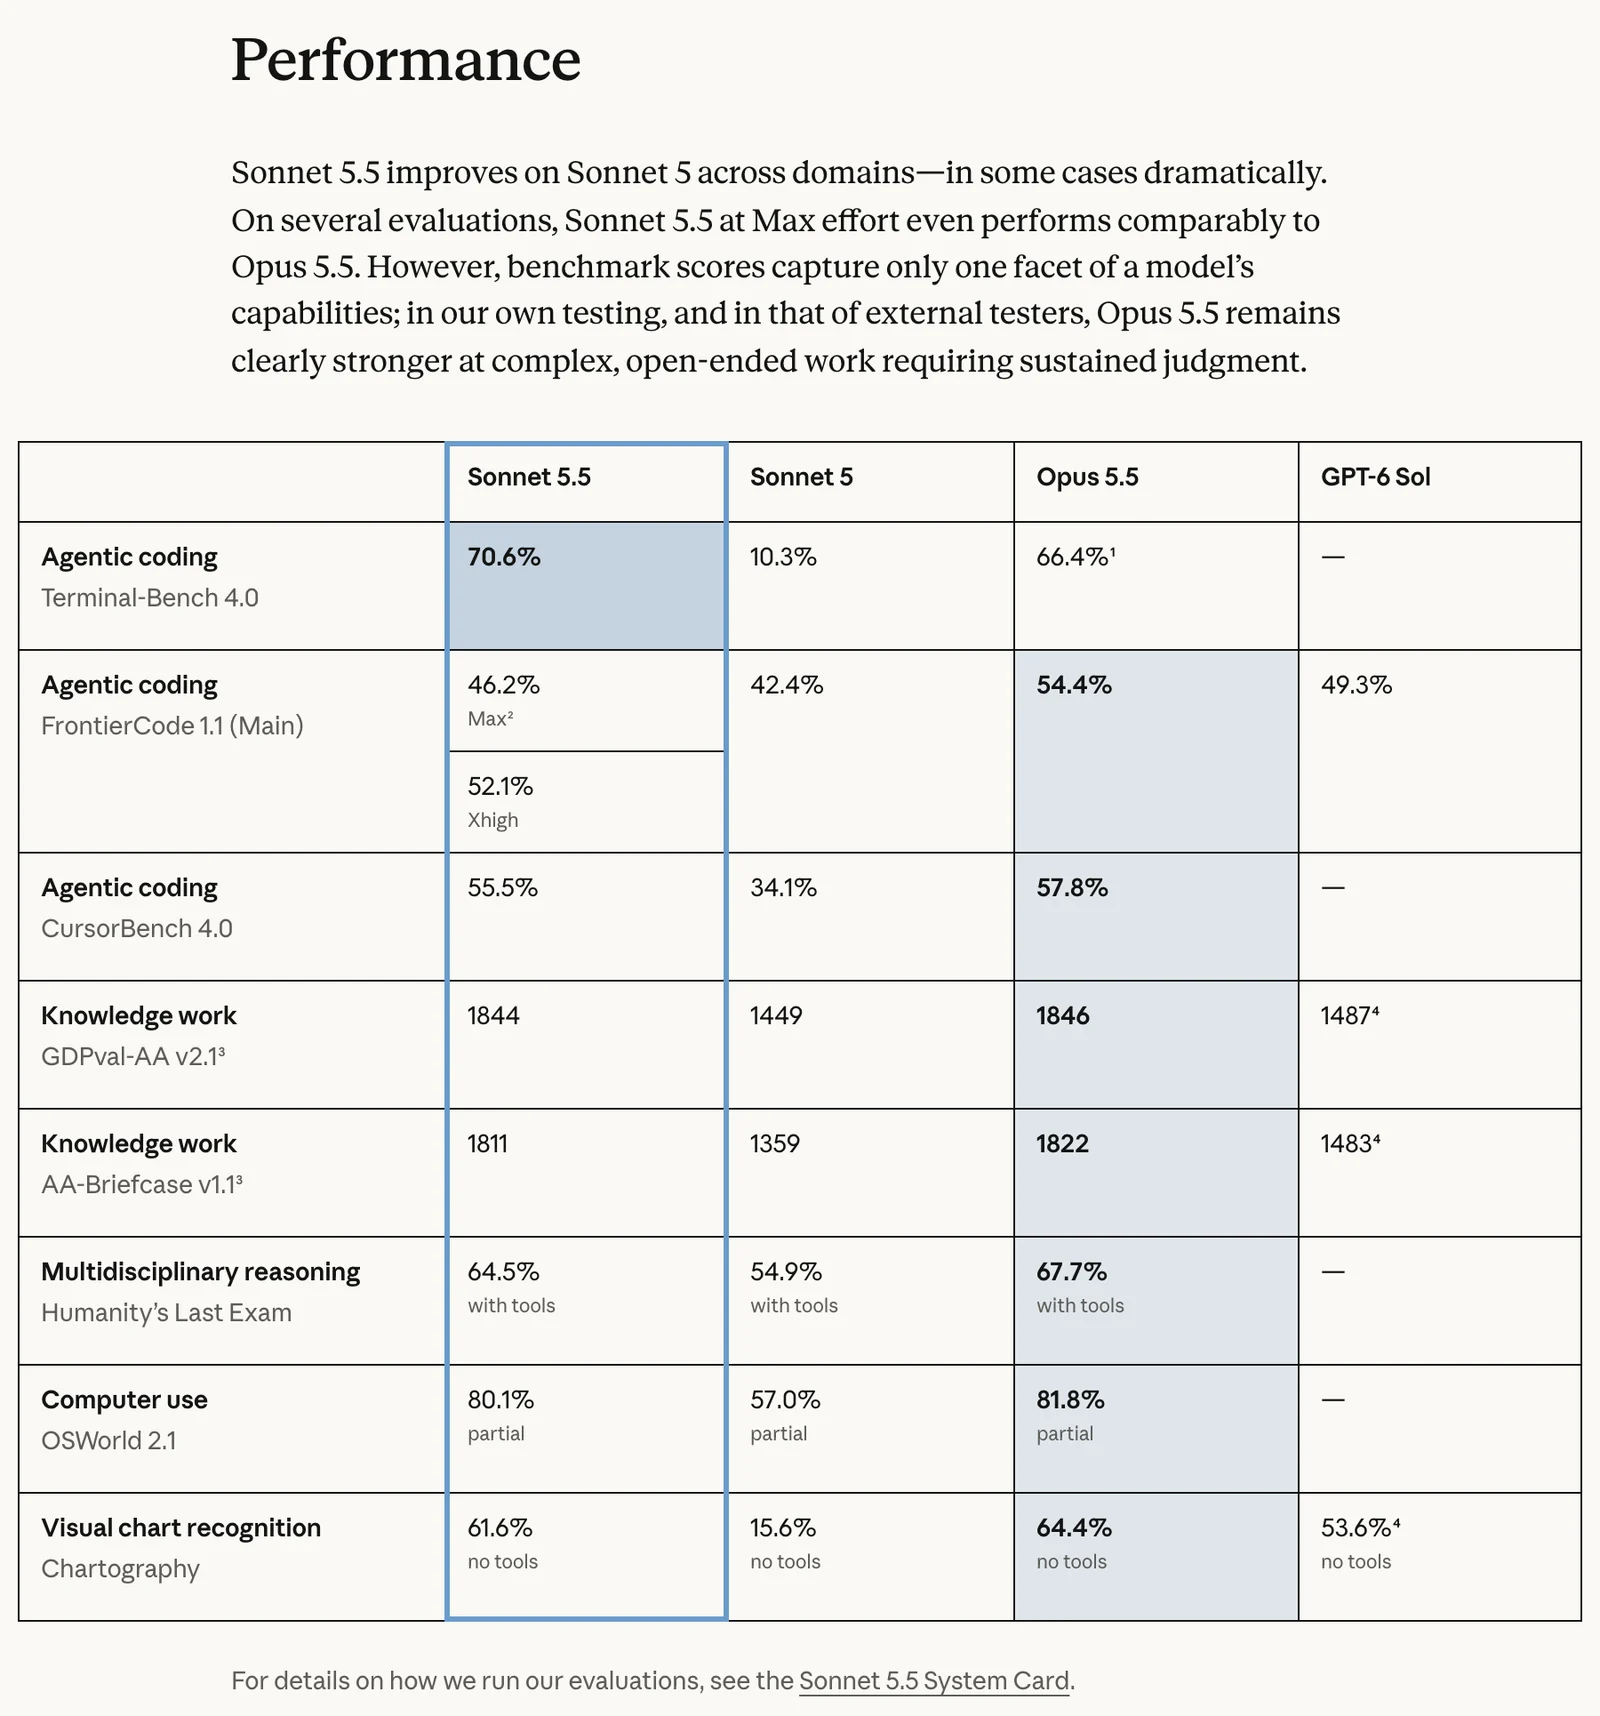
Anthropic vergleicht Sonnet 5.5 in einer Tabelle mit dem Vorgänger Sonnet 5, mit Opus 5.5 und mit GPT-6 Sol von OpenAI. Damit du nicht Zahlenreihen abgleichen musst, habe ich die Werte in einen Vergleich zum Durchklicken übertragen. Wähle oben einen Test, unten stehen alle Werte als Tabelle.
Alle Werte als Tabelle
| Test | Sonnet 5.5 | Sonnet 5 | Opus 5.5 | GPT-6 Sol |
|---|---|---|---|---|
| Terminal-Bench 4.0 (Agenten-Coding) | 70,6 % | 10,3 % | 66,4 % | k. A. |
| FrontierCode 1.1 (Agenten-Coding) | 52,1 % | 42,4 % | 54,4 % | 49,3 % |
| CursorBench 4.0 (Agenten-Coding) | 55,5 % | 34,1 % | 57,8 % | k. A. |
| GDPval-AA v2.1 (Wissensarbeit) | 1.844 | 1.449 | 1.846 | 1.487 |
| AA-Briefcase v1.1 (Wissensarbeit) | 1.811 | 1.359 | 1.822 | 1.483 |
| Humanity's Last Exam (mit Tools) | 64,5 % | 54,9 % | 67,7 % | k. A. |
| OSWorld 2.1 (Computerbedienung) | 80,1 % | 57,0 % | 81,8 % | k. A. |
| Chartography (Diagramme lesen) | 61,6 % | 15,6 % | 64,4 % | 53,6 % |
Herstellerangaben und Benchmarks messen immer nur einen Ausschnitt. Anthropic schreibt selbst, dass Opus 5.5 bei komplexer, offener Arbeit mit anhaltendem Urteilsvermögen deutlich stärker bleibt.
Drei Ergebnisse stechen heraus:
- Agenten-Coding: Bei Terminal-Bench 4.0 springt Sonnet 5.5 von 10,3 % auf 70,6 % und liegt damit vor Opus 5.5 (66,4 %). Bei CursorBench, das Aufgaben aus echten Coding-Sitzungen nutzt, sind es 55,5 % gegen 57,8 % bei Opus. Bei FrontierCode liegt Opus mit 54,4 % vorn. Sonnet 5.5 erreicht 52,1 % auf Xhigh und schlägt damit GPT-6 Sol (49,3 %), auf Max sind es 46,2 %, dann liegt Sol vorn.
- Wissensarbeit: GDPval-AA prüft reale Aufgaben aus 44 Berufen. Sonnet 5.5 kommt auf 1.844 Punkte, Opus 5.5 auf 1.846, Sonnet 5 nur auf 1.449 und GPT-6 Sol auf 1.487. Anthropic schreibt, das Modell lasse Sonnet 5 und GPT-6 Sol bei Wissensarbeit über lange Abläufe klar hinter sich.
- Diagramme lesen: Der größte Sprung. Chartography steigt von 15,6 % auf 61,6 %, Opus 5.5 liegt bei 64,4 %. Das ist für alle interessant, die Screenshots aus der Search Console oder aus Analytics auswerten lassen.
So liest du die Zahlen richtig
- Anthropic misst selbst. Es sind Herstellerangaben aus der Ankündigung. Die Wissensarbeit-Tests kommen von Artificial Analysis, Chartography von Surge AI. The Decoder weist darauf hin, dass unabhängige Tests die Angaben zu Tempo und Kosten erst noch bestätigen müssen.
- Max ist nicht immer das Beste. Bei FrontierCode erreicht Sonnet 5.5 auf Max nur 46,2 % und auf Xhigh 52,1 %. Anthropic erklärt das mit Claude Codes Code-Review-Funktion: Bei Max startete das Modell sie öfter, sie verteilt die Prüfung auf viele Unteragenten, und in zwei von Cognition untersuchten Fällen führte das zu einem Timeout oder zu Änderungen außerhalb des Auftrags.
- Zwei bekannte Messfehler. Die Wissensarbeit-Tests liefen auf einer Vorabversion mit einem Fehler bei strukturierten Ausgaben, der inzwischen behoben ist. Anthropic erwartet, dass er Sonnet 5.5 eher unterschätzt. Bei GPT-6 Sol hatte OpenAI einen Fehler im Bildverständnis behoben, die Vergleichswerte sind womöglich nicht aktualisiert.
- Der Opus-Wert bei Terminal-Bench gilt für den besten Effort (Xhigh). Für GPT-6 Sol gibt es dort keinen veröffentlichten Wert, im Diagramm zeigt Anthropic stattdessen GPT-5.6 Sol.
- Ein Test ist nicht das ganze Modell. Anthropic schreibt, Benchmarks erfassten nur eine Facette. In eigenen Tests und bei externen Testern bleibe Opus 5.5 bei komplexer, offener Arbeit deutlich stärker.
Kosten: gleicher Preis pro Token, weniger Tokens pro Aufgabe
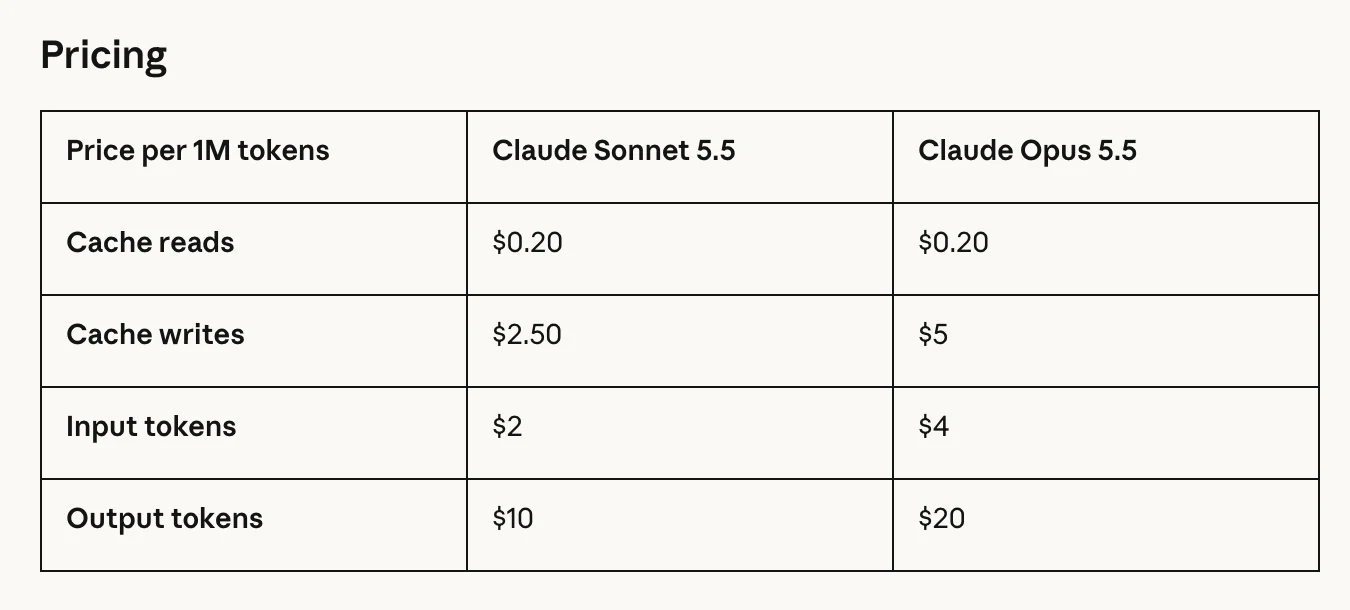
Sonnet 5.5 kostet pro Token genauso viel wie Sonnet 5, nämlich 2 $ für eine Million Eingabe-Tokens und 10 $ für eine Million Ausgabe-Tokens. Gut zu wissen: Die für den 1. September angekündigte Erhöhung von Sonnet 5 auf 3 $ und 15 $ findet laut Preisseite nicht statt, der Einführungspreis ist der Normalpreis. Gespart wird bei Sonnet 5.5 über den Verbrauch. Es braucht für dieselbe Arbeit weniger Tokens, deshalb nennt Anthropic bis zu 30 % geringere Kosten je Aufgabe.
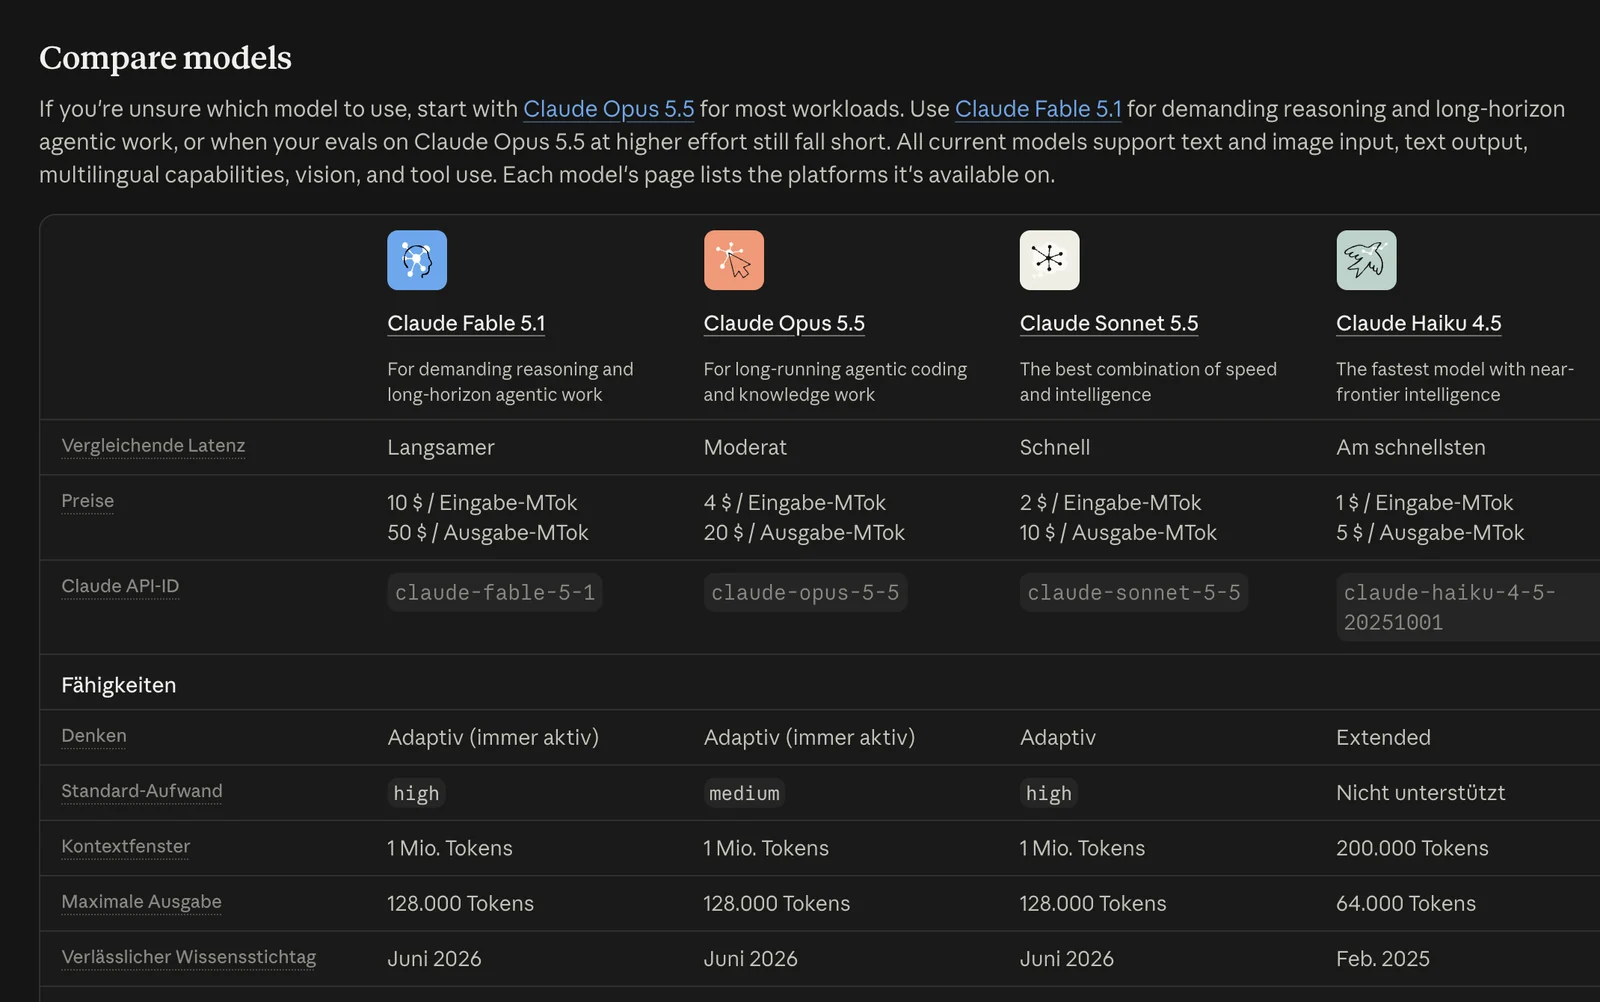
| Preis pro 1 Mio. Tokens | Sonnet 5.5 | Opus 5.5 | Fable 5.1 | Haiku 4.5 |
|---|---|---|---|---|
| Eingabe | 2 $ | 4 $ | 10 $ | 1 $ |
| Ausgabe | 10 $ | 20 $ | 50 $ | 5 $ |
| Cache lesen | 0,20 $ | 0,20 $ | 0,25 $ | 0,10 $ |
| Cache schreiben (5 Minuten) | 2,50 $ | 5 $ | 12,50 $ | 1,25 $ |
| Batch-API Eingabe / Ausgabe | 1 $ / 5 $ | 2 $ / 10 $ | 5 $ / 25 $ | 0,50 $ / 2,50 $ |
| Kontextfenster | 1 Mio. | 1 Mio. | 1 Mio. | 200.000 |
| Standard-Effort über die API | high | medium | high | nicht unterstützt |
Zwei Dinge spielen dir in die Hände. Erstens: Cache-Lesen kostet bei Sonnet 5.5 und Opus 5.5 mit 0,20 $ dasselbe. Bei langen Abläufen mit viel wiederholtem Kontext schrumpft der Preisunterschied zwischen den Modellen bei der Eingabe also, wie auch ein Redditor bemerkt hat. Zweitens: Der Batch-Rabatt von 50 % und der Cache-Rabatt lassen sich kombinieren. Für Arbeiten, die nicht sofort fertig sein müssen, etwa Beschreibungen für den ganzen Shop, ist das der größte Hebel.
Der Rechner nimmt dir die Arithmetik ab. Er startet mit 500 Produkttexten im Monat, du kannst die Beispiele wechseln oder eigene Werte eintragen.
Rechenweg: Antwort-Tokens = Wörter × 1,8 (laut Anthropic-Doku entsprechen 1 Mio. Tokens etwa 555.000 Wörtern) × Denkfaktor, weil Denk-Tokens als Ausgabe abgerechnet werden. Der Denkfaktor ist meine Annahme, nicht Herstellerangabe. Cache-Anteile werden zum Cache-Lesepreis gerechnet, die einmalige Schreib-Gebühr fehlt. Alle Modelle bekommen hier dieselbe Tokenmenge, real unterscheidet sie sich je nach Modell und Effort. Preise in US-Dollar, netto.
Tipp
Bei Aufgaben mit sehr vielen gleichen Durchläufen ist Haiku 4.5 im Rechner das günstigste Modell. Es hat aber ein kleineres Kontextfenster (200.000 Tokens) und stammt aus der älteren Generation. Haiku 5.5 hat Anthropic für die kommenden Wochen angekündigt. Bis dahin ist Sonnet 5.5 mit Batch und Cache die Stufe, die Qualität und Preis am ehesten verbindet.
Ein Hinweis zu den Tokens
Seit Opus 4.7 nutzen die Claude-Modelle einen neueren Tokenizer, der laut Preisseite für denselben Text etwa 30 % mehr Tokens erzeugt. Im Deutschen kommen wir dadurch auf grob 1,8 Tokens pro Wort. Diesen Wert nutzt der Rechner. Er stammt aus der Umrechnung in der Modelldokumentation, nach der eine Million Tokens etwa 555.000 Wörtern entspricht.
Effort: der wichtigste Regler
Bei Sonnet 5.5 entscheidet der Effort stärker über Kosten und Ergebnis als die Wahl zwischen Sonnet und Opus. Es gibt fünf Stufen: Low, Medium, High, Xhigh und Max. Anthropic zeigt für vier Tests, wie sich Ergebnis und Kosten pro Aufgabe mit jeder Stufe verändern. Hier das Diagramm zu Terminal-Bench 4.0:
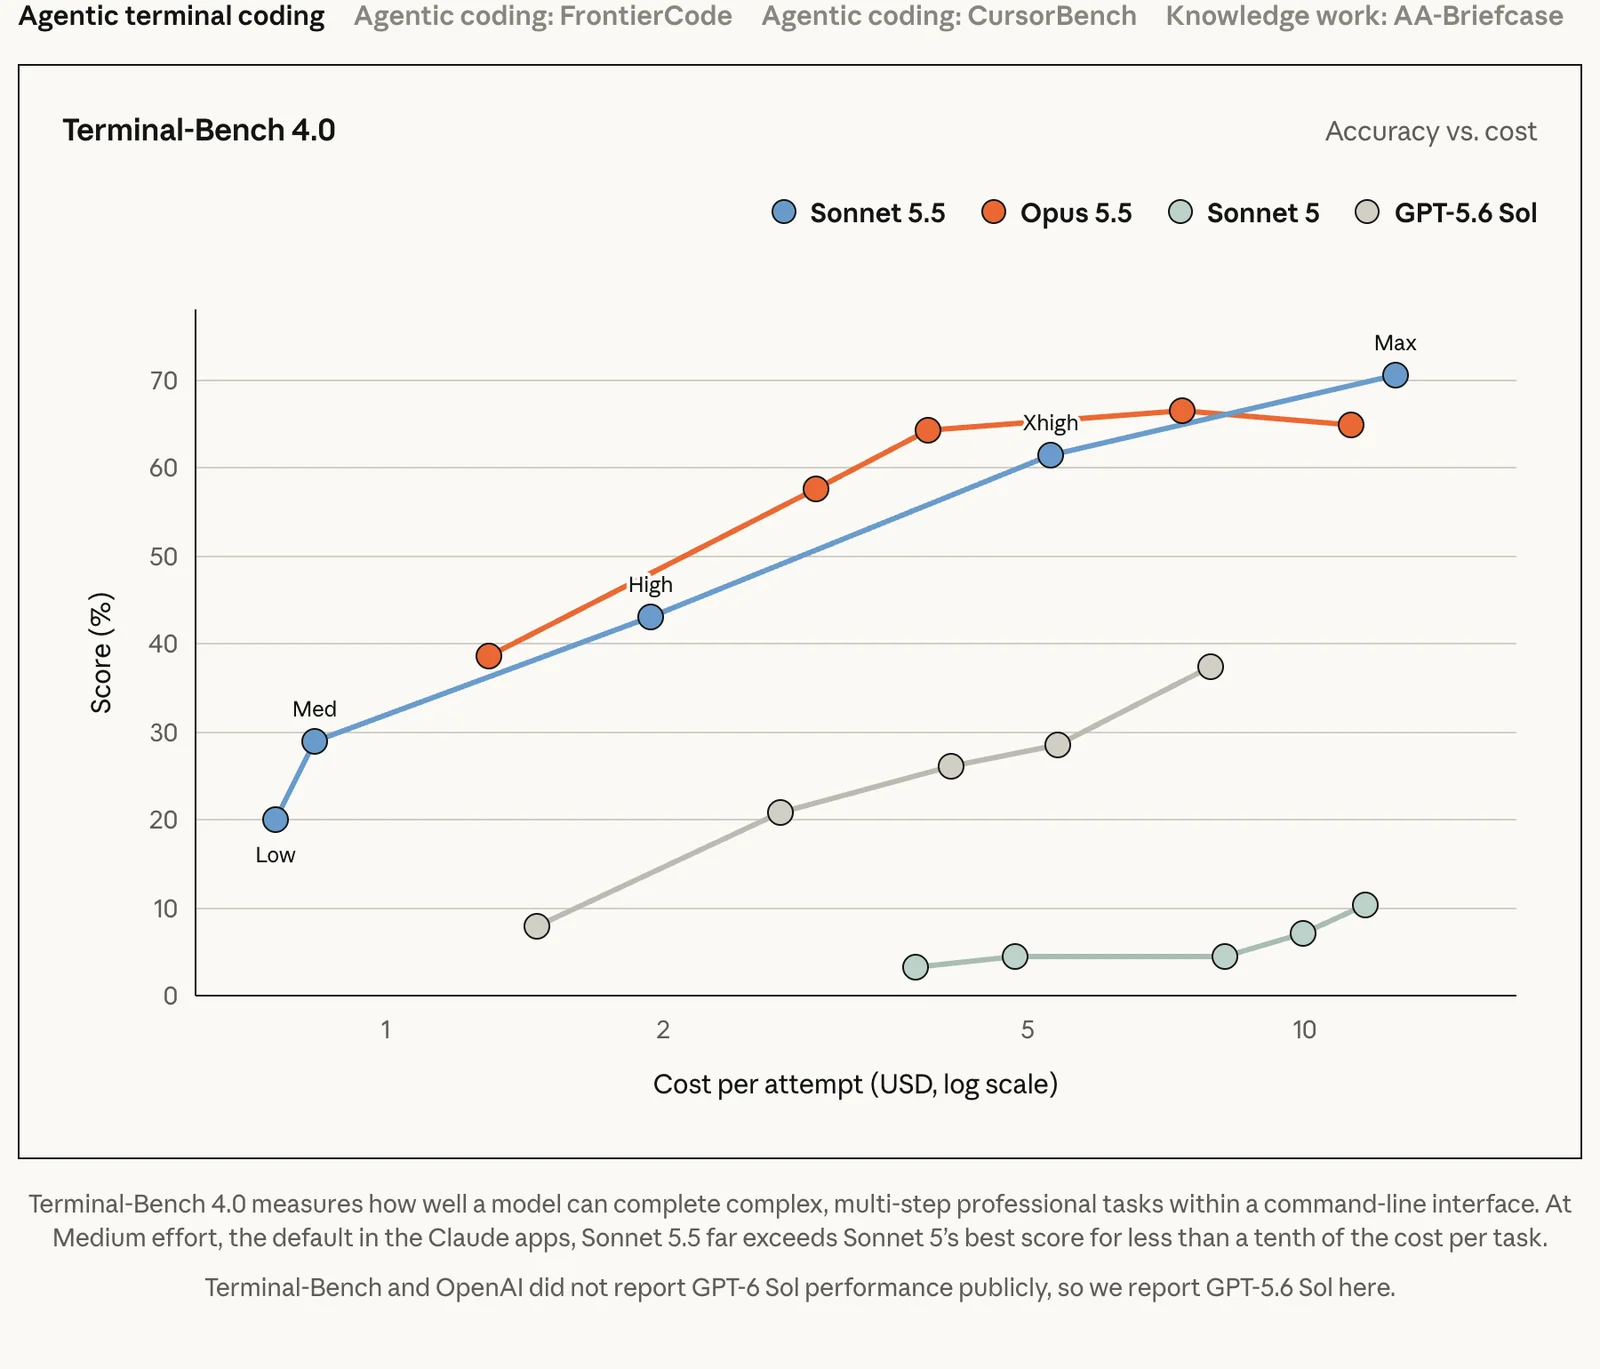
Aus dem Diagramm lässt sich Folgendes ablesen. Die Werte sind von mir aus der Grafik geschätzt und deshalb ungefähre Größenordnungen:
| Effort | Sonnet 5.5, Score | Sonnet 5.5, Kosten je Versuch |
|---|---|---|
| Low | etwa 20 % | knapp unter 1 $ |
| Medium | etwa 29 % | rund 1 $ |
| High | etwa 43 % | rund 2 $ |
| Xhigh | etwa 61 % | rund 5 $ |
| Max | 70,6 % | über 10 $ |
Anthropic fasst es so zusammen: Bei Medium, dem Standard in den Claude-Apps, übertrifft Sonnet 5.5 den besten Wert von Sonnet 5 bei weniger als einem Zehntel der Kosten pro Aufgabe. Bei FrontierCode erreicht Sonnet 5.5 auf High zehn Punkte mehr als Sonnet 5 auf derselben Stufe, zu etwa einem Fünfzehntel der Kosten. Und weiter: Am besten ergänze Sonnet 5.5 den Opus 5.5 bei niedrigem Effort, wo es weniger pro Aufgabe kostet. Auf den höchsten Stufen könne es vergleichbar gut sein, dann aber zu ähnlichen Kosten.
Tipp
Der Preisvorteil von Sonnet 5.5 steckt im niedrigen und mittleren Effort. Wer auf Max stellt, zahlt ähnlich viel wie bei Opus 5.5. Wenn du aktuell bei Opus mit hohem Effort arbeitest, teste dieselbe Aufgabe einmal mit Sonnet 5.5 auf Medium und einmal auf High. Beim Modellwechsel gilt außerdem: Setze den Effort zurück auf den Standard, denn die Stufen sind zwischen Modellen nicht gleichwertig. Das rät die Claude Academy.
Auffällig ist im Diagramm auch die orange Linie von Opus 5.5. Auf der höchsten Stufe fällt sie wieder ab. Das deckt sich mit einer Beobachtung aus r/ClaudeAI vom selben Tag, wo jemand daran erinnert, dass Opus 5.5 auf Xhigh schlechter abschneiden kann als auf Max und man bei High oder Medium bleiben solle. Die Faustregel gilt also auch dort: Mehr Effort ist nicht automatisch besser.
Sonnet oder Opus? Die Entscheidungshilfe
Die Frage, die nach so einem Release alle stellen: Kann ich mit Sonnet 5.5 Opus ersetzen? Anthropic sagt: nicht überall. Die vier Fragen unten bündeln die Einordnung aus der Ankündigung in eine Empfehlung.
Dafür spricht Sonnet 5.5
- Halber Preis pro Token und bis zu 30 % weniger Tokens pro Aufgabe als Sonnet 5.
- Über 30 % schnellere Ausgabe als Sonnet 5, laut Anthropic das schnellste Sonnet bisher.
- Bei Wissensarbeit, Computerbedienung und Diagrammen nahe an Opus 5.5.
- Bündelt Tool-Aufrufe stärker, dadurch weniger Schritte, so Testpartner wie Lovable und Base44.
- Schreibt laut Anthropic klarer als die Vorgängergeneration.
Dafür spricht Opus 5.5
- Bei komplexer, offener Arbeit mit anhaltendem Urteilsvermögen laut Anthropic deutlich stärker.
- Bei FrontierCode (54,4 % gegen 52,1 %), Humanity's Last Exam (67,7 % gegen 64,5 %) und CursorBench (57,8 % gegen 55,5 %) vorn.
- Bei den Sicherheitsprüfungen insgesamt „slightly better“.
- Für Fälle, in denen ein Fehler teuer wird und niemand nachprüft.
Wie die beiden zusammenspielen, beschreiben Testpartner konkret. Kevin Ngo von Creator sagt, wenn Opus 5.5 Architektur und Rahmen eines Spiels festlege, würde er Sonnet 5.5 die Umsetzung anvertrauen. In Claude Code lässt sich das direkt abbilden: Ein Redditor erinnert an den Alias opusplan, bei dem Opus die Aufgaben plant und Sonnet sie ausführt. Ein anderer schreibt, genau so laufe sein Ablauf bereits.
Was Launch-Partner berichten
Anthropic hat in die Ankündigung Rückmeldungen von Unternehmen eingebaut, die Sonnet 5.5 vorab getestet haben. Das sind ausgewählte Stimmen, keine unabhängige Studie. Interessant sind die Zahlen, weil sie zeigen, wo der Effizienzgewinn liegen soll:
| Unternehmen | Angabe (laut Anthropic-Ankündigung) |
|---|---|
| Base44 | 118 echte App-Builds: gleiche Qualität wie Opus 5, im Schnitt 3,6 statt 7,7 Iterationen, die wenigsten fehlgeschlagenen Tool-Aufrufe aller verglichenen Modelle |
| Balyasny Asset Management | 2.441 Finanzaufgaben: besser als Sonnet 5 mit etwa 121.000 statt 497.000 Tokens pro Antwort, bestes Qualität-Kosten-Verhältnis von sieben Modellen |
| Box | genauer, 2,4-mal schneller und 12 % weniger Tokens insgesamt als das Vorgängermodell |
| Slack | bei fast allen Offline-Tests besser als Sonnet 5, in weniger Schritten und mit rund 14 % weniger Ausgabe-Tokens, ohne dass Prompts geändert wurden |
| Zendesk | bei Support-Fällen weniger Fehlentscheidungen, Tickets 20 % schneller bearbeitet |
| Lovable | ein Drittel weniger Tool-Aufrufe und etwa halb so viele Shell-Läufe pro Aufgabe |
| Atlassian | Rovo-Agenten laufen bis zu 30 % schneller als mit Sonnet 5 |
| Unity | 90 % der Aufgaben in einem mehrstufigen Editor-und-Coding-Test erledigt, die Mehrheit bestand die Laufzeitprüfung |
| CodeRabbit | besseres Urteilsvermögen bei deutlich weniger Ausgabe-Tokens, die Neigung von Sonnet 5 zu übermäßiger Websuche ist weg; einfache und mittlere Reviews sollen umziehen |
Auffällig ist, dass fast alle Angaben Effizienz betreffen: weniger Tokens, weniger Schritte, weniger Tool-Aufrufe. Das passt zu Anthropics Kernaussage. Sonnet 5.5 ist weniger ein Sprung in die Höhe als ein Sprung in der Wirtschaftlichkeit.
Erste Reaktionen: Reddit und Hacker News
Zum Zeitpunkt der Recherche war Sonnet 5.5 kaum eine Stunde draußen. Wirklich belastbare Erfahrungsberichte gibt es deshalb noch nicht, wohl aber eine erste Stimmung. Unter dem Reddit-Thread „Sonnet 5.5 is out“ standen zu dem Zeitpunkt erst wenige Kommentare, die eigentliche Diskussion lief in r/ClaudeCode und r/ClaudeAI. Reddit-Nutzer nenne ich ohne Namen, die Links führen zum Originalbeitrag. Übersetzungen sind von mir.
„Sonnet 5.5 got 70.6% on terminal-bench vs 66.4% for opus 5.5. […] that basically means we can let opus orchestrate and have sonnet agents do all the implementation and everything gets sooooo cheap.“
Sonnet 5.5 schlägt Opus 5.5 bei Terminal-Bench, also lassen wir Opus orchestrieren und Sonnet-Agenten umsetzen, und alles wird sehr billig.
„terminal-bench being higher doesn't really separate implementation skill from reasoning, it's one benchmark measuring agentic task completion, not a clean split of the two.“
Ein hoher Terminal-Bench-Wert trennt Umsetzungskönnen nicht sauber vom Denken, er misst nur das Erledigen von Agenten-Aufgaben. Die Gegenrede zur Begeisterung, gleich im selben Thread.
„Funny that I only recently switched my implementation agents to Opus 5.5... testing Sonnet 5.5 now for comparison for a day :)“
Lustig, ich habe meine Umsetzungs-Agenten erst kürzlich auf Opus 5.5 gestellt. Jetzt teste ich Sonnet 5.5 einen Tag zum Vergleich. Genau das ist der sinnvolle Weg.
„Cache price is same so on long horizon tasks sonnet would cost slightly less than opus. […] Intelligence is getting cheaper and cheaper“
Der Cache-Preis ist gleich, bei langen Abläufen ist Sonnet also nur etwas billiger als Opus. Und: Intelligenz wird immer billiger.
„Nice, matches Sol 6 at cheaper price“
Schön, auf Augenhöhe mit Sol 6 zu einem günstigeren Preis. Der Kommentar bezieht sich auf GPT-6 Sol aus Anthropics Tabelle.
„Where is my Haiku :(“
Wo bleibt mein Haiku? Haiku 5.5 hat Anthropic für die kommenden Wochen angekündigt. Nach einem Fable 5.5 fragt ein anderer Kommentar hoffnungsvoll, in der Ankündigung kommt es nicht vor.
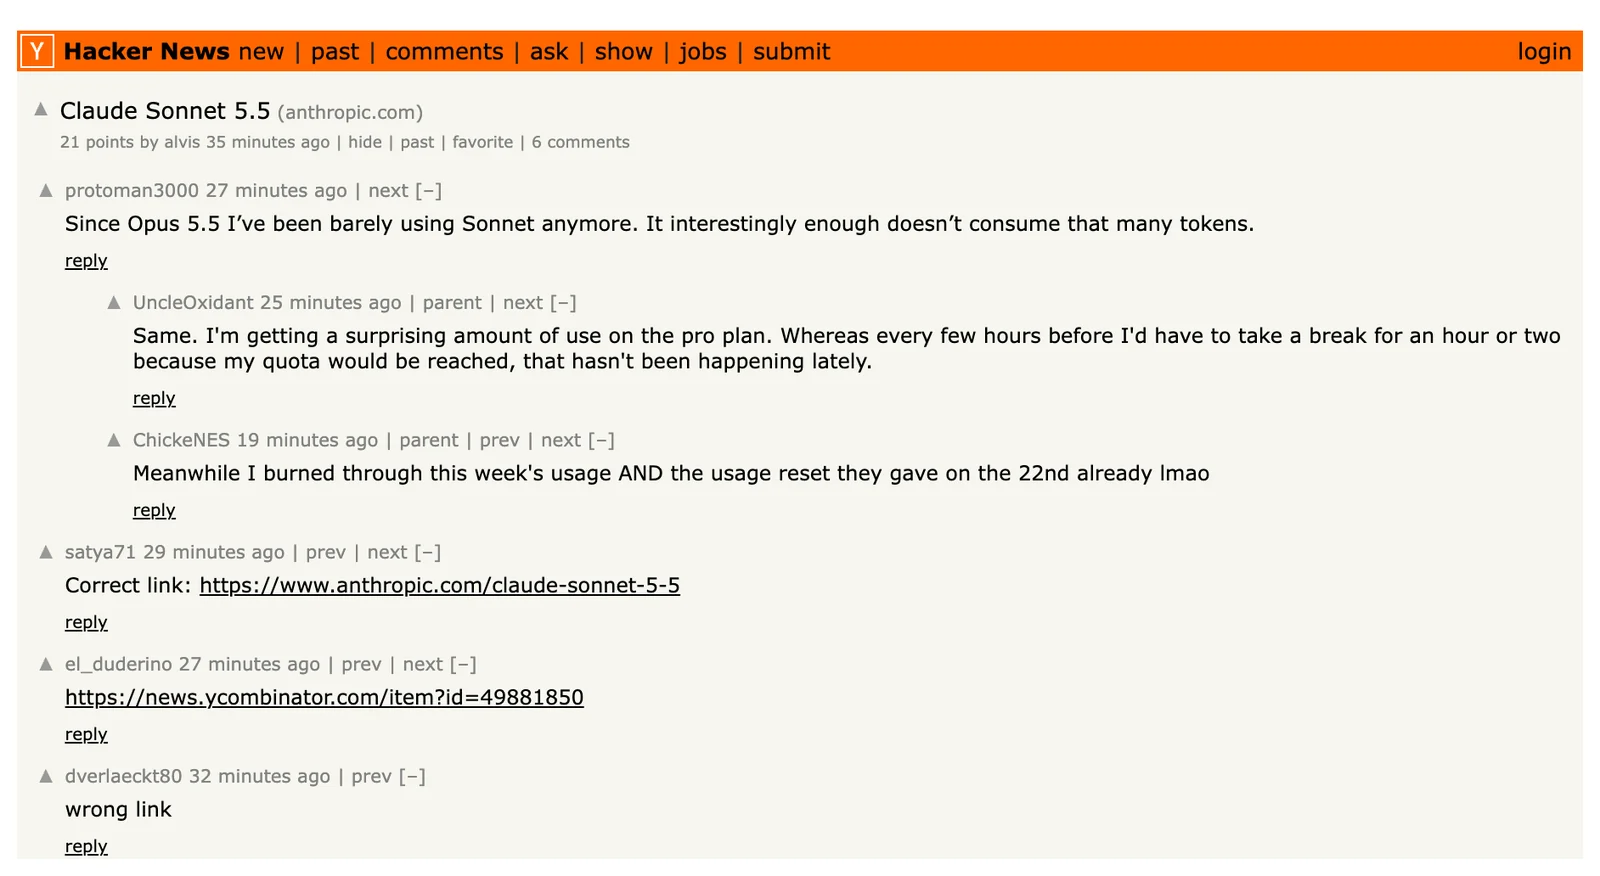
Auf Hacker News hatte der Beitrag zur Ankündigung nach 35 Minuten 21 Punkte und sechs Kommentare. Zwei davon drehen sich um dasselbe Thema, das Nutzer bei jedem Release umtreibt: die Limits. Ein Nutzer schreibt, er komme seit Opus 5.5 kaum noch zu Sonnet, das Modell verbrauche „interessanterweise“ nicht viele Tokens. Ein anderer berichtet, mit dem Pro-Abo müsse er nicht mehr alle paar Stunden für ein bis zwei Stunden pausieren, weil das Kontingent aufgebraucht ist. Ein dritter hat dagegen die Wochenlimits samt dem Reset vom 22.09. schon verbraucht.
Gut zu wissen
Bei den Kontingent-Beschwerden in r/ClaudeAI verweist die Moderation Beiträge zu Usage-Limits automatisch in einen Sammelthread. Dass Nutzer am Erscheinungstag schnell an ihre Grenzen stoßen, ist kein Sonnet-Problem, sondern ein Muster bei jedem Modellstart, bei dem viele gleichzeitig testen.
Was die Fachpresse schreibt
Die großen englischsprachigen KI-Portale haben am Erscheinungstag dieselben Kernzahlen übernommen und teils eigene Einordnungen ergänzt.
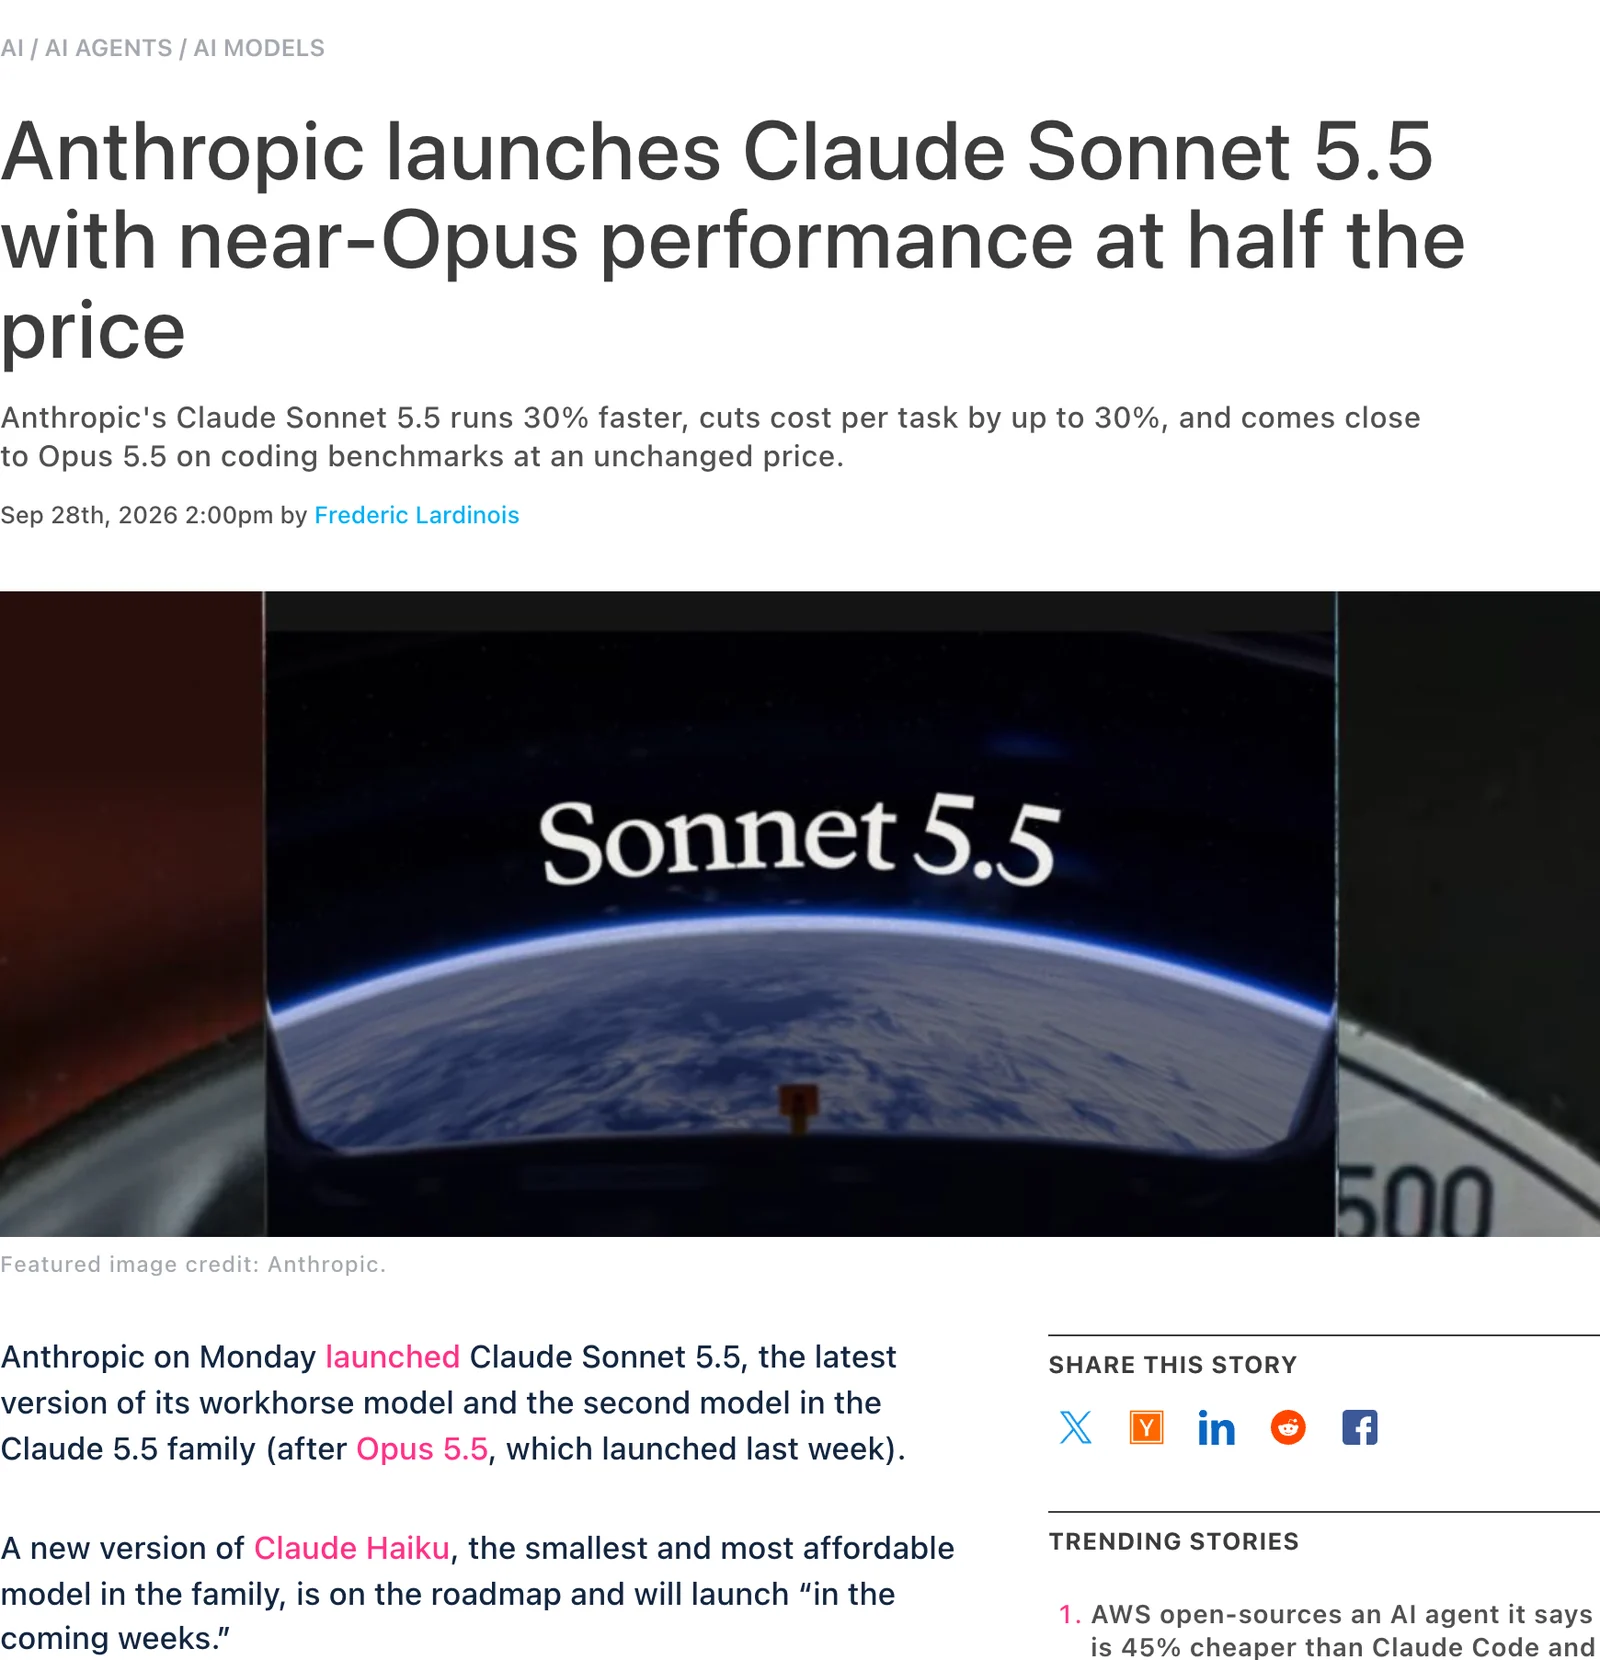
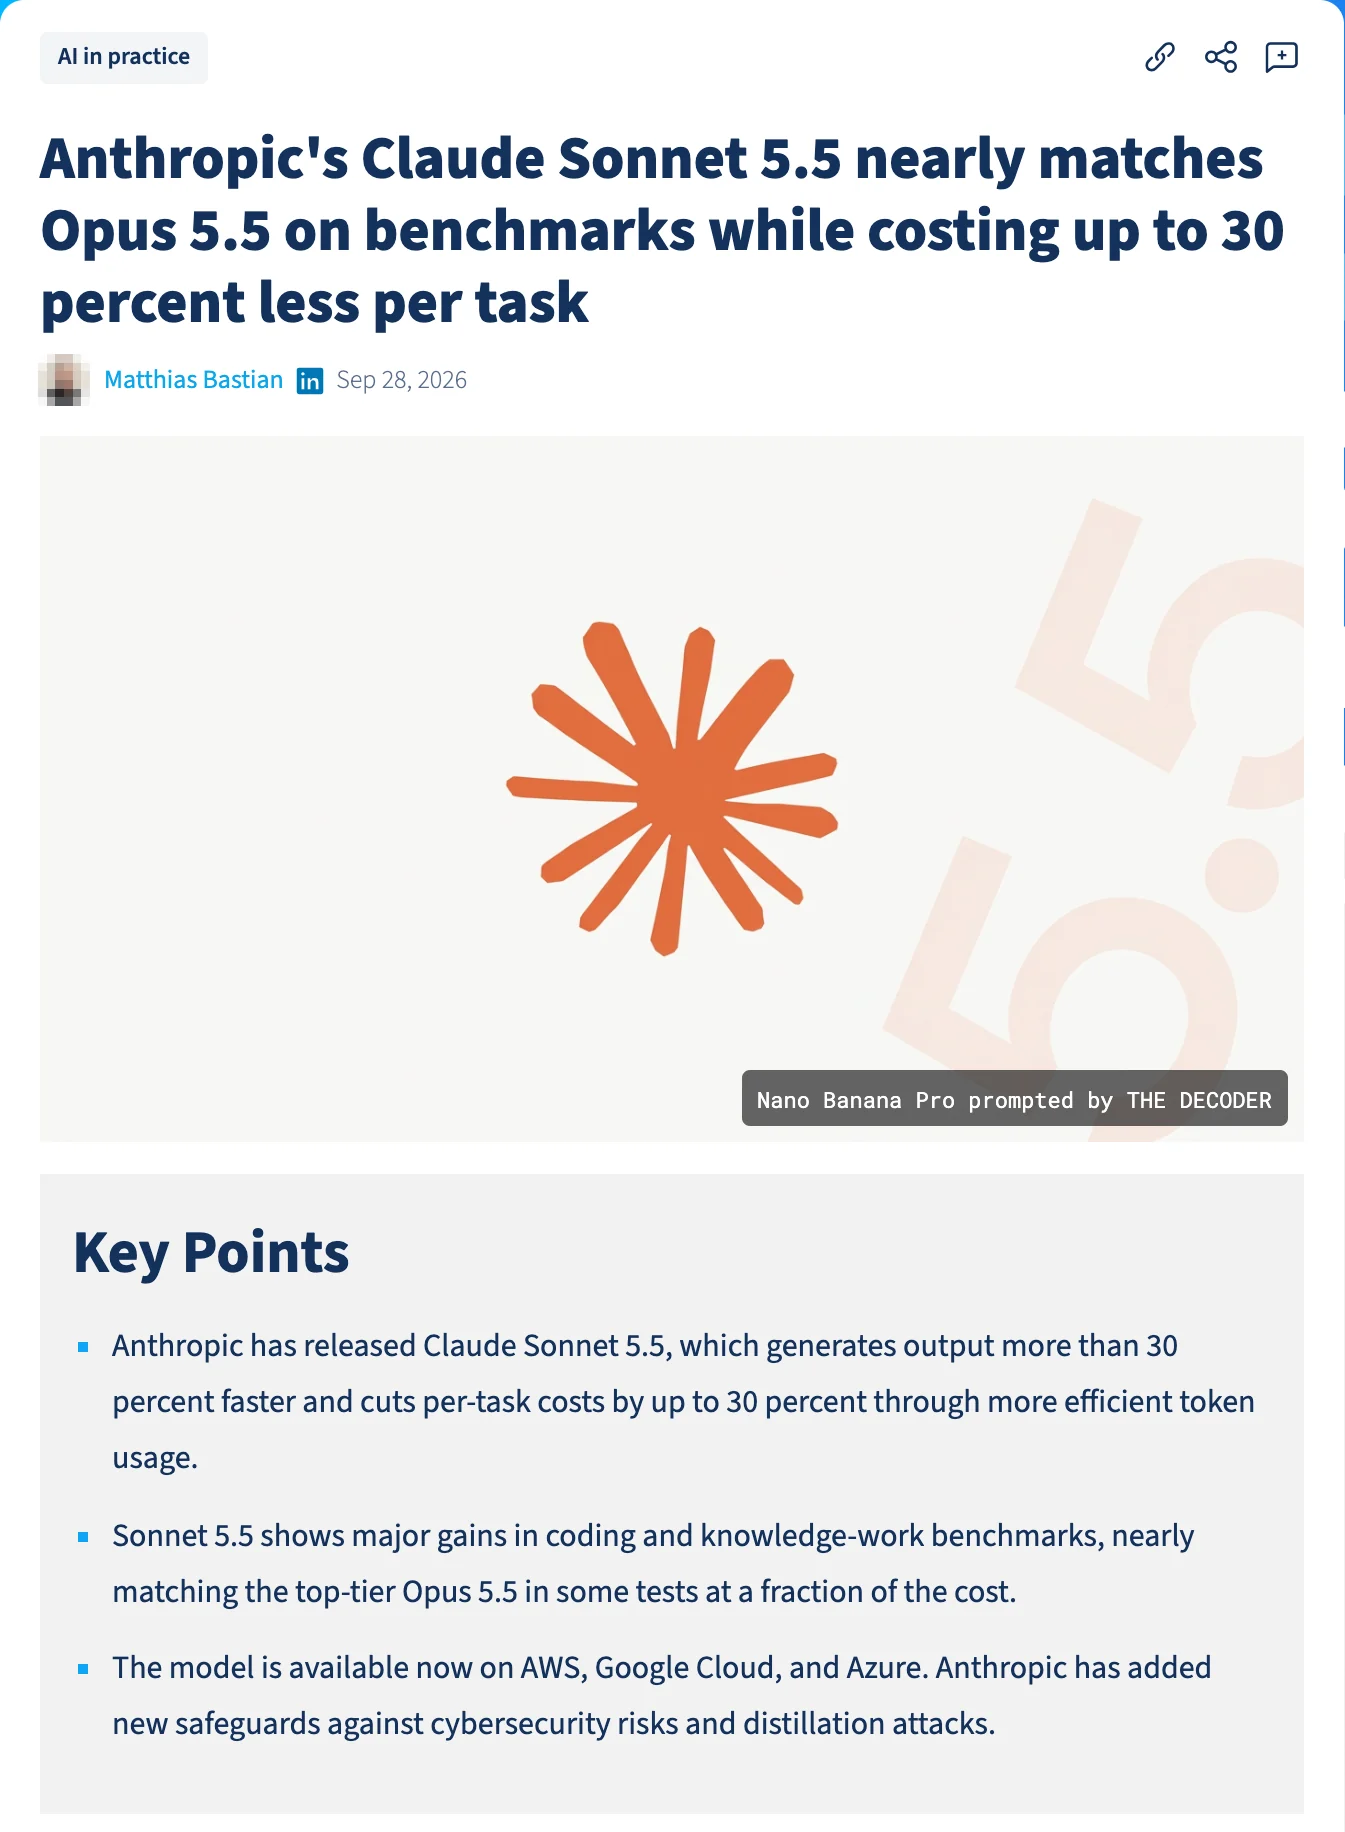
Auch OfficeChai fasst zusammen: Sonnet 5.5 führt gegenüber GPT-6 Sol bei GDPval-AA und AA-Briefcase. Bei FrontierCode sehen sie Sol vorn, das gilt für Sonnets Max-Wert, auf Xhigh dreht sich das Bild. Die Einordnung „nahe an Opus 5.5“ stammt damit aus mehreren Quellen, die alle auf dieselbe Herstellertabelle zurückgehen. Eine unabhängige Nachmessung, etwa durch Artificial Analysis mit Sonnet 5.5, war am Erscheinungstag noch nicht veröffentlicht.
Video-Test: sieben Videos, komplett aus Code
Peter Yang hat Sonnet 5.5 nach eigenen Angaben eine Woche vorab getestet und daraus ein 22-Minuten-Tutorial gemacht. Sein Ansatz: Video ist die „magische Fähigkeit“ von Opus 5.5 und Sonnet 5.5, so wie 3D-Modelle die von GPT Astra seien. Das Interessante daran ist nicht das Ergebnis allein, sondern der Weg: Fast alles entsteht durch Code, auch Ton und Musik.
| Beispiel | Wie es entstand | Aufwand |
|---|---|---|
| Meme | Mit den Video-Fähigkeiten von Sonnet erstellt, dient als Einstieg. | kurz gezeigt |
| Motion-Graphics-Reel, 20 Sekunden | Ein einfacher Prompt („zeig, was für ein toller Designer du bist“), danach der Text auf „Introducing Sonnet 5.5“ geändert. | zwei Runden |
| Claude-Maskottchen von der Steinzeit bis zur AGI | Ziel mit /goal gesetzt, Stil eines verlinkten X-Videos als Vorbild, danach Feedback für eine AGI-Szene. Ton und Musik ebenfalls aus Code. | mehrere Runden |
| Produkt-Launch-Video | Mit dem Open-Source-Werkzeug Hyperframes, Marken-Schrift, Farben und Logos vorgegeben, Vorschau-Einzelbilder abgestimmt, Feedback per Sprachdiktat, Musik-Auswahl, Animationen zur Musik synchronisiert. | ein ganzer Prozess |
| Vertikales Kurzvideo | Ein Prompt plus verlinkter Beitrag, mit Sprecherstimme. Nur ein dunkler Frame bei Sekunde 11 musste korrigiert werden. | fast One-Shot |
| Talking-Head-Video mit Overlays | Das Modell schneidet den Sprecher frei und ergänzt Effekte. Die ersten Vorschaubilder fand er langweilig, nach dem Auftrag, die Vorlage zu vergessen, wurde es deutlich mutiger, für seinen Stil aber zu aufdringlich. | weitere Runden nötig |
| Optimistisches Musikvideo | Vorbild: ein verlinktes X-Video samt Prompt. Reine Code-Grafik, einfache Formen. | One-Shot |
| Anime-Musikvideo | Liedtext mit dem Modell entwickelt, Song mit Suno erzeugt, Bilder und Videos über ein Videomodell auf fal.ai, dafür etwa 15 $ Guthaben. | mehrere Werkzeuge |
Seine vier Tipps kann man mitnehmen: Gib dem Modell den Link zu einem Video, dessen Stil du magst. Nutze Hyperframes und gib Logos, Farben und Schriften mit, wenn das Video zu deiner Marke passen soll. Lass Musik von einem Musikgenerator wie Suno erzeugen und das Modell die Animation darauf abstimmen. Und für hochwertige Videos braucht es ein Videomodell, was Geld kostet. Zum Verbrauch sagt Yang, er sei auf dem 200-Dollar-Plan, halte Sonnet und Opus 5.5 aber für sehr sparsam, sodass auch im 20-Dollar-Plan ein paar Clips gehen sollten. Das ist ein Erfahrungswert einer Person, keine Messung.
Einordnung
Das Video zeigt, wie weit sich Code-Modelle über ihr Kerngebiet hinaus treiben lassen, ist aber ein einzelner Erfahrungsbericht mit persönlichem Geschmack. Yang sagt selbst, das Anime-Video habe nicht die Qualität echter Animatoren und der Talking-Head-Schnitt sei ihm zu aufdringlich. Für Shops ist es vor allem ein Hinweis, dass kurze Produkt- und Erklärvideos aus Vorlagen und Markenwerten machbar werden. Wie das mit Bildern und Anzeigen aussieht, habe ich in Static Ads mit KI und im Beitrag zu Magnific Spaces mit Claude festgehalten.
Was das für Shops, SEO und Content bedeutet
Die folgende Einordnung ist meine Einschätzung auf Basis der Herstellerdaten. Eigene Messungen an Shop-Aufgaben reiche ich nach, sobald ich Sonnet 5.5 an echten Projekten getestet habe. Bis dahin dienen die Testfälle unten als Startpunkt für deine eigenen Vergleiche.
Guter Kandidat für Sonnet 5.5
- Produkttexte, Kategorietexte, Meta-Beschreibungen und Alt-Texte in großer Menge, vorzugsweise per Batch-API zum halben Preis.
- Datenpflege: Attribute vereinheitlichen, Varianten benennen, Tabellen und CSV-Dateien umformatieren.
- Screenshots von Diagrammen lesen lassen, etwa aus Search Console oder Analytics. Bei Chartography ist der Sprung am größten (15,6 % auf 61,6 %).
- Berichte und Folien nach Vorlage, zum Beispiel ein monatlicher Report für Kunden.
- Support-Antworten und Ticket-Vorsortierung, so berichtet es Zendesk.
Besser Opus 5.5 oder ein Mensch
- Strategische SEO-Entscheidungen, Relaunch-Planung und Migrationen mit vielen Abhängigkeiten.
- Alles, was Kunden ohne Prüfung erreicht, besonders bei Preisen, Rechtstexten oder Gesundheitsthemen.
- Offene Analyse über sehr viele Quellen, bei der eine falsche Annahme den Rest verdirbt.
Wichtig
Ein günstiges Modell macht Massentexte billig, aber nicht gut. Google geht mit dem Spam-Update vom September 2026 gerade gegen Massenware ohne eigenen Beitrag vor, egal ob Mensch oder Maschine sie geschrieben hat. Nutze die gesparten Kosten, um mehr Zeit in Prüfung, eigene Daten und Erfahrung zu stecken, nicht um mehr Seiten aus derselben Vorlage zu erzeugen.
Sicherheit und Sperren
Sonnet 5.5 startet mit Schutzmaßnahmen, die es bei Sonnet bisher nicht gab. Für dich als Anwender ändert sich im Alltag meist nichts, aber es lohnt sich, sie zu kennen:
- Cybersicherheit: Weil die Fähigkeiten laut Anthropic mit Opus 5 vergleichbar sind, gelten ähnliche Safeguards wie bei Opus 5.5. Normale Softwareentwicklung, auch das Finden und Beheben von Bugs, bleibt frei. Riskantere Sicherheitsaufgaben fallen sichtbar auf Sonnet 5 zurück. Verteidiger können sich für das erweiterte Cyber Verification Program bewerben.
- Biologie: Dieselben Sperren wie bei Sonnet 5. Manche mikrobiologische und virologische Anfragen werden dabei fälschlich markiert, es gibt dafür ein Life Sciences Verification Program.
- Destillation: Sonnet 5.5 ist das erste Sonnet mit Classifiern, die verhindern sollen, dass jemand die Denkschritte des Modells abgreift. Außerdem sind Denkblöcke nun an das Konto gebunden, das sie erzeugt hat. Wer in Claude Code mitten in einer Sitzung das Konto wechselt, sollte die Anthropic-Dokumentation zu Preserved Thinking lesen.
- Ausrichtung: In Anthropics automatischer Prüfung mit rund 1.850 Szenarien ist Sonnet 5.5 bei den meisten Werten besser oder gleich gut wie Sonnet 5. Bei den Container-Tests kommt es Opus 5.5 nahe und ist das Modell, das am seltensten die Grenzen seiner Umgebung austestet. Opus 5.5 schneidet insgesamt etwas besser ab.
Umstieg per API: Was sich ändert
Wenn du Sonnet 4.6, Sonnet 5 oder Haiku 4.5 per API nutzt, reicht ein Tausch des Modellnamens nicht. Die Migrationsanleitung nennt Einstellungen, die einen Fehler liefern. Die wichtigsten für den Wechsel von Sonnet 5:
| Was | Was jetzt gilt |
|---|---|
| Modellname | claude-sonnet-5-5, ohne Datumszusatz |
| Denken abschalten | thinking: {"type": "disabled"} liefert einen 400-Fehler. Stattdessen {"type": "between_tools"}. Das geht nur bei Effort low, medium und high, bei xhigh und max gibt es einen Fehler. |
Ohne thinking-Feld | Das Modell denkt jetzt adaptiv. Frühere Sonnet-Modelle bis 4.6 und Haiku 4.5 liefen ohne Denken. |
| Erzwungene Tool-Wahl | tool_choice vom Typ any oder tool wird abgelehnt (400-Fehler). |
| Computerbedienung | Auf der Claude API und bei Google Cloud nur noch über computer_toolset_20260801. |
| Denkblöcke | Sind an Modell und Konversation gebunden, Gespräche müssen nur angehängt und nicht nachträglich verändert werden. Blöcke aus Opus 5, Opus 5.5 oder Fable liest Sonnet 5.5 nicht. |
| Zwischentexte bei Tool-Aufrufen | Längere Notizen kommen als thinking-Blöcke zurück. Wer sie in einer Oberfläche anzeigt, muss display anpassen, sonst wird es dort still. |
| Effort | Fünf Stufen, neu kalibriert. Anthropic empfiehlt, den Sweep zu wiederholen: bei Agenten-Coding mit Medium starten, bei schwereren Aufgaben High. |
| Prompt-Cache | Mindestlänge sinkt auf 512 Tokens (vorher 1.024). |
| Ablehnungen | Zusätzliche Kategorien wie cyber, bio, frontier_llm und reasoning_extraction. Nur cyber und frontier_llm können automatisch auf Sonnet 5 zurückfallen. |
Tipp
In Claude Code gibt es dafür einen eingebauten Helfer: /claude-api migrate this project to claude-sonnet-5-5. Er tauscht die Modell-ID, passt kritische Parameter an und liefert eine Checkliste zum Nachprüfen. Er fragt vorher, in welchem Umfang er ändern darf. Wer Managed Agents nutzt, muss laut Anleitung nur den Modellnamen ändern.
Häufige Fragen
Was ist Claude Sonnet 5.5?
Sonnet 5.5 ist ein KI-Modell von Anthropic, veröffentlicht am 28.09.2026 als zweites Modell der 5.5-Familie. Es ist schneller und günstiger als Opus 5.5 und für klar umrissene Alltagsaufgaben, Bugfixes und Dokumente gedacht. Es unterstützt Text- und Bildeingaben, ein Kontextfenster von einer Million Tokens und bis zu 128.000 Ausgabe-Tokens.
Was kostet Claude Sonnet 5.5?
Über die API 2 $ pro Million Eingabe-Tokens und 10 $ pro Million Ausgabe-Tokens, dazu 0,20 $ für Cache-Lesen. Mit der Batch-API halbiert sich das auf 1 $ und 5 $. Opus 5.5 kostet mit 4 $ und 20 $ das Doppelte. In den Claude-Apps ist Sonnet 5.5 Teil der Abos.
Ist Sonnet 5.5 besser als Opus 5.5?
Nicht insgesamt. Bei Terminal-Bench 4.0 liegt Sonnet 5.5 mit 70,6 % vor Opus 5.5 (66,4 %), bei den meisten anderen Tests leicht dahinter. Anthropic schreibt selbst, Opus 5.5 sei bei komplexer, offener Arbeit mit anhaltendem Urteilsvermögen deutlich stärker. Sonnet 5.5 spielt seinen Vorteil bei Tempo und Preis aus.
Was ist der Unterschied zwischen Sonnet 5.5 und Sonnet 5?
Sonnet 5.5 ist laut Anthropic über 30 % schneller, kostet für dieselbe Arbeit bis zu 30 % weniger und ist bei Coding und Wissensarbeit deutlich besser. Bei Terminal-Bench 4.0 stehen 70,6 % gegen 10,3 %, bei GDPval-AA 1.844 gegen 1.449 Punkte. Der Preis pro Token ist gleich.
Welchen Effort sollte ich bei Sonnet 5.5 wählen?
In Claude-Apps und Claude Code ist Medium voreingestellt, über die API gilt High. Anthropic empfiehlt, bei gut beschriebenen Aufgaben mit Medium zu beginnen und bei schwierigeren auf High zu gehen. Xhigh und Max lohnen sich nur, wenn Tests zeigen, dass sie das Ergebnis verbessern. Bei FrontierCode war Max sogar schlechter als Xhigh.
Ersetzt Sonnet 5.5 Haiku?
Nein. Haiku 5.5 hat Anthropic für die kommenden Wochen angekündigt, als Modell für hohes Volumen und kostenbewusste Anwendungen. Aktuell ist Haiku 4.5 die günstigste Stufe, mit 1 $ und 5 $ pro Million Tokens.
Fazit
Sonnet 5.5 ist ein starkes Update, vor allem wirtschaftlich. Der Preis pro Token bleibt, die Leistung springt bei Coding, Wissensarbeit und Diagrammen, und weil weniger Tokens verbraucht werden, sinken die Kosten je Aufgabe. Für viele Alltagsaufgaben, gerade in Shop und Marketing, wird es damit zur sinnvollen Standardwahl, mit Opus 5.5 für die Stellen, an denen Urteilsvermögen zählt.
Was noch fehlt, sind unabhängige Messungen und Erfahrungen aus ein paar Wochen Praxis. Ich aktualisiere diesen Beitrag, sobald Artificial Analysis und andere Sonnet 5.5 selbst gemessen haben und wenn Haiku 5.5 erscheint. Teste in der Zwischenzeit deine wichtigsten Aufgaben an drei echten Beispielen mit Sonnet 5.5 auf Medium und High und vergleiche mit deinem bisherigen Modell.
Stand: 28.09.2026, dem Erscheinungstag. Zahlen zu Preisen und Benchmarks stammen aus den verlinkten Quellen, Community-Stimmen aus den ersten ein bis zwei Stunden nach dem Start.
Quellen
- Anthropic: Introducing Claude Sonnet 5.5 (28.09.2026) und Sonnet 5.5 System Card
- Anthropic: Claude Opus 5.5 (22.09.2026)
- Claude Platform Docs: Models overview, Pricing und Migrating to Claude Sonnet 5.5 (Stand 28.09.2026)
- Claude Academy: Choosing the right effort level in Claude Code
- The New Stack: Anthropic launches Claude Sonnet 5.5 with near-Opus performance at half the price (28.09.2026)
- The Decoder: Anthropic's Claude Sonnet 5.5 nearly matches Opus 5.5 on benchmarks while costing up to 30 percent less per task (28.09.2026)
- OfficeChai: Anthropic Releases Claude Sonnet 5.5, Beats GPT-6 Sol On Some Benchmarks (28.09.2026)
- Startup Fortune: Claude Sonnet 5.5 leak claims a last minute upgrade before a Monday launch
- Hacker News: Claude Sonnet 5.5 (28.09.2026)
- Reddit: Sonnet 5.5 is out!! (r/ClaudeAI), Sonnet 5.5 beats Opus 5.5 at coding and it's half the price?? (r/ClaudeCode), Reminder that Opus 5.5 on xhigh can do worse than max (r/ClaudeAI), alle vom 28.09.2026
- YouTube: Peter Yang: Sonnet 5.5 is Here! It's Insane at Making Videos (7 Incredible Examples), 28.09.2026
Geschrieben von
Mario WormuthSEO, GEO und KI-Automatisierung für Online-Shops. Ich teste, worüber ich schreibe, zuerst auf eigenen Seiten und in Kundenprojekten wie RYMHART und Opal-Schmiede.
Das für deinen Shop umsetzen?
Drei Fragen, sofort eine Einschätzung, danach drei konkrete Punkte von mir persönlich. Kostenlos.
Weitere Artikel
aus dem Magazin.
Alle Artikel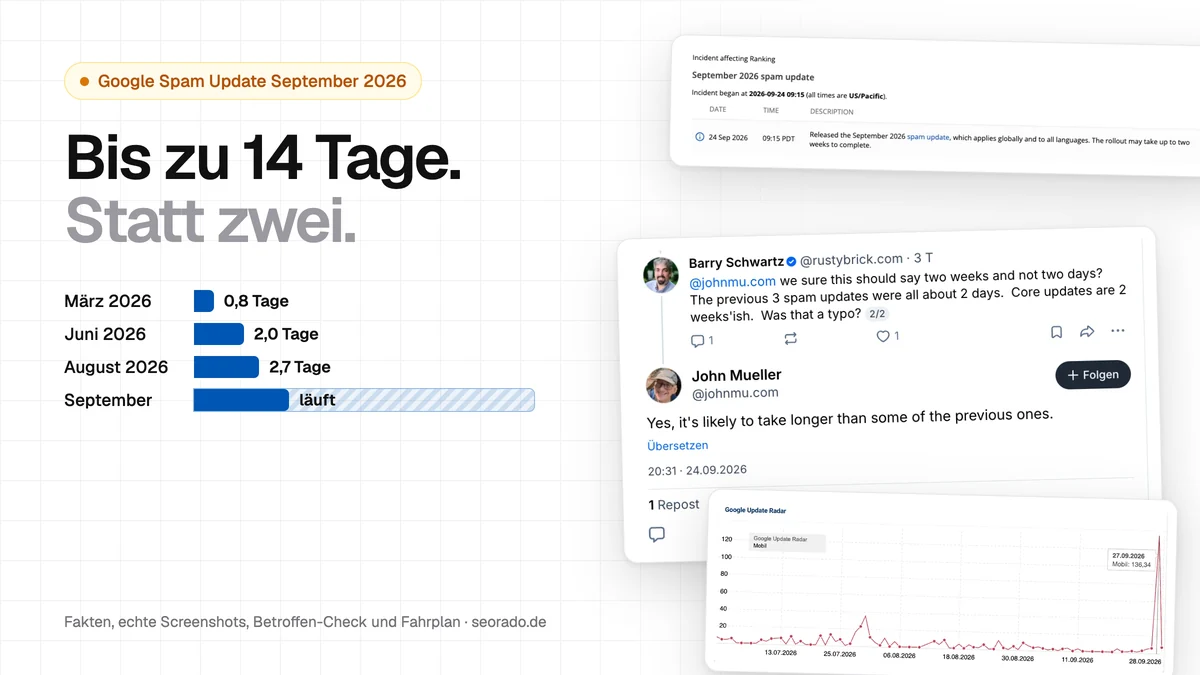
Google Spam Update September 2026: Was jetzt zu tun ist
Am 24. September 2026 um 18:15 Uhr deutscher Zeit hat Google das vierte Spam-Update dieses Jahres gestartet. Auffällig ist nicht das Update selbst, sondern seine Dauer. Die drei Spam-Updates davor waren nach 19 …
Magnific Spaces mit Claude: Produktfotos und Ads per MCP
KI-Bildmodelle sind gut darin, schöne Bilder zu erfinden. Genau das ist bei Produktfotos das Problem: Sie erfinden auch den Reißverschluss, das Etikett und das Logo. Für RYMHART, einen Strickwaren-Hersteller aus …
Static Ads mit KI: Prompts, Fehler und Kosten im Praxistest
Ich plane und betreue Anzeigen bei Meta und Google, und die Werbemittel dafür entstehen bei mir mit KI. Für mein Labor habe ich am 27.09.2026 dreißig Static Ads für sechs erfundene Marken gebaut: Nahrungsergänzung, …