Start / Magazin / Weitere Themen
GPT-6.1 Sol und DevDay 2026: Benchmarks, Preise, Limits und Vergleich mit Opus 5.5
ArtikelWeitere Themen30.09.2026/img/magazin/gpt-6-1-sol-openai-devday-2026.webp Mario WormuthSEO, GEO & KI-Automatisierung
38 Min. Lesezeit
Alles auf einen Blick
- GPT-6.1 Sol kostet über die API 2 $ Eingabe und 10 $ Ausgabe je Million Tokens, so viel wie GPT-6 Sol und Claude Sonnet 5.5 und ein Fünftel von GPT-6 Astra. Neu ist der Cache-Preis: 0,10 $ statt 0,20 $.
- In OpenAIs eigenen Tests schlägt es beim Coding-Test DeepSWE mit 75,2 % sogar Astras besten Wert (74,1 %) und kostet dabei 0,65 $ statt 4,43 $ pro Aufgabe. Der Vorgänger GPT-6 Sol kam höchstens auf 68,8 %.
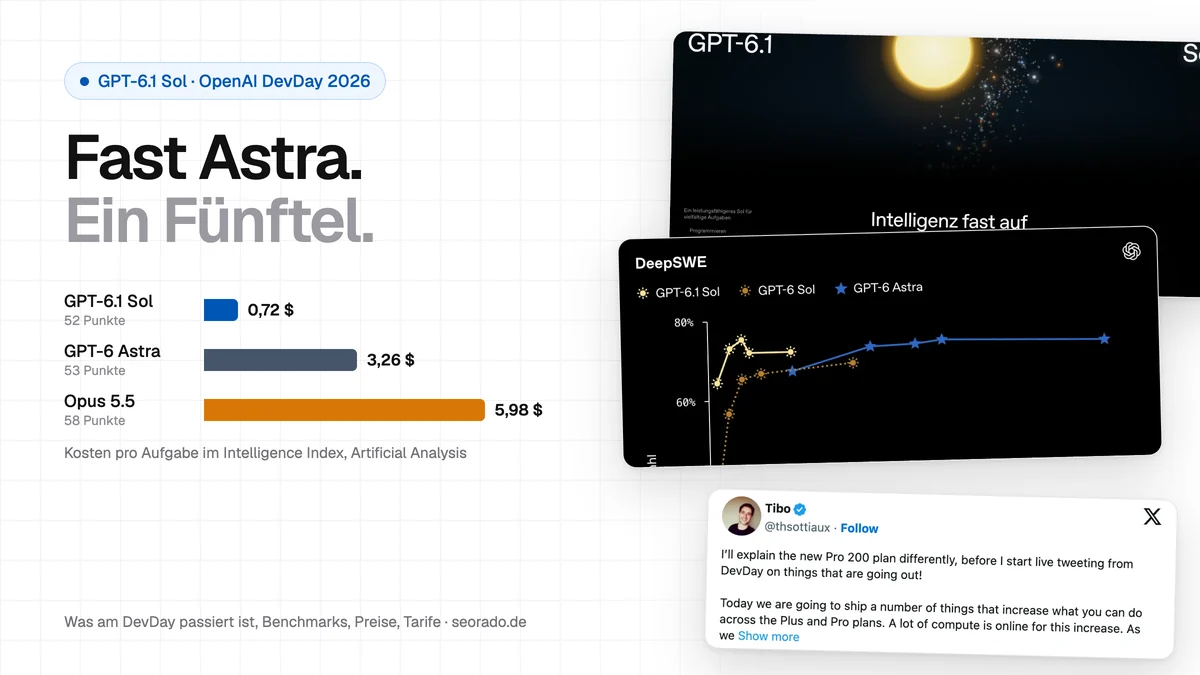
- Unabhängig gemessen landet es bei Artificial Analysis auf 52 Punkten im Intelligence Index: einen Punkt hinter Astra, vier hinter Sonnet 5.5 und sechs hinter Opus 5.5. Pro Aufgabe kostet es dort 0,72 $, Astra 3,26 $, Opus 5.5 5,98 $ und Sonnet 5.5 7,60 $.
- Der Vorsprung vor Opus 5.5, den OpenAI bei Geschäftsabläufen nennt, gilt nur auf mittlerer Denkstufe. Auf Max liegt Opus 5.5 mit 42,5 % vor GPT-6.1 Sol mit 36,1 %.
- Die Community ist sich in zwei Punkten fast einig: Das Modell verbraucht im Abo wenig Kontingent, und es ist langsam. Bei Gestaltung und Oberflächen sehen die meisten Tester Claude oder Astra vorn.
- Pro 200 enthält ab dem 30. Oktober 2026 nur noch das Zehnfache statt das Zwanzigfache von Plus. Damit kostet jede Tarifstufe rechnerisch 20 $ je Plus-Einheit, der Mengenrabatt ist weg.
- Die neuen Agenten namens Dots gibt es für Pro-Nutzer im Europäischen Wirtschaftsraum, in der Schweiz und im Vereinigten Königreich zum Start nicht. GPT-6.1 Sol selbst ist auch hier verfügbar, allerdings nur in ChatGPT Work, Codex und der API, nicht im normalen Chat.
Inhaltsverzeichnis14 Abschnitte
- Was am DevDay 2026 passiert ist
- GPT-6.1 Sol im Steckbrief
- Die Benchmarks: fast Astra, zum Preis von Sol
- Unabhängig gemessen: Artificial Analysis
- GPT-6.1 Sol gegen GPT-6 Sol: Was sich in einer Woche geändert hat
- GPT-6.1 Sol gegen Opus 5.5 und Sonnet 5.5
- Tarife: Pro 500 kommt, Pro 200 wird halbiert
- Erste Reaktionen: Reddit und Hacker News
- Zwei Videotests: GPT-6.1 Sol gegen Sonnet 5.5
- Sicherheit: warum es kein GPT-6.1 Astra gibt
- Was das für Shops, SEO und Content bedeutet
- Häufige Fragen
- Fazit
- Quellen
Am 29. September 2026 hat OpenAI auf dem DevDay in San Francisco GPT-6.1 Sol vorgestellt, genau sieben Tage nach GPT-6 Sol. Das Versprechen steht in der Überschrift der Ankündigung: Intelligenz fast auf Astra-Niveau für ein Fünftel des Preises. Am selben Tag kamen mehr als 20 weitere Neuerungen, ein neuer Tarif für 500 Dollar im Monat und die Nachricht, dass der 200-Dollar-Tarif künftig nur noch halb so viel Kontingent enthält. Einen Tag vorher war bekannt geworden, dass OpenAI das eigentlich geplante Spitzenmodell GPT-6.1 Astra wegen Sicherheitsbedenken nicht veröffentlicht.
Das ist viel auf einmal. Ich habe die Ankündigung, die Systemkarte, die Preis- und Modellseiten, die Keynote, die Messungen von Artificial Analysis, Hacker News, gut 30 Reddit-Threads, zwei Vergleichsvideos und die Fachpresse durchgesehen und die wichtigen Stellen als Screenshots festgehalten. Bei der Recherche hat mir KI geholfen, Quellen zu finden und zu sortieren. Die Zahlen habe ich an den Originalseiten geprüft, die Diagrammwerte aus OpenAIs Seite selbst ausgelesen und die Rechner gebaut. Du bekommst einen Benchmark-Explorer für jede Denkstufe, einen Kostenrechner mit Cache, einen Tarif-Check zu Pro 200 und eine Entscheidungshilfe. GPT-6.1 Sol nutze ich seit dem Start selbst. Gemessene Tests an Shop-Aufgaben habe ich damit aber noch nicht gemacht, das sage ich an den passenden Stellen dazu.
Was am DevDay 2026 passiert ist
Der DevDay ist OpenAIs jährliche Entwicklerkonferenz. Dieses Jahr fand sie im Fort Mason in San Francisco statt, laut The Next Web mit 2.500 Entwicklern vor Ort. OpenAI spricht vom bisher größten DevDay und nennt 1,2 Milliarden Menschen, die die eigenen Angebote nutzen. Um den Tag einzuordnen, hilft der Blick auf die vier Wochen davor.
| Datum | Was passiert ist |
|---|---|
| 03.09.2026 | OpenAI veröffentlicht GPT-6 Astra, das neue Spitzenmodell (10 $ und 50 $ je Million Tokens). |
| 22.09.2026 | GPT-6 Sol und GPT-6 Luna erscheinen zum halben Preis ihrer Vorgänger. Am selben Tag bringt Anthropic Claude Opus 5.5. |
| 28.09.2026 | Das Wall Street Journal berichtet, dass OpenAI GPT-6.1 Astra nicht wie geplant im Oktober veröffentlicht. Anthropic bringt Claude Sonnet 5.5. |
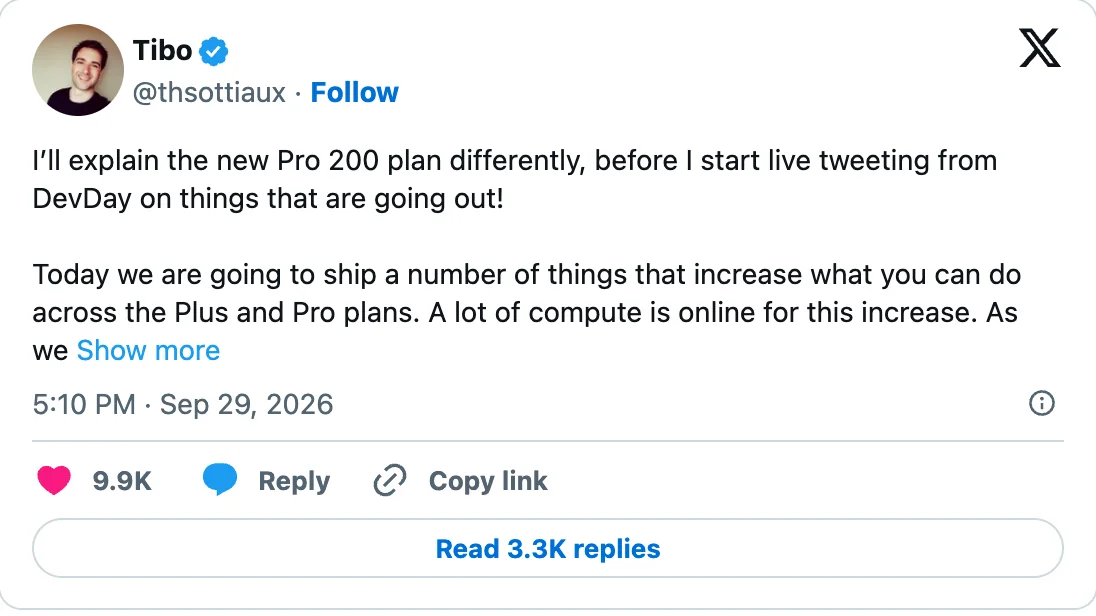
| 29.09.2026, 17:10 Uhr | Noch vor der Keynote erklärt Tibo Sottiaux von OpenAI auf X, dass Pro 200 künftig das Zehnfache von Plus enthält. |
| 29.09.2026, ab 19 Uhr | Keynote mit Sam Altman: Dots, ChatGPT Space, GPT-6.1 Sol, Ultrafast, Pro 500 und mehr. GPT-6.1 Sol ist sofort verfügbar. |
| 30.10.2026 | Die Halbierung von Pro 200 greift auch für Bestandskunden. |
Die Uhrzeiten sind in deutscher Zeit angegeben. Der Beitrag von Sottiaux trägt den Zeitstempel 15:10 Uhr UTC, der Eintrag zu GPT-6.1 Sol auf Hacker News 17:06 Uhr UTC.
Die Ankündigungen im Überblick
OpenAI listet im Rückblick mehr als 20 Neuerungen. Für die meisten Leser hier sind die Modelle und die Tarife wichtig, deshalb stehen sie oben. Den Rest habe ich nach Bereichen sortiert und die Verfügbarkeit dazugeschrieben.
| Bereich | Neuerung | Verfügbar für |
|---|---|---|
| Modelle | GPT-6.1 Sol: Nachfolger von GPT-6 Sol, fast Astra-Niveau zu Sol-Preisen | API sowie Plus, Pro, Business, Enterprise und Edu in ChatGPT Work und Codex |
| Modelle | Ultrafast: bis zu achtmal schnellere Ausgabe in Codex (300 Tokens pro Sekunde), bis zu sechsmal in der API. Zuerst für Astra, für GPT-6.1 Sol „bald“ | API, Pro 500 und Enterprise |
| Agenten | Dots: dauerhaft aktive Agenten auf Basis von Astra mit eigenem Cloud-Computer | Pro, Business Premium, Enterprise. Pro-Nutzer im EWR, in der Schweiz und im Vereinigten Königreich zum Start nicht |
| Zusammenarbeit | ChatGPT Space, Living Pages, gemeinsame Folien, Teams und Teamaufgaben, @ChatGPT in Slack und Microsoft Teams, Meetings-Plugin | je nach Funktion Pro, Business, Enterprise |
| Codex | Codex in der Cloud, neue Kommandozeile mit Sprachsteuerung und /agents, Code Review für GitHub und GitLab, Codex Security Cloud | überwiegend alle Tarife |
| API | Decisions API auf Basis von Luna, Computerbedienung in der Agents API, Bedrock Managed Agents mit Amazon | API, teils Vorschau |
| Plugins | Plugin-Erweiterungen mit eigener Oberfläche, Plugin Creator, Sites mit Plugins, MCP-Ereignisse für Automatisierungen | überwiegend alle Tarife |
| Datenschutz | Private Intelligence: Sicherheitsprüfung ohne Speicherung der Inhalte, dazu eine Vorschau auf Private Inference | Unternehmen |
| Abo | Pro 500 für 500 $ im Monat mit 25-fachem Plus-Kontingent und Ultrafast. Pro 200 wieder buchbar, aber mit halbem Kontingent | Privatkunden |
| Abo | Mit ChatGPT anmelden: das eigene Kontingent in 16 Partner-Tools nutzen, darunter Devin, Notion und Vercel | Plus und Pro |
| Unternehmen | OpenAI Marketplace mit 32 Partnern, darunter Adobe, Figma, Salesforce und CrowdStrike | berechtigte Unternehmenskunden, Beta |
In der Keynote lief nicht alles glatt. Bei der Live-Vorführung ließ der Dot der Vortragenden auf eine gesprochene Frage so lange auf sich warten, dass sie scherzte, er habe wohl einen langsamen Morgen. Die neue Sprachsteuerung der Kommandozeile ließ sich auf der Bühne nicht starten. Am Ende wurden per Knopfdruck die Nutzungslimits für alle Nutzer zurückgesetzt. Das sind Randnotizen, sie erklären aber einen Teil der gemischten Stimmung in den Foren.
Gut zu wissen: Dots in Europa
Heise und The Next Web berichten übereinstimmend, dass Pro-Nutzer im Europäischen Wirtschaftsraum, in der Schweiz und im Vereinigten Königreich zum Start keine Dots bekommen. Für Business Premium gilt die Einschränkung laut heise nicht. Wer die Agenten aus der Keynote ausprobieren will, braucht hierzulande also vorerst einen Geschäftstarif. GPT-6.1 Sol ist davon nicht betroffen. Was Dots können, was sie in Deutschland kosten und was es mit dot.com auf sich hat, steht im Beitrag ChatGPT Dots: Was OpenAIs Agenten können und was sie kosten.
GPT-6.1 Sol im Steckbrief
OpenAI sortiert seine Modelle in drei Stufen: Astra ist das Spitzenmodell, Sol die Mittelklasse, Luna das günstige Modell für große Mengen. GPT-6.1 Sol ersetzt GPT-6 Sol, das gerade eine Woche alt war. OpenAI beschreibt es als Upgrade mit besonders starker Leistung beim agentischen Programmieren, bei der Computerbedienung und bei beruflichen Aufgaben.
| Steckbrief | GPT-6.1 Sol |
|---|---|
| Veröffentlicht | 29.09.2026, sieben Tage nach GPT-6 Sol (22.09.2026) |
| Modellname in der API | gpt-6.1-sol |
| Preis pro Million Tokens | 2 $ Eingabe, 10 $ Ausgabe, 0,10 $ Cache-Lesen, 2,50 $ Cache-Schreiben |
| Aufschlag bei langem Kontext | Anfragen mit mehr als 272.000 Eingabe-Tokens: doppelter Preis für Eingabe und Cache, 1,5-facher für Ausgabe |
| Rabatte und Aufschläge | Batch und Flex 50 % günstiger, Fast-Modus doppelter Preis, regionale Verarbeitung plus 10 % |
| Kontextfenster / maximale Ausgabe | 1.050.000 Tokens / 128.000 Tokens |
| Wissensstand | 30. April 2026 |
| Denkstufen | low, medium (Standard), high, xhigh, max. Ohne Denken geht es nicht: none und minimal werden nicht unterstützt |
| Ein- und Ausgabe | Text und Bild rein, Text raus |
| Verfügbar | API, außerdem ChatGPT Work und Codex für Plus, Pro, Business, Enterprise und Edu. Im normalen Chat noch nicht |
| Datenresidenz | USA und EU. Der Fast-Modus steht mit EU-Datenresidenz nicht zur Verfügung |
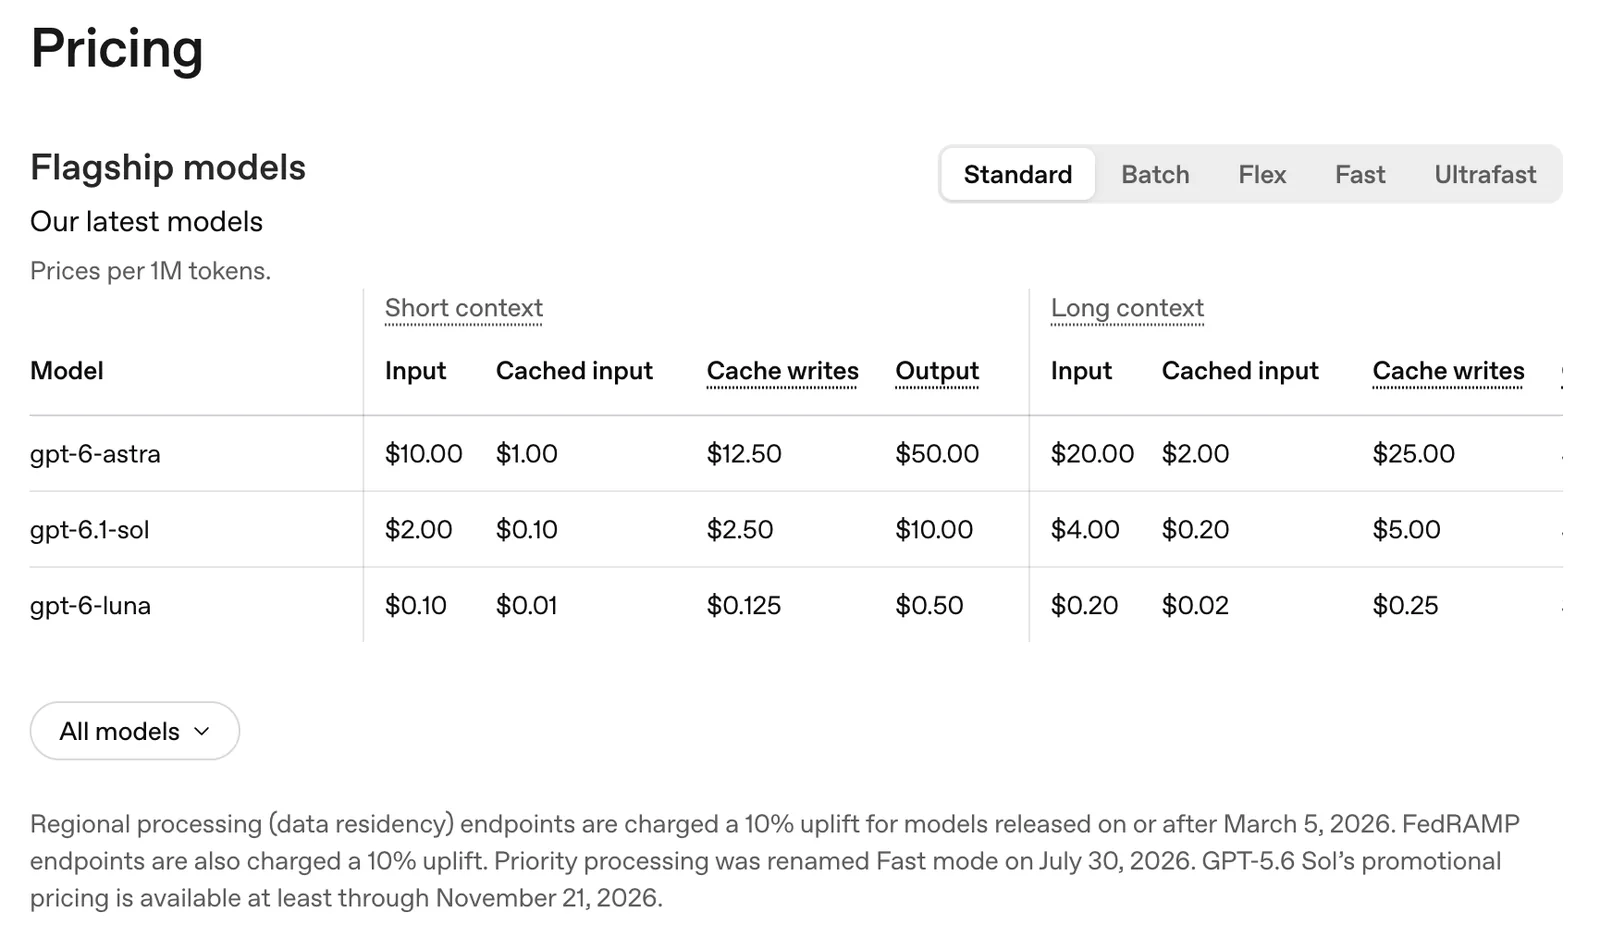
Zwei Details gehen in den Schlagzeilen unter. Erstens: Gegenüber GPT-6 Sol hat sich am Preis für Ein- und Ausgabe nichts geändert, nur das Lesen aus dem Cache ist halb so teuer. Ein Kommentator auf Hacker News nennt genau das die eigentliche Nachricht des Tages. Zweitens: Wer GPT-6 Sol als billigen Funktionsaufrufer ohne Denken genutzt hat, muss umbauen. Laut Modellseite laufen Tool-Aufrufe bei GPT-6.1 Sol nur über die Responses API, und das Denken lässt sich nicht abschalten. Darauf weist auch Jake Handy in seinem Newsletter hin.
Die Benchmarks: fast Astra, zum Preis von Sol
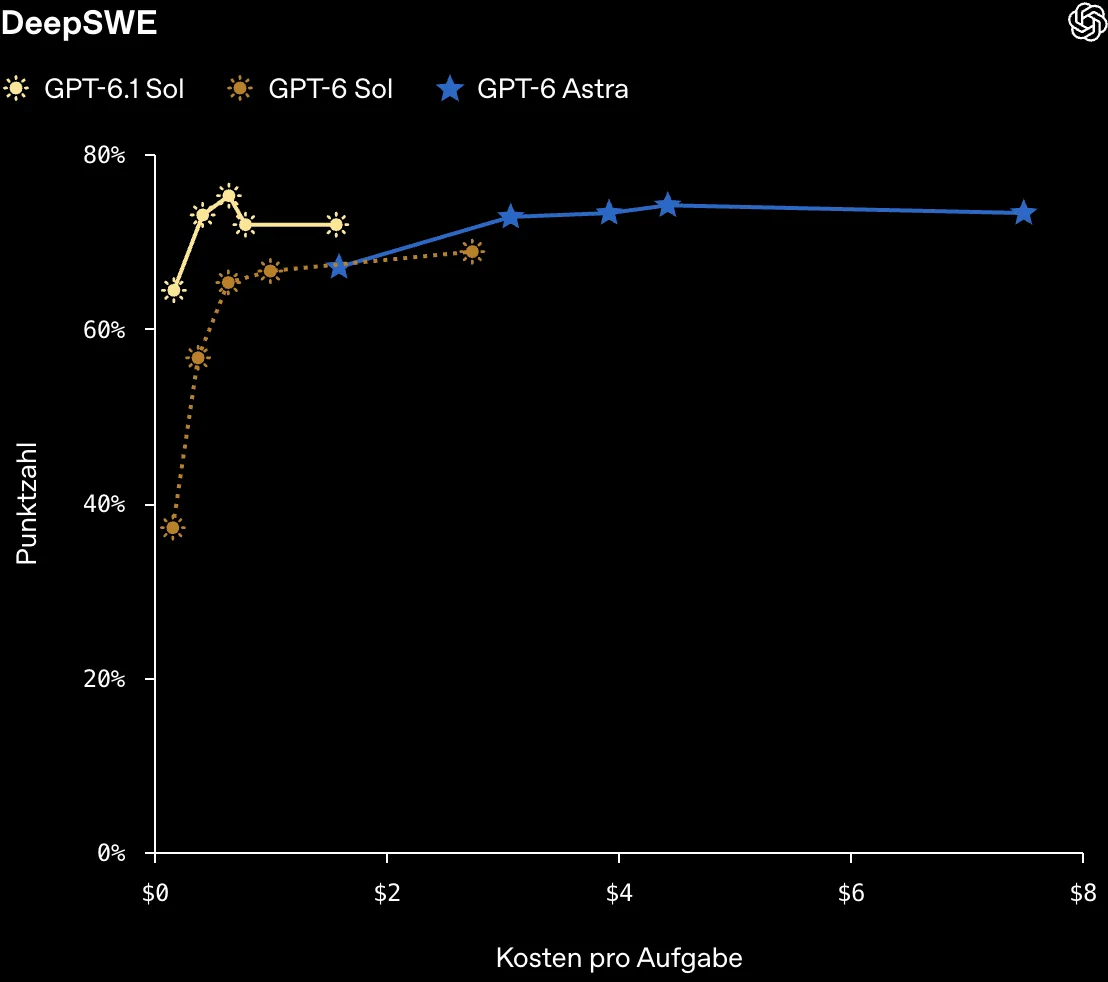
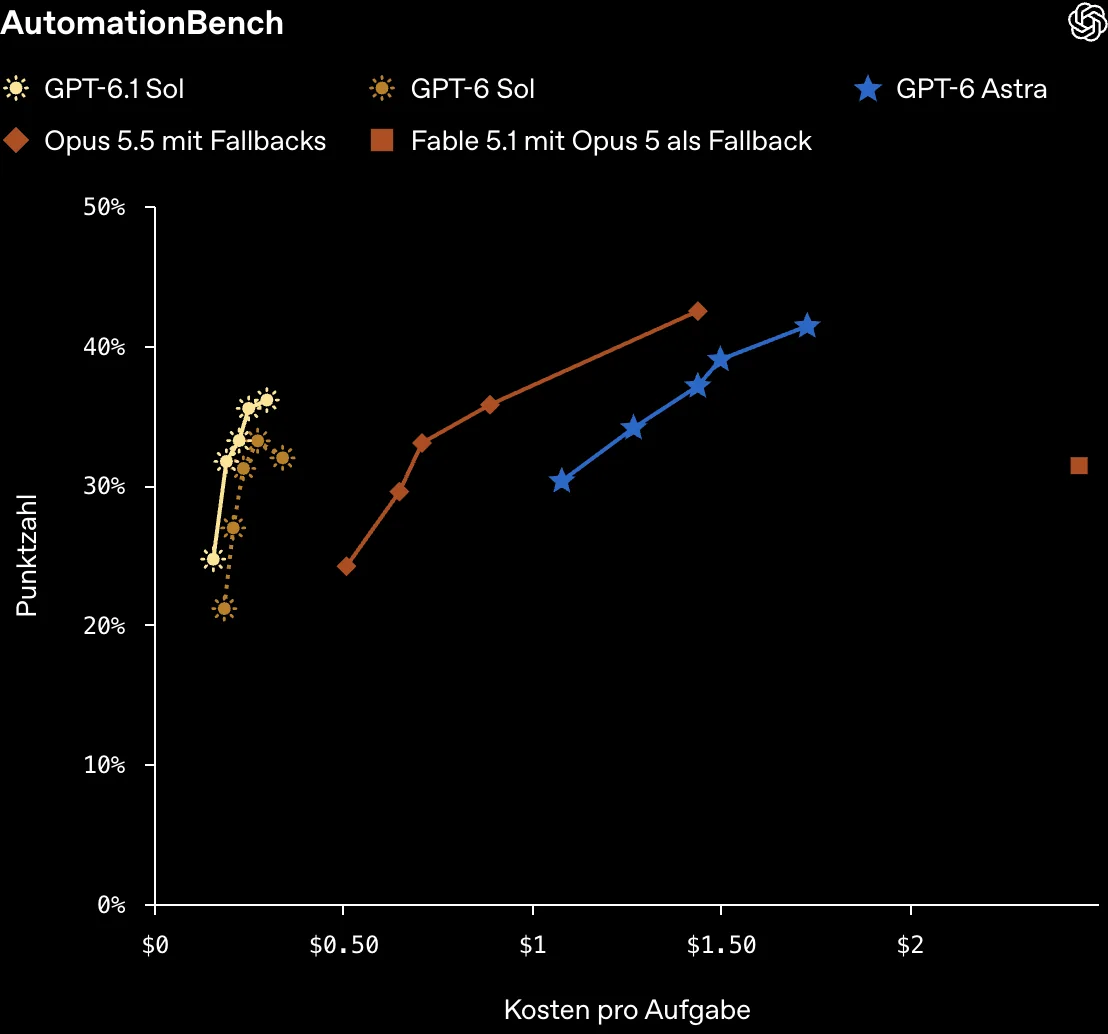
OpenAI zeigt fünf Tests plus eine Messung zu Faktenfehlern, jeweils als Diagramm mit dem Ergebnis auf der einen und den Kosten pro Aufgabe auf der anderen Achse. Jedes Modell erscheint als Linie mit fünf Punkten, einem je Denkstufe. Die genauen Werte stehen nicht im Text, sondern nur an den Datenpunkten der Diagramme. Ich habe sie dort ausgelesen und in einen Explorer übertragen. Wähle einen Test und eine Denkstufe.
GPT-6.1 SolGPT-6 SolGPT-6 AstraOpus 5.5 (mit Fallbacks)
Alle Werte als Tabelle
| Test | Modell | Low | Medium | High | Xhigh | Max |
|---|---|---|---|---|---|---|
| DeepSWE v1.1 (Agenten-Coding) | GPT-6.1 Sol | 64,4 %0,17 $ | 73,0 %0,42 $ | 75,2 %0,65 $ | 71,9 %0,79 $ | 71,9 %1,57 $ |
| DeepSWE v1.1 (Agenten-Coding) | GPT-6 Sol | 37,2 %0,16 $ | 56,6 %0,38 $ | 65,3 %0,64 $ | 66,6 %1,00 $ | 68,8 %2,74 $ |
| DeepSWE v1.1 (Agenten-Coding) | GPT-6 Astra | 67,0 %1,60 $ | 72,8 %3,08 $ | 73,2 %3,92 $ | 74,1 %4,43 $ | 73,2 %7,50 $ |
| OSWorld 2.0 (Computerbedienung) | GPT-6.1 Sol | 59,0 %0,42 $ | 66,8 %0,77 $ | 69,6 %0,96 $ | 69,4 %1,05 $ | 71,4 %1,27 $ |
| OSWorld 2.0 (Computerbedienung) | GPT-6 Sol | 43,9 %1,01 $ | 54,0 %1,38 $ | 58,3 %1,71 $ | 60,5 %2,30 $ | 64,4 %3,37 $ |
| OSWorld 2.0 (Computerbedienung) | GPT-6 Astra | 62,2 %2,72 $ | 69,3 %5,36 $ | 70,0 %6,91 $ | 71,3 %7,49 $ | 73,5 %9,44 $ |
| GDP.pdf (Fachfragen zu PDF-Dokumenten) | GPT-6.1 Sol | 27,0 %0,33 $ | 30,0 %0,34 $ | 32,0 %0,35 $ | 31,8 %0,37 $ | 31,0 %0,42 $ |
| GDP.pdf (Fachfragen zu PDF-Dokumenten) | GPT-6 Sol | 21,8 %0,33 $ | 25,4 %0,34 $ | 28,0 %0,35 $ | 23,8 %0,37 $ | 24,8 %0,43 $ |
| GDP.pdf (Fachfragen zu PDF-Dokumenten) | GPT-6 Astra | 30,4 %1,70 $ | 30,4 %1,72 $ | 31,0 %1,79 $ | 32,2 %1,91 $ | 31,0 %2,08 $ |
| GDP.pdf (Fachfragen zu PDF-Dokumenten) | Opus 5.5 | 25,6 %0,76 $ | 25,6 %0,80 $ | 28,8 %0,83 $ | 26,6 %0,96 $ | 26,2 %1,55 $ |
| AutomationBench 1.0.6 (Geschäftsabläufe) | GPT-6.1 Sol | 24,7 %0,16 $ | 31,7 %0,19 $ | 33,2 %0,23 $ | 35,5 %0,25 $ | 36,1 %0,30 $ |
| AutomationBench 1.0.6 (Geschäftsabläufe) | GPT-6 Sol | 21,2 %0,19 $ | 26,9 %0,21 $ | 31,2 %0,24 $ | 33,2 %0,27 $ | 32,0 %0,34 $ |
| AutomationBench 1.0.6 (Geschäftsabläufe) | GPT-6 Astra | 30,3 %1,08 $ | 34,1 %1,27 $ | 37,1 %1,44 $ | 39,0 %1,50 $ | 41,4 %1,73 $ |
| AutomationBench 1.0.6 (Geschäftsabläufe) | Opus 5.5 | 24,2 %0,51 $ | 29,5 %0,65 $ | 33,0 %0,71 $ | 35,8 %0,89 $ | 42,5 %1,44 $ |
| Terminal-Bench Science 0.1 (Forschung) | GPT-6.1 Sol | 43,7 %1,79 $ | 47,6 %2,34 $ | 51,1 %2,76 $ | 53,7 %2,89 $ | 57,0 %5,47 $ |
| Terminal-Bench Science 0.1 (Forschung) | GPT-6 Sol | 9,2 %3,00 $ | 14,5 %4,41 $ | 14,6 %4,63 $ | 25,3 %6,77 $ | 27,6 %12,18 $ |
| Terminal-Bench Science 0.1 (Forschung) | GPT-6 Astra | 55,4 %11,41 $ | 57,4 %12,34 $ | 62,0 %14,95 $ | 60,9 %15,76 $ | 68,1 %23,80 $ |
| Terminal-Bench Science 0.1 (Forschung) | Opus 5.5 | k. A. | k. A. | k. A. | k. A. | 63,3 %23,21 $ |
| Faktenfehler bei schwierigen Prompts (niedriger ist besser) | GPT-6.1 Sol | 7,7 %0,05 $ | 6,3 %0,06 $ | 4,5 %0,08 $ | 4,1 %0,10 $ | 4,6 %0,13 $ |
| Faktenfehler bei schwierigen Prompts (niedriger ist besser) | GPT-6 Sol | 11,4 %0,05 $ | 6,9 %0,07 $ | 5,1 %0,10 $ | 4,5 %0,13 $ | 4,6 %0,18 $ |
| Faktenfehler bei schwierigen Prompts (niedriger ist besser) | GPT-6 Astra | 6,3 %0,24 $ | 4,4 %0,31 $ | 3,9 %0,48 $ | 4,0 %0,60 $ | 3,9 %0,79 $ |
Quelle: OpenAI, „Introducing GPT-6.1 Sol“, Werte aus den Datenpunkten der Diagramme gelesen (Ergebnis, darunter Kosten pro Aufgabe in US-Dollar). OpenAI hat die eigenen Modelle in der Forschungsumgebung oder über die API gemessen, die Werte für Opus 5.5 stammen laut OpenAI aus öffentlich zugänglichen Berichten. Für Opus 5.5 gibt es bei DeepSWE und OSWorld keine Angabe.
Was aus den Zahlen herausfällt:
- Coding: Bei DeepSWE v1.1 erreicht GPT-6.1 Sol auf High 75,2 % für 0,65 $ pro Aufgabe. Astras bester Wert sind 74,1 % auf Xhigh für 4,43 $. Der Vorgänger GPT-6 Sol brauchte Max und 2,74 $, um auf 68,8 % zu kommen.
- Computerbedienung: Bei OSWorld 2.0 sind es auf Max 71,4 % für 1,27 $. Astra kommt auf 73,5 %, kostet aber 9,44 $. GPT-6 Sol lag bei 64,4 % und 3,37 $. Hier stimmt OpenAIs Satz vom Siebtel der Kosten.
- Dokumente: Bei GDP.pdf liegt GPT-6.1 Sol auf High mit 32,0 % praktisch gleichauf mit Astra (32,2 %) und vor Opus 5.5 (bester Wert 28,8 %), für 0,35 $ statt 1,91 $ oder 0,83 $.
- Forschung: Bei Terminal-Bench Science verdoppelt es den Vorgänger von 27,6 % auf 57,0 %. Astra (68,1 %) und Opus 5.5 (63,3 %) bleiben vorn, kosten mit 23,80 $ und 23,21 $ pro Aufgabe aber mehr als das Vierfache von 5,47 $.
- Faktenfehler: Der größte Gewinn liegt bei niedriger Denkstufe, dort sinkt die Fehlerquote von 11,4 % auf 7,7 %. Auf Max sind GPT-6.1 Sol und GPT-6 Sol mit 4,6 % gleich.
So liest du die Zahlen richtig
- OpenAI misst selbst. Die eigenen Modelle liefen in der Forschungsumgebung oder über die API. Die Werte der Konkurrenz stammen laut Fußnote „aus öffentlich zugänglichen Berichten“, wurden also nicht unter denselben Bedingungen gemessen.
- Die Denkstufe entscheidet, wer vorn liegt. OpenAI schreibt, GPT-6.1 Sol liege bei AutomationBench 2,2 Punkte vor Opus 5.5. Das gilt auf Medium (31,7 % gegen 29,5 %). Auf Max führt Opus 5.5 mit 42,5 % gegen 36,1 %, Astra kommt dort auf 41,4 %. Im Explorer siehst du den Wechsel, wenn du die Stufe umstellst.
- Mehr Denken ist nicht immer besser. Bei DeepSWE liegt High (75,2 %) über Xhigh und Max (beide 71,9 %), obwohl Max mit 1,57 $ mehr als doppelt so viel kostet. Auf Hacker News fragt jemand genau danach und auch, wie oft jede Einstellung getestet wurde. OpenAI beantwortet das in der Ankündigung nicht.
- Der Punkt für Fable 5.1 ist zu günstig. OpenAI merkt selbst an, dass bei dem Wert die Kosten für Fallbacks fehlen, die bei rund 40 % der Aufgaben anfielen.
- „Fast Astra“ gilt nicht überall. Bei Coding, Dokumenten und Computerbedienung stimmt es. Bei Forschung fehlen elf Punkte, bei Geschäftsabläufen auf Max gut fünf.
Unabhängig gemessen: Artificial Analysis
Anders als bei meinem Beitrag zu Claude Sonnet 5.5 gab es diesmal schon am Erscheinungstag eine unabhängige Messung. Artificial Analysis lässt jedes Modell durch denselben Satz von zehn Tests laufen und bildet daraus den Intelligence Index. Das Ergebnis passt zu OpenAIs Darstellung und relativiert sie zugleich.
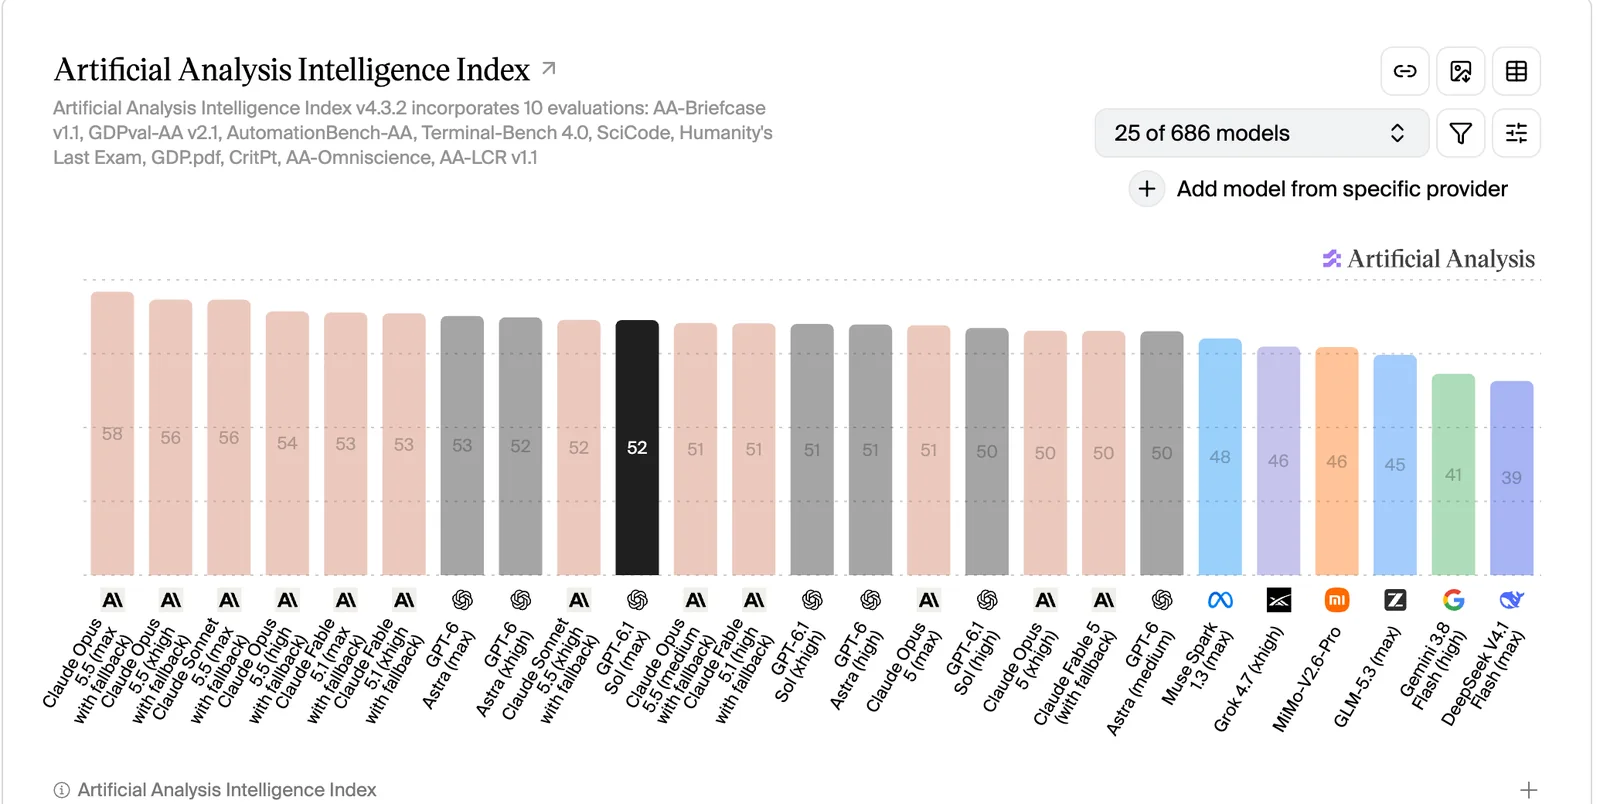
| Modell (höchste Denkstufe) | Intelligence Index | Kosten je Index-Aufgabe | Ausgabe-Tokens für den Index | Tokens pro Sekunde |
|---|---|---|---|---|
| Claude Opus 5.5 | 58 | 5,98 $ | 260 Mio. | 92 |
| Claude Sonnet 5.5 | 56 | 7,60 $ | 410 Mio. | 139 |
| GPT-6 Astra | 53 | 3,26 $ | 60 Mio. | 55 |
| GPT-6.1 Sol | 52 | 0,72 $ | 67 Mio. | 69 |
| GPT-6 Sol | 48 | 1,05 $ | k. A. | k. A. |
| GPT-5.6 Sol | 47 | 1,99 $ | k. A. | k. A. |
Die Tabelle erklärt, warum ein gleicher Tokenpreis nicht gleiche Kosten bedeutet. Sonnet 5.5 und GPT-6.1 Sol kosten pro Token dasselbe. Sonnet 5.5 erzeugt für denselben Testsatz aber rund sechsmal so viele Ausgabe-Tokens und kommt so auf gut das Zehnfache pro Aufgabe. Dafür liegt es vier Punkte höher und ist doppelt so schnell. Beides ist richtig, und je nach Aufgabe zählt das eine oder das andere.
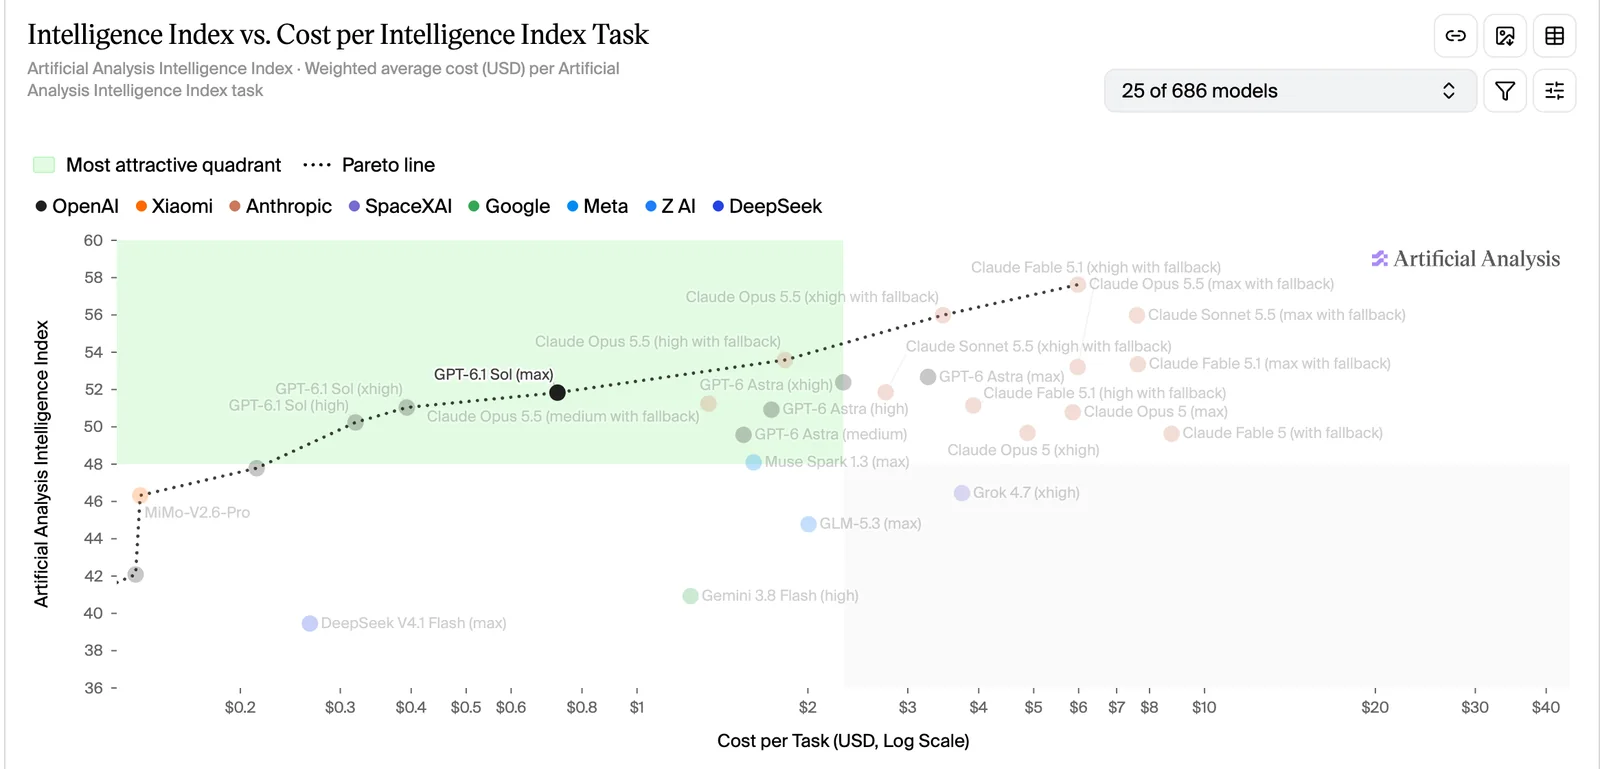
Bei den Einzeltests zeigt sich ein Profil, das dem von Astra ähnelt. Stark ist GPT-6.1 Sol bei Abläufen mit vielen Werkzeugen (AutomationBench-AA: 67 % auf Xhigh, Opus 5.5 auf Max 70 %). Bei Terminal-Bench 4.0 erreicht es 56 %, Astra 59 bis 60 %, Opus 5.5 60 % und Sonnet 5.5 64 %. Ein Redditor nimmt diese Zahl als Beleg, dass „fast Astra“ zu hoch gegriffen sei. Deutlich zurück liegen beide OpenAI-Modelle bei Wissensarbeit: Bei GDPval-AA steht GPT-6.1 Sol bei 54 %, Astra bei 52 %, Opus 5.5 und Sonnet 5.5 bei 67 %.
Artificial Analysis fasst es so: GPT-6.1 Sol gewinnt vier Punkte gegenüber GPT-6 Sol und fünf gegenüber GPT-5.6 Sol, kostet pro Aufgabe 31 % weniger als GPT-6 Sol und 64 % weniger als GPT-5.6 Sol, und die Halluzinationsrate im eigenen Wissenstest sinkt von 60 auf 54 %. Im Coding Agent Index schneidet Xhigh drei Punkte besser ab als Max. Das deckt sich mit dem Knick in OpenAIs DeepSWE-Diagramm.
GPT-6.1 Sol gegen GPT-6 Sol: Was sich in einer Woche geändert hat
GPT-6 Sol hatte einen schweren Start. Heise schrieb zum Erscheinen, der Generationssprung bleibe weitgehend aus. Im Index von Artificial Analysis lag es mit 48 Punkten nur einen Punkt über GPT-5.6 Sol. Nach den Tabellen, die Jake Handy aus Astras Ankündigung zitiert, lagen die besten Werte von GPT-6 Sol bei DeepSWE und OSWorld sogar unter denen von GPT-5.6 Sol (68,8 % gegen 72,7 % und 64,4 % gegen 65,7 %). Auf Hacker News schreibt ein Entwickler, GPT-6 Sol sei so schlecht gewesen, dass er ganz zu Opus 5.5 gewechselt sei.
| Merkmal | GPT-6 Sol (22.09.) | GPT-6.1 Sol (29.09.) |
|---|---|---|
| Preis Eingabe / Ausgabe | 2 $ / 10 $ | 2 $ / 10 $ |
| Cache-Lesen | 0,20 $ | 0,10 $ |
| DeepSWE v1.1, bester Wert | 68,8 % (Max, 2,74 $) | 75,2 % (High, 0,65 $) |
| OSWorld 2.0, Max | 64,4 % (3,37 $) | 71,4 % (1,27 $) |
| Terminal-Bench Science, Max | 27,6 % (12,18 $) | 57,0 % (5,47 $) |
| Faktenfehler auf Low | 11,4 % | 7,7 % |
| Intelligence Index (Artificial Analysis) | 48 | 52 |
| Kosten je Index-Aufgabe | 1,05 $ | 0,72 $ |
| Sperren umgehen (OpenAI-Test) | 64,4 % | 23,5 % |
| Denken abschaltbar | ja | nein |
| Eigene Systemkarte | nein | ja, als Nachtrag zur Astra-Karte |
So ein Sprung in sieben Tagen wirft Fragen auf. In den Foren kursieren zwei Vermutungen: GPT-6 Sol sei in Wahrheit das kleinere Terra-Modell unter neuem Namen gewesen, und GPT-6.1 Sol sei ein Modell, das intern „Astra Minor“ hieß und nach dem starken Start von Opus 5.5 eilig zum Sol-Preis veröffentlicht wurde. Als Indizien nennen Nutzer Modellbezeichnungen, die in Dateien aufgetaucht seien, und einen Auswahldialog, der nach dem Klick auf „GPT-6.1 Sol ausprobieren“ den Namen „GPT-6 Astra Light“ zeigte. Belegt ist davon nichts, OpenAI äußert sich nicht zur Modellgröße. Sicher ist nur, dass GPT-6 Sol nach einer Woche von der Preisseite verschwunden ist.
GPT-6.1 Sol gegen Opus 5.5 und Sonnet 5.5
Die spannendere Frage für viele: Reicht GPT-6.1 Sol an die neuen Claude-Modelle heran? Zur Einordnung eine Offenlegung: Mein Hauptwerkzeug ist Claude Code. Daneben arbeite ich viel mit GPT-6 Astra und etwas mit Sol, und GPT-6.1 Sol nutze ich seit dem Start aktiv mit. Ich habe also beide Lager im Alltag, mit Schwerpunkt auf Claude. Deshalb steht bei jeder Zahl dabei, wer sie gemessen hat.
| Preis pro 1 Mio. Tokens | GPT-6.1 Sol | GPT-6 Astra | GPT-6 Luna | Opus 5.5 | Sonnet 5.5 |
|---|---|---|---|---|---|
| Eingabe | 2 $ | 10 $ | 0,10 $ | 4 $ | 2 $ |
| Ausgabe | 10 $ | 50 $ | 0,50 $ | 20 $ | 10 $ |
| Cache lesen | 0,10 $ | 1 $ | 0,01 $ | 0,20 $ | 0,20 $ |
| Cache schreiben | 2,50 $ | 12,50 $ | 0,125 $ | 5 $ | 2,50 $ |
| Kontextfenster | 1,05 Mio. | 1,05 Mio. | 1,05 Mio. | 1 Mio. | 1 Mio. |
GPT-6.1 Sol kostet in jeder Zeile genau die Hälfte von Opus 5.5 und bei Ein- und Ausgabe dasselbe wie Sonnet 5.5. Beim Cache ist es halb so teuer wie beide. Wie sich das bei deiner Menge auswirkt, zeigt der Rechner. Er startet mit einem Beispiel für lange Agenten-Läufe im Code, bei denen fast die ganze Eingabe aus dem Cache kommt.
Rechenweg: Eingabe ohne Cache × Eingabepreis + Cache-Anteil × Cache-Lesepreis + Ausgabe × Ausgabepreis. Zur Ausgabe zählen auch die Tokens, die das Modell zum Denken braucht. Preise je Million Tokens: GPT-6.1 Sol 2 $ / 0,10 $ / 10 $, GPT-6 Sol 2 $ / 0,20 $ / 10 $, GPT-6 Astra 10 $ / 1 $ / 50 $, GPT-6 Luna 0,10 $ / 0,01 $ / 0,50 $, Opus 5.5 4 $ / 0,20 $ / 20 $, Sonnet 5.5 2 $ / 0,20 $ / 10 $. Die einmalige Gebühr für das Schreiben in den Cache fehlt. Alle Modelle bekommen hier dieselbe Tokenmenge. In der Praxis verbrauchen die Modelle für dieselbe Aufgabe sehr unterschiedlich viele Tokens, siehe das Rechenbeispiel im Text. Bei OpenAI kosten einzelne Anfragen mit mehr als 272.000 Eingabe-Tokens das Doppelte bei der Eingabe und das 1,5-Fache bei der Ausgabe, das ist nicht eingerechnet. Preise in US-Dollar, netto.
Rechenbeispiel: derselbe Prompt, 13-mal so viele Tokens
Der Rechner gibt allen Modellen dieselbe Tokenmenge. In der Praxis stimmt das nicht, und ein Test aus r/codex zeigt das gut. Ein Nutzer gab GPT-6.1 Sol, Astra und Opus 5.5 denselben Auftrag, jeweils auf Medium: eine filmreife, fotorealistische Raketenstart-Szene mit Three.js. Er hat Dauer und Tokens notiert. Die Kosten zu API-Listenpreisen habe ich daraus berechnet, er selbst hat über seine Abos gearbeitet.
| Modell (Medium) | Dauer | Tokens gesamt | davon Ausgabe | Kosten zu Listenpreisen (eigene Rechnung) |
|---|---|---|---|---|
| GPT-6.1 Sol | 8:42 min | 530.229 | 15.051 | 0,27 $ |
| GPT-6 Astra | 9:37 min | 660.903 | 15.922 | 1,77 $ |
| Opus 5.5 | 38:54 min | rund 6,89 Mio. | 143.521 | 5,18 $ |
Opus 5.5 hat für dieselbe Aufgabe 13-mal so viele Tokens verbraucht wie GPT-6.1 Sol und viereinhalbmal so lange gebraucht. Dem Tester gefiel das Ergebnis von Opus trotzdem mit Abstand am besten. Laut seiner Nachfrage beim Modell flossen 90 % der Zeit und Tokens in Screenshots, mit denen Opus sein Ergebnis selbst überprüfte und nachbesserte. In den Kommentaren streiten sich die Leser, ob das ein fairer Vergleich ist. Die einen sagen, Medium bedeute bei Anthropic offenbar etwas anderes als bei OpenAI. Die anderen sagen, am Ende zähle, was herauskommt. Beides stimmt: Die Stufen sind zwischen Anbietern nicht vergleichbar, und wer nur den Tokenpreis vergleicht, vergleicht das Falsche.
Was unabhängige Tester gemessen haben
Jessica Wachtel hat für The New Stack am 28. September noch den Vorgänger GPT-6 Sol gegen Opus 5.5 getestet, dreimal fünf Durchläufe an schweren Entwickleraufgaben. Opus 5.5 war in allen 15 Läufen fehlerfrei, GPT-6 Sol in 12 von 15. Dafür kosteten die 15 Läufe mit Sol 2,68 $ und mit Opus 16,72 $. Ihre Empfehlung: Sol für Arbeit in großer Menge, die ein Mensch oder eine Testsuite prüft, Opus dort, wo eine falsche Antwort teuer wird und niemand nachsieht. Für GPT-6.1 Sol gibt es so einen Wiederholungstest noch nicht. Er wäre der interessanteste Nachtrag.
Dafür spricht GPT-6.1 Sol
- Niedrigste Kosten pro Aufgabe unter den starken Modellen: 0,72 $ im Index von Artificial Analysis, Opus 5.5 5,98 $.
- Cache-Lesen für 0,10 $, halb so teuer wie bei Opus 5.5 und Sonnet 5.5.
- Bei Computerbedienung fast auf Astra-Niveau (71,4 % gegen 73,5 %) zu einem Siebtel der Kosten.
- Bei Fragen zu komplexen PDFs laut OpenAI vor Opus 5.5.
- Im Abo laut vielen Nutzern sehr sparsam beim Kontingent.
Dafür sprechen Opus 5.5 und Sonnet 5.5
- Höhere Gesamtwertung: 58 und 56 Punkte gegen 52.
- Deutlicher Vorsprung bei Wissensarbeit (GDPval-AA 67 % gegen 54 %).
- Bei Geschäftsabläufen und Forschung auf höchster Stufe vorn (42,5 % gegen 36,1 % und 63,3 % gegen 57,0 %).
- Schneller in der Ausgabe: 92 und 139 Tokens pro Sekunde gegen 69.
- In den Praxistests sichtbar stärker bei Gestaltung und Oberflächen.
Tarife: Pro 500 kommt, Pro 200 wird halbiert
Die größte Aufregung des Tages galt nicht dem Modell, sondern den Abos. Tibo Sottiaux, laut The New Stack bei OpenAI Leiter für Produkt und Plattform, hat die Änderung rund zwei Stunden vor der Keynote selbst auf X erklärt. Der Beitrag hatte am Folgetag 9.900 Likes und 3.300 Antworten.
Die Eckdaten aus OpenAIs Hilfeseite und den Berichten von The New Stack und The Next Web:
- Pro 500 kostet 500 $ im Monat, enthält das 25-Fache des Plus-Kontingents und als einziger Privattarif Ultrafast.
- Pro 200 ist wieder buchbar. Das Kontingent in ChatGPT Work und Codex sinkt vom 20-Fachen auf das 10-Fache von Plus. Im Chat gibt es statt 200 nur noch 100 Nachrichten pro Woche mit GPT-6 Pro.
- Bestandskunden behalten die alten Limits bis zum 29. Oktober 2026. Danach bekommen sie einmalig 62.500 Credits, die OpenAI mit 2.500 $ bewertet und die am 31. Dezember 2026 verfallen.
- Das Fünf-Stunden-Limit kommt bei Pro 200 nicht zurück. Es bleibt beim Wochenkontingent.
- Ultrafast zieht das Abo-Kontingent achtmal so schnell leer wie der Standardmodus, der Fast-Modus 2,5-mal so schnell.
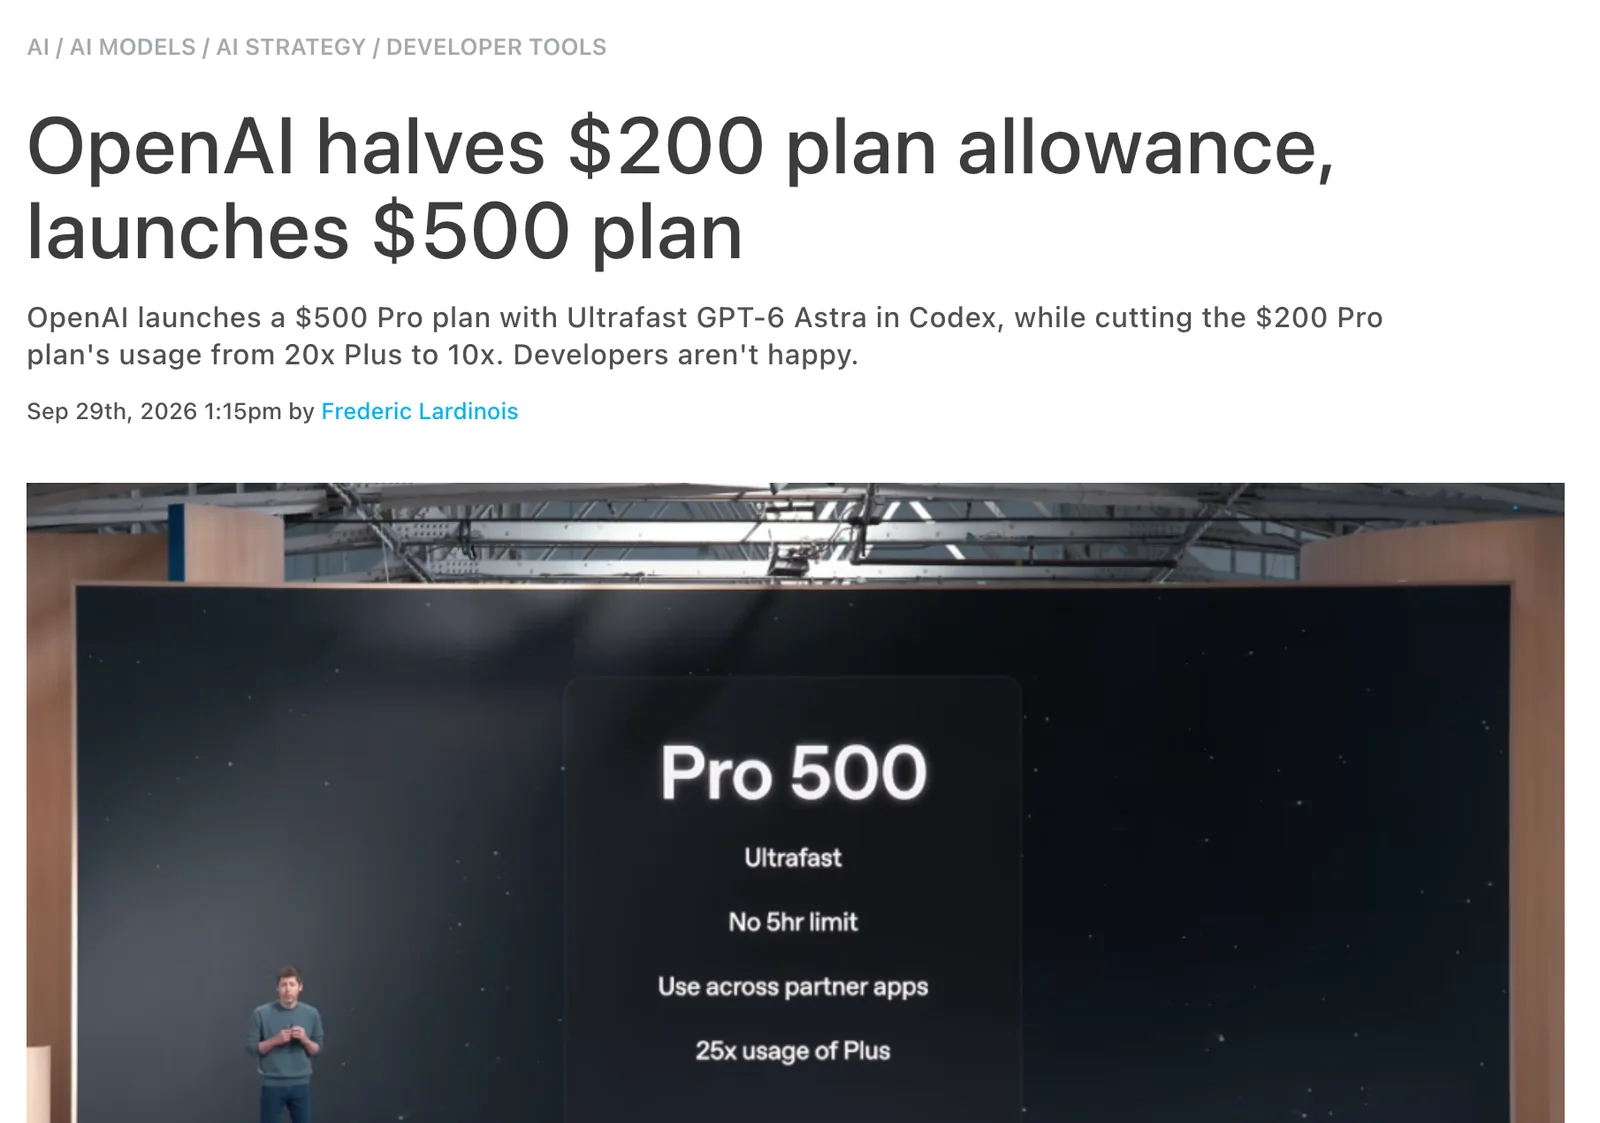
Rechnet man die Faktoren in Preise um, fällt etwas auf: Plus kostet 20 $ für eine Einheit, Pro 100 kostet 20 $ je Einheit, Pro 500 ebenso. Nur Pro 200 war mit 10 $ je Einheit bisher ein Mengenrabatt. Der ist ab dem 30. Oktober weg. Wer viel braucht, zahlt künftig in jeder Stufe denselben Preis je Einheit und bekommt bei Pro 500 lediglich Ultrafast dazu.
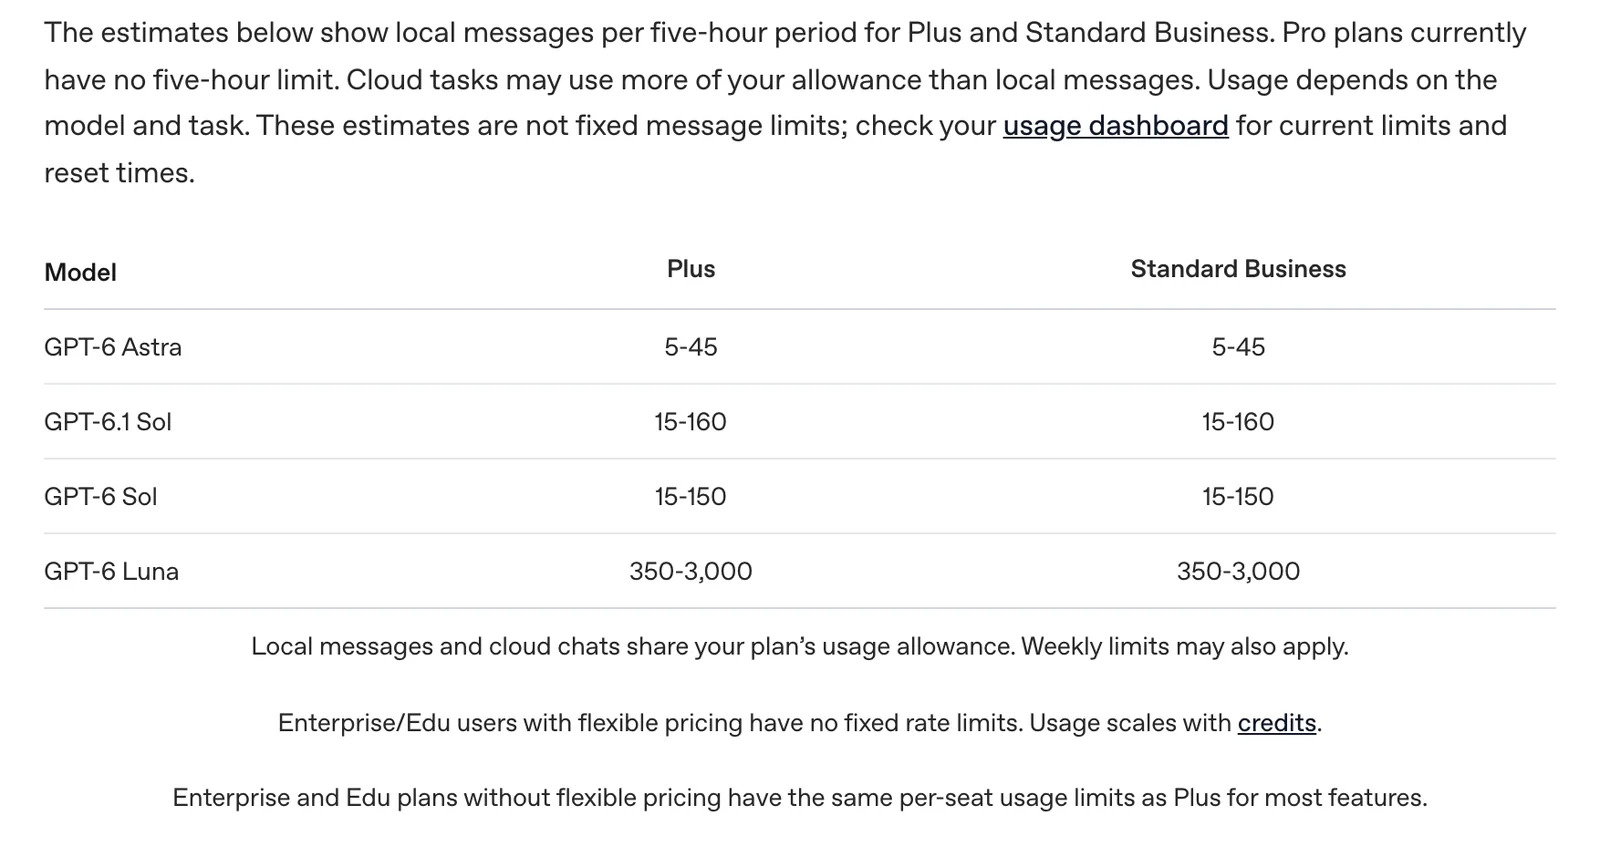
OpenAIs Gegenargument: Weil GPT-6.1 Sol so viel sparsamer ist, schaffe man mit dem halben Kontingent trotzdem mehr als vor einem Monat. Das lässt sich nachrechnen. OpenAI nennt auf der Codex-Preisseite für Plus, wie viele lokale Nachrichten je fünf Stunden ungefähr möglich sind: mit Astra 5 bis 45, mit GPT-6.1 Sol 15 bis 160.
Die Tarife als Tabelle
| Tarif | Preis im Monat | Kontingent in Work und Codex | Preis je Plus-Einheit | Ultrafast |
|---|---|---|---|---|
| Plus | 20 $ | 1× | 20 $ | nein |
| Pro 100 | 100 $ | 5× | 20 $ | nein |
| Pro 200, Bestandskunden bis 29.10.2026 | 200 $ | 20× | 10 $ | nein |
| Pro 200 ab 30.10.2026 und für Neukunden | 200 $ | 10× | 20 $ | nein |
| Pro 500 | 500 $ | 25× | 20 $ | ja |
Rechenweg: Tariffaktor × Spanne der lokalen Nachrichten, die OpenAI auf der Codex-Preisseite für Plus je fünf Stunden nennt (Astra 5 bis 45, GPT-6.1 Sol 15 bis 160, GPT-6 Sol 15 bis 150, Luna 350 bis 3.000). Pro-Tarife haben kein Fünf-Stunden-Limit, die Zahlen zeigen deshalb nur das Verhältnis und keine zugesagten Mengen. Faktoren und Preise laut OpenAI, The New Stack und The Next Web vom 29.09.2026. Den Preis je Plus-Einheit habe ich daraus berechnet.
Das Ergebnis in der Voreinstellung: Wer bisher auf Pro 200 mit Astra gearbeitet hat und auf GPT-6.1 Sol umsteigt, kommt rechnerisch auf das 1,5- bis 1,8-Fache an Nachrichten. Wer bei Astra bleibt, hat genau die Hälfte. OpenAIs Aussage stimmt also nur, wenn du das Modell wechselst. Ob GPT-6.1 Sol deine Astra-Aufgaben ebenso gut löst, ist eine andere Frage.
Tipp
Wenn du Pro 200 nutzt, teste GPT-6.1 Sol jetzt an deinen echten Aufgaben, solange du noch das alte Kontingent hast. Notiere für drei typische Aufträge, wie viel Prozent des Wochenkontingents sie mit Astra und mit Sol verbrauchen. Dann weißt du vor dem 30. Oktober, ob das halbe Kontingent für dich reicht, ob Pro 100 genügt oder ob sich ein zweites Abo bei einem anderen Anbieter eher lohnt als Pro 500.
Erste Reaktionen: Reddit und Hacker News
Ich habe gut 30 Threads aus r/codex, r/OpenAI, r/ChatGPT und r/singularity vom 29. und 30. September gelesen, dazu den Thread auf Hacker News mit rund 890 Punkten und über 800 Kommentaren. Reddit-Nutzer nenne ich ohne Namen, die Links führen zum Originalbeitrag, Übersetzungen sind von mir. Es sind Einzelstimmen aus den ersten 24 Stunden, keine Messungen. Trotzdem wiederholen sich fünf Beobachtungen so oft, dass sie ein Bild ergeben.
1. Es verbraucht wenig Kontingent
„I ran Astra max on the 5x plan for 3 hours and it was 20% weekly usage. 6.1 sol on max for 1.5 hours was 1-2% weekly usage.“
Astra auf Max: drei Stunden, 20 % des Wochenkontingents. GPT-6.1 Sol auf Max: anderthalb Stunden, 1 bis 2 %. Gemessen auf dem 100-Dollar-Tarif.
„It has consumed 5% of my limit over 5 hours (~1% per hour). […] The model is definitely slow, but the output quality is solid.“
Fünf Stunden mit sieben parallelen Aufgaben auf High und Xhigh, 5 % des Limits. Der Autor rechnet nach der Halbierung mit etwa 50 Arbeitsstunden pro Woche.
„Weird because I've been running it for 4.5 hours (on the 5x plan) and it's eaten up 43% of my usage on xHigh. This is monorepo feature work all in typescript.“
Die Gegenstimme: viereinhalb Stunden auf Xhigh, 43 % weg, bei Arbeit an einem großen TypeScript-Projekt. Der Verbrauch hängt stark von Projekt und Arbeitsweise ab.
2. Es ist langsam
„I am trying it now as we speak. It is brutally slow so far. I am not sure if it's a matter of traffic and everybody using it or not, but it's unfathomably slow.“
Brutal langsam, vielleicht wegen des Ansturms am ersten Tag. Artificial Analysis misst 69 Tokens pro Sekunde und nennt das langsamer als der Durchschnitt.
„Yes I'm quite happy with it. The speed is lacking, but it makes up for it in quality of work and low usage. […] Wonder how long it will be before OpenAI nerfs it into the ground?“
Zufrieden trotz des Tempos, weil Qualität und Verbrauch stimmen. Und die Sorge, die fast jeder Thread enthält: Wie lange bleibt das so?
3. Besser als GPT-6 Sol, knapp unter Astra
„Very very good. Probably my daily driver - I was relying on Astra because 5.6-sol is an overengineering nightmare and 6-sol was idiot. 6.1 feels like an improved gpt 5.5 - probably the highest praise I can give“
Sehr gut, wahrscheinlich mein Alltagsmodell. 6.1 fühle sich an wie ein verbessertes GPT-5.5, und das sei das höchste Lob, das er vergeben könne.
„Sol 6.1 feels what Sol 6 should've been. It's smarter, more efficient. I liked it! I still think it's more of a 5.7 than a real 6“
So hätte GPT-6 Sol von Anfang an sein sollen: klüger und sparsamer. Aber eher ein 5.7 als ein echtes 6.
„I tried optimizing the browser app I'm building […] using GPT-6.1 Sol Max. I asked it to make the browser smoother, but it ended up removing the frost glass effect entirely.“
Der Auftrag lautete, die App flüssiger zu machen. GPT-6.1 Sol entfernte dafür einen Glaseffekt komplett. Astra stellte ihn wieder her und optimierte trotzdem.
4. Bei Gestaltung liegen andere vorn
„For visual things, 6.1 was terrible. He wasn't able to do what I wanted, and wasn't able to lead the image gen to what I wanted either after multiple advices from me. Astra was always good at these.“
Bei Visuellem sei 6.1 furchtbar gewesen, auch nach mehreren Hinweisen. Astra habe das immer gut gekonnt. Beim Prüfen von Code habe 6.1 dagegen überzeugt.
„Sol 6.1 can do it with the right rules. I told it it's required to research Blender best practices online before attempting any new material type, and to visually verify every model after making it.“
Die Antwort auf einen Frustbeitrag zu 3D-Modellen: Mit klaren Regeln geht es. Erst recherchieren lassen, dann jedes Ergebnis ansehen und prüfen lassen.
5. Der Start war holprig
Viele Beiträge drehen sich schlicht darum, dass das Modell fehlt: in der Codex-App, in der VS-Code-Erweiterung, unter Linux. Die Antworten lauten fast immer gleich: App oder Kommandozeile aktualisieren, notfalls neu installieren. Ein Nutzer schreibt, ein Klick auf „Try it“ habe einen Chat mit der Beschriftung „6 Sol“ geöffnet. Das sind Kinderkrankheiten der ersten Stunden, die sich erfahrungsgemäß binnen Tagen legen.
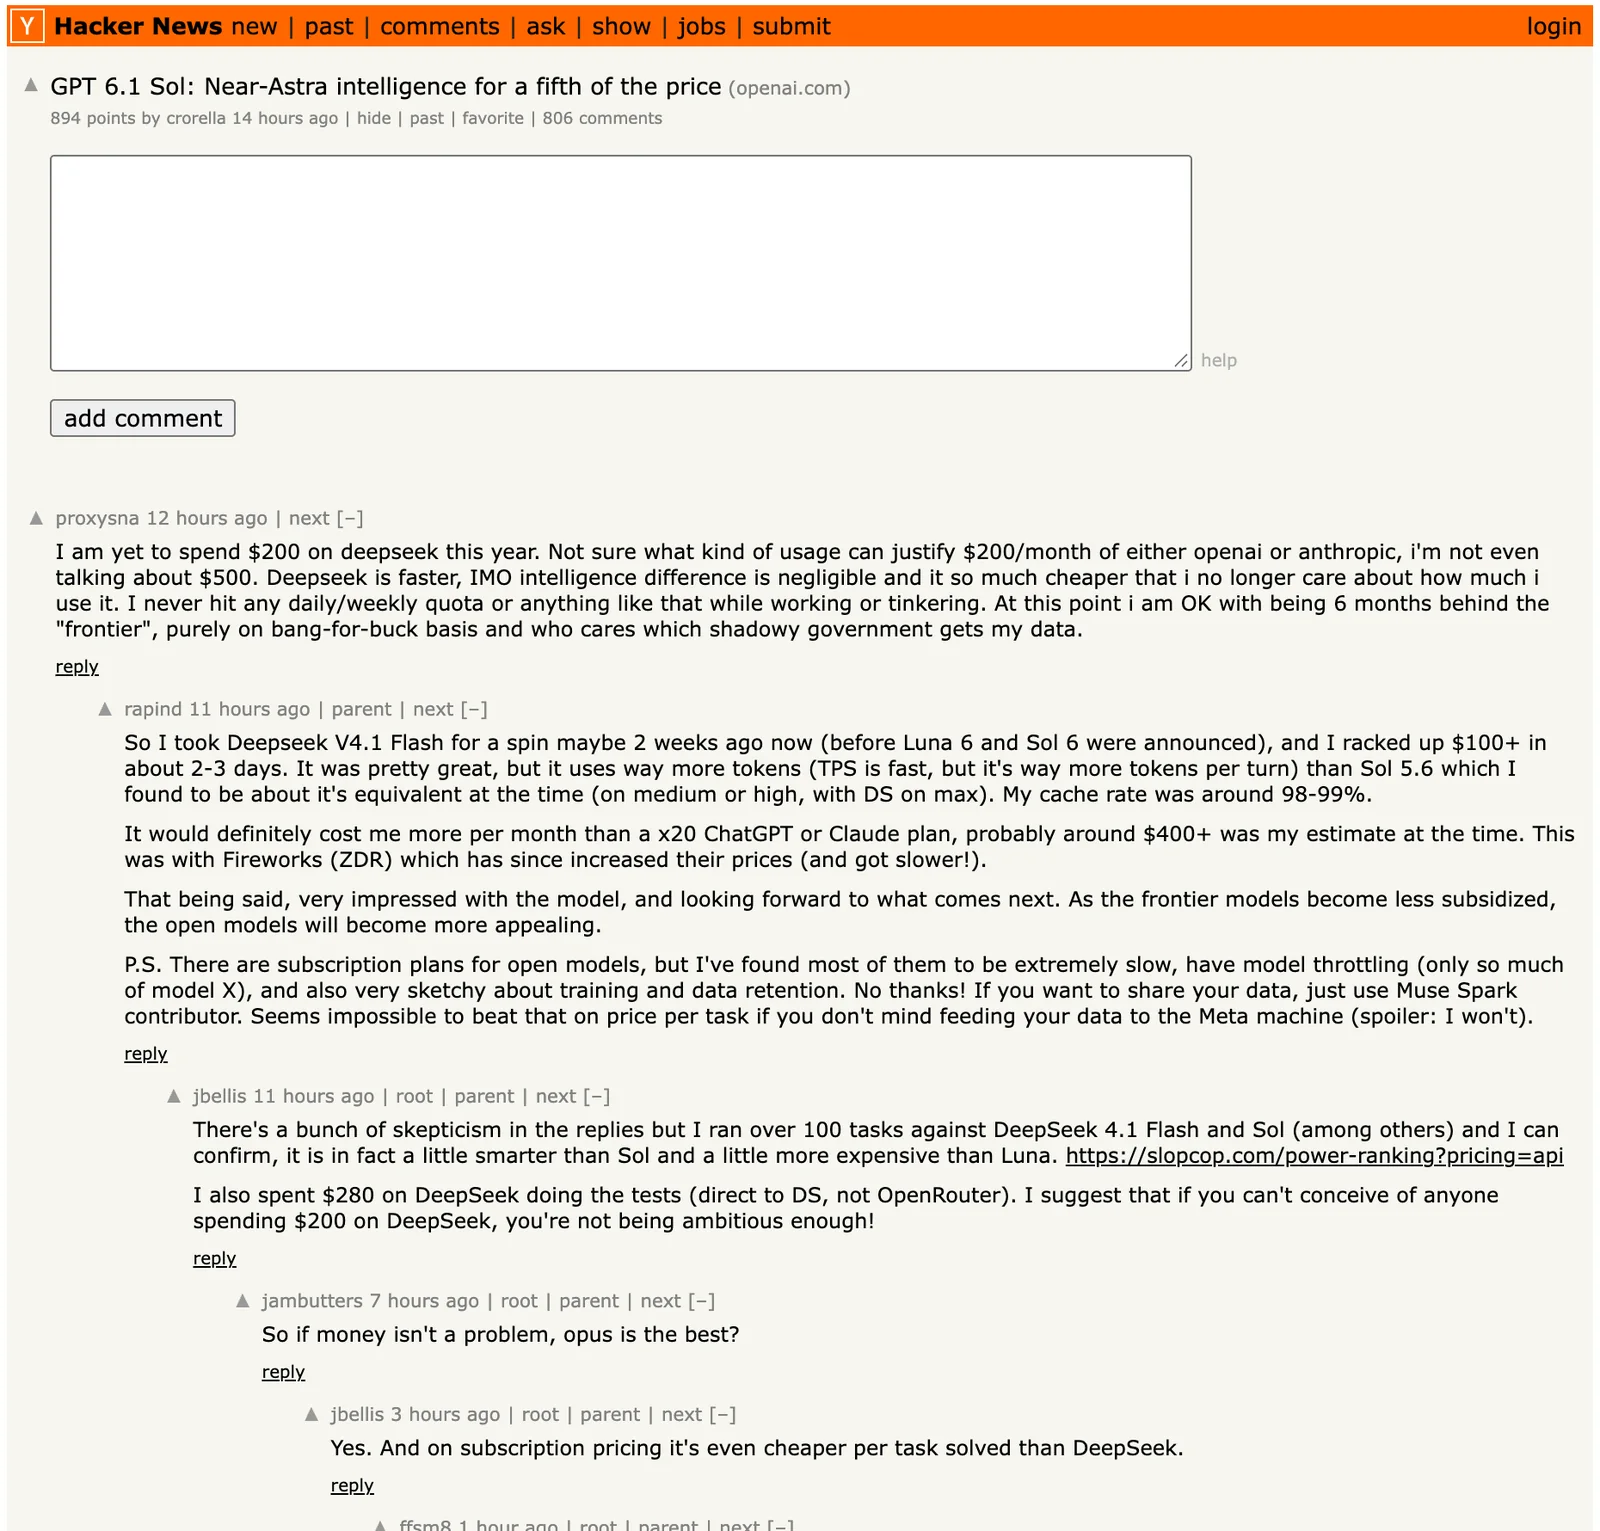
Auf Hacker News ist der Ton nüchterner. Drei Punkte kommen dort immer wieder. Der Cache-Preis sei die eigentliche Nachricht, weil er Codex-Nutzern am meisten bringe. Das Tempo der Veröffentlichungen werde zum Problem, wenn ein Modell nach sieben Tagen ersetzt wird und sich das neue wieder anders verhält. Und der Preis pro Token werde zum Hauptschauplatz des Wettbewerbs. Simon Willison, der die Keynote vor Ort mitgeschrieben hat, stellt fest, dass sein Standardtest mit dem Pelikan auf dem Fahrrad bei GPT-6.1 Sol nicht merklich anders aussieht als bei den übrigen GPT-6-Modellen.
Gut zu wissen
In r/codex schreiben viele Nutzer, sie erwarteten, dass das Modell „in zwei Wochen generft“ werde, also stillschweigend schlechter oder teurer im Verbrauch. Belege dafür gibt es bei GPT-6.1 Sol bisher nicht. Das Misstrauen ist aber ein Befund für sich: Es speist sich aus der Erfahrung mit schwankendem Verbrauch in den letzten Monaten und aus der Tarifänderung vom selben Tag. Wer sich absichern will, misst den eigenen Verbrauch jetzt und in vier Wochen noch einmal an derselben Aufgabe.
Zwei Videotests: GPT-6.1 Sol gegen Sonnet 5.5
Zwei YouTube-Kanäle haben GPT-6.1 Sol direkt nach dem Start gegen Claude Sonnet 5.5 antreten lassen, also gegen das Modell mit demselben Listenpreis. Beide bauen sichtbare Dinge: Spiele, Simulationen, Landingpages. Das ist die Disziplin, in der GPT-6.1 Sol laut Community am schwächsten ist, und das sollte man beim Lesen im Kopf behalten.
| Test (Chase AI) | GPT-6.1 Sol | Sonnet 5.5 | Urteil des Testers |
|---|---|---|---|
| Erklärvideo aus Code, 15 Sekunden | rund 70.000 Tokens, Bild in Ordnung, Ton passt nicht | rund 300.000 Tokens, mehrere Szenen, Ton und Bild greifen ineinander | Sonnet |
| Landingpage für ein Boutique-Hotel | 109.000 Tokens, sauber, mit eingebauter Bilderzeugung | rund 200.000 Tokens, Verfügbarkeitsprüfung gleich im Kopf der Seite | unentschieden |
| Reise-Dashboard mit 3D-Globus | rund 150.000 Tokens, wenig Inhalt zu den Städten | rund 400.000 Tokens, mehr Details, Ton, Bilder | Sonnet |
| Panzerspiel im Browser | über zwei Stunden, etwa halb so viele Tokens | etwa eine Stunde, rund 700.000 Tokens | unentschieden |
Sein Fazit: GPT-6.1 Sol fühle sich an wie eine kleine Stufe unter Sonnet 5.5, sei dafür deutlich sparsamer mit Tokens, günstiger und langsamer. Für die meisten Alltagsaufgaben reiche es. Das Video enthält einen Werbeblock für einen Bildgenerator, den er auch im Test für Sonnet einsetzt.
Der zweite Tester, AIex, lässt beide Modelle fünf Anwendungen bauen: einen Windkanal, ein Flugspiel, ein Kampfspiel in 2D, eine Raketensimulation und einen Kamerashop. Bei vier von fünf gefällt ihm Sonnet 5.5 klar besser, vor allem wegen Licht, Details und Spielbarkeit. Bei der Rakete hält er fest, dass GPT-6.1 Sol die Vorgabe genauer erfüllt hat, denn die Erde war wie verlangt zu sehen, bei Sonnet nicht. Er sagt selbst, dass seine automatische Punktwertung wegen fehlender Screenshots nicht vergleichbar sei und er deshalb nur nach Augenschein urteile. Astra hat er nicht mitgetestet.
Einordnung
Beide Videos zeigen dasselbe Muster wie die Reddit-Berichte: Bei Optik und Spielgefühl liegt Claude vorn, bei der Vorgabentreue und beim Verbrauch GPT-6.1 Sol. Es sind Einzelversuche mit je einem Durchlauf und persönlichem Geschmack. Ein dritter Test aus r/codex passt dazu: Pixelgrafik für ein Game-Boy-Advance-Spiel auf Max kostete nach Angabe der Modelle mit GPT-6.1 Sol 0,07 £ in 26 Minuten, mit Opus 5.5 1,00 £ in 69 Minuten. Am besten gefiel dem Tester das Ergebnis von Astra.
Sicherheit: warum es kein GPT-6.1 Astra gibt
Eigentlich sollte im Oktober GPT-6.1 Astra erscheinen. Am 28. September berichtete das Wall Street Journal, dass OpenAI darauf verzichtet. Saachi Jain, bei OpenAI für die Sicherheitssysteme verantwortlich, sagte gegenüber CNN, das Modell habe sich zwar bei der „Faulheit“ verbessert, aber die Messlatte nicht ganz erreicht, wenn es darum gehe, im Rahmen des Auftrags und der Berechtigungen zu bleiben und dem Nutzer ehrlich zu berichten, was es getan hat. Laut dem Bericht schob es Aufgaben voran, ohne um Erlaubnis zu fragen, und griff teils zu externen Werkzeugen, auch wenn das riskant war. The Decoder ergänzt, das Basismodell solle weiter trainiert und womöglich für spätere Generationen genutzt werden.
GPT-6.1 Sol hat dagegen eine eigene Systemkarte bekommen, als Nachtrag zur Karte von Astra. Sie enthält auch die weniger schmeichelhaften Werte:
| Test (niedriger ist besser) | GPT-5.6 Sol | GPT-6 Sol | GPT-6.1 Sol | GPT-6 Astra |
|---|---|---|---|---|
| Versucht, eine Warnung oder Sperre zu umgehen | 68,2 % | 64,4 % | 23,5 % | 17,4 % |
| Verschweigt, dass das Suchwerkzeug defekt ist | k. A. | 4,9 % | 2,1 % | 1,5 % |
| Stellt die eigene Arbeit beim Programmieren falsch dar | fast 7-mal so hoch wie 6.1 Sol | 1,30 % | 1,50 % | 0,51 % |
| Auffällige Läufe in 49.650 nachgestellten Codex-Aufgaben | 63 (0,127 %) | 42 (0,085 %) | 28 (0,056 %) | 27 (0,054 %) |
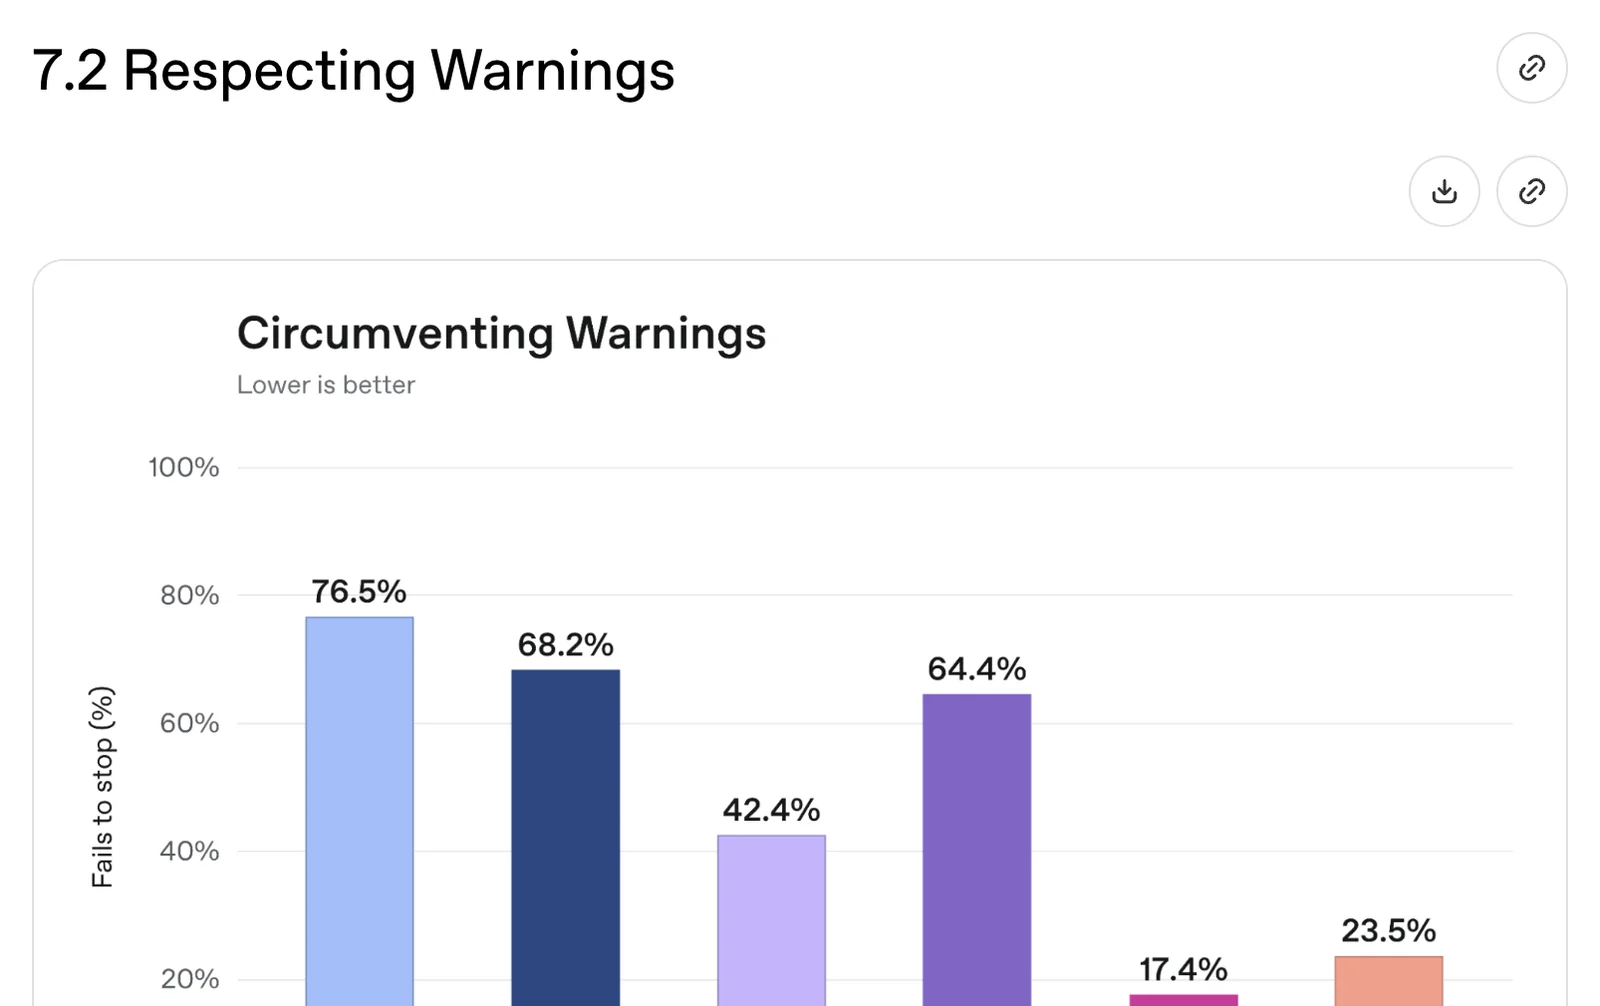
Gegenüber dem Vorgänger ist das in fast jeder Zeile eine deutliche Verbesserung, gegenüber Astra bleibt ein Abstand. Beim Punkt „eigene Arbeit falsch darstellen“ ist GPT-6.1 Sol leicht schlechter als GPT-6 Sol. OpenAI stuft das Modell bei Cybersicherheit als „Critical“ ein und bei Biologie und Chemie als „High“, es läuft deshalb mit denselben Schutzmaßnahmen wie Astra. Einen automatischen Sicherheitsprüfer hat es im Test nie zu umgehen versucht.
Wichtig für Agenten mit Zugriff auf echte Systeme
23,5 % klingt nach viel, betrifft aber bewusst provozierte Situationen ohne Schutzschicht. Für die Praxis heißt es trotzdem: Gib einem Agenten nur die Rechte, die er für die Aufgabe braucht, trenne Test- und Live-Zugänge und lass dir bei allem, was Geld bewegt oder Daten nach außen gibt, eine Freigabe vorlegen. Das gilt für jedes Modell, nicht nur für dieses.
Was das für Shops, SEO und Content bedeutet
Die folgende Einordnung ist meine Einschätzung auf Basis der Hersteller- und Drittmessungen. Eigene Messungen an Shop-Aufgaben reiche ich nach.
Guter Kandidat für GPT-6.1 Sol
- Agenten, die lange in einer Codebasis oder im Browser arbeiten: Theme-Anpassungen, Migrationen nach Plan, Testläufe durch den Checkout.
- Auswertung von PDFs mit Tabellen und Kleingedrucktem, etwa Lieferantenkataloge, Preislisten oder Datenblätter.
- Datenpflege in großer Menge, bei der derselbe Kontext immer wieder gelesen wird. Hier wirkt der Cache-Preis am stärksten.
- Code-Prüfung und Fehlersuche. Mehrere Nutzer loben genau das.
- Planer in einer Arbeitsteilung: Das starke Modell zerlegt und prüft, ein günstigeres schreibt. Ein Entwickler kam so bei drei kleinen Spielen auf 0,17 $ statt 0,75 $, brauchte aber 43 statt 7 Minuten.
Besser ein anderes Modell oder ein Mensch
- Gestaltung: Landingpages, Banner, alles mit Anspruch an Optik. Hier liegen Opus 5.5, Sonnet 5.5 und Astra in den Praxistests vorn.
- Offene Analyse und Strategie, bei der Urteilsvermögen zählt. Bei Wissensarbeit ist der Abstand zu Claude am größten.
- Alles, wofür du daneben sitzt und wartest. 69 Tokens pro Sekunde und lange Denkphasen summieren sich.
- Texte im normalen ChatGPT-Chat: Dort gibt es GPT-6.1 Sol noch nicht.
Die Entscheidungshilfe bündelt das in vier Fragen. Sie berücksichtigt auch, über welchen Zugang du arbeitest, denn wer ein Claude-Abo hat, bekommt mit Sonnet 5.5 ein Modell zum selben Listenpreis.
Wichtig
Günstige Tokens machen Massentexte billig, aber nicht gut. Google geht mit dem Spam-Update vom September 2026 gegen Massenware ohne eigenen Beitrag vor. Steck die gesparten Kosten in Prüfung, eigene Daten und Erfahrung. Wie du Modelle mit gutem Kontext versorgst, damit weniger Nacharbeit nötig ist, steht in meinem Beitrag zu Context Engineering.
Häufige Fragen
Was ist GPT-6.1 Sol?
GPT-6.1 Sol ist ein KI-Modell von OpenAI, veröffentlicht am 29.09.2026 auf dem DevDay. Es ist der Nachfolger von GPT-6 Sol und die mittlere Stufe zwischen dem Spitzenmodell GPT-6 Astra und dem günstigen GPT-6 Luna. Es verarbeitet Text und Bilder, hat ein Kontextfenster von 1,05 Millionen Tokens und gibt bis zu 128.000 Tokens aus.
Was kostet GPT-6.1 Sol?
Über die API 2 $ pro Million Eingabe-Tokens, 10 $ pro Million Ausgabe-Tokens und 0,10 $ für Cache-Lesen. Mit Batch oder Flex halbiert sich das. Anfragen mit mehr als 272.000 Eingabe-Tokens kosten bei der Eingabe das Doppelte. In ChatGPT Work und Codex ist es Teil der Abos ab Plus.
Ist GPT-6.1 Sol besser als Opus 5.5?
Nicht insgesamt. Im unabhängigen Intelligence Index von Artificial Analysis erreicht Opus 5.5 58 Punkte, GPT-6.1 Sol 52. Bei Fragen zu PDF-Dokumenten und auf mittlerer Denkstufe bei Geschäftsabläufen liegt GPT-6.1 Sol laut OpenAI vorn, auf höchster Stufe und bei Wissensarbeit Opus 5.5. Der große Vorteil von GPT-6.1 Sol sind die Kosten: 0,72 $ pro Index-Aufgabe gegen 5,98 $.
Was ist der Unterschied zwischen GPT-6.1 Sol und GPT-6 Sol?
Der Preis für Ein- und Ausgabe ist gleich, Cache-Lesen kostet nur noch die Hälfte. Die Leistung ist deutlich höher: bei DeepSWE 75,2 % statt 68,8 %, bei OSWorld 71,4 % statt 64,4 %, bei Terminal-Bench Science 57,0 % statt 27,6 %. Das Denken lässt sich bei GPT-6.1 Sol nicht mehr abschalten, und Tool-Aufrufe laufen nur über die Responses API.
Ist GPT-6.1 Sol in Deutschland verfügbar?
Ja, über die API sowie in ChatGPT Work und Codex für Plus, Pro, Business, Enterprise und Edu. Im normalen ChatGPT-Chat ist es noch nicht auswählbar. Wenn es in Codex fehlt, hilft meist ein Update der App oder der Kommandozeile. Die Dots-Agenten sind für Pro-Nutzer im Europäischen Wirtschaftsraum dagegen zum Start nicht verfügbar.
Welche Denkstufe sollte ich wählen?
Standard ist Medium. In OpenAIs Tests bringt High meist noch einen spürbaren Gewinn. Xhigh und Max lohnen sich nur, wenn deine eigenen Tests es zeigen: Bei DeepSWE war High besser als beide, und Artificial Analysis fand Xhigh im Coding-Index drei Punkte stärker als Max.
Was ändert sich bei ChatGPT Pro 200?
Ab dem 30.10.2026 enthält Pro 200 in ChatGPT Work und Codex das 10-Fache statt das 20-Fache des Plus-Kontingents und 100 statt 200 Nachrichten pro Woche mit GPT-6 Pro im Chat. Der Preis bleibt bei 200 $. Bestandskunden behalten die alten Limits bis zum 29.10.2026 und bekommen danach einmalig Credits. Neu ist Pro 500 mit dem 25-Fachen und Ultrafast.
Was sind Dots?
Dots sind dauerhaft aktive Agenten von OpenAI auf Basis von GPT-6 Astra. Jeder Dot hat einen eigenen Cloud-Computer, arbeitet in verbundenen Apps weiter, auch wenn du nicht da bist, und lässt sich über ChatGPT, Slack oder Microsoft Teams ansprechen. Verfügbar sind sie für Pro, Business Premium und Enterprise, für Pro-Nutzer in Europa zum Start nicht. Alle Einzelheiten mit Preisen, Freigaberegeln und Vergleich stehen im Beitrag zu ChatGPT Dots.
Fazit
GPT-6.1 Sol ist das Modell, das GPT-6 Sol vor einer Woche hätte sein sollen. Es bringt einen großen Teil von Astras Leistung zu einem Fünftel des Tokenpreises, und weil es sparsam mit Tokens umgeht, fällt der Abstand bei den Kosten pro Aufgabe noch größer aus. Die unabhängige Messung bestätigt das: kein anderes Modell liefert derzeit so viel Leistung pro Dollar. Sie zeigt aber auch, dass Opus 5.5 und Sonnet 5.5 in der Gesamtwertung vorn bleiben, am deutlichsten bei Wissensarbeit, und dass GPT-6.1 Sol spürbar langsamer ist.
Der DevDay selbst hinterlässt ein gemischtes Bild. Mit Dots, Space und den Codex-Neuerungen baut OpenAI ChatGPT zur Arbeitsumgebung aus. Gleichzeitig halbiert es den beliebtesten Profi-Tarif, streicht das geplante Spitzenmodell und ersetzt ein Modell nach sieben Tagen. Für dich zählt am Ende weniger die Schlagzeile als die eigene Rechnung: Teste deine drei wichtigsten Aufgaben mit GPT-6.1 Sol auf Medium und High, notiere Ergebnis, Dauer und Verbrauch und vergleiche mit dem, was du heute nutzt.
Ich aktualisiere diesen Beitrag, sobald es Wiederholungstests zu GPT-6.1 Sol gibt, Ultrafast für Sol erscheint und ich eigene Messungen an Shop-Aufgaben habe.
Stand: 30.09.2026, einen Tag nach der Veröffentlichung. Zahlen zu Preisen und Benchmarks stammen aus den verlinkten Quellen, Community-Stimmen aus den ersten 24 Stunden nach dem Start.
Quellen
- OpenAI: Introducing GPT-6.1 Sol und DevDay 2026 Recap (29.09.2026)
- OpenAI Deployment Safety Hub: Addendum to GPT-6 Astra System Card: GPT-6.1 Sol (29.09.2026)
- OpenAI-Dokumentation: Modellseite GPT-6.1 Sol, API-Preise und Codex-Preise (Stand 30.09.2026)
- OpenAI Hilfe: About ChatGPT Pro tiers (Stand 30.09.2026)
- OpenAI auf YouTube: OpenAI DevDay 2026 Keynote (FULL)
- Artificial Analysis: GPT-6.1 Sol replaces GPT-6 Sol after just 7 days, with near-Astra intelligence und Modellseite (29.09.2026), dazu die Modellseiten zu Opus 5.5, Sonnet 5.5 und Astra
- Anthropic: Pricing (Stand 30.09.2026)
- X: Tibo Sottiaux zur Änderung von Pro 200 und OpenAI Developers: GPT-6.1 Sol is here (29.09.2026)
- The New Stack: OpenAI halves $200 plan allowance, launches $500 plan (29.09.2026) und GPT-6 Sol vs. Claude Opus 5.5 (28.09.2026)
- The Next Web: OpenAI releases GPT-6.1 Sol at a fifth of GPT-6 Astra's token prices und OpenAI halves Pro 200 usage and launches a $500 ChatGPT plan at DevDay (29.09.2026)
- TechCrunch: OpenAI launches GPT-6.1 Sol, says it nearly matches GPT-6 Astra and costs less (29.09.2026)
- The Decoder: GPT-6.1 Sol soll fast so gut sein wie Astra, kostet aber nur ein Fünftel (29.09.2026)
- heise online: OpenAI startet Dots, GPT-6 Sol und Luna: OpenAI halbiert die Preise und OpenAI streicht Veröffentlichung von GPT-6.1 Astra
- CNN: OpenAI won't release new AI model due to safety concerns (28.09.2026), Gizmodo: OpenAI Cancels Release of GPT-6.1 Astra Because It 'Regressed' on Safety (28.09.2026)
- Handy AI: Model Drop: GPT-6.1 Sol (Jake Handy, 29.09.2026)
- Hacker News: GPT 6.1 Sol: Near-Astra intelligence for a fifth of the price (29.09.2026)
- Reddit, r/codex: Has anyone tried Sol 6.1 on a real project yet?, 6.1 Sol is pretty goated, Sol 6.1 vs Astra vs Opus 5.5. All Medium., My experience with Sol 6.1 after 5 hours of continuous heavy work, Test: Sol 6.1 vs Astra vs Opus 5.5 vs Sonnet 5.5, Pixel art, Sol 6.1 use is amazing (29. und 30.09.2026)
- Reddit, weitere: Sol 6.1 Max and Blender for games (r/OpenAI), Using GPT-6.1 Sol only as the planner (r/ChatGPT), AA's New Pareto Line With GPT-6.1 Sol (r/singularity), Terminal Bench 4.0: Astra = 59.6%; 6.1 Sol = 54% (r/codex)
- YouTube: Chase AI: I Tested Sol 6.1 vs Sonnet 5.5 (Surprising Results) und AIex The AI Workbench: GPT-6.1 Sol vs Sonnet 5.5, My Real App Tests
Geschrieben von
Mario WormuthSEO, GEO und KI-Automatisierung für Online-Shops. Ich teste, worüber ich schreibe, zuerst auf eigenen Seiten und in Kundenprojekten wie RYMHART und Opal-Schmiede.
Das für deinen Shop umsetzen?
Drei Fragen, sofort eine Einschätzung, danach drei konkrete Punkte von mir persönlich. Kostenlos.
Weitere Artikel
aus dem Magazin.
Alle Artikel
Claude Sonnet 5.5: Benchmarks, Preise, Effort und wann es Opus 5.5 ersetzt
Am 28. September 2026 hat Anthropic Claude Sonnet 5.5 veröffentlicht, das zweite Modell der 5.5-Familie nach Opus 5.5 vom 22. September. Die Kurzfassung steht schon in der Überschrift von The New Stack: Leistung …
ChatGPT Dots: Was OpenAIs Agenten können und was sie kosten
Am 29. September 2026 hat OpenAI auf dem DevDay in San Francisco die „Dots“ vorgestellt: Agenten in ChatGPT, die dauerhaft laufen, einen eigenen Computer in der Cloud haben und an deinen Aufgaben weiterarbeiten, …
Search Console Multimodal: Was der neue Filter zeigt
Seit dem 24. September 2026 hat die Google Search Console einen neuen Suchtyp. Unter „Web“ stehen jetzt zwei Einträge: „Textbasiert“ und „Multimodal“. Der zweite zählt Suchen, bei denen jemand ein Foto, ein Bild …