Start / Magazin / Weitere Themen
GPT-6.1 Sol langsam? Meine Messung und was wirklich stimmt
ArtikelWeitere Themen01.10.2026/img/magazin/gpt-6-1-sol-langsam-tempo-test.webp Mario WormuthSEO, GEO & KI-Automatisierung
22 Min. Lesezeit
Alles auf einen Blick
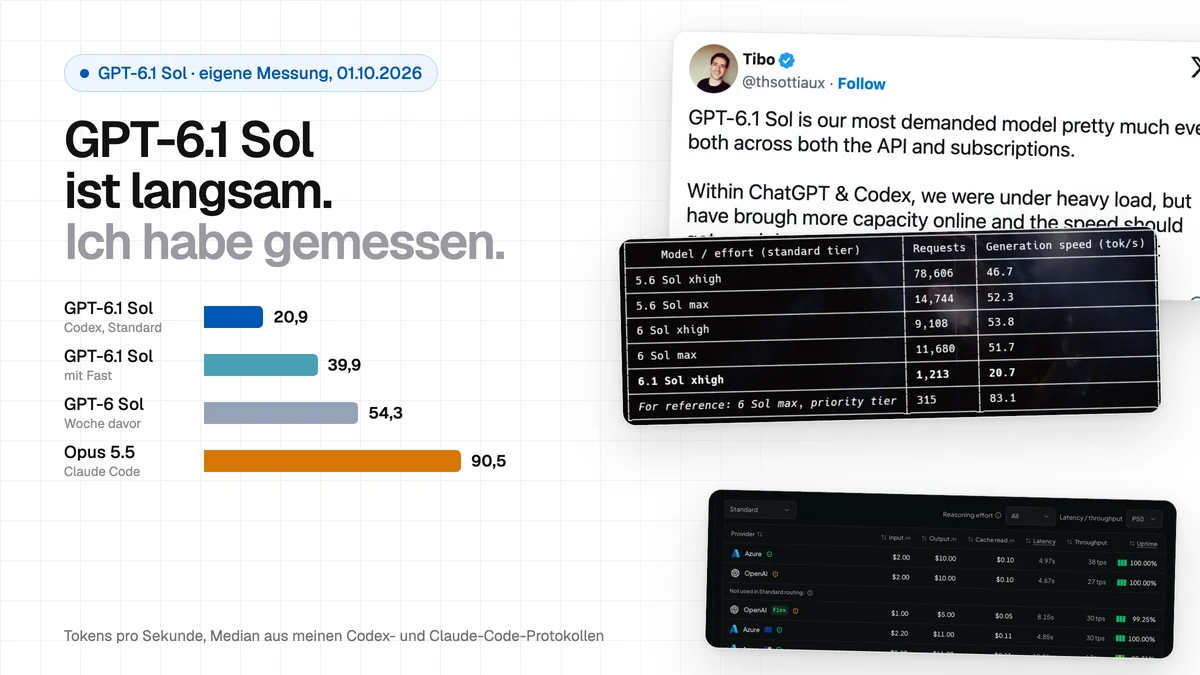
- Ja, GPT-6.1 Sol ist im Codex-Abo derzeit langsam. In meinen Protokollen schreibt es 20,9 Tokens pro Sekunde. GPT-6 Sol schaffte in der Woche davor auf derselben Stufe 54,3, Opus 5.5 in Claude Code gut 90.
- Dazu kommt mehr Wartezeit vor jeder Antwort: Bis zum ersten Token vergehen bei Sol 6.1 im Median 5,7 Sekunden, bei GPT-6 Sol waren es 2,0. Bei einer typischen Codex-Aufgabe mit 16 Modellaufrufen summiert sich das.
- Das Warten aufs Modell ist bei mir fast die ganze Arbeitszeit: 94 % der Zeit meiner Sol-Aufgaben in Codex, der Rest sind Werkzeuge und Tests.
- OpenAI nennt als Grund die hohe Last und hat fast doppeltes Tempo angekündigt. Bei mir stieg es seitdem um 20 %, von 20,4 auf 24,5 Tokens pro Sekunde.
- Fast hilft im Abo deutlich: Im Kontrolltest schrieb Sol mit Fast 39,9 statt 18,0 Tokens pro Sekunde und war nach 62 statt 143 Sekunden fertig. Dafür zählt jede Anfrage 2,5-fach aufs Kontingent. Eine niedrigere Denkstufe spart dagegen nur Denkzeit, das Schreiben bleibt langsam.
- Über die API ist Sol 6.1 schneller als im Abo. Und pro Aufgabe ist es günstig und stark: Im Bug Hunt Bench fand es mehr Fehler als Opus 5.5 für ein Achtel der Kosten, brauchte aber mehr als doppelt so lange.
Inhaltsverzeichnis13 Abschnitte
- Mein Eindruck: deutlich langsamer als Opus 5.5
- So habe ich gemessen
- Ergebnis 1: Meine Protokolle
- Ergebnis 2: Der Kontrolltest
- Was OpenAI sagt
- Was andere messen
- Tokens pro Sekunde sind nicht alles
- Die häufigsten Behauptungen im Check
- Was du jetzt tun kannst
- Miss dein eigenes Tempo
- Mein Fazit
- Häufige Fragen
- Quellen
Seit dem 30. September arbeite ich in Codex mit GPT-6.1 Sol, eingestellt auf die Denkstufe Sehr hoch und ohne Fast. Mein Eindruck nach den ersten Tagen ist eindeutig: Man merkt, dass das Modell deutlich langsamer ist, besonders im Vergleich zu Claude Opus 5.5, mit dem ich parallel in Claude Code arbeite. Im Subreddit r/codex ist das seit dem 30.09. das beherrschende Thema, mit Überschriften wie „GPT-6.1 Sol feels unlimited, because it runs at 20 tokens per second“. OpenAI hat in der Nacht zum 01.10. reagiert: zu viel Last, mehr Kapazität ist geschaltet, das Tempo soll sich fast verdoppeln.
Ein Eindruck ist aber keine Messung. Deshalb habe ich drei Dinge gemacht. Erstens habe ich meine eigenen Protokolle aus Codex und Claude Code ausgewertet: 718 Antworten von GPT-6.1 Sol und 10.683 von Opus 5.5, dazu die Wochen davor mit GPT-6 Sol, GPT-6 Astra und GPT-5.6 Sol. Zweitens habe ich am 01.10. einen Kontrolltest gemacht, mit derselben Aufgabe in ChatGPT Work und claude.ai und in fünf Einstellungen, gemessen an den Zeitstempeln der Server. Drittens habe ich zusammengetragen, was OpenAI sagt, was unabhängige Messdienste wie Artificial Analysis, OpenRouter und der Bug Hunt Bench zeigen und was andere Nutzer berichten. Beim Auswerten und bei der Recherche hat mir KI geholfen (Claude Code). Die Messwerte stammen aus meinen eigenen Protokollen und Tests, die Zahlen der anderen habe ich an den Originalquellen geprüft.
Mein Eindruck: deutlich langsamer als Opus 5.5
Ich nutze GPT-6.1 Sol seit dem 30. September in Codex, auf Sehr hoch und ohne Fast. Wie es eingeordnet ist, steht in meinem Beitrag zu GPT-6.1 Sol und dem OpenAI DevDay 2026: knapp Astra-Niveau zu einem Fünftel des Preises. Im Alltag fällt mir aber vor allem eines auf: Man merkt, dass Sol deutlich langsamer ist. Am stärksten, wenn ich direkt danach in Claude Code mit Opus 5.5 weiterarbeite.
Das Gefühl kann täuschen. Ein Modell, das länger nachdenkt, wirkt langsamer, auch wenn es am Ende schneller fertig ist. Und Opus 5.5 ist ein anderes Modell mit einem anderen Denkstil. Deshalb habe ich nicht nach Gefühl verglichen, sondern gezählt.
So habe ich gemessen
1. Meine Protokolle aus Codex und Claude Code
Codex und Claude Code speichern jede Sitzung lokal auf dem Rechner, mit Zeitstempeln und Tokenzahlen. Ich habe nur diese Zahlen ausgelesen, keine Inhalte. Für jede einzelne Antwort des Modells gilt:
- Schreibtempo: Ausgabe-Tokens geteilt durch die Zeit ab dem ersten gestreamten Teil der Antwort. Zu den Ausgabe-Tokens zählen auch die Tokens, mit denen das Modell nachdenkt.
- Zeit bis zum ersten Token: wie lange das Modell nach dem Abschicken braucht, bis überhaupt etwas kommt.
- Nur längere Antworten: Ich zähle nur Antworten mit mindestens 300 Tokens, weil sehr kurze Antworten das Tempo verzerren.
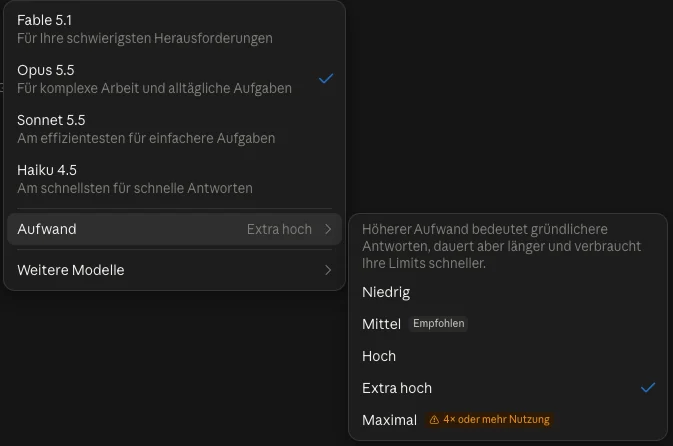
Bei Claude Code steht im Protokoll nicht, wann das erste Token kam. Der Wert für Opus 5.5 enthält deshalb die Wartezeit und ist eher zu niedrig als zu hoch. Beide Modelle liefen auf der vergleichbaren Stufe: Sol auf Sehr hoch (xhigh), Opus auf Extra hoch (xhigh).
2. Der Kontrolltest im Browser
Am 01.10. zwischen 14:50 und 15:25 Uhr habe ich dieselbe Aufgabe in ChatGPT Work und in claude.ai gestellt: einen Ratgebertext mit etwa 900 Wörtern zur Retourenquote, ohne Websuche. GPT-6.1 Sol lief auf Sehr hoch, auf Sehr hoch mit Fast und auf Mittel, Opus 5.5 auf Extra hoch und auf Mittel. Dazu kam eine Programmieraufgabe: ein Margen-Rechner als einzelne HTML-Datei, mit Sol auf Sehr hoch und Opus auf Extra hoch. Gemessen habe ich nicht mit der Stoppuhr, sondern mit den Zeitstempeln, die beide Dienste selbst liefern: bei ChatGPT aus dem Antwort-Datenstrom, in dem jedes Token einzeln ankommt, bei claude.ai aus dem gespeicherten Gesprächsverlauf, der Beginn und Ende von Nachdenken und Text festhält.
Was ist ein Token? Sprachmodelle schreiben in Wortstücken, den Tokens. Im deutschen Ratgebertext aus meinem Test war ein Token bei GPT-6.1 Sol im Schnitt 4,8 Zeichen lang, „Retourenquote“ zum Beispiel kam als „ Retour“, „en“ und „quote“. 20 Tokens pro Sekunde sind damit rund 95 Zeichen pro Sekunde, etwa eine Zeile Text. Weil OpenAI und Anthropic Texte unterschiedlich in Tokens zerlegen, vergleiche ich im Kontrolltest zusätzlich Zeichen pro Sekunde.
Ergebnis 1: Meine Protokolle
Die Tabelle zeigt den Median aus allen längeren Antworten je Modell. Der Median ist der mittlere Wert, einzelne Ausreißer verschieben ihn kaum.
| Modell | Zeitraum | Antworten | Token/s beim Schreiben | Token/s mit Warten | 1. Token nach |
|---|---|---|---|---|---|
| GPT-6.1 SolCodex, Sehr hoch (xhigh) | 30.09. bis 01.10. | 376 | 20,9 | 18,6 | 5,7 s |
| GPT-6 SolCodex, Sehr hoch (xhigh) | 23.09. bis 28.09. | 611 | 54,3 | 44,0 | 2,0 s |
| GPT-6 AstraCodex, Hoch (high) | 06.09. bis 30.09. | 4.758 | 33,0 | 28,3 | 2,5 s |
| GPT-5.6 SolCodex, Hoch (high) | 03.09. bis 10.09. | 1.266 | 32,2 | 28,4 | 2,4 s |
| Claude Opus 5.5Claude Code, Extra hoch (xhigh) | 24.09. bis 01.10. | 5.743 | nicht erfasst | 90,5 | nicht erfasst |
Drei Dinge fallen auf. Erstens schreibt GPT-6.1 Sol bei mir nicht einmal halb so schnell wie sein Vorgänger GPT-6 Sol eine Woche vorher, auf derselben Stufe und im selben Werkzeug. Zweitens wartet man vor jeder Antwort fast dreimal so lange auf das erste Token. Drittens liegt Opus 5.5 mit gut 90 Tokens pro Sekunde in einer anderen Liga, obwohl in diesem Wert die Wartezeit sogar noch steckt.
Wie viel das im Alltag ausmacht, zeigen meine 30 Sol-Aufgaben in Codex seit dem 30.09.: Im Median waren es 16 Modellaufrufe, rund 9.000 Ausgabe-Tokens und 9 Minuten pro Aufgabe. Davon entfielen 94 % auf das Warten auf das Modell. Befehle ausführen, Dateien lesen und Tests laufen lassen machten nur 6 % aus. Das Schreibtempo des Modells ist also nicht ein Faktor unter vielen, sondern der Engpass.
Der Verlauf zeigt noch etwas: Am 30.09. lag das Tempo von morgens bis abends fast konstant bei etwa 20 Tokens pro Sekunde, ganz gleich, wann ich gearbeitet habe. Am 01.10., nach der Ankündigung von OpenAI, lag es bei 22 bis 25. Das ist besser, aber weit entfernt vom versprochenen doppelten Tempo.
Ergebnis 2: Der Kontrolltest
Im Kontrolltest bekamen beide Modelle exakt denselben Auftrag. So lassen sich Nachdenken und Schreiben getrennt betrachten.
| Modell | Text beginnt nach | Fertig nach | Länge | Schreibtempo |
|---|---|---|---|---|
| GPT-6.1 SolSehr hoch, ohne Fast | 49,8 s | 142,7 s | 7.719 | 86 Zeichen/s (18,0 Token/s) |
| GPT-6.1 SolSehr hoch, mit Fast | 20,1 s | 61,7 s | 7.455 | 189 Zeichen/s (39,9 Token/s) |
| GPT-6.1 SolMittel, ohne Fast | 11,2 s | 109,8 s | 7.585 | 77 Zeichen/s |
| Claude Opus 5.5Extra hoch | 67,8 s | 87,5 s | 5.942 | mind. 302 Zeichen/s |
| Claude Opus 5.5Mittel | 2,7 s | 27,9 s | 5.287 | mind. 210 Zeichen/s |
| Modell | Text beginnt nach | Fertig nach | Länge | Schreibtempo |
|---|---|---|---|---|
| GPT-6.1 SolSehr hoch, ohne Fast | 4:57 min | 8:03 min | 22.396 | 124 Zeichen/s (32,3 Token/s) |
| Claude Opus 5.5Extra hoch | 4:58 min | 6:19 min | 27.204 | mind. 339 Zeichen/s |
Das Ergebnis passt zu meinen Protokollen, ist aber an einer Stelle überraschend: Opus 5.5 hat auf Extra hoch nicht kürzer nachgedacht als Sol 6.1. Beim Ratgebertext begann der Text bei Opus nach 68 Sekunden, bei Sol nach 50, beim Rechner bei beiden nach knapp 5 Minuten. Trotzdem war Opus jeweils früher fertig, weil es danach zweieinhalb- bis dreieinhalbmal so schnell geschrieben hat. Beim Rechner stand der fertige Code von Opus nach 6:19 Minuten da, bei Sol nach 8:03 Minuten, obwohl Opus mit gut 27.000 Zeichen sogar mehr Code geschrieben hat.
Zwei weitere Ergebnisse sind für die Praxis wichtig:
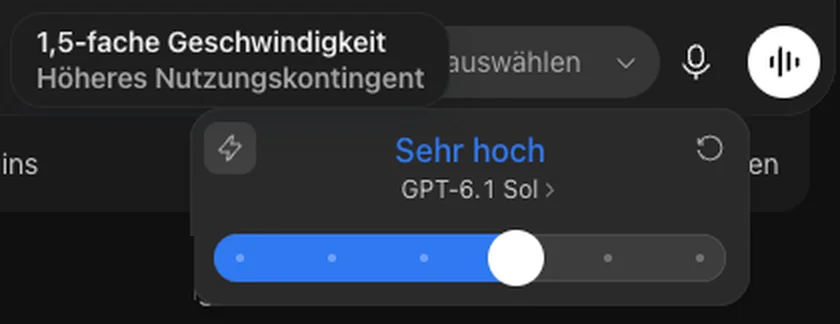
- Fast verdoppelt das Tempo. Mit Fast schrieb Sol 39,9 statt 18,0 Tokens pro Sekunde, auch das Nachdenken ging schneller. Der Text war nach 62 statt 143 Sekunden fertig und damit sogar früher als bei Opus 5.5 auf Extra hoch. ChatGPT selbst verspricht in der Einstellung nur die „1,5-fache Geschwindigkeit“.
- Mittel spart nur Denkzeit. Auf Mittel begann der Text nach 11 statt 50 Sekunden. Geschrieben hat Sol danach aber genauso langsam, mit 77 Zeichen pro Sekunde. Fertig war es nach 110 Sekunden statt 143.
Auffällig ist auch, dass Sol bei der Programmieraufgabe gut 20 Minuten später mit 32 Tokens pro Sekunde schrieb, deutlich schneller als beim Text. Das kann an der Art der Tokens liegen, Code zerfällt in kürzere Stücke, oder daran, dass OpenAI im Lauf des Nachmittags weitere Kapazität zugeschaltet hat. Mit je einem Lauf lässt sich das nicht trennen. Wie sich die Unterschiede anfühlen, kannst du hier nachspielen:
- GPT-6.1 Sol Sehr hoch, ohne FastText nach 49,8 s, fertig nach 142,7 s
- GPT-6.1 Sol Sehr hoch, mit FastText nach 20,0 s, fertig nach 61,7 s
- GPT-6.1 Sol Mittel, ohne FastText nach 11,2 s, fertig nach 109,8 s
- Claude Opus 5.5 Extra hochText nach 67,8 s, fertig nach 87,5 s
- Claude Opus 5.5 MittelText nach 2,7 s, fertig nach 27,9 s
Gemessen am 01.10.2026 zwischen 14:50 und 15:25 Uhr im Browser, jeweils mit einem bezahlten Abo, je ein Lauf pro Einstellung. ChatGPT: Server-Zeitstempel aus dem Antwort-Datenstrom und dem gespeicherten Gesprächsverlauf. claude.ai: Start- und Endzeit der Denk- und Textblöcke aus dem gespeicherten Gesprächsverlauf. Das Abspielen läuft in deinem Browser, es wird nichts gesendet oder gespeichert.
Was OpenAI sagt
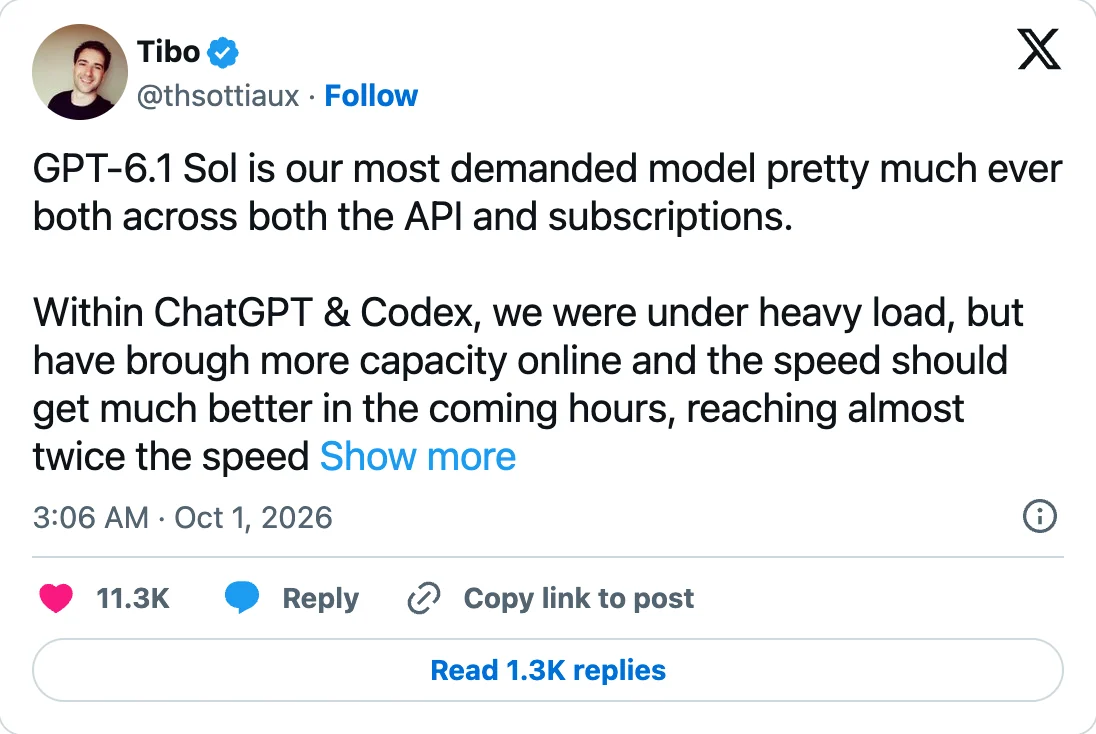
Die einzige direkte Aussage von OpenAI zum Tempo kam von Tibo Sottiaux, der bei OpenAI für Codex zuständig ist. Am 01.10. um 3:06 Uhr deutscher Zeit schrieb er auf X, GPT-6.1 Sol sei „our most demanded model pretty much ever“, über die API und in den Abos. In ChatGPT und Codex sei man „under heavy load“ gewesen, habe aber mehr Kapazität zugeschaltet. Das Tempo solle in den nächsten Stunden „almost twice the speed compared to what we served yesterday“ erreichen.
Was OpenAI darüber hinaus dokumentiert:
- Fast: Laut Codex-Dokumentation unterstützt GPT-6.1 Sol die Stufen Standard und Fast. Einen Tempo-Faktor nennt OpenAI für Sol 6.1 dort nicht, für GPT-5.6 und GPT-5.5 sind es 1,5-fach. Im Abo verbraucht Fast das 2,5-Fache an Kontingent, über die API kostet es das Doppelte.
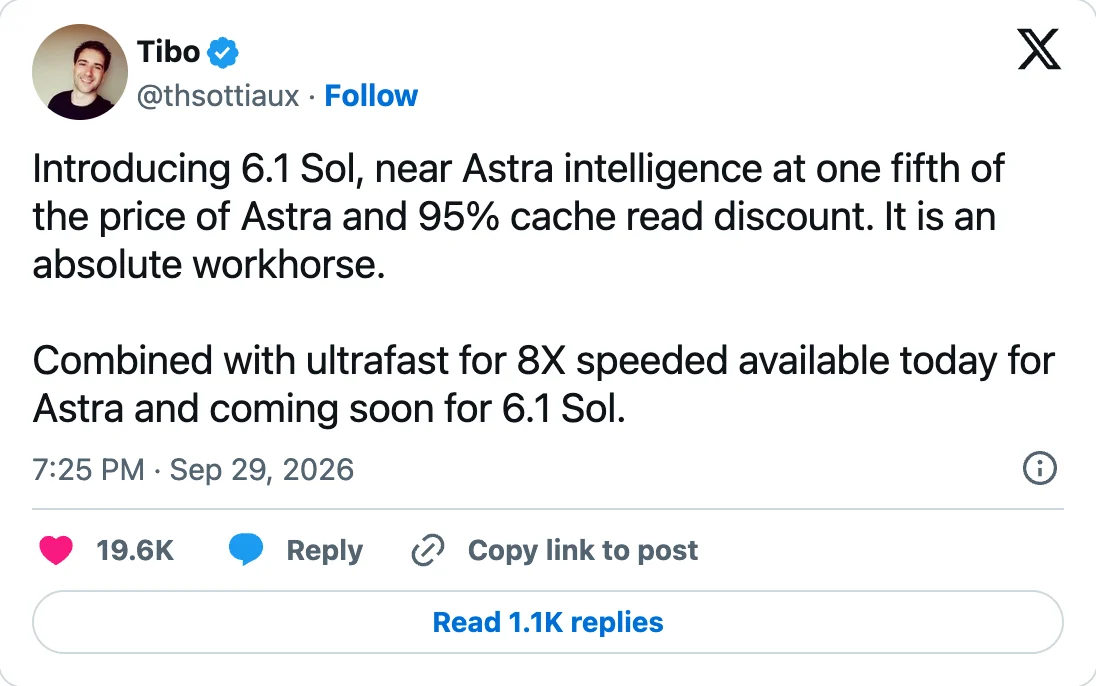
- Ultrafast: Die schnellste Stufe mit bis zu achtfachem Tempo gibt es bisher nur für GPT-6 Astra. Für Sol 6.1 ist sie angekündigt, aber ohne Datum.
- Statusseite: Für den 30.09. vermerkt OpenAI zwischen 19:05 und 22:35 Uhr deutscher Zeit eine „Elevated latency for some API requests“, also längere Antwortzeiten bei der API. Einen eigenen Eintrag zum langsamen Sol in Codex gab es bis zum 01.10. mittags nicht.
Eine Erklärung für das Tempo im Detail gibt OpenAI nicht. Auf Reddit behauptet ein Nutzer, Tibo habe vorher über Batching gesprochen, also darüber, viele Anfragen gemeinsam zu verarbeiten, was Rechenzeit spart und den einzelnen Nutzer bremst. Einen solchen Post habe ich nicht gefunden.
Was andere messen
Andere Nutzer: dieselben 20 Tokens pro Sekunde
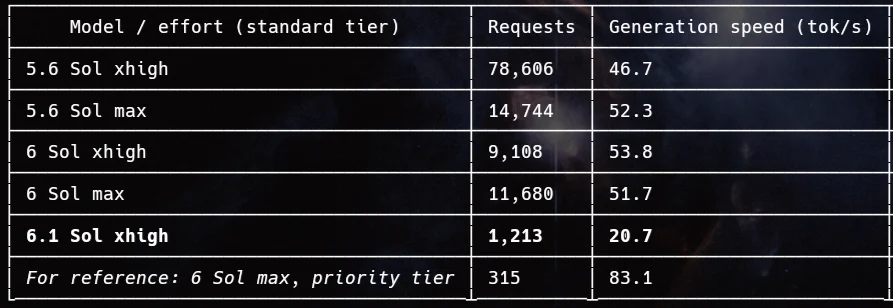
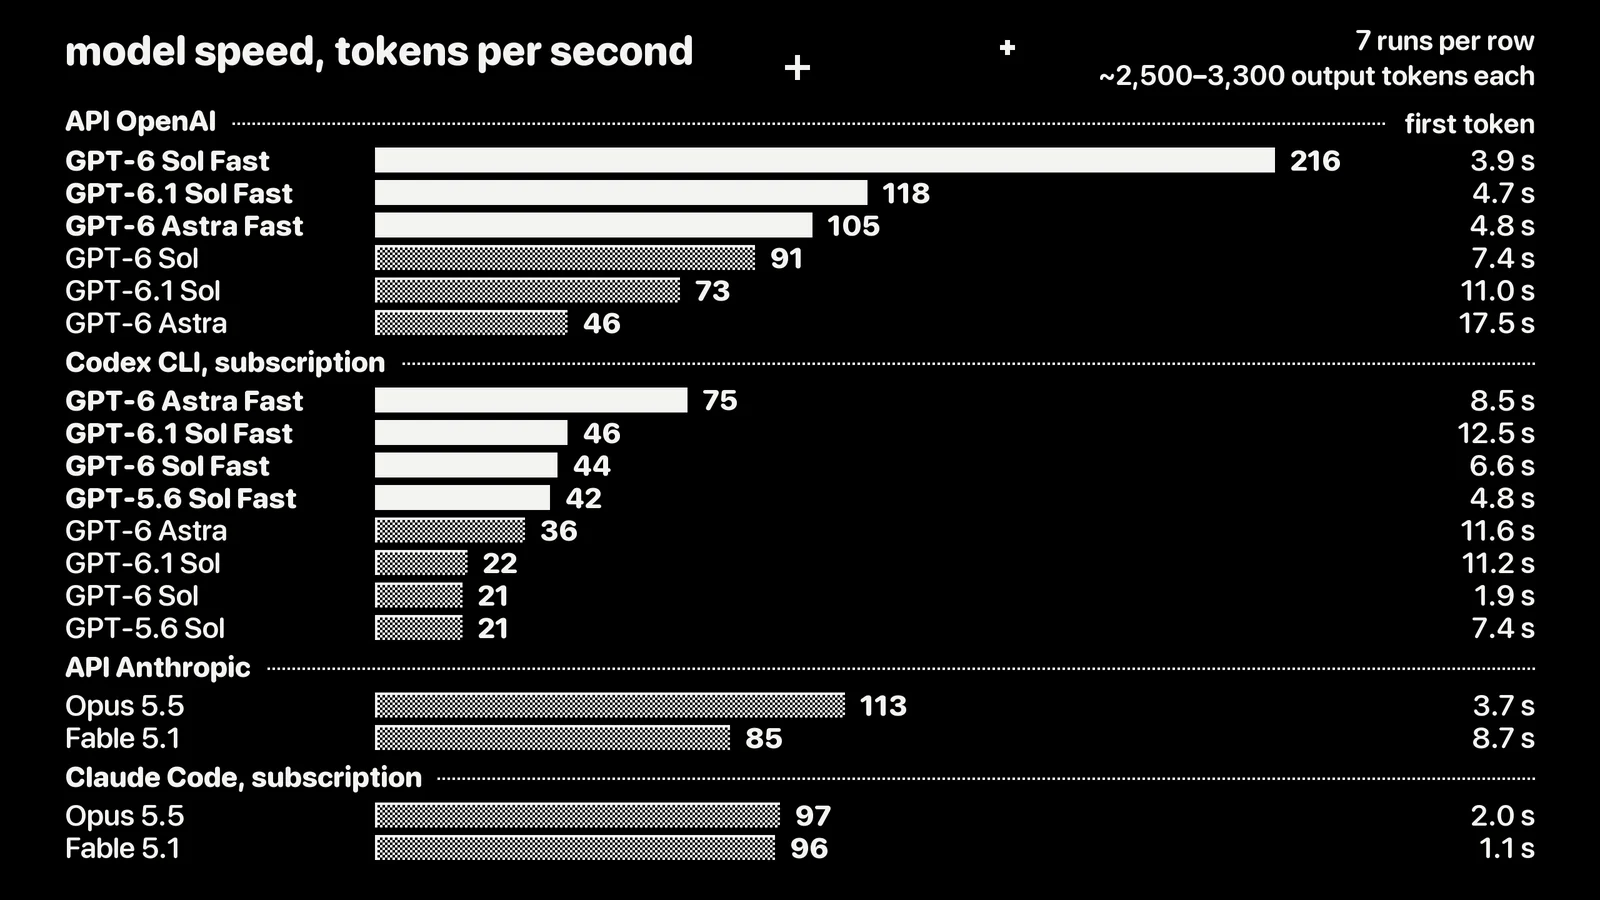
Der Thread, der die Diskussion ins Rollen brachte, stammt von einem Nutzer, der wie ich seine Codex-Protokolle ausgewertet hat. Seine Tabelle zeigt fast dieselben Werte: GPT-6.1 Sol auf xhigh 20,7 Tokens pro Sekunde aus 1.213 Anfragen, GPT-6 Sol auf xhigh 53,8. Ein anderer Nutzer hat je sieben Läufe über die API und über das Codex-Abo gemessen. Bei ihm kamen am 30.09. im Abo auch GPT-6 Sol und GPT-5.6 Sol nur auf 21 Tokens pro Sekunde, über die API lag GPT-6 Sol bei 91 und Sol 6.1 bei 73. In meinen Protokollen schaffte GPT-6 Sol in der Woche davor im Abo noch 54. Das spricht dafür, dass die Last am 30.09. das ganze Codex-Abo gebremst hat und nicht nur Sol 6.1.
„I've been running it on xhigh and it literally implemented a same task in 50 minutes that Opus 5.5 did in 15 minutes.“
Dieselbe Aufgabe, auf xhigh: Sol brauchte 50 Minuten, Opus 5.5 nur 15.
„Bug investigation/fix took one hour. For most of that time I did not saw any commands being run, no changes. Then session logs revealed that only 8min~ out of that hour was real agent work time.“
Eine Stunde für einen Bugfix, und die meiste Zeit passierte sichtbar nichts. Das passt zu meinen 94 % Wartezeit aufs Modell.
„Story checks out for me as well Opus 5.5 is almost 3 times faster.“
Auch hier: Opus 5.5 sei fast dreimal so schnell.
Es gibt aber auch viele, denen das Tempo wenig ausmacht oder die es sogar gut finden, weil ihr Kontingent länger reicht:
„I'm not sitting there waiting for my agents to run. I give them a task and then go do something else.“
Wer die Aufgabe abgibt und etwas anderes macht, merkt das Tempo kaum.
„Sol 6.1 is a godsend for budget users. Yes, it's slow but it's been very competent so far. Gets things right the first time.“
Langsam, aber gut: Wer auf das Budget achtet, bekommt viel für wenig Kontingent, und es muss seltener nachgebessert werden.
„Having less stress knowing that I won't hit the limit 3 days before reset is amazing for the user who is on a budget.“
Ein Nutzer mit dem kleinen Plus-Abo freut sich, dass sein Kontingent nicht mehr drei Tage vor dem Ende aufgebraucht ist.
Über die API: schneller, aber nicht so schnell wie GPT-6 Sol
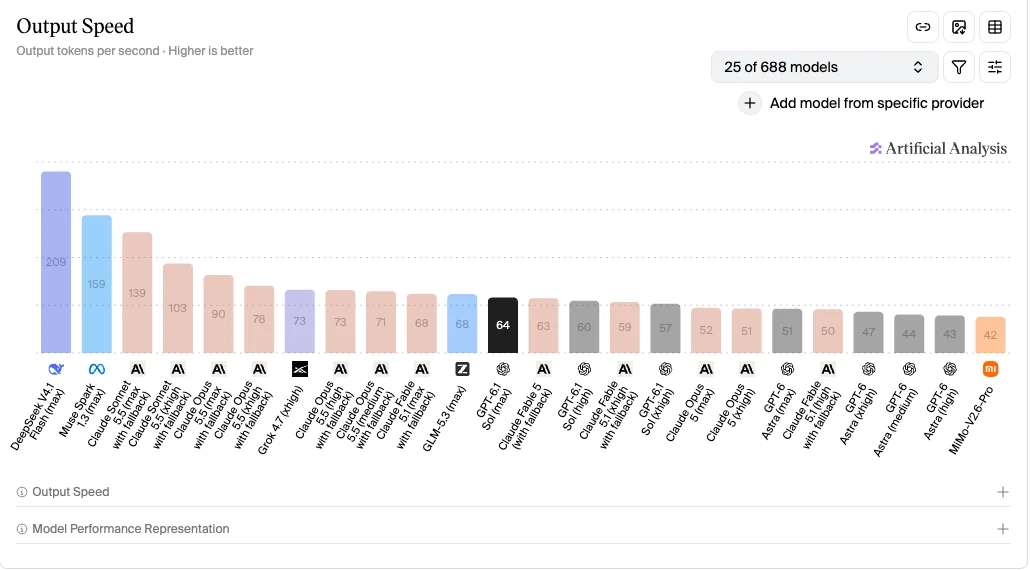
Wer Sol 6.1 über die API nutzt, bekommt ein anderes Bild. Artificial Analysis misst die Schreibgeschwindigkeit direkt bei OpenAI und Anthropic. Am 01.10. lag Sol 6.1 auf Max bei 64 Tokens pro Sekunde, Opus 5.5 auf Max bei 90, GPT-6 Sol auf Max bei 74. Sol 6.1 ist also auch über die API langsamer als sein Vorgänger, aber dreimal so schnell wie in meinem Codex.
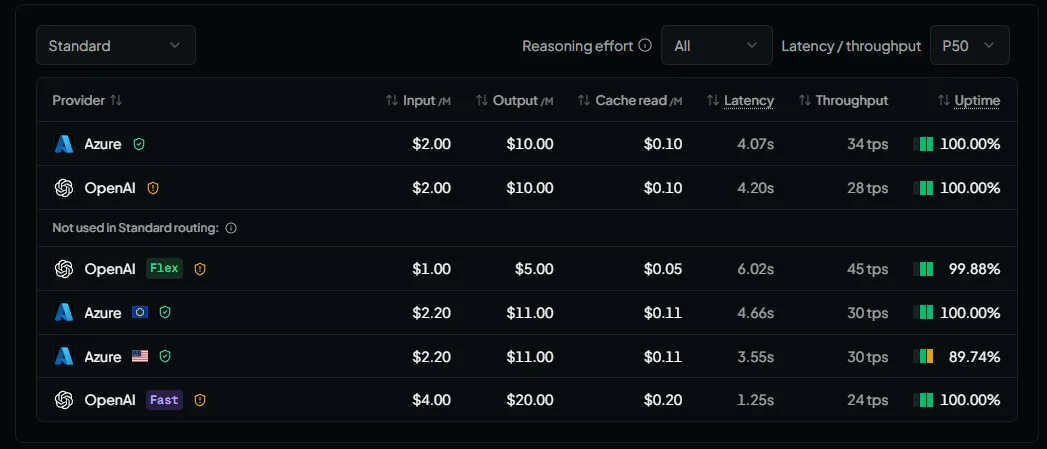
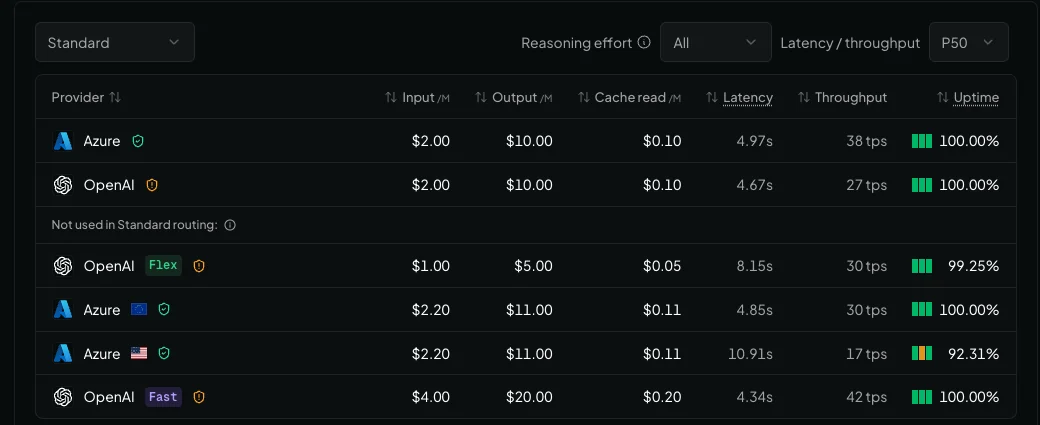
Bei OpenRouter, einem Dienst, der Anfragen an verschiedene Anbieter verteilt, lag Sol 6.1 am 01.10. mittags bei den meisten Anbietern bei 27 bis 38 Tokens pro Sekunde. Spannend ist der Fast-Zugang: Am Abend des 30.09. war er mit 24 Tokens pro Sekunde sogar langsamer als der normale mit 28. Am 01.10. lag er mit 42 gegenüber 27 vorn. Opus 5.5 kam bei OpenRouter im Wochenschnitt je nach Anbieter auf 53 bis 79 Tokens pro Sekunde, mit Fast auf 111.
Tokens pro Sekunde sind nicht alles
Das stärkste Gegenargument in der Diskussion lautet: Das Schreibtempo sagt nichts darüber, wie schnell eine Aufgabe erledigt ist. Ein Modell, das mit weniger Tokens und weniger Umwegen zum Ziel kommt, kann trotz langsamerer Ausgabe früher fertig sein. Ein Nutzer rechnete es auf Reddit vor: 1.000 Tokens mit 20 pro Sekunde dauern 50 Sekunden, 5.000 Tokens mit 50 pro Sekunde 100 Sekunden. Das stimmt, und die Messungen zeigen, dass es bei Sol 6.1 eine Rolle spielt, aber nicht immer zu seinen Gunsten:
- Bug Hunt Bench: In 105 Fehlern, die in zwei echte Projekte eingebaut sind, fand GPT-6.1 Sol auf xhigh im Schnitt 42,7, Opus 5.5 auf xhigh 36. Sol kostete dafür zu Listenpreisen 4,35 $ statt 34,98 $, brauchte aber 98,7 statt 42,5 Minuten. Sol lief dabei über das Codex-Abo, Opus über die API. Der erste Sol-Lauf am Starttag dauerte 80,6 Minuten, die Wiederholungen am 30.09. 98,9 und 116,7 Minuten, also genau in der langsamen Phase.
- Artificial Analysis: Über die API war Sol 6.1 pro Aufgabe sogar schneller fertig als Opus 5.5 auf derselben Stufe, auf High etwa 3,6 statt 5,0 Minuten. Gegenüber GPT-6 Sol braucht es aber länger, 3,6 statt 2,7 Minuten.
- Vals AI: Auch hier lag Sol 6.1 mit 43 Minuten pro Testlauf vor Opus 5.5 mit 79 Minuten, aber hinter GPT-6 Sol mit 29 Minuten. Vals misst über die API, welche Denkstufen dort liefen, steht nicht in der Übersicht.
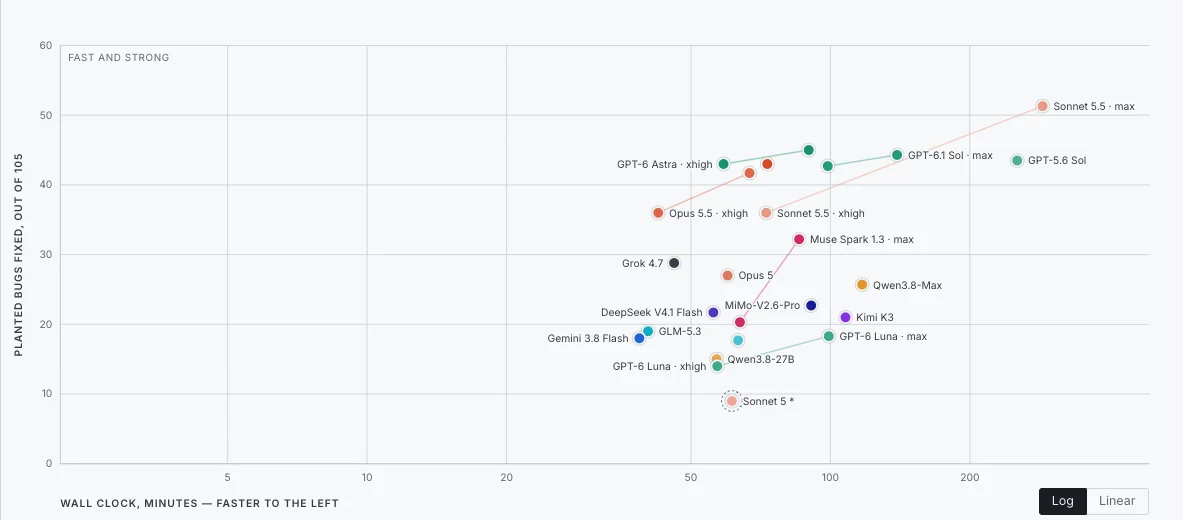
Der Unterschied zwischen diesen Messungen liegt vor allem am Weg: Über die API ist Sol schnell genug, dass seine sparsame Arbeitsweise den Ausschlag gibt. Im Abo, mit 20 Tokens pro Sekunde, frisst das Schreibtempo diesen Vorteil auf. Meine eigenen Aufgaben in Codex zeigen das deutlich: Wenn 94 % der Zeit Warten aufs Modell sind, wird jede Aufgabe fast proportional langsamer, wenn das Modell langsamer schreibt.
Die häufigsten Behauptungen im Check
- stimmt„Sol 6.1 ist im Codex-Abo deutlich langsamer als GPT-6 Sol und Opus 5.5.“
In meinen Protokollen: 20,9 Token/s gegenüber 54,3 bei GPT-6 Sol in der Woche davor und gut 90 bei Opus 5.5 in Claude Code. Im Kontrolltest schrieb Opus 5.5 etwa 300 Zeichen pro Sekunde, Sol 6.1 ohne Fast 86.
- stimmt„Über die API ist Sol 6.1 schneller als im Abo.“
Artificial Analysis misst über die API je nach Stufe und Länge der Anfrage 56 bis 73 Token/s, OpenRouter 27 bis 47. In Codex und ChatGPT Work lag ich bei 16 bis 25. Ein Nutzer auf Reddit hat beide Wege mit je sieben Läufen gemessen: 73 Token/s über die API, 22 im Codex-Abo.
- teilweise„OpenAI macht es seit Tibos Post doppelt so schnell.“
Angekündigt war „almost twice the speed“. Bei mir stieg das Tempo von 20,4 Token/s am 30.09. auf 24,5 am 01.10., also um gut 20 Prozent. Andere melden „snappier“, wieder andere weiter 16 bis 22 Token/s.
- teilweise„Eine niedrigere Denkstufe macht Sol schneller.“
Sie spart Denkzeit, nicht Schreibzeit. Auf Mittel begann der Text nach 11 statt 50 Sekunden, geschrieben hat Sol danach aber genauso langsam (77 statt 86 Zeichen pro Sekunde). Fertig war es nach 110 statt 143 Sekunden.
- im Abo falsch„Fast bringt bei Sol 6.1 nichts.“
Im Kontrolltest schrieb Sol mit Fast 39,9 statt 18,0 Token/s und war nach 62 statt 143 Sekunden fertig. Über die API sah es anders aus: Am 30.09. war der Fast-Zugang bei OpenRouter zeitweise sogar langsamer als der normale, am 01.10. etwa 1,5-mal so schnell. Im Abo kostet Fast das 2,5-Fache an Kontingent.
- unbelegt„OpenAI bremst absichtlich, um Fast und Ultrafast zu verkaufen.“
Dafür gibt es keinen Beleg. OpenAI nennt als Grund die hohe Last, und Ultrafast gibt es für Sol 6.1 noch gar nicht. Auffällig ist nur, wie gleichmäßig das Tempo bei mir war: am 30.09. von morgens bis abends um die 20 Token/s, ohne die Schwankungen, die man bei wechselnder Auslastung erwarten würde.
- Spekulation„Sol 6.1 ist ein umbenanntes, größeres Modell, deshalb ist es so langsam.“
Die These, Sol 6.1 sei eigentlich ein „Astra Minor“, steht in vielen Threads. OpenAI hat dazu nichts gesagt, Modellgrößen veröffentlicht OpenAI nicht. Gemessen ist nur: Auch über die API ist Sol 6.1 langsamer als GPT-6 Sol (Artificial Analysis 64 gegenüber 74 Token/s auf Max).
Was du jetzt tun kannst
Solange OpenAI das Tempo im Abo nicht deutlich erhöht, helfen ein paar einfache Regeln:
- Fast gezielt einschalten. Wenn du vor dem Bildschirm sitzt und auf die Antwort wartest, lohnt sich Fast. In Codex schaltest du es mit
/fastum, in ChatGPT Work mit dem Blitz-Symbol neben der Denkstufe. Bedenke, dass jede Anfrage dann 2,5-fach aufs Kontingent zählt. - Lange Aufgaben im Hintergrund laufen lassen. Für Aufgaben, bei denen du nicht danebensitzt, ist das Tempo weniger wichtig. Dort spielt Sol seine Stärke aus: gute Ergebnisse für wenig Kontingent.
- Mehrere Aufgaben parallel. Sol ist pro Anfrage langsam, nicht insgesamt begrenzt. Wer zwei oder drei unabhängige Aufgaben gleichzeitig laufen lässt, holt einen Teil der Zeit zurück.
- Die Denkstufe nur senken, wenn die Aufgabe es erlaubt. Mittel statt Sehr hoch spart Denkzeit, aber nicht das langsame Schreiben. Im Bug Hunt Bench fand Sol auf Medium 29 statt 42,7 Fehler. Für einfache Aufgaben passt das, für schwierige eher nicht.
- Für zeitkritische Arbeit ein schnelleres Modell nehmen. Wenn es auf Minuten ankommt, ist Opus 5.5 in Claude Code im Moment deutlich schneller. Wie sich die Claude-Modelle untereinander schlagen, steht in meinem Beitrag zu Claude Sonnet 5.5.
Wie viel Zeit das bei deiner Arbeit ausmacht, rechnet dir der Rechner aus. Die Vorlage „typische Codex-Aufgabe“ entspricht dem Median meiner eigenen Aufgaben.
Rechenweg: Aufgaben × (Aufrufe × Zeit bis zum ersten Token + Ausgabe-Tokens ÷ Token pro Sekunde). Werte: GPT-6.1 Sol 20,9 Token/s und 5,7 s bis zum ersten Token (Median aus 376 Antworten in meinem Codex), mit Fast 39,9 Token/s (Kontrolltest), GPT-6 Sol 54,3 Token/s und 2,0 s, Opus 5.5 90,5 Token/s einschließlich Wartezeit. Zur Ausgabe zählen auch die Tokens, die das Modell zum Denken braucht. Die Vorlage „typische Codex-Aufgabe“ ist der Median meiner Sol-Aufgaben seit dem 30.09.: 16 Modellaufrufe und rund 9.000 Ausgabe-Tokens, „groß“ ist das obere Viertel. Nicht eingerechnet: Zeit für Werkzeuge und Tests, die bei mir aber nur einen kleinen Teil ausmacht. Alle Modelle bekommen dieselbe Tokenmenge, in der Praxis brauchen sie unterschiedlich viele.
Miss dein eigenes Tempo
Wenn du Codex auf dem Mac oder unter Linux nutzt, kannst du deine eigenen Werte mit diesem kleinen Python-Skript auslesen. Es liest nur Zeitstempel und Tokenzahlen aus deinen lokalen Codex-Protokollen in ~/.codex/sessions, keine Inhalte, und sendet nichts. Speichere es als codex-tempo.py und starte es im Terminal mit python3 codex-tempo.py.
# codex-tempo.py: misst das Tempo deiner Modelle aus den lokalen Codex-Protokollen.
# Liest nur Zeitstempel und Tokenzahlen aus ~/.codex/sessions, sendet nichts.
import datetime as dt, glob, json, os, statistics as st
from collections import defaultdict

def ms(ts):
    return dt.datetime.fromisoformat(ts.replace("Z", "+00:00")).timestamp() * 1000

werte = defaultdict(list)
for datei in glob.glob(os.path.expanduser("~/.codex/sessions/**/*.jsonl"), recursive=True):
    modell = stufe = start = erstes = None
    for zeile in open(datei, errors="ignore"):
        try:
            o = json.loads(zeile)
        except ValueError:
            continue
        p, ts, typ = o.get("payload") or {}, o.get("timestamp"), o.get("type")
        art = (p.get("item") or {}).get("type")
        if not ts:
            continue
        if typ == "turn_context":
            modell, stufe = p.get("model"), p.get("effort")
        elif p.get("type") == "token_count" or art == "UserMessage":
            start, erstes = ms(ts), None
        elif art in ("Reasoning", "AgentMessage") and start and erstes is None:
            erstes = p.get("started_at_ms")
        elif typ == "token_usage_record" and start:
            aus, ende = (p.get("usage") or {}).get("output_tokens", 0), ms(ts)
            if aus >= 300 and erstes and ende > erstes:
                werte[(modell, stufe)].append((aus / ((ende - erstes) / 1000), (erstes - start) / 1000))
            start = None

for (modell, stufe), v in sorted(werte.items(), key=lambda x: -len(x[1])):
    if len(v) >= 10:
        print(f"{modell} ({stufe}): {st.median([x[0] for x in v]):.1f} Token/s, "
              f"erstes Token nach {st.median([x[1] for x in v]):.1f} s, {len(v)} Antworten")
Die Ausgabe zeigt je Modell und Denkstufe das mittlere Schreibtempo, die Zeit bis zum ersten Token und die Zahl der ausgewerteten Antworten. Bei mir steht dort für GPT-6.1 Sol auf xhigh 21,1 Tokens pro Sekunde, für GPT-6 Sol 54,5.
Mein Fazit
Der Eindruck täuscht nicht. GPT-6.1 Sol ist im Codex-Abo zurzeit langsam: 21 Tokens pro Sekunde statt 54 beim Vorgänger und gut 90 bei Opus 5.5. Und weil bei meinen Aufgaben fast die ganze Zeit Warten aufs Modell ist, schlägt das voll auf die Arbeitszeit durch. Die Ankündigung von OpenAI hat bisher 20 % gebracht, nicht das Doppelte.
Ein schlechtes Modell ist Sol 6.1 deshalb nicht. Pro Aufgabe ist es günstig, in Tests wie dem Bug Hunt Bench findet es mehr Fehler als Opus 5.5, und über die API ist es deutlich flotter. Für mich heißt das im Moment: Sol läuft da, wo ich nicht danebensitze, und wenn ich auf die Antwort warte, schalte ich Fast ein oder nehme Opus 5.5. Die Werte messe ich in den nächsten Tagen weiter und aktualisiere den Beitrag, sobald OpenAI nachlegt oder Ultrafast für Sol kommt.
Häufige Fragen
Warum ist GPT-6.1 Sol so langsam?
OpenAI nennt als Grund die hohe Last: Sol 6.1 sei das meistgenutzte Modell bisher. Im Codex-Abo und in ChatGPT Work kommen derzeit rund 20 bis 25 Tokens pro Sekunde an, über die API je nach Messung 27 bis 73. Ob OpenAI die Abos zusätzlich bewusst langsamer bedient, ist nicht belegt.
Ist GPT-6.1 Sol über die API schneller?
Ja. Artificial Analysis misst über die API je nach Stufe 56 bis 73 Tokens pro Sekunde, OpenRouter 27 bis 47. Im Codex-Abo lag ich bei 21. Langsamer als GPT-6 Sol ist Sol 6.1 aber auch über die API.
Lohnt sich Fast bei GPT-6.1 Sol?
Im Abo ja, wenn du auf die Antwort wartest. In meinem Kontrolltest schrieb Sol mit Fast 39,9 statt 18,0 Tokens pro Sekunde und war nach 62 statt 143 Sekunden fertig. Jede Anfrage zählt dafür 2,5-fach aufs Kontingent.
Wird Sol schneller, wenn ich eine niedrigere Denkstufe wähle?
Nur teilweise. Eine niedrigere Stufe verkürzt das Nachdenken, auf Mittel kam der Text bei mir nach 11 statt 50 Sekunden. Das Schreiben selbst bleibt gleich langsam.
Wie schnell ist Opus 5.5 im Vergleich?
In meinem Claude Code schreibt Opus 5.5 auf Extra hoch gut 90 Tokens pro Sekunde, gut viermal so schnell wie Sol 6.1 in Codex. Im Kontrolltest dachte Opus teils länger nach, war aber trotzdem früher fertig.
Wann kommt Ultrafast für GPT-6.1 Sol?
OpenAI hat es am 29.09. als „coming soon“ angekündigt, ein Datum gibt es nicht. Bisher bietet Codex für Sol 6.1 nur Standard und Fast an.
Quellen
- Eigene Messung: Codex- und Claude-Code-Protokolle vom 03.09. bis 01.10.2026, ausgewertet am 01.10.2026. Kontrolltest in ChatGPT Work und claude.ai am 01.10.2026, 14:50 bis 15:25 Uhr.
- Tibo Sottiaux auf X, 01.10.2026: x.com/thsottiaux/status/2105464274747527543, und 29.09.2026: x.com/thsottiaux/status/2104986027953930613
- OpenAI, Codex-Dokumentation zu Speed und Fast mode, API-Dokumentation zu Fast mode und Ultrafast mode, abgerufen am 01.10.2026: developers.openai.com/codex/speed, developers.openai.com/api/docs/guides/fast-mode
- OpenAI-Statusseite, Vorfälle vom 29.09. bis 01.10.2026: status.openai.com
- Reddit r/codex, Threads 1wuatzt, 1wugkrs, 1wuv5ew und 1wuho1p vom 30.09. und 01.10.2026, gelesen über das Archiv Arctic Shift
- Artificial Analysis, Seiten Speed und GPT-6.1 Sol, abgerufen am 01.10.2026: artificialanalysis.ai
- OpenRouter, Anbieter und Durchsatz für GPT-6.1 Sol und Claude Opus 5.5, abgerufen am 01.10.2026: openrouter.ai/openai/gpt-6.1-sol
- Bug Hunt Bench von Pawel Huryn, Rangliste und Laufnotizen, Stand 01.10.2026: bughunt.productcompass.pm
- Vals AI, Modellseiten GPT-6.1 Sol, GPT-6 Sol und Claude Opus 5.5, abgerufen am 01.10.2026: vals.ai
Geschrieben von
Mario WormuthSEO, GEO und KI-Automatisierung für Online-Shops. Ich teste, worüber ich schreibe, zuerst auf eigenen Seiten und in Kundenprojekten wie RYMHART und Opal-Schmiede.
Das für deinen Shop umsetzen?
Drei Fragen, sofort eine Einschätzung, danach drei konkrete Punkte von mir persönlich. Kostenlos.
Weitere Artikel
aus dem Magazin.
Alle Artikel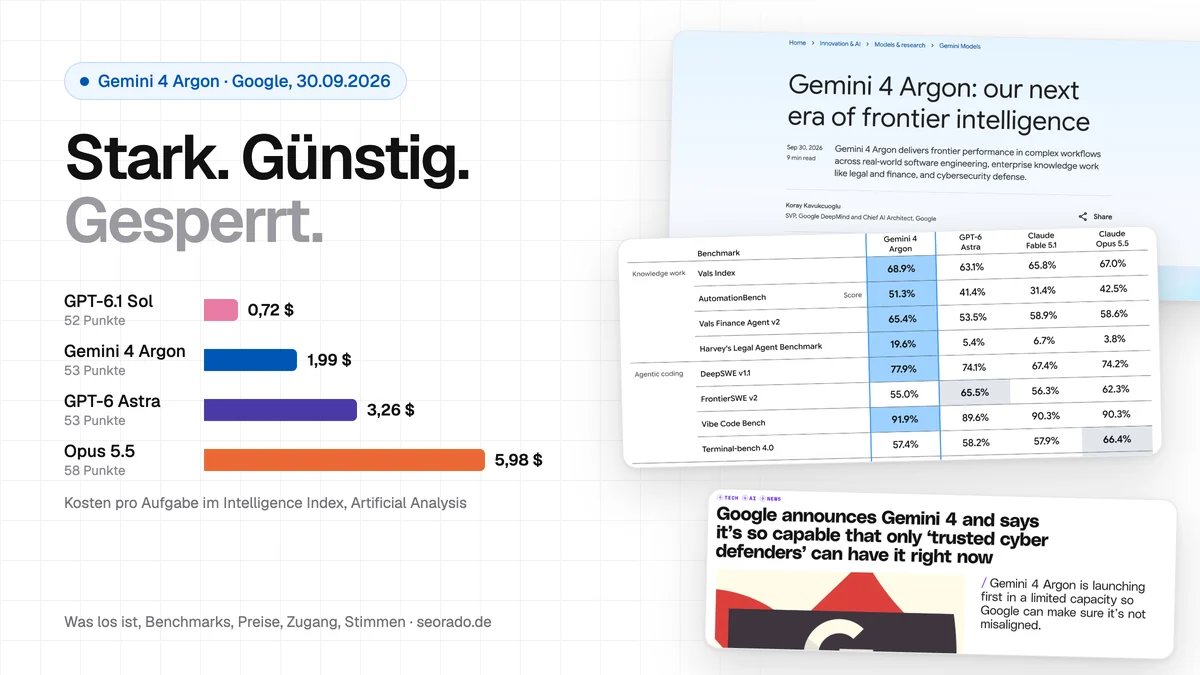
Gemini 4 Argon: Benchmarks, Preis, Zugang und Vergleich mit Opus 5.5 und Sol 6.1
Am 30. September 2026 um 22 Uhr deutscher Zeit hat Google Gemini 4 Argon vorgestellt, sein neues Spitzenmodell. Acht Tage vorher kam Claude Opus 5.5, zwei Tage vorher Claude Sonnet 5.5, einen Tag vorher GPT-6.1 …
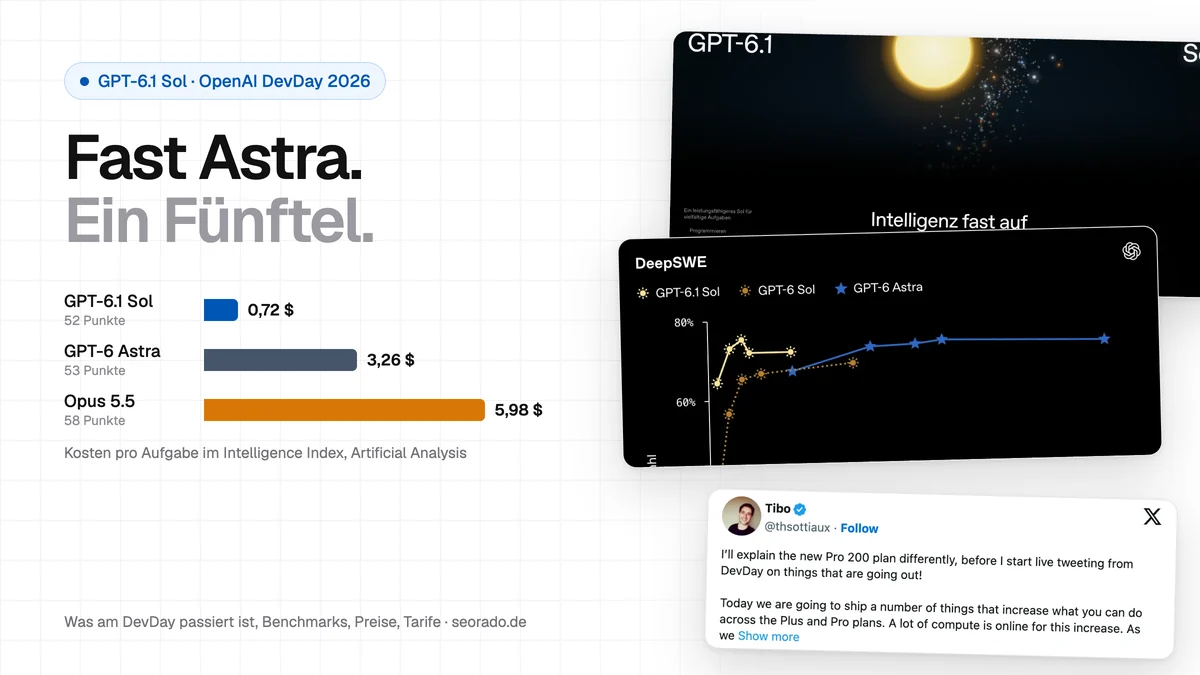
GPT-6.1 Sol und DevDay 2026: Benchmarks, Preise, Limits und Vergleich mit Opus 5.5
Am 29. September 2026 hat OpenAI auf dem DevDay in San Francisco GPT-6.1 Sol vorgestellt, genau sieben Tage nach GPT-6 Sol. Das Versprechen steht in der Überschrift der Ankündigung: Intelligenz fast auf …
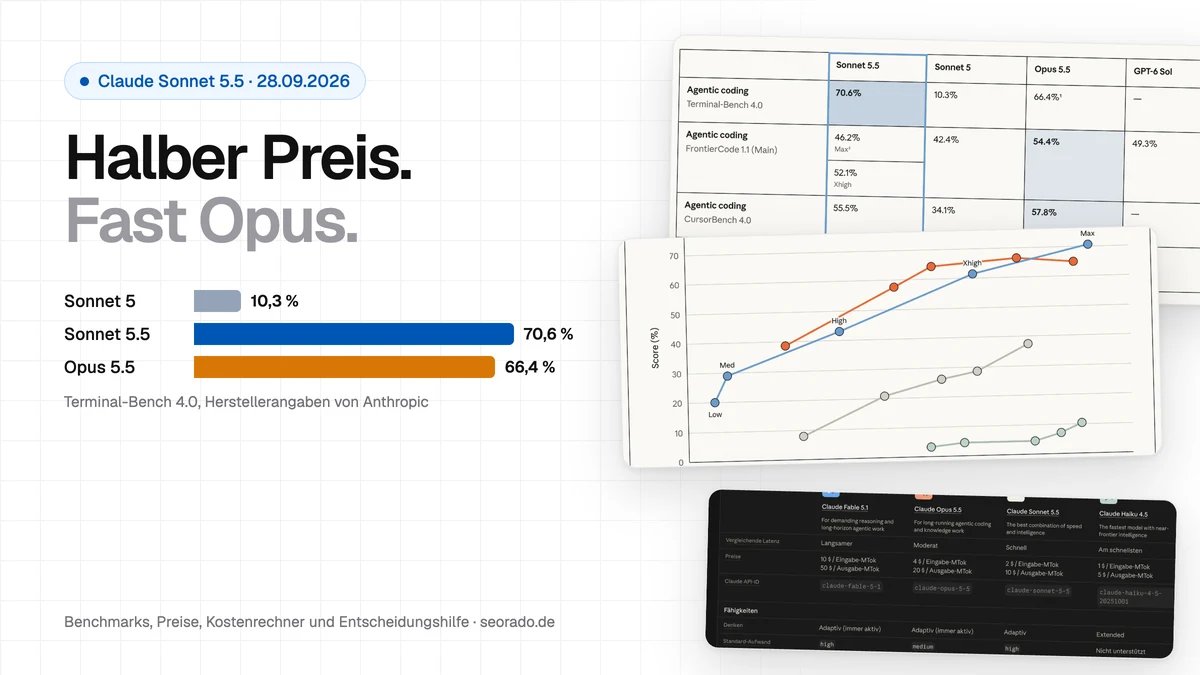
Claude Sonnet 5.5: Benchmarks, Preise, Effort und wann es Opus 5.5 ersetzt
Am 28. September 2026 hat Anthropic Claude Sonnet 5.5 veröffentlicht, das zweite Modell der 5.5-Familie nach Opus 5.5 vom 22. September. Die Kurzfassung steht schon in der Überschrift von The New Stack: Leistung …