Start / Magazin / KI, Automatisierung & Reporting
Textwasserzeichen bei Claude, ChatGPT und Gemini: Vergleich
ArtikelKI, Automatisierung & Reporting06.10.2026/img/magazin/textwasserzeichen-claude-chatgpt-gemini-vergleich-oktober-2026.webp Mario WormuthSEO, GEO & KI-Automatisierung
36 Min. Lesezeit
Das Wichtigste auf einen Blick
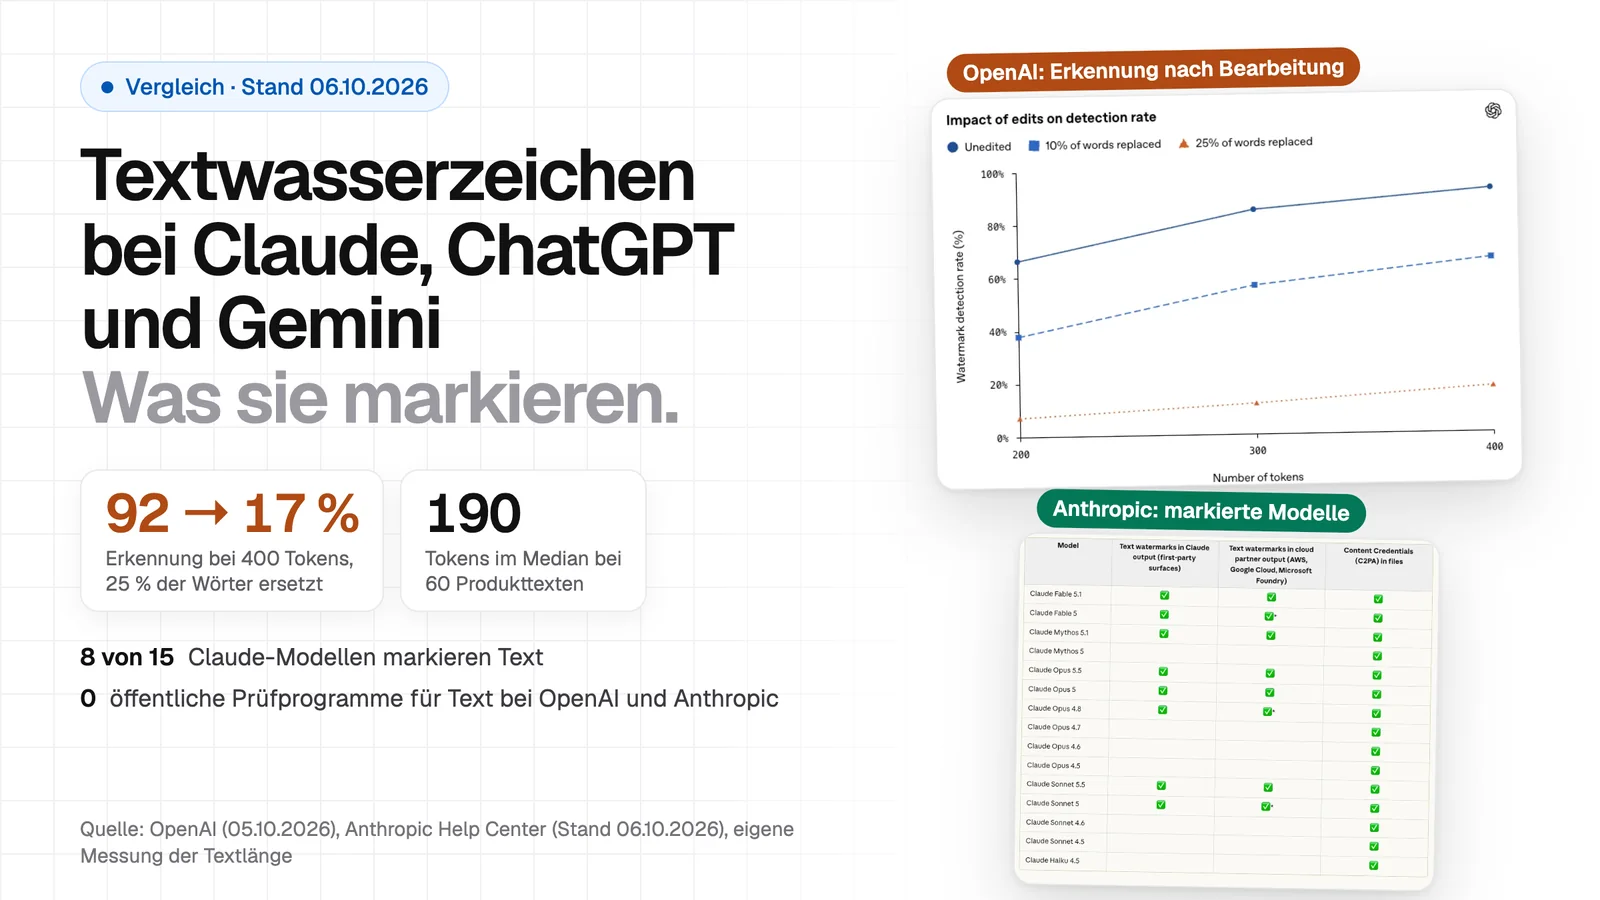
- Alle drei markieren Text oder haben es angekündigt, prüfen darf fast niemand. Anthropic markiert 8 von 15 Claude-Modellen, darunter Opus 5.5 und Sonnet 5.5. OpenAI will ChatGPT und Codex in der EU „in den kommenden Wochen“ markieren. Gemini markiert in der Gemini-App seit der Ankündigung vom 14.05.2024. Eine öffentliche Textprüfung bietet keiner.
- Nur OpenAI veröffentlicht Zahlen. Bei 400 Tokens liegt die Erkennung bei 92 Prozent, mit 10 Prozent ersetzter Wörter bei 66, mit 25 Prozent bei 17. Bei 200 Tokens sind es nach dem Diagramm 66, 38 und 7 Prozent. Für Claude und Gemini nennen Anthropic und Google keine Erkennungsraten.
- Produkttexte sind kurz. Der Median meiner 60 deutschen Beschreibungen liegt bei 190,5 Tokens, 41 davon unter 200. Der EU-Kodex nennt das „sehr kurzen Text“, OpenAI zeigt dafür keine Werte.
- Wer überarbeitet, löscht das Signal schnell. Nach OpenAIs Test genügt der Ersatz jedes vierten Wortes. Anthropic schreibt, leichte Bearbeitung entferne die Marke wahrscheinlich nicht ganz, ein Umschreiben jedes Wortes schon. Für Claude und Gemini hat kein Dritter mit echtem Detektor getestet.
- Die EU verlangt von dir kein Wasserzeichen. Markieren muss der Anbieter. Als Betreiber legst du Text offen, der die Öffentlichkeit über Angelegenheiten von öffentlichem Interesse informiert, und auch das entfällt bei inhaltlicher Prüfung mit benannter Verantwortung. Gewöhnliche Produktbeschreibungen nennt die Kommission als Beispiel außerhalb der Pflicht.
- Für SEO gibt es keinen Beleg. Keine der geprüften Quellen zeigt, dass Google markierte Texte anders behandelt. Auch die Praktiker auf LinkedIn, X, Reddit und YouTube begründen ihre Gelassenheit mit Googles Qualitätslinie und nicht mit Daten.
- Meine Empfehlung: Nicht tarnen, sondern prüfen und verantworten. Das schützt Texte mit und ohne Wasserzeichen und kostet weniger als jedes Umschreiben.
Inhaltsverzeichnis13 Abschnitte
- Wer markiert Text, und wer darf prüfen?
- Was seit 2024 passiert ist: OpenAI im Archivvergleich
- Produkttexte sind kurz: Wo meine 60 Texte auf OpenAIs Kurve liegen
- Was nach dem Überarbeiten übrig bleibt
- Was die EU von Shopbetreibern verlangt: Artikel 50 in der Praxis
- Ändert das etwas für SEO und GEO?
- Was Praktiker auf LinkedIn, X, Reddit und YouTube sagen
- Meine Einschätzung: nicht tarnen, sondern prüfen und verantworten
- Gegenhypothesen: Was gegen meine Einordnung spricht
- Grenzen der Daten
- Häufige Fragen zu Textwasserzeichen
- Fazit
- Quellen
Die meisten Produktbeschreibungen aus meinem Test mit KI sind kürzer als 200 Tokens. Genau an dieser Zahl zieht die EU eine Linie: Der Verhaltenskodex zur Kennzeichnung nennt Text unter 200 Tokens „sehr kurz“ und nimmt ihn aus der Wasserzeichen-Maßnahme für Anbieter aus, und OpenAI zeigt Erkennungsraten erst ab 200 Tokens. Bei 41 von 60 deutschen Produktbeschreibungen lag ich darunter, der Median beträgt 190,5 Tokens. Das habe ich am 6. Oktober 2026 gemessen, einen Tag nachdem OpenAI angekündigt hatte, Text aus ChatGPT in der EU zu markieren.
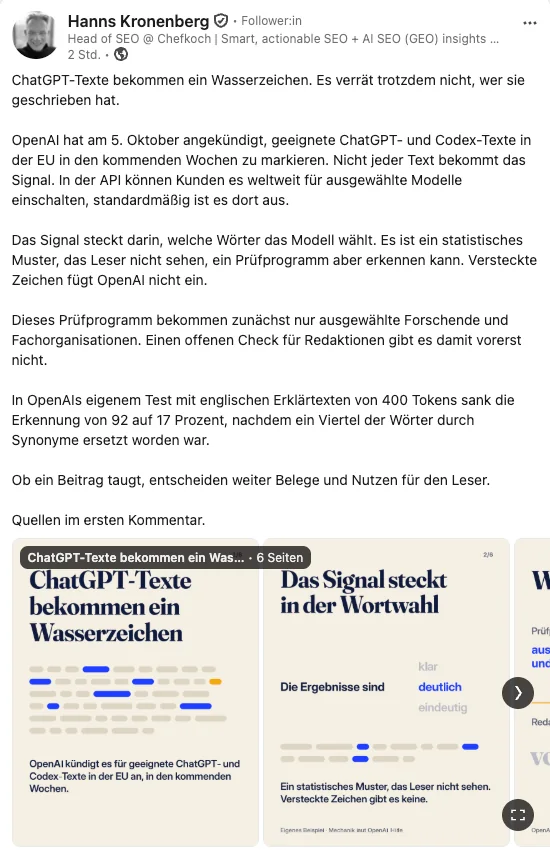
Den Anstoß gab der LinkedIn-Beitrag von Hanns Kronenberg, Head of SEO bei Chefkoch. Er fasst OpenAIs Ankündigung zusammen und nennt die Zahl, die hängen bleibt: Die Erkennung sinkt von 92 auf 17 Prozent, wenn ein Viertel der Wörter durch Synonyme ersetzt wird. Ich habe das mit OpenAIs Original verglichen, die Zahlen stimmen. Dort steht auch ein Zwischenwert, den ein Post kaum unterbringt: Bei 10 Prozent ersetzter Wörter sind es noch 66 Prozent. Und die Diagramme zeigen Werte für 200 Tokens, die im Text fehlen.
Daraus ist ein Vergleich geworden: Wer markiert Text bei Claude, ChatGPT und Gemini, wer darf ihn prüfen, welche Zahlen veröffentlichen die Anbieter, und was verlangt die EU von dir als Shopbetreiber? Dazu kommen drei Werkzeuge. Ein Finder zeigt, ob dein Modell markiert. Ein Änderungsmesser legt deine Endfassung auf OpenAIs Messpunkte. Ein Pflicht-Check geht Artikel 50 der KI-Verordnung für einen konkreten Text durch.
Beim Lesen und Auswerten hat mir KI geholfen (Claude Code): Sie hat die Seiten der Anbieter, der EU-Kommission und über 20 Fachbeiträge gelesen und die Fundstellen herausgesucht. Dazu habe ich LinkedIn, X, Reddit und YouTube nach Diskussionen durchsucht und die Kommentare gelesen. Jedes Zitat und jede Zahl ist per Skript gegen die gespeicherte Quelle geprüft, die Längenmessung lief als Skript. Welche Schlüsse ich daraus ziehe, ist meine Einschätzung. Eine Messung der Wasserzeichen selbst enthält der Beitrag nicht. Ohne öffentlichen Detektor wäre sie ein Nachbau mit eigenem Schlüssel und kein Test von Claude oder ChatGPT.
Lieber ansehen als lesen? Das Erklärvideo fasst die Befunde in gut anderthalb Minuten zusammen.
Transkript des Videos lesen
Trägt ein KI-Text ein Wasserzeichen, und was bleibt davon bei deinen Produkttexten? Ich habe die Quellen ausgewertet, mit KI-Unterstützung, und 60 deutsche Produktbeschreibungen vermessen. Der Fund: Der Median liegt bei 190 Tokens. Die EU nennt Text unter 200 Tokens "sehr kurz". Ein Textwasserzeichen ist ein verborgenes Muster in der Wortwahl. Du siehst nichts, ein Prüfprogramm erkennt es. Anthropic markiert 8 von 15 Claude-Modellen. OpenAI kündigt es für ChatGPT in der EU an, Google nutzt es in der Gemini-App. Prüfen darf bisher fast niemand. Wie stabil ist das? Nur OpenAI nennt Zahlen. Bei 400 Tokens erkennt der Detektor in dessen Test 92 Prozent. Ersetzt du 10 Prozent der Wörter, sind es 66, bei 25 Prozent nur noch 17. Und deine Produkttexte? 41 von 60 sind kürzer als 200 Tokens. Genau dort zeigt OpenAI keine Werte. Bei 200 Tokens sind es laut Diagramm schon ohne Änderung nur etwa 66 Prozent. Was verlangt die EU? Von dir kein Wasserzeichen. Offenlegen musst du nur Text zu Themen von öffentlichem Interesse, und auch das entfällt bei inhaltlicher Prüfung mit benannter Verantwortung. Gewöhnliche Produktbeschreibungen nennt die Kommission als Beispiel außerhalb der Pflicht, solange sie keine Gesundheits- oder Sicherheitsaussagen enthalten. Mein Rat: Nicht tarnen, sondern prüfen und verantworten. Finder, Änderungsmesser und Pflicht-Check findest du im Beitrag.
Wer markiert Text, und wer darf prüfen?
Seit dem 2. August 2026 gilt Artikel 50 der KI-Verordnung. Anbieter von KI-Systemen müssen Text in einem maschinenlesbaren Format kennzeichnen. Wie die drei großen Anbieter das umsetzen, steht verstreut in Blogbeiträgen, Hilfeseiten und einer Release Note. Ich habe die Angaben nebeneinandergelegt.
| OpenAI (ChatGPT, Codex, API) | Anthropic (Claude) | Google (Gemini) | |
|---|---|---|---|
| Verfahren | textGrain, eigenes Verfahren: ein statistisches Signal in der Wortwahl. Open Source ist angekündigt | Eine Version von SynthID-Text von Google DeepMind | SynthID-Text, Nature 2024. Der Referenzcode ist offen |
| Start und Geltung | API: wählbar seit 05.10.2026, weltweit. ChatGPT und Codex: in den kommenden Wochen, nur EU | Modelle ab 02.08.2026 zum Start, ältere werden nachgerüstet. Weltweit. Stand 01.10.2026: 8 von 15 Modellen | Gemini-App und Web, angekündigt am 14.05.2024. Region und Standard nennt Google nicht, Gemini API und Vertex AI sind für Text nicht belegt |
| Standard | API: aus. ChatGPT und Codex in der EU: an | An bei unterstützten Modellen. Eine Option zum Abschalten ist nicht belegt | Für Text nicht belegt |
| Textprüfung öffentlich? | Nein. Antrag für ausgewählte Forschende und Fachorganisationen | Nein. Private Preview für berechtigte Organisationen und verpflichtete Unternehmen | Nein belegt. Die Gemini-App prüft Bilder, Videos und Audio |
| Eigene Erkennungszahlen | Ja, nur Englisch: nach Länge und nach Synonymersatz | Keine | Für Gemini keine Erkennungsrate. Nature nennt nahezu 20 Millionen Antworten für die Qualität |
| Genannte Schwächen | Kurze Texte, wenig Wortwahl-Spielraum (Mathematik), Bearbeitung, Übersetzung | Kleine Textmengen, Faktentexte, Code, Korrekturlesen, vollständiges Umschreiben | Gründliches Umschreiben, Übersetzen, faktische Antworten |
| Bilder und Audio | C2PA und SynthID, öffentlich prüfbar | C2PA-Angaben in Dateien | SynthID, Prüfung in der Gemini-App |
Quellen: OpenAI, 05.10.2026; Anthropic Help Center, 01.10.2026, und Beitrag vom 14.08.2026; Google DeepMind, 14.05.2024, Nature, 23.10.2024, und Gemini-Hilfe, Abruf 06.10.2026. „Nicht belegt“ heißt: in den geprüften Seiten nicht gefunden. Das beweist nicht, dass es fehlt.
Claude: Markierung laut Anthropic, Modellliste mit Stand 1. Oktober
Anthropic markiert weltweit und nutzt laut eigener Angabe eine Version von SynthID-Text, dem Verfahren, das Google DeepMind 2024 in Nature veröffentlicht hat. Das Signal liegt in der Wortwahl, es werden weder Zeichen noch Tokens hinzugefügt. Im Help Center steht, für welche Modelle das gilt: Opus 5.5 und Sonnet 5.5 sind dabei, ebenso Opus 5, Sonnet 5, Opus 4.8, Fable 5 und 5.1 sowie Mythos 5.1. Opus 4.7 und älter, Sonnet 4.6 und älter, Haiku 4.5 und Mythos 5 stehen ohne Haken. Anthropic nennt als Orte Claude, Claude Code, Claude Cowork, Claude Tag und die API, und die Tabelle gilt auch für die Ausgabe über AWS, Google Cloud und Microsoft Foundry. Bei Amazon Bedrock soll der Rollout bis zum 12. Oktober abgeschlossen sein.
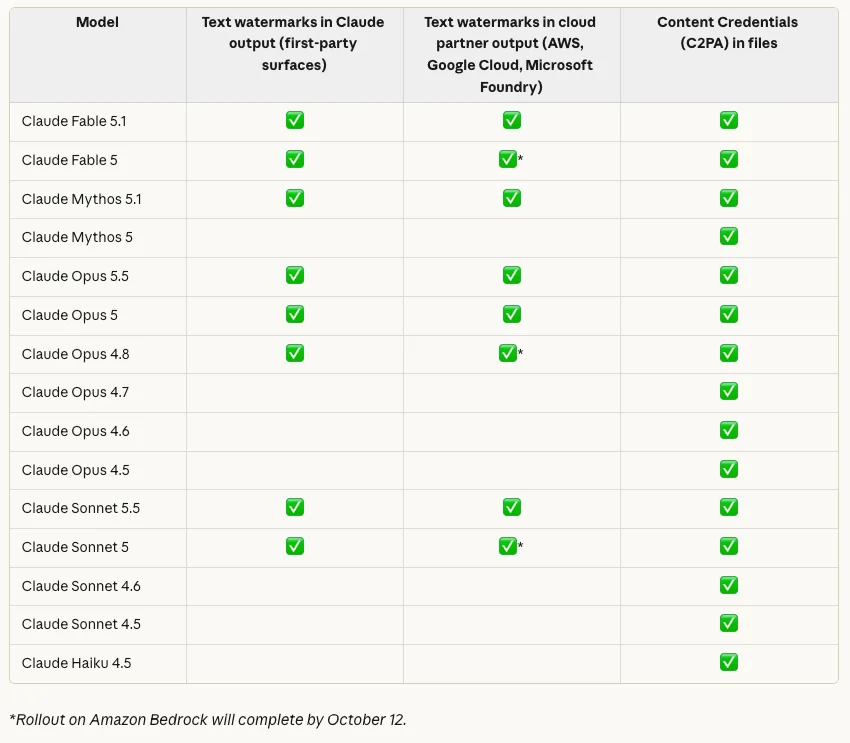
Das zeitliche Bild ist weniger eindeutig, als es im August klang. Anthropic schrieb am 14. August von „künftigen Modellen“, einige Medien lasen das so, als markiere Claude schon alles, und t3n hat daraufhin zwei Artikel korrigiert. Verlässlich ist die Tabelle vom 1. Oktober, und sie ändert sich: Früher erschienene Modelle rüstet Anthropic laut Help Center nach. Für dich heißt das: Schau nicht auf das Erscheinungsdatum, sondern in die Tabelle.
OpenAI: textGrain, erst EU, Detektor auf Antrag
OpenAI hat am 5. Oktober die Ankündigung seines Textwasserzeichens textGrain veröffentlicht. Es besteht aus drei Maßnahmen: In der API können Kunden weltweit für ausgewählte Modelle ein Wasserzeichen einschalten, standardmäßig bleibt es aus. In ChatGPT und Codex kommt es „in den kommenden Wochen“, in allen Plänen, aber nur in der EU. Und den Detektor bekommen zunächst nur ausgewählte Forschende und Fachorganisationen auf Antrag. Welche API-Modelle gemeint sind und wie man die Option aktiviert, habe ich weder in der Ankündigung noch in der API-Dokumentation gefunden.
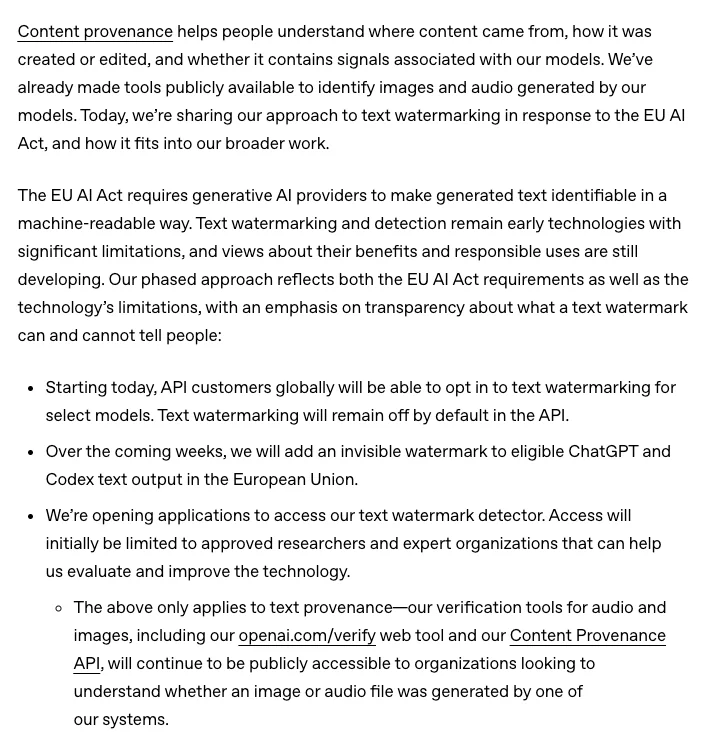
Zwei Randnotizen helfen beim Einordnen. Bilder und Audio sind bei OpenAI weiter öffentlich prüfbar, über openai.com/verify, mit C2PA und SynthID. Für Text nutzt OpenAI nicht SynthID, sondern textGrain. Wer liest, OpenAI bringe SynthID zu mehr Inhalten, wie es Google in einer I/O-Meldung schreibt, sollte also die Art des Inhalts dazusetzen.
Google: am längsten dabei, am wenigsten dazu
Google hat SynthID für Text in der Gemini-App und im Web am 14. Mai 2024 angekündigt. Region, Standard und betroffene Modelle nennt Google in den geprüften Quellen nicht, und für die Gemini API und Vertex AI steht dort nichts zu Text. Die Gemini-App prüft laut ihrer Hilfeseite Bilder, Videos und Audio, keinen Text. Für Gemini nennt das Nature-Paper keine Erkennungsrate, sondern ein Qualitätsexperiment mit nahezu 20 Millionen Gemini-Antworten. Für offene Modelle wie Gemma und Mistral gibt es Erkennungsraten. Der Referenzcode von SynthID-Text ist offen, die Produktionsversion steckt in Hugging Face Transformers.
Welches Modell du nutzt, entscheidet also, ob dein Text ein Signal trägt. Der Finder gibt die Angaben der Anbieter wieder, mit Quelle und Stand.
„Zugang“ zählt nur bei Claude, der Standort nur bei ChatGPT und Codex, das jeweils andere Feld ist dann gesperrt. „Nicht markiert“ heißt: laut Anbieter nicht in der Liste oder nicht vorgesehen. Es beweist keinen menschlichen Autor. Der Finder prüft keinen Text, er gibt die Angaben der Anbieter wieder.
Was seit 2024 passiert ist: OpenAI im Archivvergleich
OpenAI hatte im August 2024 drei Gründe genannt, warum die Firma ein Textwasserzeichen nicht veröffentlicht. Ich habe diesen Nachtrag, eine Wayback-Kopie vom 06.08.2024, neben die Ankündigung vom 05.10.2026 gelegt und geschaut, was davon beantwortet wurde. Das ist ein Archivvergleich und kein Test. Mein Befund steht in der rechten Spalte, die Zitate sind OpenAIs Wortlaut.
| Thema | OpenAI im August 2024 | OpenAI am 05.10.2026 | Mein Befund |
|---|---|---|---|
| Umgehbarkeit | „highly accurate and even effective against localized tampering, such as paraphrasing“, aber weniger robust bei Übersetzung, Umschreiben mit einem anderen Modell oder eingeschobenen Sonderzeichen | Bei 400 Tokens sinkt die Erkennung von etwa 92 auf 66 Prozent, wenn 10 Prozent der Wörter durch Synonyme ersetzt werden, und auf 17 Prozent bei 25 Prozent. „Editing can weaken the watermark“ | Die Robustheit gegen kleine Änderungen von 2024 ist jetzt beziffert, und schon der Ersatz jedes vierten Wortes lässt wenig übrig. Ob textGrain dasselbe Verfahren wie 2024 ist, sagt OpenAI in Ankündigung und Bericht nicht. Zahlen zu Übersetzung gibt es nicht |
| Nicht-Muttersprachler | Das Verfahren könne die Nutzung von KI als Schreibwerkzeug für Nicht-Muttersprachler stigmatisieren | Kommt in der Ankündigung und im technischen Bericht nicht vor. Getestet ist Englisch, Deutsch steht in keiner Datei | Der Punkt bleibt offen. Ob die Erkennung bei deutschen Texten genauso arbeitet, ist nicht veröffentlicht |
| Falschmeldungen bei großen Mengen | Bei großen Textmengen entstehe trotz niedriger Rate eine große Zahl falscher Treffer | Ziel-Falschpositivrate 1 Prozent beim Längen-Diagramm. Wegen des „risk of missed watermarks and false positives“ ist der Detektor nicht öffentlich | OpenAI löst das Problem durch gesperrten Zugang. Bei 1 Prozent wären es rechnerisch 100 Fehltreffer je 10.000 menschlichen Texten. Die Rechnung ist meine, nicht OpenAIs |
| Metadaten als Alternative | Metadaten seien kryptografisch signiert und hätten keine Falschmeldungen. OpenAI erforscht sie auch für Text | Content Credentials gibt es nur für Bilder, bei Text nennt die Ankündigung allein das Wasserzeichen | Für Text ist die Metadaten-Idee von 2024 in der Ankündigung nicht aufgegriffen |
Quellen: OpenAI, Nachtrag vom 04.08.2024 im Beitrag vom 07.05.2024 (Wayback-Kopie vom 06.08.2024), und OpenAI vom 05.10.2026, Abruf beider Seiten 06.10.2026. Die Zitate sind OpenAIs Originalwortlaut.
Der Fortschritt liegt bei den Zahlen: Zum ersten Mal können Betreiber Größenordnungen sehen, wie viel Signal nach Überarbeitung übrig bleibt. Die Begründung für den Schritt liefert OpenAI selbst. Der Ansatz sei „phased“ und spiegele die EU-Vorgabe und die Grenzen der Technik. Zwei der drei Einwände von 2024 sind damit nicht gelöst, sondern in Zahlen und in einen eingeschränkten Detektorzugang übersetzt. Der übrige Einwand, die Nachteile für Nicht-Muttersprachler, kommt in OpenAIs Unterlagen von 2026 nicht mehr vor. Ich lese das nicht als Vorwurf. Es zeigt, wie früh das Verfahren ist, und es erklärt, warum du dich nicht darauf verlassen solltest, dass ein Text eindeutig als KI-Text erkannt wird. Wie schwach solche Erkennung ist, habe ich im Beitrag über KI-Texte erkennen an den Detektoren ohne Wasserzeichen beschrieben, den ich am 06.10.2026 auf den neuen Stand gebracht habe.
Wie eng die Daten liegen
Die Chronologie zeigt, dass sich fast alles Entscheidende seit Juni 2026 abspielt. Zwei Daten liegen noch vor uns: der 12. Oktober für Amazon Bedrock und der 2. Dezember, an dem die Frist für Systeme endet, die schon vor dem 2. August im Markt waren.
Quellen: Google DeepMind (14.05.2024), OpenAI (04.08.2024 und 05.10.2026), Nature (23.10.2024), EU-Kommission (Kodex 10.06.2026, Leitlinien 20.07.2026, Geltungsbeginn 02.08.2026), TechCrunch (11.08.2026), Anthropic (14.08. und 01.10.2026). Die letzten beiden Zeilen liegen in der Zukunft und stammen aus der Verordnung und einer Fußnote von Anthropic.
Produkttexte sind kurz: Wo meine 60 Texte auf OpenAIs Kurve liegen
Im Test zu KI-Produkttexten habe ich am 3. Oktober 2026 zehn Produkte mit drei Aufträgen an zwei Modelle gegeben, GPT-6.1 Sol und Claude Sonnet 5.5. Das ergibt 60 Pakete aus Beschreibung, Titel, Meta-Beschreibung und Alt-Text. Für diesen Beitrag habe ich nur die Beschreibung gezählt, im Auftrag waren es 100 bis 150 Wörter, und sie mit dem OpenAI-Tokenizer o200k_base in Tokens umgerechnet. Ein Token ist ein Wortstück, aus dem das Modell Text zusammensetzt, und die Anbieter geben Längen in dieser Einheit an.
Die Beschreibungen haben 101 bis 133 Wörter, im Median 115. In Tokens sind es 157 bis 262, der Median liegt bei 190,5. Pro Wort ergibt das 1,68 Tokens. 41 von 60 Texten liegen unter 200 Tokens, alle 60 unter 400. Bei beiden Modellen sieht es ähnlich aus: Bei Sol sind es 21 von 30 Texten unter 200, bei Sonnet 5.5 sind es 20 von 30. Der Auftrag macht einen Unterschied. Ohne Datenblatt (Auftrag A) liegen alle 20 Beschreibungen unter 200 Tokens, bei 1,52 Tokens je Wort. Mit Herstellerdaten (Aufträge B und C) sind es nur 9 und 12 von 20, bei rund 1,76 Tokens je Wort. Diese Texte enthalten mehr Zahlen und Maße: Im Mittel stehen 5,85 (B) und 7,15 (C) Wörter mit Ziffer je Text, bei Auftrag A sind es 0,8.
GPT-6.1 SolClaude Sonnet 5.5OpenAI-Messpunkte bei 200, 300 und 400 Tokens
Was die 200 Tokens bedeuten
OpenAIs kürzester Messpunkt liegt bei 200 Tokens. Dort liegt die Erkennung bei unbearbeiteten englischen Erklärtexten nach dem Diagramm bei etwa 66 Prozent. Werden 10 Prozent der Wörter ersetzt, sind es etwa 38, bei 25 Prozent etwa 7 Prozent. Im Text nennt OpenAI für Psychologie-Antworten etwa 80 Prozent bei 200 Tokens, und die Kurve für Texte mit wenig Wortwahl-Spielraum, in OpenAIs Beispiel Mathematik, startet bei etwa 36,5 Prozent. Unter 200 Tokens zeigt OpenAI nichts, und der Trend in beiden Diagrammen läuft nach unten. Die Werte habe ich aus den Pfaden der beiden Diagramme berechnet, weil OpenAI sie nur als Bild zeigt. Sie decken sich mit den Zahlen im Text: etwa 80 und 95 Prozent bei 200 und 400 Tokens, 92, 66 und 17 Prozent bei den Bearbeitungen.
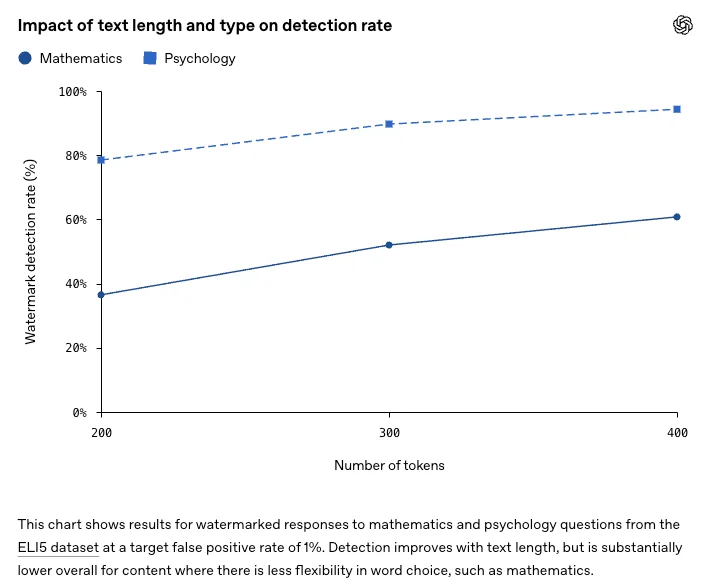
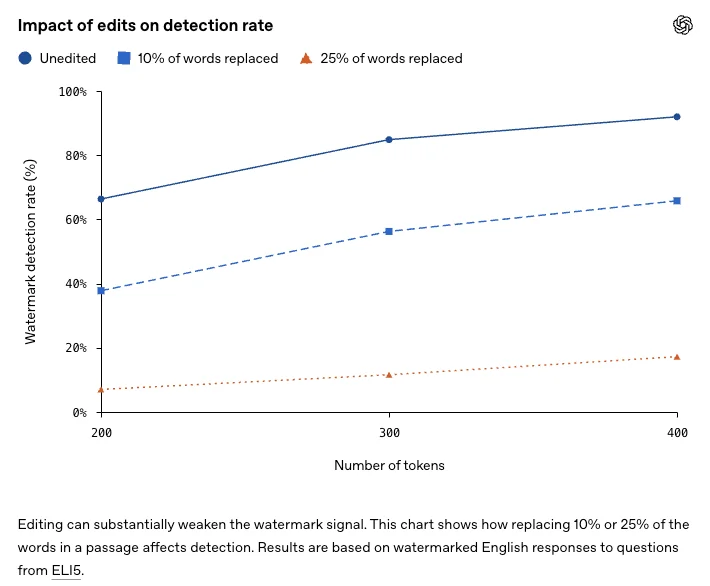
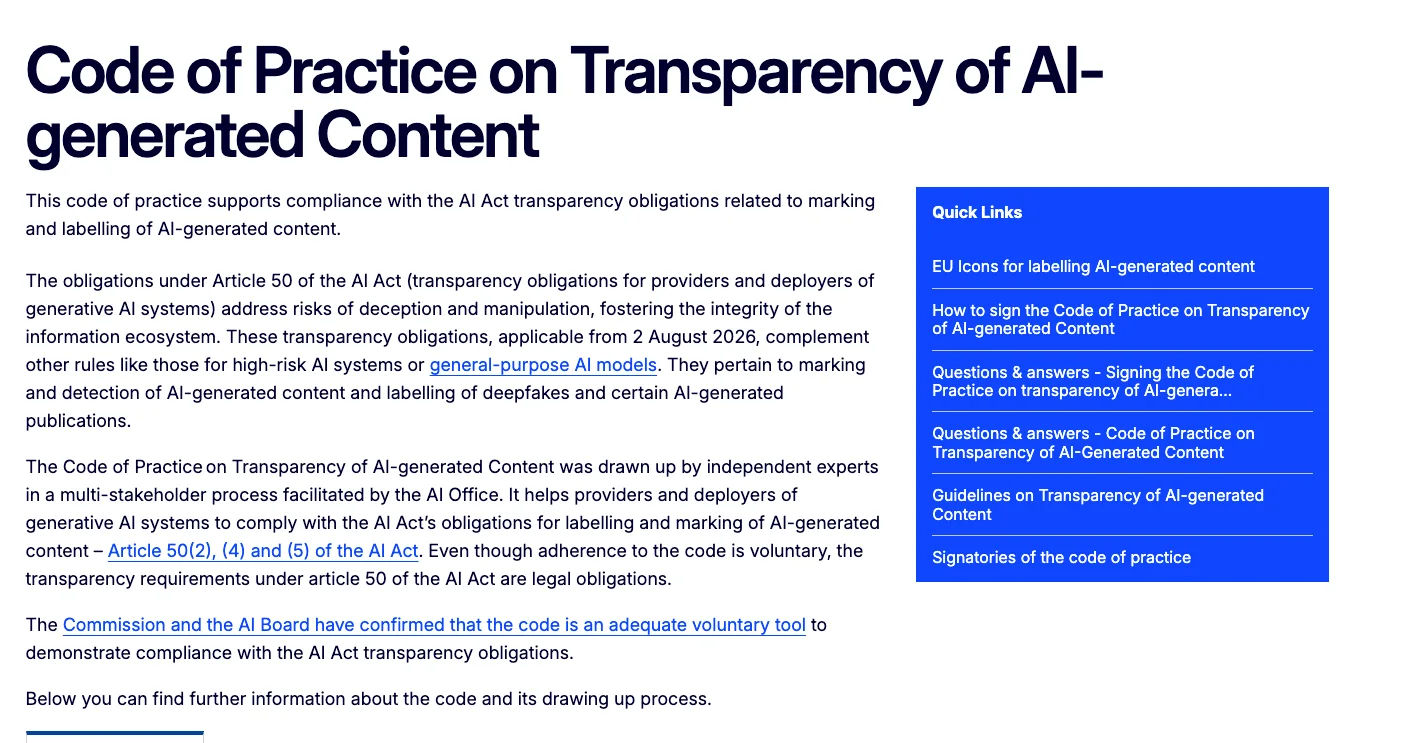
Die EU zieht dieselbe Linie. Im Verhaltenskodex zur Kennzeichnung KI-erzeugter Inhalte steht, dass Unterzeichner für Fließtext über 200 Tokens ein Wasserzeichen setzen müssen, auch wenn es weniger zuverlässig ist, und dass „sehr kurzer Text“ Text unter 200 Tokens meint. Die Begründung: Nach dem Stand der Technik reicht die Zuverlässigkeit ab etwa 200 Tokens für ein Grundniveau. Meine Produktbeschreibungen liegen mit einem Median von 190,5 Tokens knapp unter dieser Grenze. Anthropic beschreibt denselben Zusammenhang ohne Zahlen: Auf kleinen Textmengen funktioniere die Erkennung nicht gut, weil es weniger Wortentscheidungen gibt, und bei Faktenpassagen finde das Signal nichts, woran es ansetzen kann.
Daraus ziehe ich zwei Schlüsse. Erstens tragen Titel, Meta-Beschreibungen und Alt-Texte, mit unter 60 oder 155 Zeichen weit unter 200 Tokens, praktisch kein Signal. Zweitens liegt die Erkennung bei Beschreibungen um 190 Tokens, die voll mit Maßen und Materialien sind, schon ohne Überarbeitung bei höchstens den 66 Prozent, die OpenAI bei 200 Tokens zeigt, eher darunter. Das ist eine Einordnung aus den Herstellerzahlen für andere Texte und keine Messung an ChatGPT oder Claude. Die Kurve gilt außerdem für textGrain, nicht für das SynthID-Verfahren bei Claude und Gemini, und sie gilt für englische Texte. Wie sich deutsche Texte verhalten, hat keiner der drei Anbieter veröffentlicht.
Was nach dem Überarbeiten übrig bleibt
Die wenigsten Shops lassen KI-Text roh stehen. Sie kürzen, setzen eigene Daten ein und tauschen Wörter. Der Änderungsmesser vergleicht die KI-Fassung mit deiner Endfassung. Er zählt die Wörter des Originals, die in der Endfassung nicht in derselben Reihenfolge wieder vorkommen, schätzt die Länge in Tokens und rechnet zwischen OpenAIs Messpunkten.
So rechne ich: Die Länge der Endfassung in Tokens schätze ich mit dem Faktor 1,68 Tokens je Wort, gemessen mit dem OpenAI-Tokenizer o200k_base an 60 deutschen Produktbeschreibungen. Welcher Tokenizer bei GPT-6.1 Sol oder Claude gilt, ist nicht öffentlich bestätigt. Der geänderte Anteil ist der Teil der Originalwörter, der in der Endfassung nicht in derselben Reihenfolge wieder vorkommt. Zwischen den Messpunkten (0, 10 und 25 Prozent, 200, 300 und 400 Tokens) rechne ich linear. Die Messpunkte stammen aus englischen Erklärtexten und nennen den Ersatz durch Synonyme. Ob eine echte Umschreibung dasselbe bewirkt, ist offen. Das Werkzeug ist kein Detektor und prüft keinen Text auf ein Wasserzeichen.
Probiere die drei Beispiele aus. Bei „Leicht überarbeitet“ sind 18 Prozent der Wörter geändert, und das Werkzeug zeigt etwa 22 von 100 nach OpenAIs Messpunkten. Beim stark umgeschriebenen Text sind es 7, der Randwert bei 25 Prozent. Wenn nur Satzzeichen und Großschreibung geändert sind, bleibt alles beim Alten, denn das Signal sitzt in der Wortwahl und nicht in der Schreibweise. Unter 5 Prozent geänderter Wörter hebt das Werkzeug die Zeile „Unverändert“ hervor. Das ist meine Faustregel und keine Angabe von OpenAI. Bei 25 Prozent ersetzter Wörter nennt OpenAI nur noch rund 17 Prozent Erkennung bei 400 Tokens.
Was Dritte gemessen haben
Wer wissen will, ob Übersetzen oder Umschreiben das Wasserzeichen entfernt, findet viele Behauptungen und wenige Messungen. Ich habe zusammengestellt, was die geprüften Quellen sagen und wie belastbar es ist.
| Quelle | Was sie sagt oder getestet hat | Art der Quelle |
|---|---|---|
| OpenAI, 05.10.2026 | Synonymersatz von 10 und 25 Prozent der Wörter, 400 Tokens, englische Erklärtexte: Erkennung 92, 66 und 17 Prozent | Herstellermessung am eigenen Verfahren. Der Detektor ist nicht öffentlich, Nachprüfung ist nicht möglich |
| OpenAI, 04.08.2024 | Übersetzung, Umschreiben mit einem anderen Modell und eingeschobene Sonderzeichen umgehen das Verfahren. Zahlen fehlen | Herstellerangabe zu einem früheren Verfahren |
| Google DeepMind, 14.05.2024 | Übersteht Zuschneiden, wenige Wortänderungen und milde Paraphrase. Bei gründlichem Umschreiben oder Übersetzen sinkt die Konfidenz stark. Zahlen fehlen | Herstellerangabe, qualitativ |
| Anthropic, 14.08.2026 | Leichte Bearbeitung entfernt die Marke wahrscheinlich nicht ganz, ein Umschreiben jedes Wortes schon. Zahlen fehlen | Herstellerangabe, qualitativ |
| r/ClaudeAI, 23.08.2026 | Selbstversuch an einem Nachbau von SynthID-Text mit eigenem Schlüssel. Hin-und-zurück-Übersetzung über Deutsch und über Chinesisch entfernte die Marke in je 0 von 10 Fällen. Eine vollständige Nacherzählung durch ein Modell ohne Marke, mit anschließender Faktenkorrektur, entfernte sie in 10 von 10 Fällen, bei 100 von 100 erhaltenen Fakten. Ein Paraphrase-Werkzeug (DIPPER) entfernte sie auch, verfälschte aber jede vierte Aussage | Selbstbericht einer Einzelperson, nicht wiederholt, Nachbau und kein Claude |
| Queen’s University, über AkitaOnRails, 16.08.2026 | Nach einem Paraphrase-Werkzeug etwa 84 Prozent Erkennung, nach Hin-und-zurück-Übersetzung unter 70 Prozent. Geschwächt, nicht null | Sekundärangabe, die Studie ist im Artikel nicht verlinkt |
Keiner dieser Versuche hat Claudes, Gemini oder ChatGPTs echtes Wasserzeichen mit einem echten Detektor geprüft, weil es keinen öffentlichen gibt. Stand der Quellen: 06.10.2026.
Zwei Dinge fallen auf. Erstens hat keiner dieser Versuche ein echtes Wasserzeichen mit einem echten Detektor geprüft, weil es keinen öffentlichen gibt. Der einzige dokumentierte Selbstversuch, ein Beitrag in r/ClaudeAI vom 23.08.2026, läuft an einem Nachbau, und die Medien haben nichts selbst gemessen. Zweitens widersprechen sich die Aussagen zur Übersetzung: OpenAI und Google nennen sie als Schwachstelle, der Nachbau-Versuch entfernte die Marke damit nicht, und die Queen’s-Zahlen zeigen eine Schwächung statt eines Verschwindens. Diesen Widerspruch kann ich nicht auflösen. Ich würde weder darauf setzen, dass Übersetzen schützt, noch darauf, dass es tarnt.
Dort, wo Umschreiben sicher wirkte, hat es Inhalt gekostet: Im Reddit-Versuch verfälschte das Paraphrase-Werkzeug jede vierte Aussage, also Zahlen, Daten und Namen. Bei Produktdaten ist das der Fehler, den du am wenigsten brauchst. Wie du einen Text mit dem Datenblatt abgleichst, zeigt der Faktencheck der 60 Produkttexte.
Was die EU von Shopbetreibern verlangt: Artikel 50 in der Praxis
Artikel 50 teilt die Pflichten auf. Anbieter eines KI-Systems, das Text erzeugt, müssen die Ausgaben maschinenlesbar kennzeichnen (Absatz 2). Für Systeme, die vor dem 2. August 2026 im Markt waren, gilt dafür eine Frist bis zum 2. Dezember 2026 (Artikel 111 Absatz 4). Betreiber, also du, wenn du ChatGPT oder Claude für dein Unternehmen nutzt, müssen dagegen nur dann offenlegen, dass ein Text künstlich erzeugt oder manipuliert wurde, wenn er veröffentlicht wird, um die Öffentlichkeit über Angelegenheiten von öffentlichem Interesse zu informieren (Absatz 4). Diese Betreiberpflicht gilt seit dem 2. August ohne Schonfrist.
Die Leitlinien der EU-Kommission vom 20. Juli 2026 machen das konkreter. Sie sind nicht bindend, zeigen aber, wie die Kommission liest. Produktbeschreibungen und Werbetexte nennt sie als Beispiel für Text außerhalb der Pflicht, solange sie keine Aussagen zu Gesundheit, Verbrauchersicherheit oder Nachhaltigkeit enthalten. Als Beispiel für Text innerhalb nennt sie die KI-bearbeiteten Teile eines Lifestyle-Artikels über Diäten bei einer Krankheit. Ein Onlineshop oder ein Shop-Blog kommt in den Leitlinien nicht vor, und für Produkttexte mit solchen Aussagen nennen sie keine Rechtsfolge.
Die Ausnahme ist für dich der wichtigste Teil. Eine Offenlegung entfällt, wenn der Text eine menschliche Prüfung oder redaktionelle Kontrolle durchlaufen hat und eine natürliche oder juristische Person die redaktionelle Verantwortung trägt. Beides muss zusammenkommen. Die Leitlinien werden hier deutlich: Menschliche Prüfung heißt inhaltliche Prüfung durch sachkundige Personen, die Faktenprüfung ist das Minimum. Rechtschreib- und Grammatikprüfung, eine bloße Redaktionsrichtlinie, automatisierte Prüfung oder eine flüchtige Freigabe genügen nicht. Ändert die KI den Text nach der Prüfung wesentlich, entfällt die Ausnahme wieder. Wer verantwortet, soll mit Name und Kontakt leicht auffindbar sein, etwa in den AGB oder anderen rechtlichen Nutzerinformationen. Bei einer Website ist das Impressum dafür ein naheliegender Ort, das ist meine Übertragung und steht so nicht in den Leitlinien.
Ein Wasserzeichen ersetzt die Offenlegung nicht. Sie muss ohne technische Hilfsmittel erkennbar sein, und umgekehrt musst du als Betreiber kein Wasserzeichen setzen. Ob du ein vorhandenes entfernen darfst, beantworten Gesetz und Leitlinien nicht. Im Kodex steht ein Verbot in den Nutzungsbedingungen nur für Metadaten-Markierungen, nicht für Textwasserzeichen. Das ist eine Lücke und kein Freibrief, und meine Empfehlung unten setzt nicht auf Tarnen. Verstöße gegen Artikel 50 können laut Leitlinien bis zu 15 Millionen Euro oder 3 Prozent des weltweiten Jahresumsatzes kosten, bei kleinen und mittleren Unternehmen gilt der niedrigere Betrag. Durchgesetzt wird vor allem von den nationalen Marktüberwachungsbehörden, welche in Deutschland zuständig ist, steht in den Quellen nicht.
Der Pflicht-Check geht diese Regeln für einen konkreten Text durch. Er zeigt, welche Regel greift, welche Bedingung der Ausnahme fehlt und wo es steht.
Die letzten drei Felder zählen nur bei Ratgebern zu öffentlichen Themen und bei Produkttexten mit Aussagen zu Gesundheit, Verbrauchersicherheit oder Nachhaltigkeit, sonst sind sie gesperrt. Die Leitlinien der Kommission sind nicht bindend. Sie nennen weder ein Onlineshop-Beispiel noch ein Beispiel für Shop-Blogs.
Ändert das etwas für SEO und GEO?
Die Frage, die Shopbetreiber und SEOs zuerst stellen: Straft Google Texte mit Wasserzeichen ab, oder bevorzugen KI-Antwortsysteme Texte ohne? In den Quellen steht dafür kein Beleg. Ich habe sieben SEO-Quellen gelesen, darunter Sistrix, Seer Interactive und Ahrefs, dazu LSEO, SEO Hacker, Hostinger und Deepak Gupta. Keine davon zitiert eine Google-Aussage oder eine Messung, nach der Google oder ein KI-Antwortsystem Wasserzeichen von Anthropic oder OpenAI ausliest. Ahrefs schreibt zu seinen Daten, es sehe keinen Beleg dafür, dass Google KI-Inhalte allein wegen KI abstraft. Sistrix hält fest, dass Google SynthID-Wasserzeichen bislang nicht als negativen Rankingfaktor genannt hat. Seer argumentiert, Google nutze SynthID-Text seit zwei Jahren bei Gemini und habe es nie fürs Ranking verwendet. Das ist ein Schluss aus Abwesenheit und kein Beleg.
Die einzige Gegenzahl stammt von First Page Sage: Von 1.682 Inhalten auf 139 Websites landeten die mit KI erstellten nach drei Tagen im Schnitt auf Position 11, die anderen auf Position 6, und sie wurden zu 7 statt 12 Prozent in KI-Antworten zitiert. Ich nehme das nicht als Beleg für eine Wirkung von Wasserzeichen. Die Gruppen sind nach KI-Einsatz gebildet und nicht nach einer erkannten Marke, ChatGPT-Texte zählen mit, bevor OpenAI überhaupt markierte, und die Position wurde nach nur drei Tagen gemessen. Die Quelle selbst nennt es eine Korrelation.
Googles Linie bleibt die von 2023, die ich im Beitrag über KI-Texte erkennen mit Wortlaut belegt habe: Bewertet werden Qualität und Zweck, nicht die Herstellung. Wie Google Qualität und Vertrauen beschreibt, steht in der Erklärung zu E-E-A-T. Hanns Kronenberg landet in seinem Beitrag an derselben Stelle: Ob ein Beitrag taugt, entscheiden weiter Belege und Nutzen für den Leser. Offen ist dagegen, was Sistrix als Frage stellt: ob Menschen auf Inhalte klicken, die als „KI-generiert“ gelabelt sind. Dafür liegt noch keine Messung vor.
Was Praktiker auf LinkedIn, X, Reddit und YouTube sagen
Ich habe vier Plattformen nach Beiträgen zum Thema durchsucht und die Kommentare gelesen: auf LinkedIn die Kommentare unter fünf Beiträgen, auf X einen Thread mit seinen Antworten, bei Reddit über 2.200 Kommentare in 13 Threads, davon in acht die bestbewerteten, und auf YouTube die Transkripte von drei Videos. Gepostet habe ich nirgends. Die Stimmen sind überwiegend entspannt. Zwei Gruppen fallen heraus: Menschen, die mit präziser Sprache arbeiten, und Beiträge, die weit über Anthropics eigene Aussagen hinausgehen.
| Wer und wo | Was gesagt oder berichtet wird | Einordnung |
|---|---|---|
| Markus Hövener (Bloofusion), LinkedIn, 07.09.2026 | Erwartet keinen negativen Effekt für SEO: Google ging schon vorher gegen schlechte KI-Inhalte vor, Google sage, die Herstellung sei egal, und Content entstehe selten zu 100 Prozent von Mensch oder KI. In den Kommentaren nennt Dennis Lai Googles Formulierung „unique, valuable, non-commodity content“. | Einschätzung eines Praktikers, keine Messung. Deckt sich mit Googles Linie. |
| Raphael Guldimann (onlineKarma.ch), LinkedIn, 11.08.2026 | Google straft schlechte Texte, nicht KI-Texte. Reine KI-Spam-Seiten könnten abgestraft werden. | Einschätzung, in zehn Kommentaren überwiegend geteilt. |
| Doris Weßels (Professorin, Kiel) und Robert Gies, LinkedIn, 06.10.2026 | Beide lesen OpenAIs Ankündigung als Grenze: Ein Wasserzeichen ist kein wasserfester Beweis. Gies zieht daraus den Schluss, nicht zu fragen, ob KI mitgeschrieben hat, sondern wer was geprüft hat und für das Ergebnis einsteht. | Deckt sich mit OpenAIs eigenen Grenzen und mit meiner Empfehlung. |
| Charles Floate (SEO), X, 30.08.2026, rund 29.000 Aufrufe | Zwei Seiten, nach eigener Angabe zu 100 Prozent mit Claude Opus 5 geschrieben, stehen laut Tweet nach 48 Stunden auf Position 2 beziehungsweise Position 2 der zweiten Ergebnisseite, die erste wurde in der AI Overview zitiert. | Einzelversuch mit zwei Seiten, 48 Stunden, erzwungener Indexierung. Ob Opus 5 am 30.08. schon markierte, ist offen, Anthropics Tabelle stammt vom 01.10. |
| Caleb Ulku (Agentur), YouTube, 14.08.2026, rund 159.000 Aufrufe | Sieht keinen Beleg für eine Abstrafung: Googles SynthID für Bilder laufe seit 2023, und Seiten mit KI-Text und KI-Bildern rankten trotzdem. Umschreiben oder Zeichentausch zum Entfernen koste Qualität und könne Namen und Orte auf der Seite zerstören. | Argumentation per Analogie und Rankingkarten aus dem eigenen Produkt. Eigeninteresse: Er bewirbt ein KI-SEO-System. |
| Reddit r/ClaudeAI, 13. und 14.08.2026 (Thread und FAQ-Thread) | Ein Nutzer (158 Punkte) schreibt, beim Feinschliff eines juristischen Schriftsatzes wähle Claude nach jedem Polieren andere Wörter. Ein anderer (299 Punkte) bezweifelt Anthropics Aussage, die Wortwahl sei meist egal: „overcast“ und „grey“ hießen etwas anderes. Ein dritter (19 Punkte) erwartet, dass Kunden künftig prüfen, ob in geliefertem Code ein Wasserzeichen fehlt. | Erfahrungsberichte und Prognosen, nicht prüfbar und vom Modellwechsel nicht zu trennen. Sie zeigen, wo das Verfahren bei präzisen Texten auf Widerstand stößt. |
| Reddit r/SEO, 24.09.2026 (Thread, laut Arctic Shift 85 Kommentare am 25.09.2026) | Ein Nutzer berichtet von mehreren Seiten mit KI-Text von Claude, Gemini und ChatGPT auf Seite 1. Ein anderer schreibt, er habe Entfernungs-Werkzeuge an einem Nachbau getestet: Bei Texten über etwa 500 Wörtern entferne kaum eines das Muster, ohne den Text zu zerstören. | Selbstberichte ohne Belege. Der zweite steht gegen die Aussage anderer, Umschreiben entferne die Marke leicht. |
Gelesen am 06.10.2026, bei Reddit die Beiträge und die bestbewerteten Kommentare, bei YouTube die Transkripte, nur lesend. Die Aussagen sind Meinungen und Selbstberichte, keine Messungen.
Zwei Dinge fallen mir auf. Fast alle SEO-Stimmen erwarten keine Abstrafung, und sie begründen das mit Googles Qualitätslinie statt mit Daten. Der einzige Versuch, den ich gefunden habe, wird in den Antworten selbst relativiert. Die schärfsten Einwände kommen von Menschen, die genau formulieren müssen. Anthropic schreibt, dass es dem Leser unter den meisten Umständen egal sei, ob das Modell „overcast“ oder „grey“ wählt. Für juristische Texte und Fachtexte stimmt das nicht immer, und diese Frage beantwortet kein Anbieter mit Zahlen.
Außerdem stehen zwei Behauptungen in Beiträgen und Videos im Widerspruch zu Anthropics eigenem Text oder zu den Messungen. Die erste: Ein Text, den Claude nur korrigiert, trage verlässlich das Wasserzeichen, so etwa bei Nadja Buoyardane auf LinkedIn und im Video von Kris von AI2ROI. Anthropic schreibt dagegen, beim Korrekturlesen stammten fast alle Wörter von dir, deshalb bleibe oft kaum etwas übrig, woran das Signal hängen könnte. Die zweite: Auch eine Übersetzung lösche das Wasserzeichen, das sagt Kris im Video als Tatsache. Dazu widersprechen sich die Quellen, wie oben gezeigt, und im einzigen Versuch entfernte die Rückübersetzung die Marke nicht. Und eine LinkedIn-Diskussion hat die Funktionsweise per Gemini-Antwort mit Grün-Rot-Listen erklärt, während Anthropic ein Verfahren aus der SynthID-Familie nennt. Wer Chatbots nach dem Wasserzeichen fragt, bekommt nicht unbedingt das Verfahren des Anbieters beschrieben.
Meine Einschätzung: nicht tarnen, sondern prüfen und verantworten
Wer von einem Wasserzeichen hört, fragt sich oft zuerst, wie man es loswird. Ich würde die Energie woanders einsetzen, aus vier Gründen. Das Umschreiben lässt sich nicht prüfen: Ohne öffentlichen Detektor weißt du hinterher nicht, ob etwas gewonnen ist. Es kostet Inhalt, denn im einzigen dokumentierten Versuch verfälschte das Werkzeug jede vierte Aussage, bei Produktdaten ist das der falsche Preis für ein Signal, das ohnehin kurze Texte kaum trägt. Es bringt für SEO nichts Belegtes. Und es löst die Rechtsfrage nicht, denn ob du offenlegen musst, hängt an Textart, Prüfung und Verantwortung, nicht am Wasserzeichen.
Was ich stattdessen empfehle, ist kurz:
- Lege je Textart eine Prüfstufe fest. Für Produkttexte reicht der Abgleich mit dem Datenblatt, den der Faktencheck der 60 Produkttexte zeigt. Für Ratgeber zu Gesundheit, Sicherheit oder Nachhaltigkeit gehört eine inhaltliche Prüfung mit Faktencheck durch eine sachkundige Person dazu.
- Benenne die verantwortliche Stelle. Name und Kontakt gehören an eine leicht auffindbare Stelle, bei einer Website ist das Impressum ein naheliegender Ort.
- Ändere nach der Freigabe nichts mehr per KI. Wenn doch, prüfe den Text noch einmal.
- Beschreibe deinen Prozess, statt „zu 100 Prozent von Menschen geschrieben“ zuzusagen. Ahrefs sieht Streit um Verträge mit KI-Verbot als wahrscheinlichsten Anwendungsfall eines Nachweises, und Sistrix, Hostinger und SEO Hacker raten übereinstimmend, den Ablauf offenzulegen.
- Prüfe deine Rolle, wenn du eine eigene Anwendung baust. Wer anderen ein System anbietet, das Text erzeugt, ist eher Anbieter als Betreiber. Dann gilt die Markierungspflicht, mit der Frist bis 2. Dezember 2026 für Altsysteme.
Auch bei mir entstehen Texte mit KI als Entwurfshilfe. Ich arbeite mit Claude, Opus 5.5 und Sonnet 5.5, und beide stehen in Anthropics Tabelle. Ob ein einzelner Text auf dieser Seite ein Signal trägt, kann ich nicht prüfen, weil es keinen öffentlichen Detektor gibt. Meine Absicherung ist die, die ich dir empfehle: Primärquellen, Faktencheck gegen die Quelle, eine Person, die freigibt, und die offene Angabe der KI-Hilfe in der Einleitung. Wie sich die beiden Modelle beim Schreiben unterscheiden, steht im Textvergleich von Opus 5.5 und GPT-6.1 Sol.
Gegenhypothesen: Was gegen meine Einordnung spricht
Google könnte Wasserzeichen doch auslesen
Chris Long argumentiert laut Ahrefs, die Erkennung werde für Google billiger. Das ist die einzige Gegenposition in den Quellen, und ich kenne sie nur über Ahrefs, das LinkedIn-Original habe ich nicht gelesen. Möglich ist es, belegt nicht. Käme es so, träfe es zuerst Texte, die ein Modell fast allein geschrieben hat, und die Gegenmaßnahmen blieben dieselben: eigene Daten, inhaltliche Prüfung, eine verantwortliche Person.
Wer sauber umschreibt, ist sicher
Die Quellen widersprechen sich bei der Übersetzung, und keine hat ein echtes Wasserzeichen mit einem echten Detektor getestet. Bei OpenAI sinkt die Erkennung nach 25 Prozent ersetzter Wörter auf 17 Prozent, das ist deutlich, aber nicht null. Sicherheit gibt es weder auf der einen noch auf der anderen Seite.
Ohne Wasserzeichen heißt von Menschen geschrieben
Das behaupten die Anbieter selbst nicht. OpenAI schreibt, ein fehlendes Wasserzeichen beweise keine menschliche Autorenschaft, der Text könne zu kurz, bearbeitet, übersetzt, von einem nicht unterstützten Modell oder von einer anderen Firma sein. Anthropic sagt, ein Treffer zeige nur, dass Claude irgendwann beteiligt war. heise-Autor Malte Kirchner warnt deshalb vor falscher Sicherheit: Das fehlende Zeichen könne wie ein Echtheitssiegel gelesen werden.
Wasserzeichen verschlechtern die Texte
OpenAI hat sein Modell Astra in acht Benchmarks mit und ohne Wasserzeichen verglichen und sieht keine bedeutsamen Unterschiede, bei GPQA Diamond waren es 93,94 Prozent mit und 94,44 Prozent ohne Wasserzeichen. Das Nature-Paper nennt für Gemini ein Experiment mit nahezu 20 Millionen Antworten, ohne Qualitätsverlust. The Decoder weist darauf hin, dass Benchmarks nicht beantworten, ob sich die Textqualität ändert. Für Shop-Texte hat das niemand gemessen. Beide Tests sind Herstellerangaben. Aus der Praxis kommt ein anderer Einwand, nämlich dass Wortwahl in präzisen Texten nie egal ist, siehe die Stimmen oben.
Grenzen der Daten
- Kein öffentlicher Detektor. Ich habe nichts an echten Texten von Claude, ChatGPT oder Gemini geprüft. Die Versuche Dritter sind Nachbauten oder Sekundärangaben.
- OpenAIs Zahlen: englische ELI5-Texte, beim Längen-Diagramm Ziel-Falschpositivrate 1 Prozent, Synonymersatz statt freier Überarbeitung. Die Werte bei 200 und 300 Tokens habe ich aus den Diagrammpfaden berechnet, auf 0,1 Punkte gerundet, die Textzahlen stimmen damit überein. Der technische Bericht enthält keine Messzahlen.
- Die Längenmessung nutzt o200k_base als Näherung, 60 Beschreibungen von zwei Modellen zu zehn Produkten, im Oktober-Test über Codex CLI und Claude Code erzeugt. Welcher Tokenizer bei GPT-6.1 Sol und Claude gilt, ist nicht öffentlich bestätigt.
- Recht: Den Gesetzestext habe ich in der deutschen Fassung von ai-act-law.eu gelesen, die nicht amtlich ist, EUR-Lex lieferte beim Abruf keinen Text. Leitlinien, FAQ und Kodex liegen mir nur auf Englisch vor. Die Leitlinien sind nicht bindend. Das ist keine Rechtsberatung.
- Stand: Alle Anbieterangaben gelten für den 06.10.2026. Anthropics Tabelle ist vom 01.10., OpenAI sagt „in den kommenden Wochen“, und beides ändert sich.
- Praktikerstimmen: LinkedIn, X, Reddit und YouTube liefern Meinungen und Selbstberichte, keine Messungen. Bei Reddit habe ich 2.224 Kommentare abgerufen und in acht von 13 Threads die bestbewerteten gelesen, Beiträge und Kommentare können später entfernt werden. X lud unzuverlässig, die Suche dort ist unvollständig. YouTube-Transkripte sind automatisch erzeugt. Aussagen von Praktikern, die ich nur über Ahrefs oder Search Engine Journal kenne, sind im Text so benannt.
- Ausgebliebene Funde: Den API-Parameter von OpenAI, eine Aussage zur Gemini API und ein Prüfangebot für Shops habe ich nicht gefunden. Das beweist nicht, dass es sie nicht gibt.
- Auswertung: Die Quellen hat KI gelesen und ausgewertet, Zitate und Zahlen sind per Skript gegen die gespeicherten Seiten geprüft. Die Schlüsse sind meine.
Häufige Fragen zu Textwasserzeichen
Trägt ein Text, den ich mit ChatGPT geschrieben habe, ein Wasserzeichen?
Nach OpenAIs Ankündigung vom 05.10.2026 noch nicht. In der EU soll es für ChatGPT und Codex in den kommenden Wochen kommen, außerhalb der EU ist es nicht vorgesehen, und in der API musst du es einschalten. Texte von vor dem Start tragen keines.
Trägt ein Text von Claude eines?
Bei Opus 5.5, Sonnet 5.5 und sechs weiteren Modellen ja, laut Anthropics Tabelle vom 01.10.2026. Für Haiku 4.5, Opus 4.7 und ältere Modelle steht dort kein Haken. Der Finder oben zeigt jedes Modell einzeln.
Muss ich KI-Text auf meiner Website kennzeichnen?
Nur bei veröffentlichtem Text, der die Öffentlichkeit über Angelegenheiten von öffentlichem Interesse informiert, und nur dann, wenn keine inhaltliche Prüfung mit benannter Verantwortung stattgefunden hat. Gewöhnliche Produktbeschreibungen nennt die Kommission als Beispiel außerhalb der Pflicht. Der Pflicht-Check geht deinen Fall durch. Eine Rechtsberatung ersetzt er nicht.
Kann ich prüfen, ob mein Text markiert ist?
Nicht öffentlich. OpenAI und Anthropic geben den Detektor an ausgewählte Organisationen, bei Google ist für Text keine Prüfung beschrieben. Für Bilder und Audio gibt es öffentliche Prüfungen.
Wertet Google Wasserzeichen für das Ranking aus?
Dafür gibt es keinen Beleg. Keine der geprüften Quellen zitiert eine Google-Aussage oder eine Messung dazu. Googles bekannte Linie ist, Qualität und Zweck zu bewerten, nicht die Herstellung.
Entfernt Übersetzen oder Umschreiben das Wasserzeichen?
Bei OpenAIs Verfahren senkt der Ersatz von 25 Prozent der Wörter die Erkennung bei 400 Tokens von 92 auf 17 Prozent. Zur Übersetzung widersprechen sich die Quellen, und für Claude und Gemini hat niemand mit einem echten Detektor getestet.
Tragen Titel, Meta-Beschreibung und Alt-Text ein Wasserzeichen?
Sie sind zu kurz, um viel Signal zu tragen. Der Kodex nennt Text unter 200 Tokens „sehr kurz“, und Anthropic schreibt, dass die Erkennung bei kleinen Textmengen nicht gut funktioniert. Ein Titel mit 60 oder eine Meta-Beschreibung mit 155 Zeichen liegt weit darunter.
Gilt das auch für Code?
Weniger. Anthropic schreibt, bei Code gebe es oft keine freie Wortwahl, das Signal könne aber zum Beispiel in Kommentaren sitzen. OpenAI nennt Mathematik, also Text mit wenig Spielraum bei der Wortwahl, als Fall mit deutlich niedrigerer Erkennung.
Fazit
Die Wasserzeichen sind da, aber bei kurzen Shop-Texten ein schwaches Signal, öffentlich nicht prüfbar und ohne belegten Einfluss auf Rankings. Was dich schützt, ist das, was einen guten Text ohnehin ausmacht: Quellen, eigene Daten und eine Person, die freigibt. Wenn ChatGPT in der EU markiert oder Anthropic und Google Zahlen nennen, lohnt sich ein neuer Blick. Diese Seite zeigt den Stand vom 06.10.2026.
Quellen
Anbieter
- OpenAI: Our approach to EU text provenance rules, 05.10.2026 und der technische Bericht zu textGrain (PDF, 05.10.2026)
- OpenAI: Understanding the source of what we see and hear online, Nachtrag vom 04.08.2024 (Wayback-Kopie vom 06.08.2024)
- OpenAI Help Center: Provenance signals und API-Dokumentation: Content provenance, Abruf 06.10.2026
- Anthropic: How Claude’s text watermark works, 14.08.2026, Nachtrag vom 01.09.2026
- Anthropic Help Center: How Claude marks AI-generated content, zuletzt geändert am 01.10.2026, und die API Release Notes vom 01.09.2026
- Google DeepMind: Watermarking AI-generated text and video with SynthID, 14.05.2024, SynthID-Seite und Gemini-Hilfe zur Prüfung von Bildern, Videos und Audio, Abruf 06.10.2026
- Nature: Scalable watermarking for identifying large language model outputs, Dathathri et al., 23.10.2024
EU
- Europäische Kommission: Code of Practice on Transparency of AI-generated Content (letzte Aktualisierung 31.07.2026) und der Kodex als PDF (Endfassung)
- Europäische Kommission: Leitlinien zu Artikel 50, C(2026) 5054, 20.07.2026 (englisch, nicht bindend)
- Europäische Kommission: Fragen und Antworten zu Artikel 50, letzte Aktualisierung 24.07.2026
- Gesetzestext, deutsche Fassung: Artikel 50 und Artikel 111 bei ai-act-law.eu (nicht amtlich)
Fachmedien, SEO und Praktiker
- Hanns Kronenberg auf LinkedIn zu OpenAIs Textwasserzeichen, 06.10.2026
- TechCrunch: Anthropic says it will watermark text, 11.08.2026 und OpenAI will start watermarking ChatGPT’s text in the EU, 05.10.2026
- The Decoder, 05.10.2026; heise online: AI watermarks in text, 11.08.2026; t3n zur Kritik an Claudes Wasserzeichen, 23.08.2026
- SEO und Content: Sistrix (17.08.2026, aktualisiert 01.09.2026), Seer Interactive (04.09.2026), Ahrefs (14.08.2026), LSEO (16.08.2026), SEO Hacker (14.08.2026), Hostinger (07.09.2026), Deepak Gupta (17.08.2026)
- First Page Sage: Impact of AI watermarking on SEO and GEO results, 25.08.2026 (Eigenstudie einer Agentur)
- AkitaOnRails: Anthropic AI watermark, how to beat it, 16.08.2026, und der Selbstversuch in r/ClaudeAI, 23.08.2026
- LinkedIn: Markus Hövener (07.09.2026), Raphael Guldimann (11.08.2026), Nadja Buoyardane (09.09.2026), Doris Weßels und Robert Gies (beide 06.10.2026)
- X: Charles Floate, 30.08.2026 mit den Antworten darunter
- Reddit: r/ClaudeAI, 13.08.2026, r/ClaudeAI, 14.08.2026 und r/SEO, 24.09.2026, jeweils mit Kommentaren
- YouTube: Caleb Ulku, 14.08.2026, Kris (AI2ROI) und Sandy Lee AI (beide August 2026), Transkripte über youtubetotranscript.com
Eigene Messung
- Länge von 60 Produktbeschreibungen aus dem Test zu KI-Produkttexten (03.10.2026), gezählt in Tokens mit o200k_base, 06.10.2026
- Diagrammwerte von OpenAI (05.10.2026) aus den SVG-Pfaden der Seite berechnet, 06.10.2026
Geschrieben von
Mario WormuthSEO, GEO und KI-Automatisierung für Online-Shops. Ich teste, worüber ich schreibe, zuerst auf eigenen Seiten und in Kundenprojekten wie RYMHART und Opal-Schmiede.
Das für deinen Shop umsetzen?
Drei Fragen, sofort eine Einschätzung, danach drei konkrete Punkte von mir persönlich. Kostenlos.
Weitere Artikel
aus dem Magazin.
Alle Artikel
Heatmap-Tools 2026: 10 Anbieter von kostenlos bis bezahlt
Hotjar nimmt keine neuen Konten mehr an, und bei Smartlook war der 31. Mai 2026 der letzte Bestelltag. Trotzdem führen vier von sechs deutschsprachigen Vergleichslisten zu Heatmap-Tools Smartlook noch als wählbares …
Die 10 besten kostenlosen SEO-Tools 2026 im Check
Von 30 Tools und Funktionen, die als kostenlos laufen, bestehen am 5. Oktober 2026 genau 22 meinen Kostenlos-Check. Acht fliegen raus. Ubersuggest, AnswerThePublic und AlsoAsked erlauben je 3 Suchen pro Tag. …
Opus 5.5 oder GPT-6.1 Sol: Wer schreibt bessere Texte?
Zwischen dem 1. und 3. Oktober sind auf seorado.de mehrere Beiträge entstanden, mit zwei verschiedenen KI-Werkzeugen. Claude Code mit Claude Opus 5.5 auf der Stufe xhigh hat unter anderem den Vergleich von GPT-6.1 …