Start / Magazin / KI, Automatisierung & Reporting
GPT-6.1 Sol vs. Opus 5.5: Wer programmiert besser?
ArtikelKI, Automatisierung & Reporting03.10.2026/img/magazin/gpt-6-1-sol-vs-opus-5-5-programmieren-vergleich.webp Mario WormuthSEO, GEO & KI-Automatisierung
39 Min. Lesezeit
Alles auf einen Blick
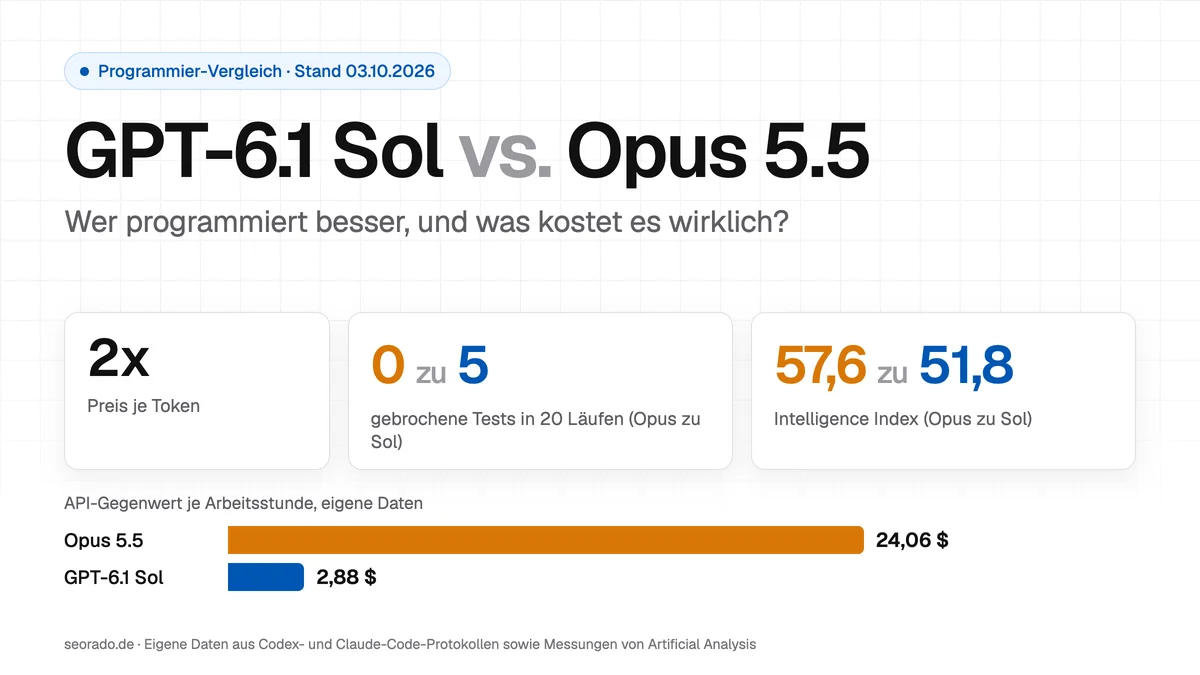
- In fast allen unabhängigen Ranglisten liegt Opus 5.5 vorn, im Intelligence Index von Artificial Analysis etwa mit 57,6 zu 51,8 Punkten. GPT-6.1 Sol gewinnt bei der Fehlersuche und bei gezielten Patches.
- Über die API ist Sol viel günstiger: je Token halb so teuer, je gelöster Aufgabe meist 3- bis 12-mal.
- Im Abo schrumpft der Vorteil. Für 20 $ bekommst du bei Claude Pro derzeit mehr Arbeit als bei ChatGPT Plus. Ab dem 30. Oktober halbiert OpenAI das Kontingent von Pro 200, danach liefert Claude je Dollar eher mehr Arbeitsstunden.
- In großen bestehenden Codebasen bricht Opus seltener etwas, das vorher lief: In einem Monorepo waren es 0 gegen 5 gebrochene Tests in je 20 Läufen. Dazu hat Opus im Werkzeug viermal so viel Kontext. Sol löst dort gleich viel für ein Sechstel der Kosten, braucht aber gute Tests.
- Bei neuen Projekten mit klarer Vorgabe liefern beide, Sol für einen Bruchteil. Bei Design, Spielen und offenen Aufgaben gewinnt Opus fast immer.
- Höhere Stufen sind nicht besser. Beide Modelle arbeiten auf medium bis high am besten, nur die Fehlersuche profitiert von max.
- Meine Empfehlung: Wichtige Software ohne starkes Testnetz baust du mit Opus 5.5. Sol 6.1 ist der günstige, gründliche Prüfer und das Arbeitstier für gut getestete Aufgaben. Am meisten bekommst du, wenn du beide kombinierst.
Inhaltsverzeichnis17 Abschnitte
- Die beiden Modelle kurz vorgestellt
- Meine Ausgangslage: Claude für 100 $, Codex für 200 $
- Qualität: Was die unabhängigen Messungen zeigen
- Große, kleine und neue Codebasen: Wo welches Modell vorn liegt
- Gleicher Prompt, zwei Ergebnisse
- Was die Videos zeigen
- Kosten: Ist Codex wirklich günstiger?
- Tempo: Wer ist schneller fertig?
- Welche Stufe lohnt sich?
- Wie die beiden Modelle arbeiten
- Codex und Claude Code: was die Werkzeuge ausmacht
- Was andere Entwickler sagen
- Welches Modell für welchen Fall?
- Meine Einschätzung
- Was dieser Vergleich nicht zeigt
- Häufige Fragen
- Quellen
Seit dem 22. September gibt es Claude Opus 5.5, seit dem 29. September GPT-6.1 Sol. Mit diesen beiden Modellen bauen gerade die meisten Entwickler: Opus in Claude Code, Sol in Codex. Und beide Lager sind sich sicher, dass ihres besser ist. Die einen verweisen auf die Ranglisten, in denen Opus vorn liegt. Die anderen auf den Preis: Sol kostet je Token die Hälfte, je Aufgabe oft nur ein Zehntel.
Ich arbeite mit beiden. Claude Code mit Opus 5.5 ist mein Hauptwerkzeug, im Abo Max 5x für 100 $. Codex mit GPT-6.1 Sol läuft daneben, auf der Stufe xhigh, im Abo Pro 200. Für diesen Vergleich habe ich zusammengetragen, was es bis heute an Messungen gibt: alle unabhängigen Benchmarks, 16 Tests auf YouTube, rund 90 Threads auf Reddit, Hacker News, X, LinkedIn und die Blogs der Tool-Anbieter. Dazu kommen meine eigenen Protokolle aus 11 Tagen mit beiden Werkzeugen. Die Leitfrage: Welches Modell nimmst du, wenn du wichtige Software baust, und wo bekommst du mehr für dein Geld? Beim Sammeln und Auswerten hat mir KI geholfen (Claude Code). Jede Zahl ist mit ihrer Quelle verlinkt, Stand ist der 3. Oktober 2026. Einen eigenen Kopf-an-Kopf-Test mit eigens gebauten Testprojekten trage ich nächste Woche nach.
Die beiden Modelle kurz vorgestellt
GPT-6.1 Sol ist das Arbeitsmodell von OpenAI, eine Stufe unter GPT-6 Astra. Was es beim Start alles gab, steht in meinem Beitrag zu GPT-6.1 Sol und dem OpenAI DevDay 2026. Claude Opus 5.5 ist bei Anthropic das Modell für lange Agentenarbeit, über ihm steht nur noch Fable 5.1. Beide sind gleichzeitig Modell und Werkzeug: Sol bekommst du im Abo nur in Codex und ChatGPT Work, Opus in Claude Code und claude.ai. Der Vergleich ist deshalb immer auch einer der Werkzeuge.
| GPT-6.1 Sol | Claude Opus 5.5 | |
|---|---|---|
| Hersteller, Start | OpenAI, 29.09.2026 | Anthropic, 22.09.2026 |
| Werkzeug im Abo | Codex (App, CLI, Cloud), ChatGPT Work | Claude Code (CLI, Desktop, Web), claude.ai |
| API-Preis je Million Token | 2 $ Eingabe, 0,10 $ Cache-Lesen, 10 $ Ausgabe | 4 $ Eingabe, 0,20 $ Cache-Lesen, 20 $ Ausgabe |
| Langer Kontext | über 272.000 Token Eingabe doppelter Eingabepreis und 1,5-facher Ausgabepreis | kein Aufschlag bis 1 Mio. Token |
| Kontext im Werkzeug | Codex: 272.000, nutzbar 258.400 Token | Claude Code: 1 Mio. Token |
| Stufen | low, medium, high, xhigh, max, in Codex zusätzlich ultra | low, medium, high, xhigh, max, dazu der Schalter ultracode |
| Schreibtempo im Abo | rund 20 bis 25 Token pro Sekunde (30.09. bis 02.10.) | rund 90 Token pro Sekunde |
| Fast-Modus | im Abo enthalten, zählt 2,5-fach aufs Kontingent | nur gegen Usage Credits, 8 $ und 40 $ je Million Token |
Quellen: OpenAI-Modellseite, Anthropic-Preisliste, Codex-Modellkatalog auf GitHub, abgerufen am 03.10.2026. Das Tempo im Abo stammt aus meiner Messung im Beitrag GPT-6.1 Sol langsam?.
Meine Ausgangslage: Claude für 100 $, Codex für 200 $
Mit Opus 5.5 kann ich richtig gut arbeiten. Es ist stark, gerade weil Claude Code für eine Aufgabe viele Agenten losschickt, und es ist schnell und effizient. Ich bin mit Claude zufrieden. Aber es ist deutlich teurer, wirklich deutlich. Das bestätigt, was fast alle sagen: Im Preisvergleich schlägt Sol 6.1 Claude um Welten.
Wie groß der Unterschied ist, zeigen meine Protokolle vom 22.09. bis 02.10.2026. Codex und Claude Code speichern jede Sitzung lokal. Ich habe daraus nur Zeitstempel, Modelle, Stufen und Tokenzahlen gelesen, keine Inhalte, und alles zu API-Listenpreisen umgerechnet. Eine aktive Stunde heißt: In dieser Zeit lief tatsächlich ein Modellaufruf.
| Codex | Claude Code | |
|---|---|---|
| Abo | ChatGPT Pro 200 (bis 29.10. noch das 20-Fache von Plus) | Claude Max 5x |
| API-Gegenwert in 11 Tagen | 694,82 $, davon GPT-6.1 Sol 105,37 $ | 1.674,01 $, davon Opus 5.5 1.600,90 $ |
| Je aktiver Stunde | Sol 6.1 xhigh 2,88 $, ultra 8,20 $ | Opus 5.5 xhigh 24,06 $ |
| Je Aufgabe, Median | Sol 6.1 xhigh 0,40 $ in 7,3 Minuten | Opus 5.5 xhigh 1,01 $ in 2,5 Minuten |
| Limits | höchstens 71 % des Wochenlimits, keine Sperre | viermal im 5-Stunden-Limit (27. bis 30.09.), Wartezeit 28 Minuten bis 3,7 Stunden |
| Kontext zusammengefasst | 114-mal in 39 Sitzungen | 4-mal |
Ein Vorbehalt gehört dazu: Ich habe in beiden Werkzeugen verschiedene Dinge gebaut. Codex lief vor allem in Software-Projekten (Shopify-Apps, eine Web-App, eine API), Claude Code vor allem an dieser Website, an Rechnern und an Recherchen. Die Tabelle zeigt also Verbrauch und Arbeitsweise, keinen Qualitätsvergleich. Je Arbeitsstunde ist Opus bei mir gut achtmal so teuer wie Sol. Das passt zu meinem Gefühl. Spannend wird es, wenn man das Abo dagegenrechnet. Dazu weiter unten mehr.
Qualität: Was die unabhängigen Messungen zeigen
Die folgende Tabelle sammelt alle unabhängigen Tests, in denen beide Modelle stehen. Unabhängig heißt: Weder OpenAI noch Anthropic haben gemessen. Bei FrontierCode misst mit Cognition ein Anbieter, der beide Modelle in seinen eigenen Produkten anbietet.
| Test | Was er misst | GPT-6.1 Sol | Claude Opus 5.5 |
|---|---|---|---|
| Intelligence Index (Artificial Analysis) | 10 schwere Aufgaben, einheitlich gemessen | 51,8 (max) | 57,6 (max) |
| Coding Agent Index (Artificial Analysis) | Programmieraufgaben im eigenen Werkzeug | 62,9 (xhigh) | 66,0 (max) |
| Terminal-Bench 4.0 | Arbeiten im Terminal | 53 bis 56 % | 58 bis 66 %, je nach Gerüst |
| LiveBench Coding | Programmieraufgaben | 80,4 | 89,3 |
| Vals Index | 19 gemischte Tests | 61,2 % | 67,0 % |
| WebDev Arena | Blindvoten über Frontends | 1.758 Punkte | 1.815 Punkte |
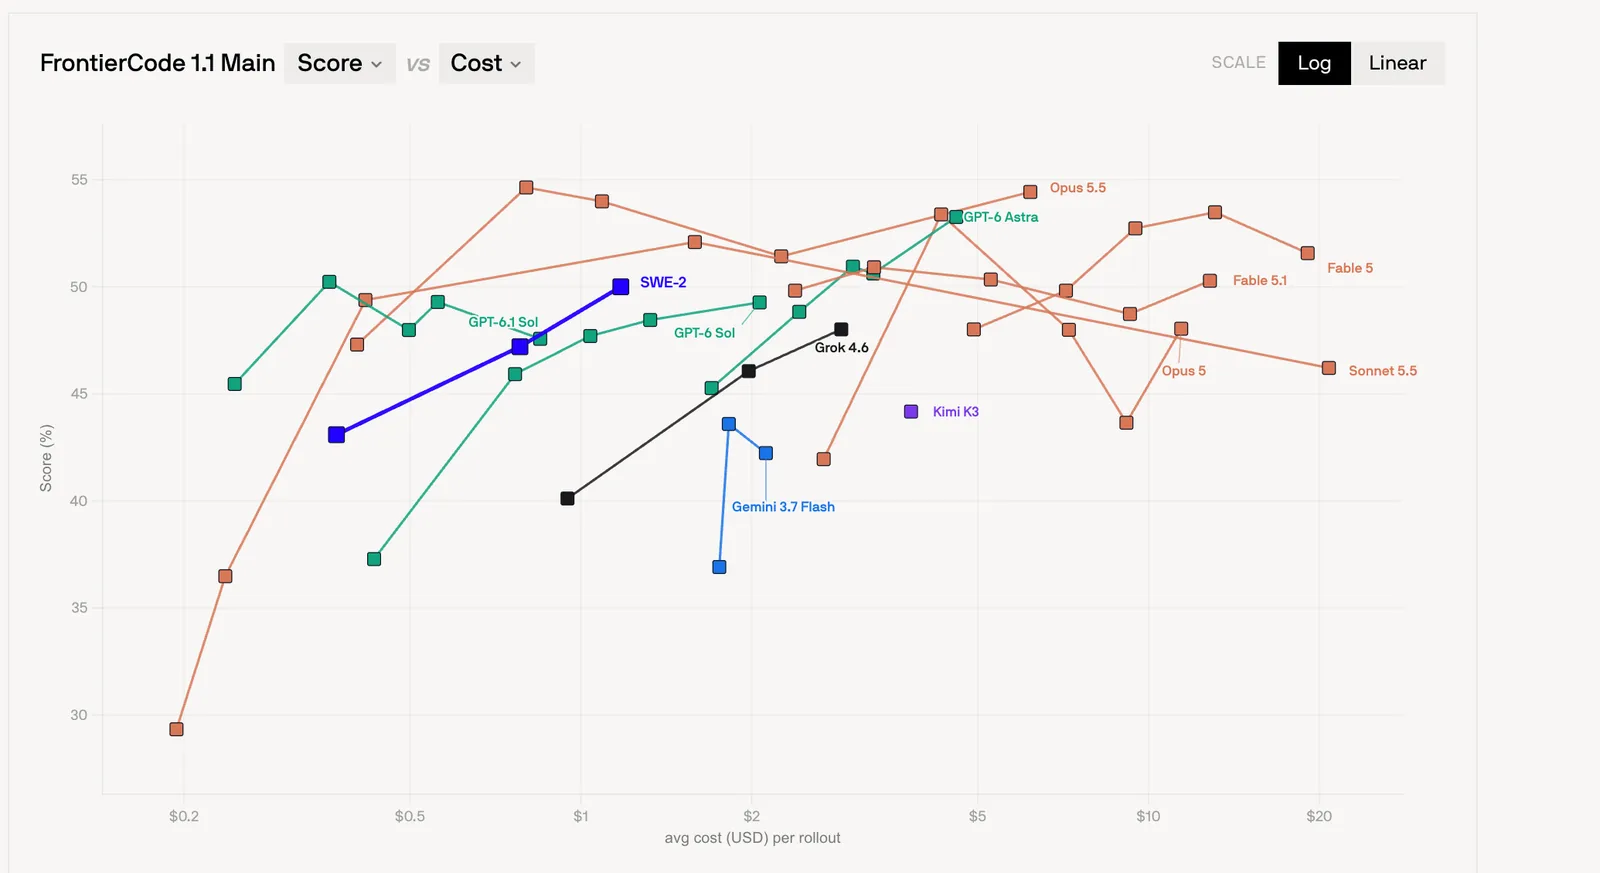
| FrontierCode (Cognition) | Pull Requests, die Maintainer mergen würden | 50,2 % (medium) | 54,6 % (medium) |
| Vibe Code Bench (Vals) | Web-App von null nach Vorgabe | 88,9 % | 90,3 % |
| Code Migration (Vals) | Code in eine andere Sprache portieren | 65,1 % | 66,7 % |
| DeepSWE (Artificial Analysis) | Patches in Open-Source-Repos | 73,2 (xhigh) | 68,4 (max) |
| Bug Hunt Bench | gefundene Fehler von 105 | 44,3 (max) | 41,7 (max) |
Quellen: Artificial Analysis, Artificial Analysis Coding Agents, LiveBench, Vals AI, Arena, FrontierCode, Bug Hunt Bench, alle abgerufen am 03.10.2026.
In 9 von 11 Tests liegt Opus vorn, bei zweien davon nur knapp (Vibe Code Bench und Migration). Sol gewinnt bei DeepSWE und im Bug Hunt Bench, also genau dort, wo es um gezielte Patches und die Suche nach Fehlern geht. Auffällig ist die Decke: Im Intelligence Index erreicht Opus auf xhigh und max 56 bis 58 Punkte. Sol kommt auf keiner Stufe über 51,8. Für die schwersten Aufgaben hat Sol also kein Niveau, das Opus' Spitze entspricht. Für sehr viele Alltagsaufgaben reicht der Abstand aber nicht, um einen Unterschied zu sehen.
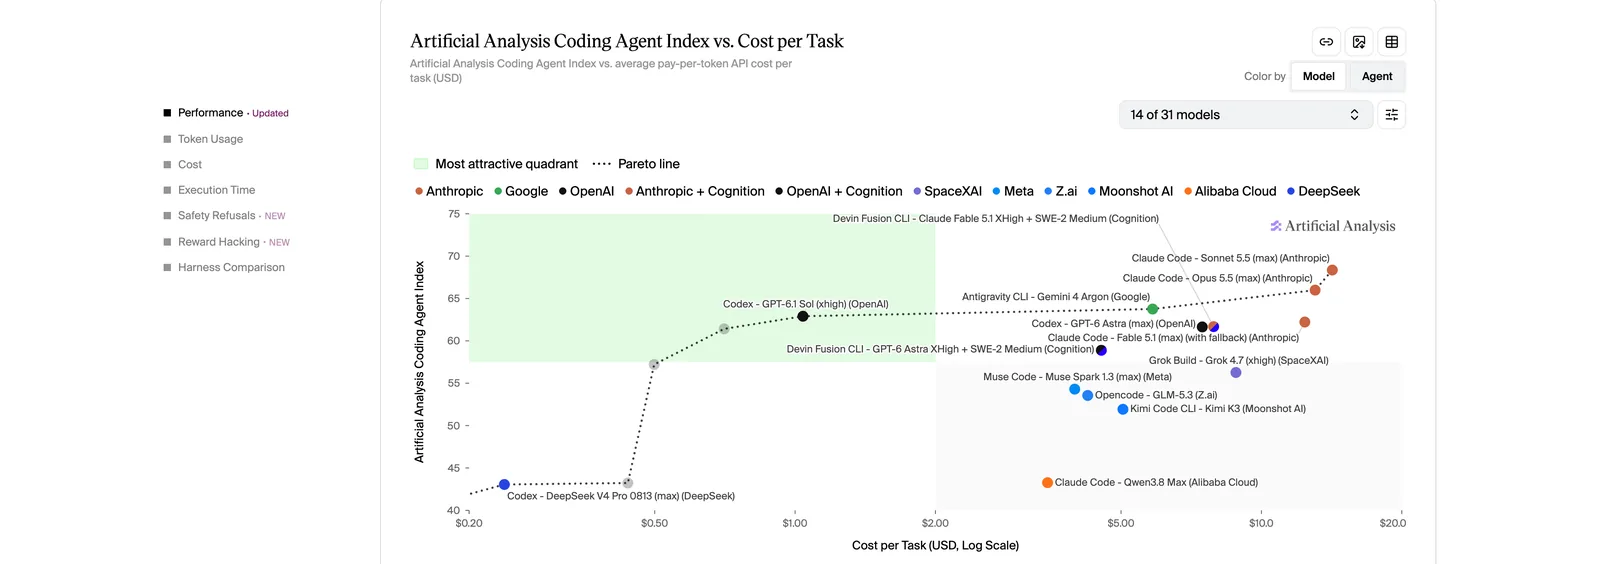
Zwei Dinge musst du bei diesen Zahlen wissen. Erstens vergleicht keiner der beiden Hersteller sein Modell beim Programmieren direkt mit dem anderen. OpenAI zeigt Opus 5.5 nur bei AutomationBench, GDP.pdf und Terminal-Bench Science, Anthropic erwähnt GPT-6.1 Sol gar nicht. Zweitens enthalten einige Opus-Werte Fallbacks: Blockieren die Sicherheitsfilter von Anthropic eine Anfrage, antwortet ein älteres Claude-Modell. Bei Artificial Analysis betraf das 78 von 909 Versuchen, bei Vals rund 4 %.
Große, kleine und neue Codebasen: Wo welches Modell vorn liegt
Die Ranglisten mitteln über viele Aufgaben. Im Alltag zählt aber, woran du arbeitest: an einer großen gewachsenen Codebasis, an einem kleinen Projekt oder an etwas ganz Neuem. Genau hier unterscheiden sich die beiden Modelle am deutlichsten. Im Baustein findest du die wichtigsten Messungen je Lage, darunter die Einzelheiten.
Große bestehende Codebasis
Ohne starke Testsuite: Opus 5.5 auf medium, für Bugfixes high. Mit guter Testsuite, CI und Review: Sol 6.1 als günstiges Arbeitstier.
| Test | GPT-6.1 Sol | Claude Opus 5.5 | Quelle |
|---|---|---|---|
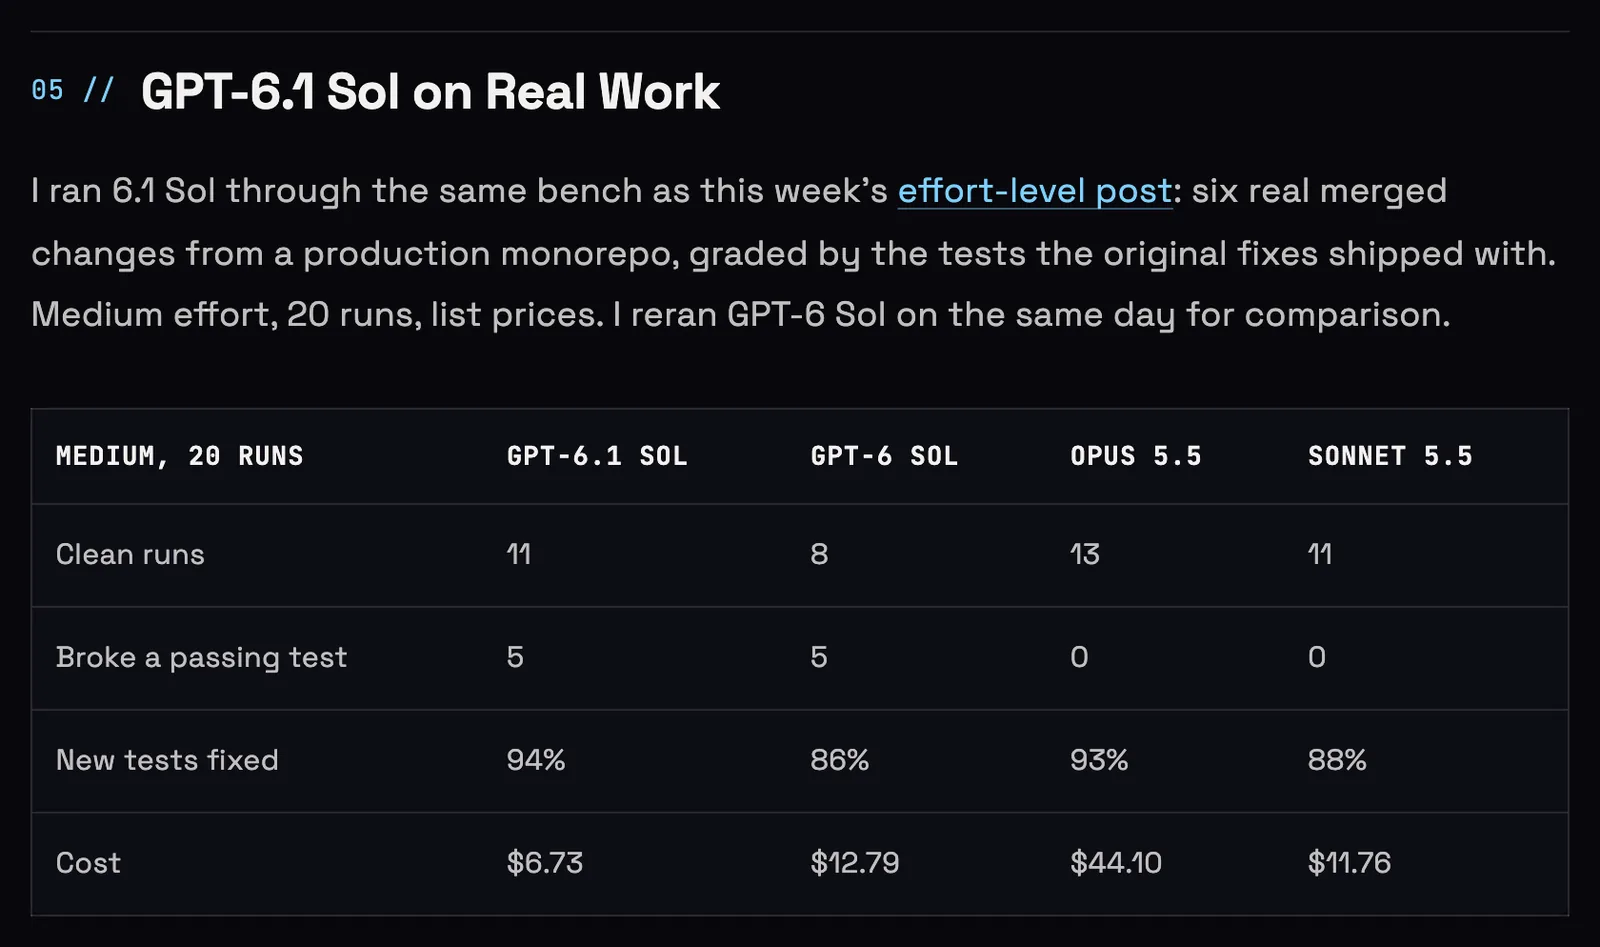
| Monorepo mit 3.700 Dateien, 6 echte Änderungen, je 20 Läufe auf medium | 94 % neue Tests grün, in 5 von 20 Läufen einen grünen Test gebrochen, 6,73 $ | 93 % grün, 0 von 20 gebrochen, 44,10 $ | paddo.dev |
| FrontierCode: Pull Requests, die Maintainer mergen würden (Claude Code gegen Codex) | 50,2 % auf medium, 0,36 $ je Aufgabe | 54,6 % auf medium, 0,80 $ | Cognition |
| Fragen zu großen Produktions-Repos (SWE-Atlas-QnA) | 61,0 Punkte | 66,4 Punkte, liest dafür rund 4,8-mal so viel Kontext | Artificial Analysis |
| Patches in Open-Source-Repos (DeepSWE) | 73,2 Punkte (xhigh) | 68,4 Punkte (max) | Artificial Analysis |
| Kontext im Werkzeug, meine 11 Tage | Codex 258.400 Token, 114 Zusammenfassungen | Claude Code 1 Mio. Token, 4 Zusammenfassungen | Eigene Daten |
Kurz gesagt: Opus bricht seltener Bestehendes und behält mehr vom Projekt im Blick. Sol löst gleich viel für ein Sechstel der Kosten, braucht aber Tests, die Fehler sofort zeigen.
Kleines bestehendes Projekt
Ohne Tests, wie bei vielen Kunden- und Shopprojekten: Opus 5.5 auf high. Mit voller Testsuite: Sol 6.1 auf medium oder xhigh.
| Test | GPT-6.1 Sol | Claude Opus 5.5 | Quelle |
|---|---|---|---|
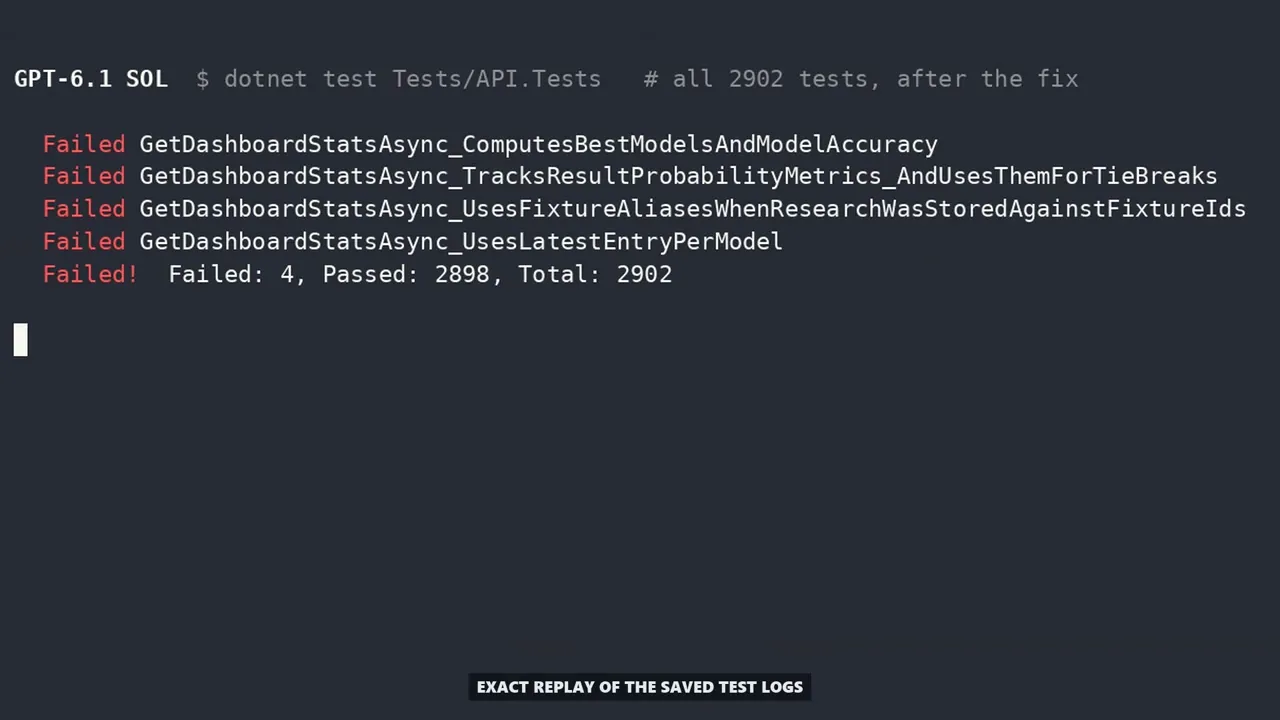
| 10 echte Bugs, beide auf high, danach die ganze Testsuite | 10 von 10 gelöst, 27:48 min, 4 von 2.902 Tests gebrochen | 10 von 10 gelöst, 24:59 min, keinen gebrochen | Marvijo AI auf YouTube |
| Gleicher Refactor über 14 bis 16 Dateien, beide medium, 20-$-Abos | 18 % des 5-Stunden-Fensters | 7 %, gleiches Ergebnis | r/codex |
| 10 Alltagsaufgaben, je 3 Läufe | 100 % gelöst, 0,14 $ je Aufgabe (medium) | 100 %, 0,35 $ (high) | ibragim.dev |
| 105 eingebaute Fehler in Repos mit 28.000 und 60.000 Zeilen, xhigh | 42,7 gefunden, 4,34 $ je Lauf, viele Zusatzänderungen | 36,0 gefunden, 34,98 $ | Bug Hunt Bench |
Kurz gesagt: In der Qualität gleichauf. Opus arbeitet zielgenauer und lässt den Nachbarcode in Ruhe, Sol ist billiger und gründlicher bei der Fehlersuche.
Neues Projekt
Mit fertiger Vorgabe (Rechner, Formular-App, einfache Seite): Sol 6.1. Mit Designanspruch, Spiel, 3D oder offenen Entscheidungen: Opus 5.5.
| Test | GPT-6.1 Sol | Claude Opus 5.5 | Quelle |
|---|---|---|---|
| Web-App von null nach Spezifikation (Vibe Code Bench, max) | 88,9 %, 7,01 $ je gelöster App | 90,3 %, 64,15 $ | Vals AI |
| Programm komplett nachbauen (ProgramBench) | 6 von 200 voll gelöst | 37 von 200 | Vals AI |
| Blindvergleich von Frontends (WebDev Arena) | 1.758 Punkte | 1.815 Punkte | Arena |
| Fabians drei Tests, beide medium | App-Nachbau knapp vorn, 1,45 $ für alle drei | 3D-Spiel klar vorn, Blender knapp, 8,50 $ | IchBinFabian |
| Neubauten in 11 YouTube-Videos, eigene Zählung | 2 Siege | 14 Siege, 3 unentschieden | Auswertung im Beitrag |
Kurz gesagt: Bei klarer Vorgabe liefern beide, Sol für einen Bruchteil. Sobald Geschmack und eigene Entscheidungen gefragt sind, liegt Opus vorn.
Große bestehende Codebasis
Den saubersten Test für diese Lage hat der Blogger hinter paddo.dev am 30.09. veröffentlicht. Er hat sechs echte, schon gemergte Änderungen aus einem TypeScript-Monorepo mit rund 3.700 Dateien nachgestellt, mit dem Ticket als Prompt. Jedes Modell lief 20-mal auf medium, Sol in der Codex-CLI, Opus in Claude Code, mit derselben Regeldatei. Bewertet wurde mit den Tests der echten Änderung. Ergebnis: Beide lösen fast gleich viel, Sol 94 % der neuen Tests, Opus 93 %. Sol kostet dafür 6,73 $, Opus 44,10 $. Aber Sol brach in 5 von 20 Läufen einen Test, der vorher grün war. Opus in keinem. Das Muster war jedes Mal ähnlich: Sol schrieb eine bestehende Fehlermeldung um und verlor dabei eine Anweisung, die darin stand. Sein Fazit: „GPT-6.1 Sol for well-tested work … Claude for work without that safety net.“
Der zweite starke Beleg kommt von Cognition, der Firma hinter Devin und Windsurf. Ihr Test FrontierCode nimmt echte Aufgaben aus offenen Repos und fragt: Würde ein Maintainer diesen Pull Request mergen? Bewertet werden Korrektheit, Tests, Stil, die Konventionen des Repos und ob das Modell beim Auftrag bleibt. Gemessen wird genau mit Claude Code und Codex. Opus 5.5 kommt auf medium auf 54,6 % für 0,80 $ je Aufgabe und steht damit auf Platz 1. Sol 6.1 kommt auf medium auf 50,2 % für 0,36 $. Beide werden über medium schlechter, weil sie dann mehr ändern als verlangt.
Der größte praktische Unterschied in großen Repos ist aber das Kontextfenster im Werkzeug. Claude Code gibt Opus 1 Million Token, auf jedem Abo. Codex begrenzt Sol auf 272.000 Token, nutzbar sind 258.400, und fasst den bisherigen Verlauf zusammen, wenn das Fenster voll ist. Bei mir passierte das in 11 Tagen 114-mal in 39 Sitzungen, in Claude Code 4-mal. Auf GitHub gibt es dazu Fehlerberichte, etwa #49641, in dem ein frischer Thread schon bei rund 80 % Füllung startet. Ein Nutzer auf Hacker News beschreibt es so: „It's crazy on Codex. I sometimes get just 2-3 turns before it compacts … By comparison, Opus 5.5 is a breath of fresh air.“ (Gareth321, 30.09.2026). Das Fenster lässt sich in Codex größer stellen, über die API kostet Sol dann aber für die ganze Anfrage den doppelten Eingabepreis.
Der große Kontext erklärt auch, warum Opus so viel teurer ist. Im Coding Agent Index von Artificial Analysis liest Opus je Aufgabe rund 15,2 Millionen Token und macht 155 Schritte. Sol liest 3,2 Millionen in 40 Schritten. Beim Verstehen großer Produktions-Repos zahlt sich das aus: Im Teiltest SWE-Atlas-QnA liegt Opus mit 66,4 zu 61,0 Punkten vorn. Bei gezielten Patches liegt dagegen Sol vorn, im Teiltest DeepSWE mit 73,2 zu 68,4.
Die Praxisberichte passen dazu. „Large codebases here too: A 1.3M LOC Rust, a 700K LoC Typescript, a 350K Python. I trust Sonnet/Opus more at the moment“, schreibt ein Entwickler in r/codex. Ein anderer im selben Subreddit: „Codex does sifting through large code much better“ (Kommentar). Theo von t3.gg fasst sein Video so zusammen: „I find Sol to be way better at reviewing and digging into the details, but I find Opus a more pleasant collaborator and significantly better at actually implementing code without getting blocked“ (YouTube, 27:54). Für lange, unbeaufsichtigte Umbauten sei Anthropic „just comically far ahead right now“ (16:33).
Kurz gesagt: In großen Codebasen entscheidet das Sicherheitsnetz. Mit einer guten Testsuite, CI und Review ist Sol ein günstiges Arbeitstier. Ohne dieses Netz ist Opus die sicherere Wahl, weil es seltener Bestehendes bricht und mehr vom Projekt im Blick behält.
Kleines bestehendes Projekt
Für kleine und mittlere Projekte gibt es ein Video, das ich jedem empfehle: Marvijo AI hat zehn echte Bugs genommen, einen offenen aus der Codex-CLI und neun, die er in seinen eigenen Produktions-Apps schon behoben hatte. Beide Modelle liefen auf high mit demselben Prompt in getrennten Ordnern. Beide lösten alle zehn im ersten Versuch. Opus war in 8 von 10 Runden schneller, insgesamt 24:59 gegen 27:48 Minuten aktive Zeit. Dann ließ er die ganze Testsuite laufen: „Both passed the regression test. Then I ran the other two thousand nine hundred tests. The Sol fix broke four of them.“ Opus traf dieselben vier Tests und passte sie so an, wie es auch die echten Maintainer in ihrem Fix getan hatten. Sein Fazit: „Sol is the value pick, as long as you run the whole test suite, not just the one test you asked it to pass“ (14:10).
Bei kleinen, klar umrissenen Aufgaben liegen beide gleichauf. In den zehn Alltagsaufgaben von ibragim.dev bestanden beide in je drei Läufen alles, Sol auf medium für 0,14 $ je Aufgabe, Opus auf high für 0,35 $. Im Bug Hunt Bench von Paweł Huryn, mit 105 eingebauten Fehlern in zwei echten Repos mit 28.000 und 60.000 Zeilen, findet Sol auf xhigh 42,7 Fehler für 4,34 $ je Lauf, Opus 36,0 für 34,98 $. Sol behebt dabei aber auch viele Dinge, nach denen niemand gefragt hat: 56,7 zusätzliche Korrekturen gegen 13,3 bei Opus. Das heißt größere Diffs und mehr zu prüfen.
Im Abo sieht es anders aus. Ein Entwickler hat in r/codex denselben Umbau über 14 bis 16 Dateien in beiden Werkzeugen laufen lassen, beide auf medium, mit derselben AGENTS.md und je einem 20-$-Abo. Das Ergebnis war gleich. Sol verbrauchte dafür 18 % des 5-Stunden-Fensters, Opus 7 %. Und ein X-Nutzer zeigt, wie Sol eine einfache Funktion mit 2.677 neuen Zeilen löste, die Opus danach um 1.865 Zeilen kürzte (@watermelon0guy, 01.10.2026). Bei OpenAI ist das Problem bekannt. Tibo Sottiaux, der bei OpenAI Codex leitet, schrieb am 03.10.: „Fortunately our future models will be much better at code deletion and simplification“ (X).
Kurz gesagt: In der Qualität liegen beide gleichauf. Opus arbeitet zielgenauer und lässt den Nachbarcode in Ruhe. Sol ist billiger und gründlicher bei der Fehlersuche, baut aber mehr, als du bestellt hast. Viele Kunden- und Shopprojekte haben keine Testsuite, die jeden Fehler sofort zeigt. Dort ist Opus auf high die sicherere Wahl.
Neues Projekt von null
Bei neuen Projekten mit klarer Vorgabe liefern beide Modelle fast gleich gut. Im Vibe Code Bench von Vals AI bauen sie Web-Apps von null nach einer Spezifikation von unter einer Seite, geprüft mit 20 bis 60 Browser-Tests. Opus kommt auf 90,3 %, Sol auf 88,9 %. Je gelöster App kostet Sol 7,01 $, Opus 64,15 $. Der Unterschied liegt also im Preis, nicht im Ergebnis.
Anders wird es, sobald das Modell selbst entscheiden muss: wie etwas aussieht, wie sich ein Spiel anfühlt, was fehlt. Im ProgramBench, in dem ein ganzes Programm nachgebaut wird, löst Opus 37 von 200 Aufgaben vollständig, Sol 6. In der WebDev Arena, in der Menschen blind über Frontends abstimmen, liegt Opus mit 1.815 zu 1.758 Punkten vorn. Und in den YouTube-Tests mit Neubauten steht es nach meiner Zählung 14 zu 2 für Opus bei 3 Unentschieden.
Dazu passt ein Befund aus mehreren Videos: Sol meldet früher „fertig“. „The model decides when it's done. GPT could keep iterating, but it chose to hand over“, sagt der Kanal Can It Code? (4:03). Opus prüft sich länger selbst, öffnet die Seite im Browser, macht Screenshots, vergleicht. Das kostet, bringt aber oft das bessere Ergebnis. Fabian von IchBinFabian hat das beim 3D-Spiel gut gezeigt, dazu weiter unten mehr. Ein dritter Befund: Mehr Denken hilft bei Neubauten kaum. „Low effort scored 100 out of 100. Extra high effort didn't. And that's true for both tools“, fasst der Kanal Company Under Glass seinen Test mit vier Stufen zusammen (YouTube, 30.09.2026).
Kurz gesagt: Hast du eine fertige Vorgabe, etwa für einen Rechner, eine Formular-App oder eine einfache Seite, reicht Sol für einen Bruchteil der Kosten. Bei Designanspruch, Shop-Frontends, Spielen, 3D und allem, wo das Modell eigene Entscheidungen treffen soll, liegt Opus vorn. Und ein neues Projekt bleibt nicht lange neu: Ab dem zweiten oder dritten Änderungswunsch gelten die Befunde für bestehende Projekte.
Gleicher Prompt, zwei Ergebnisse
Am anschaulichsten sind Tests, bei denen beide Modelle dieselbe Aufgabe bekommen. Hier sind die besten Beispiele, die ich gefunden habe. Fast alle sind Einzelläufe, bewertet vom jeweiligen Tester. Sie zeigen Muster, keine Statistik.
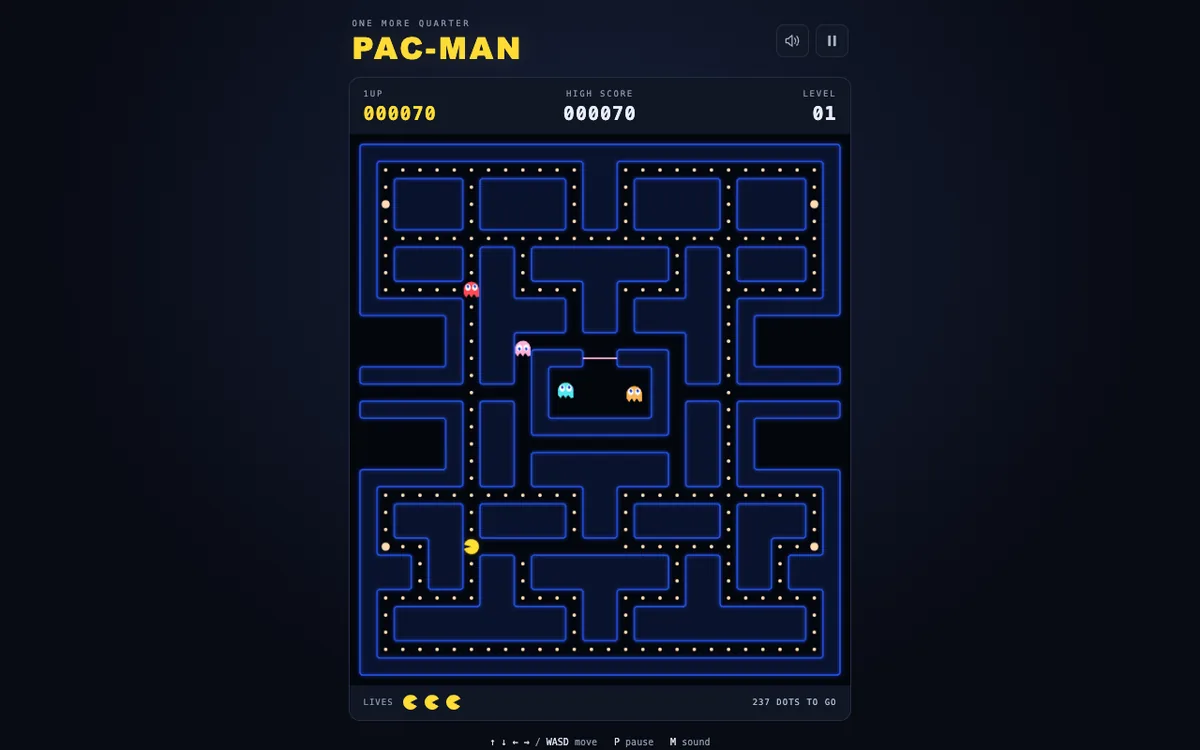
Pac-Man in einer HTML-Datei
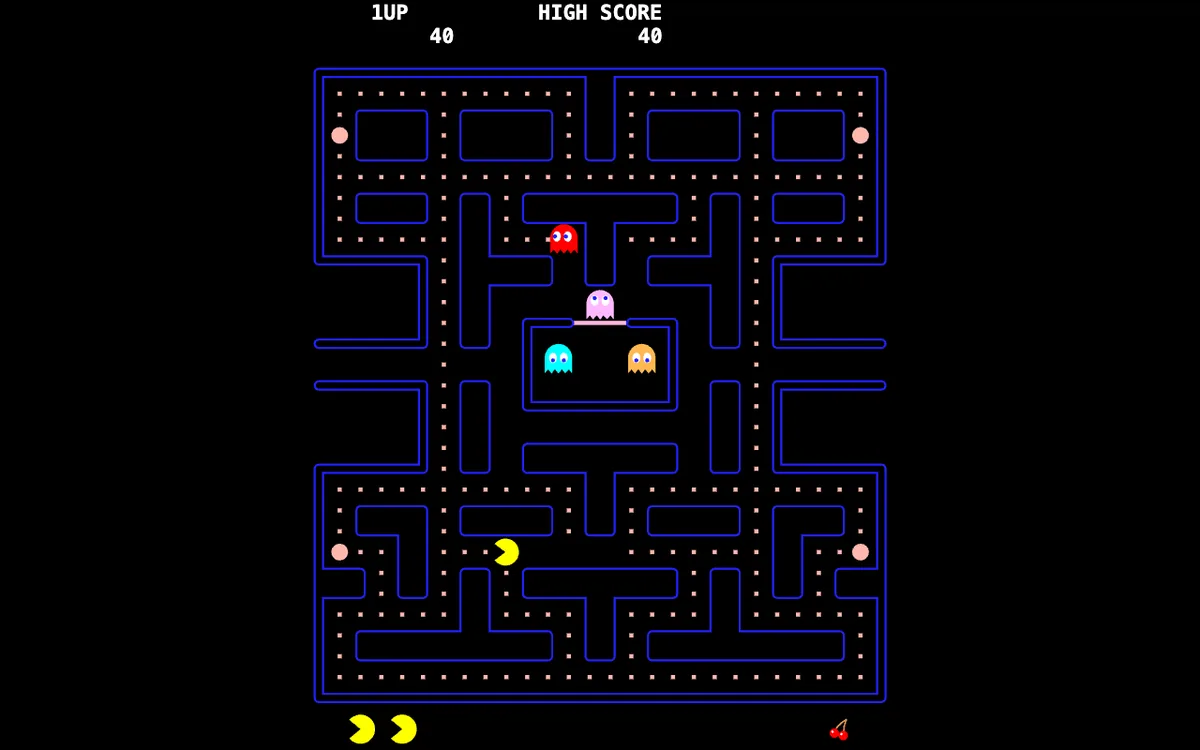
Landingpage für einen Film, Stufe xhigh
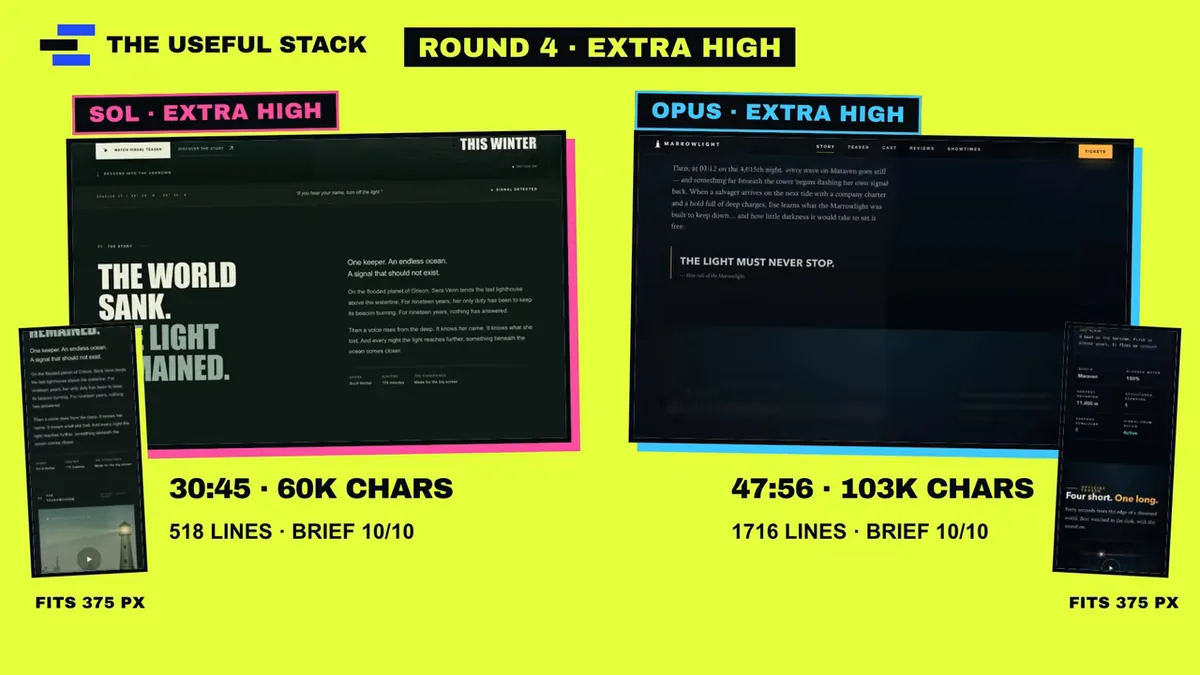 Sol links, Opus rechts
Raketenstart in Three.js
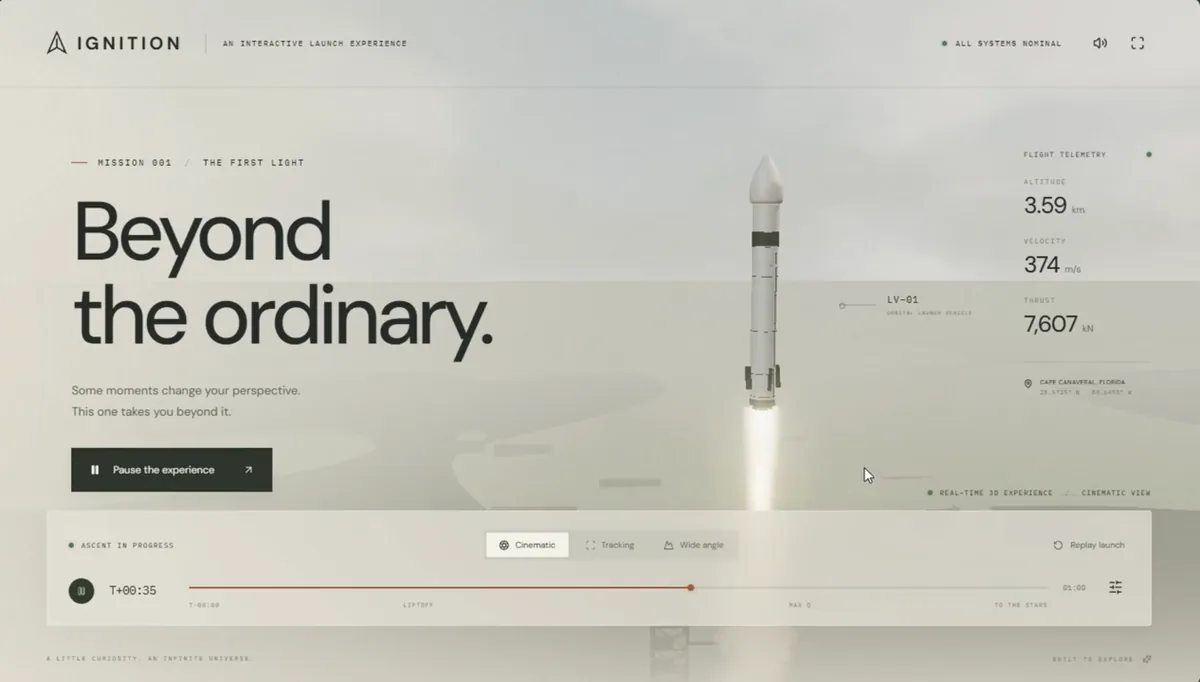
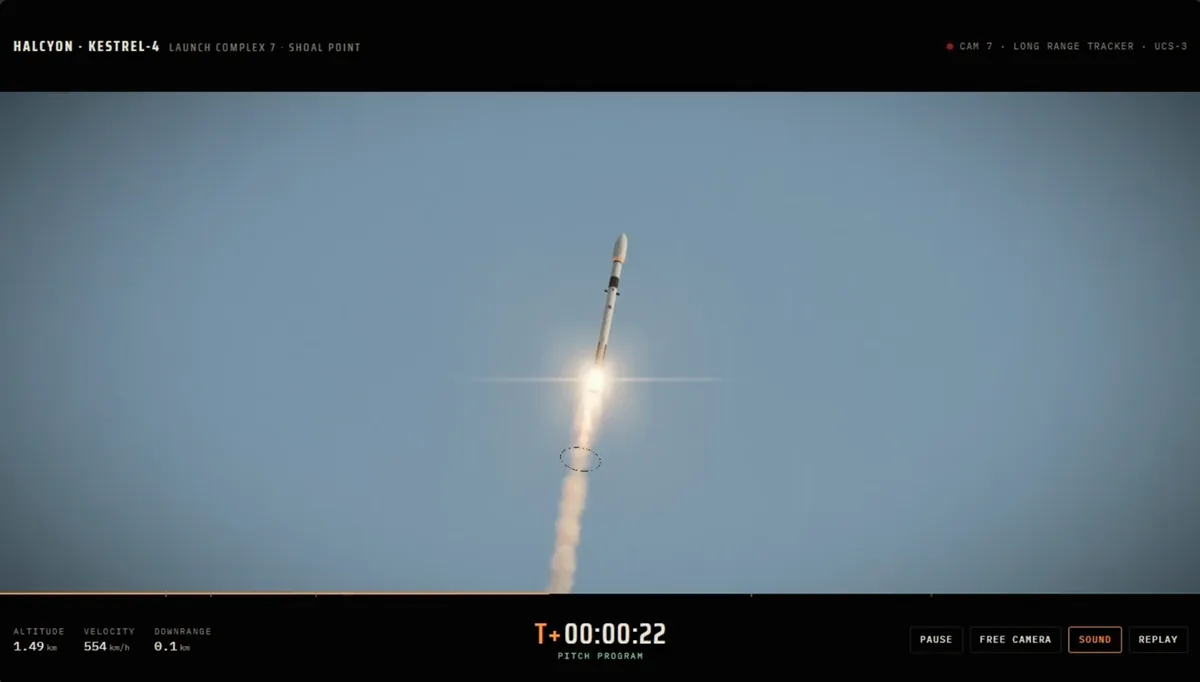
3D-Globus (eine von 4 Aufgaben)
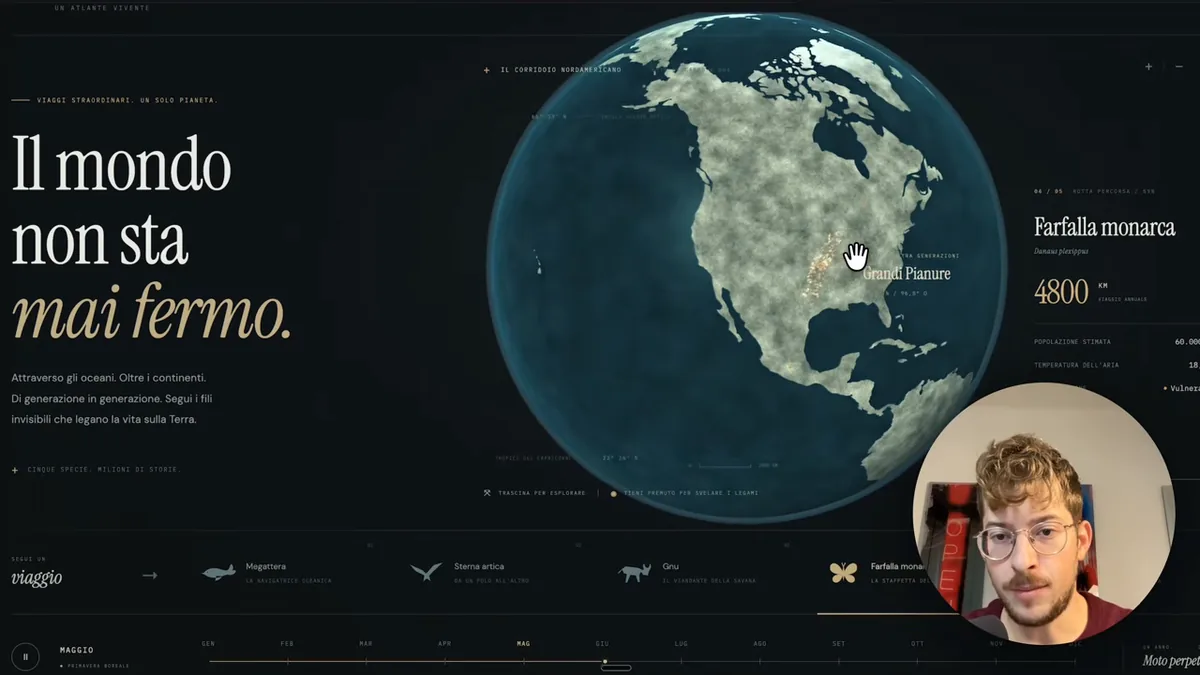
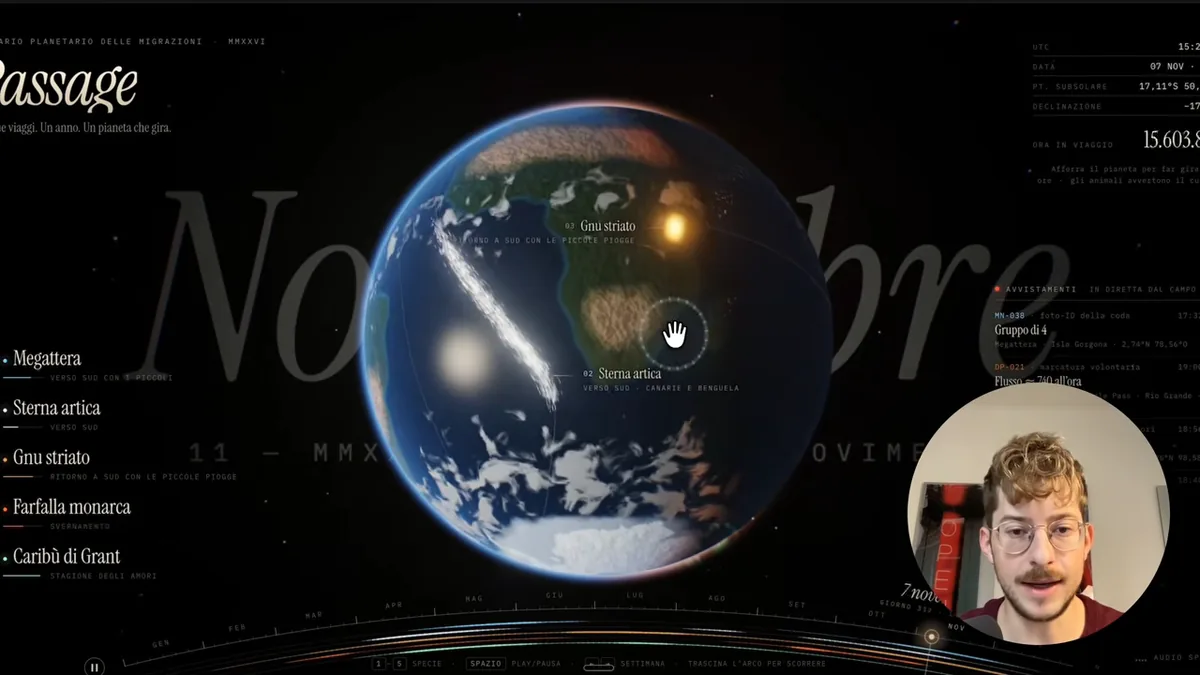
Grundriss-Werkzeug
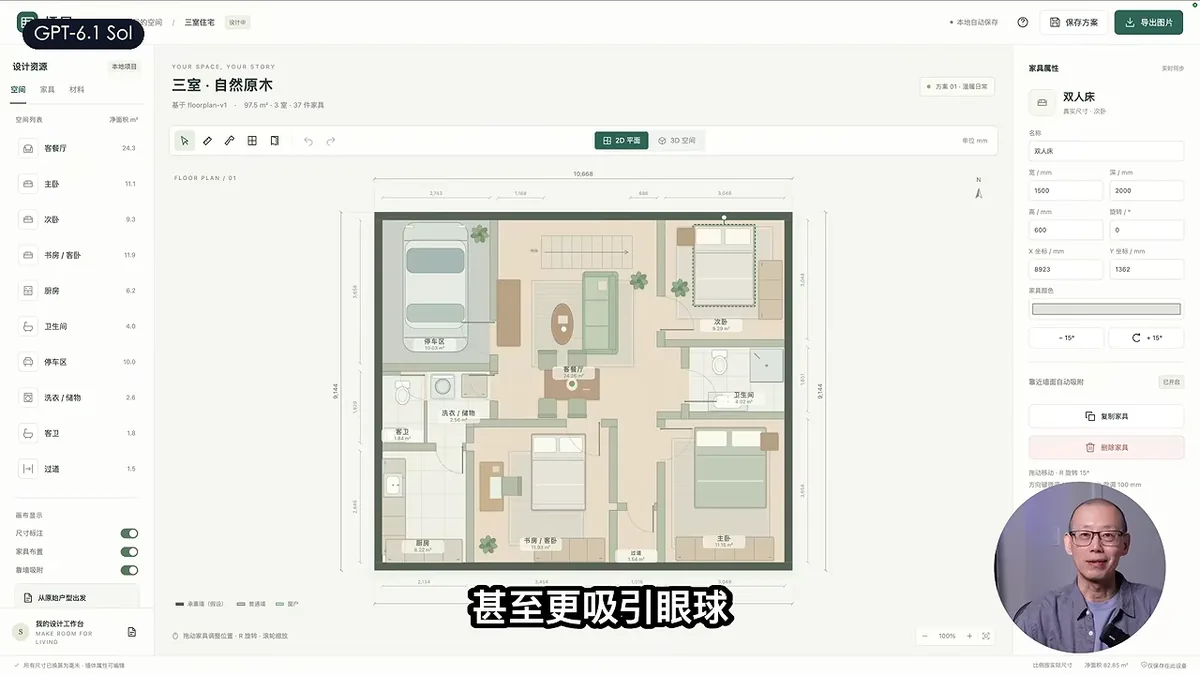
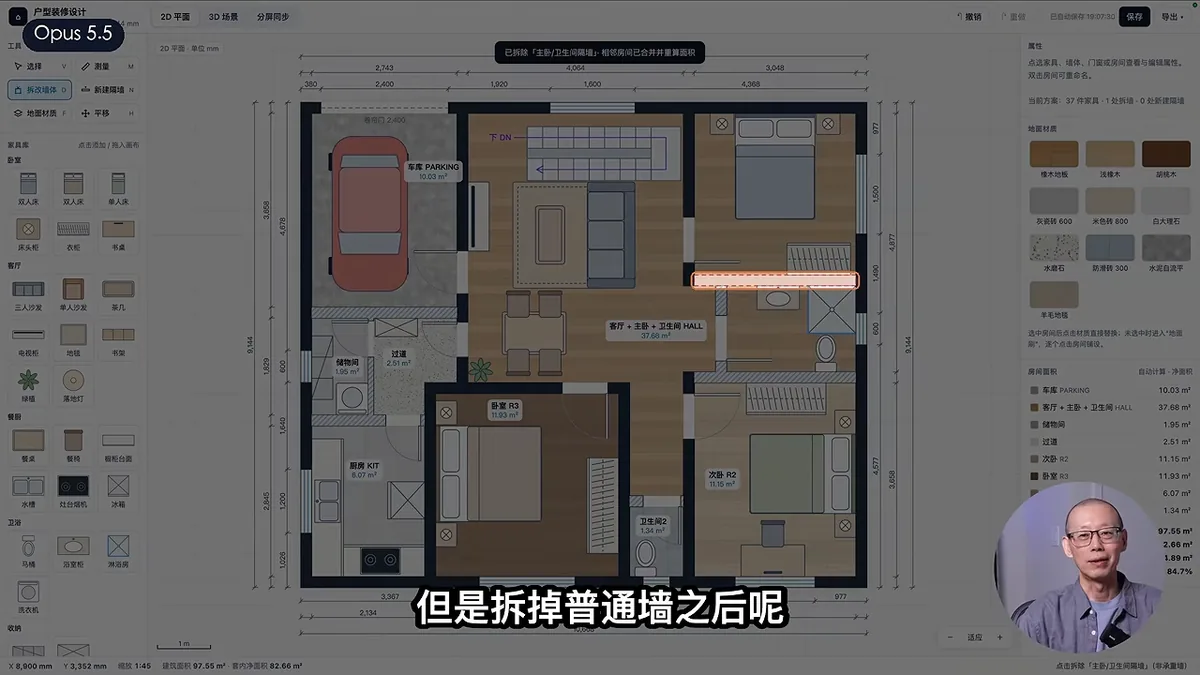
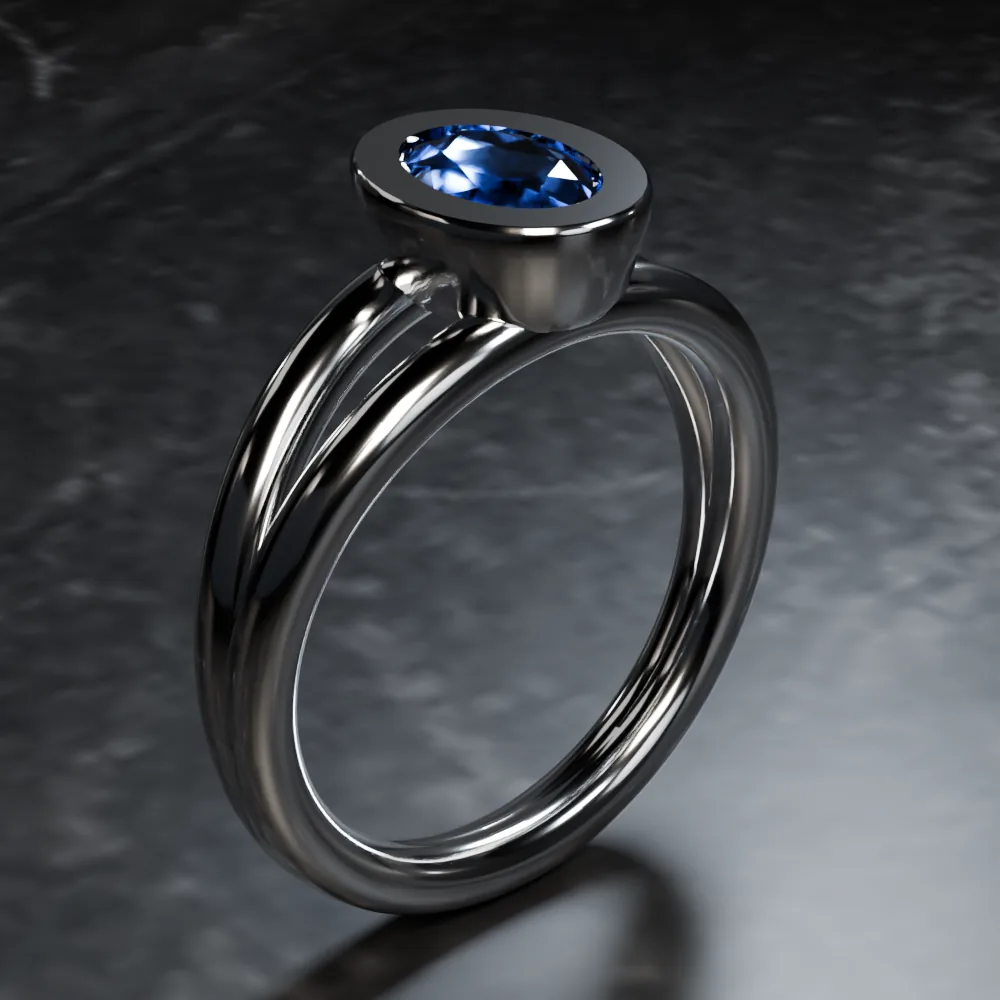
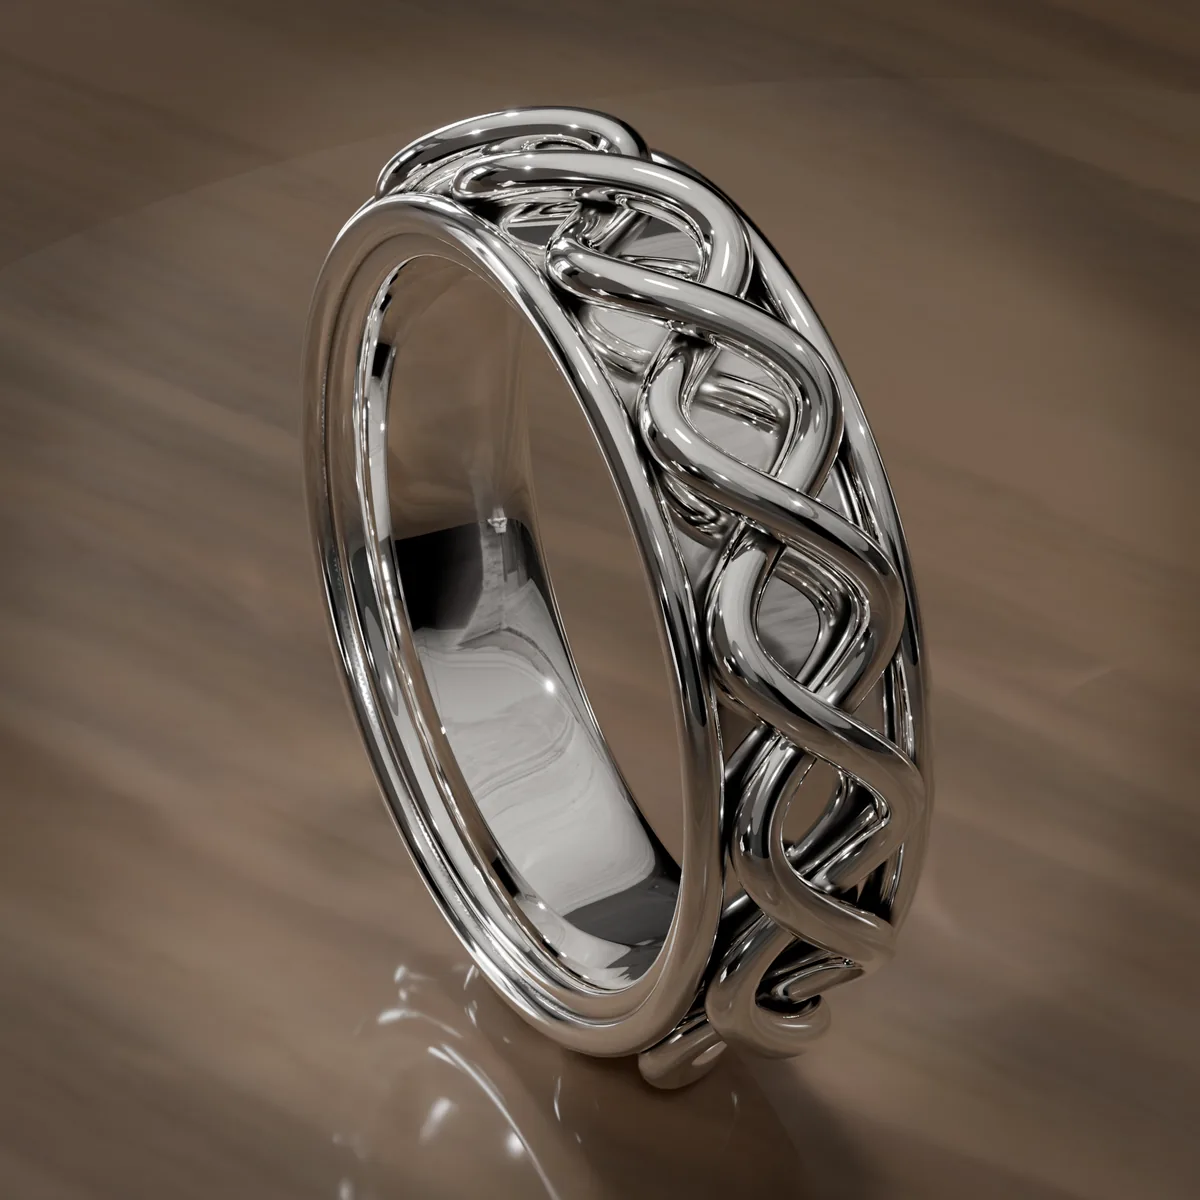
Keltischer Ring in Blender
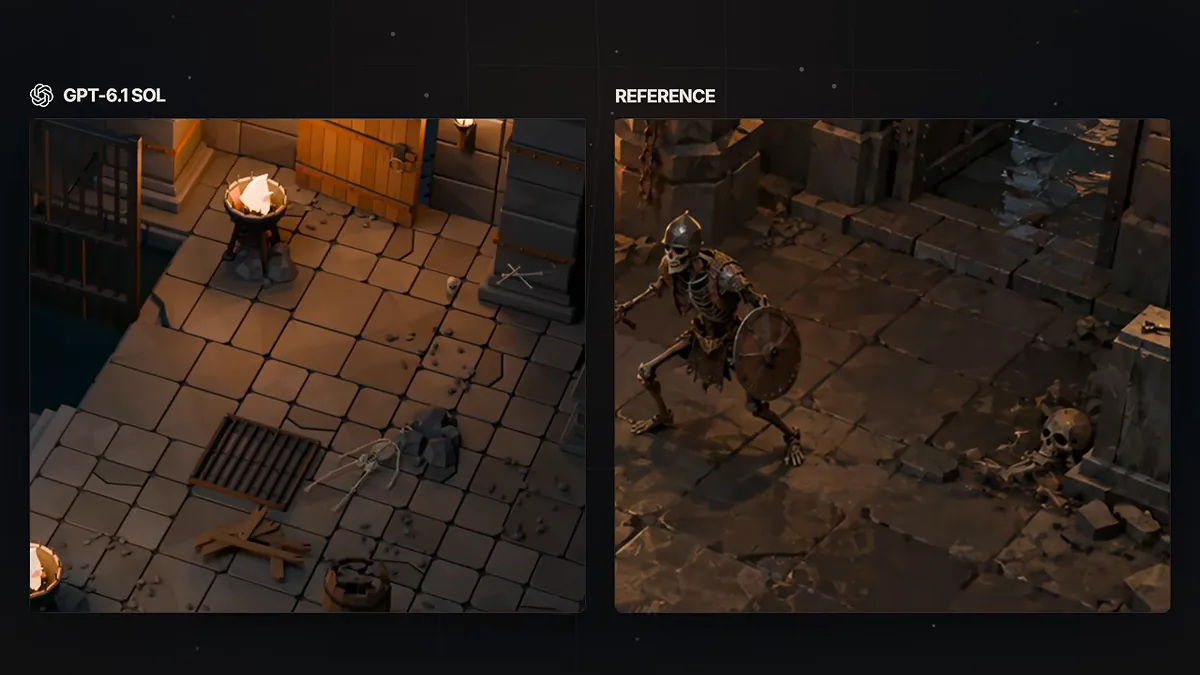
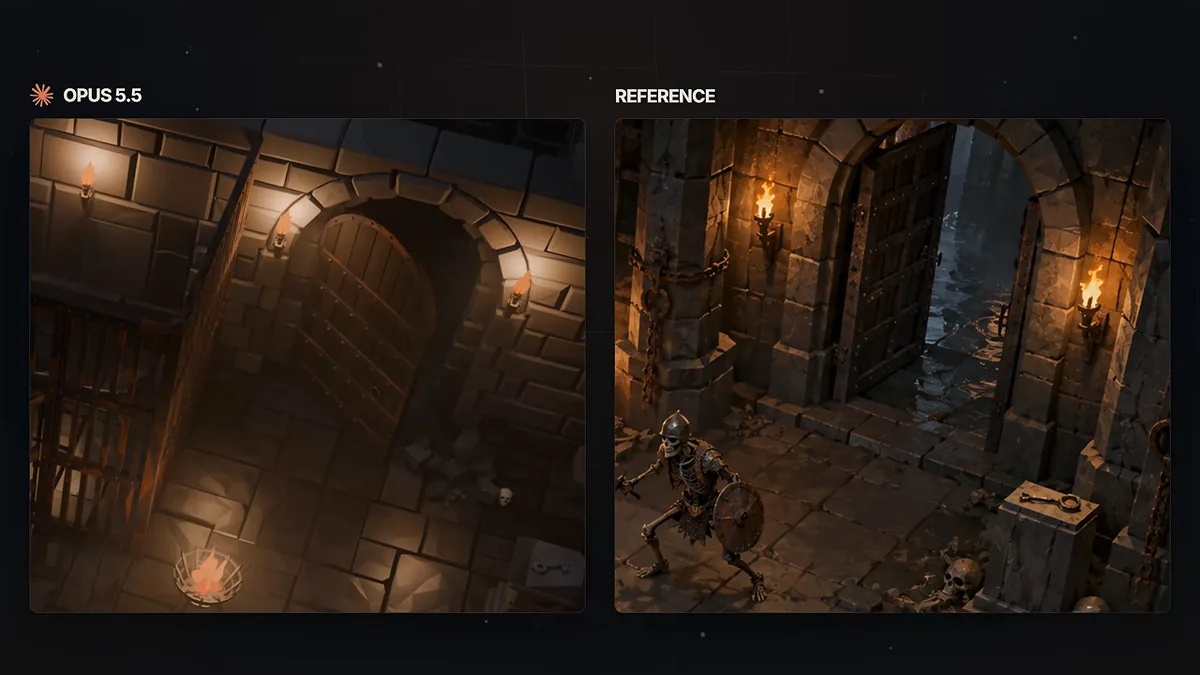
Dungeon-Szene nach Vorlage
Terminplaner für eine Praxis in einer Datei
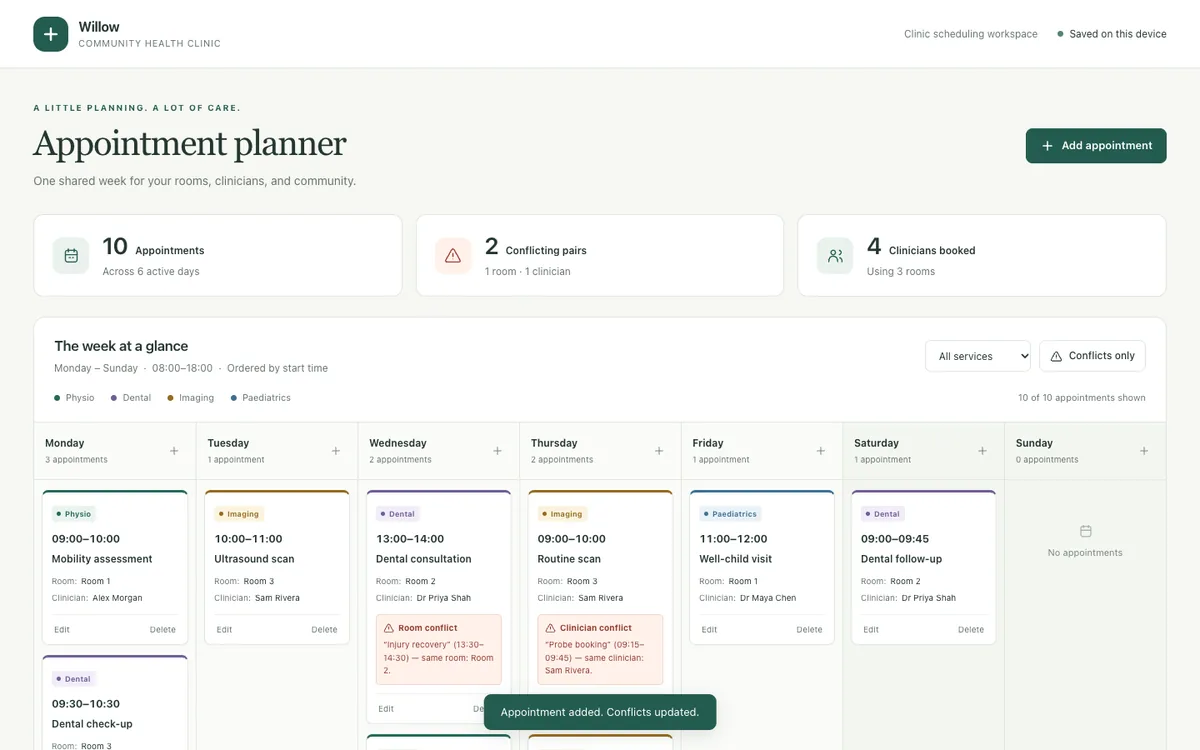
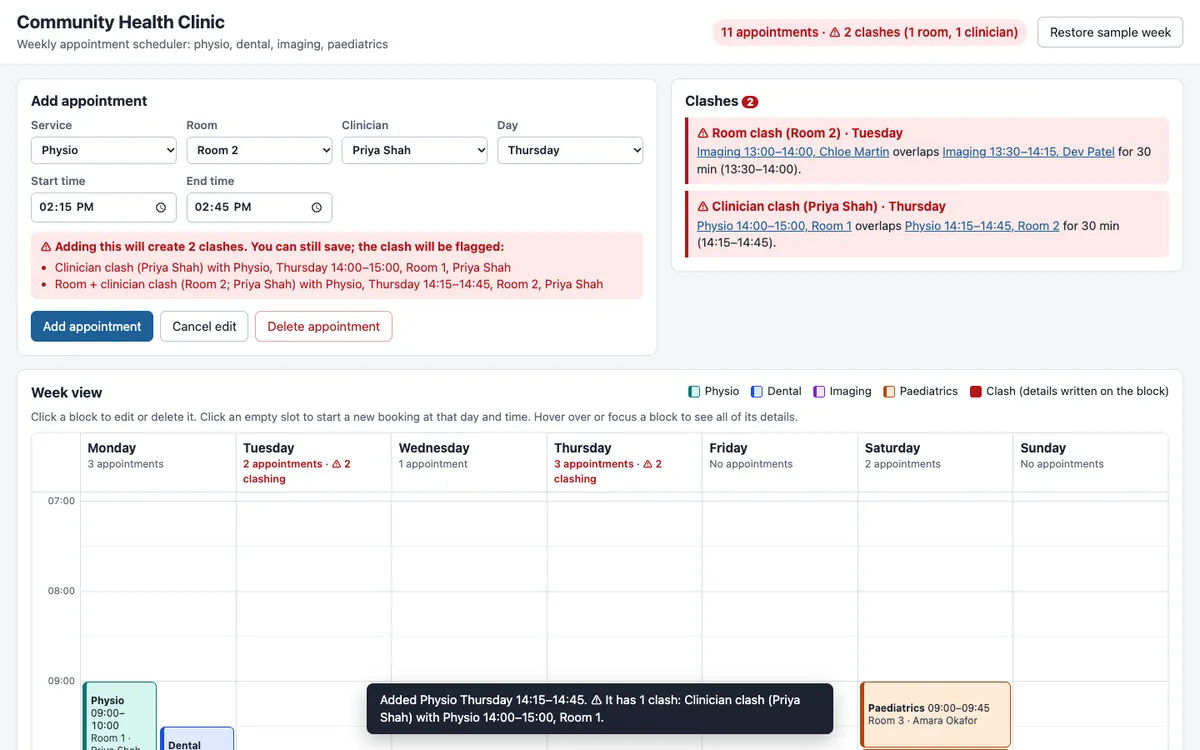
Pelikan auf dem Fahrrad als SVG
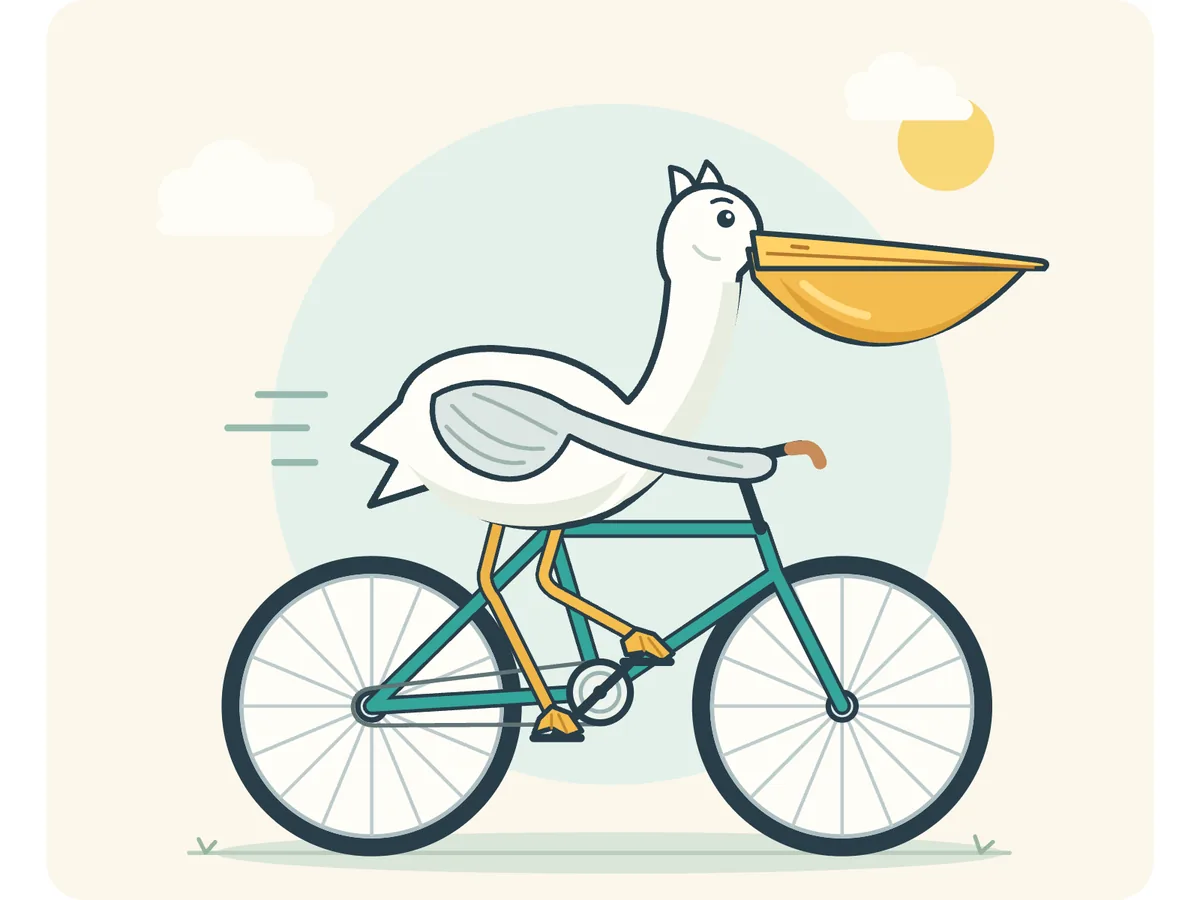
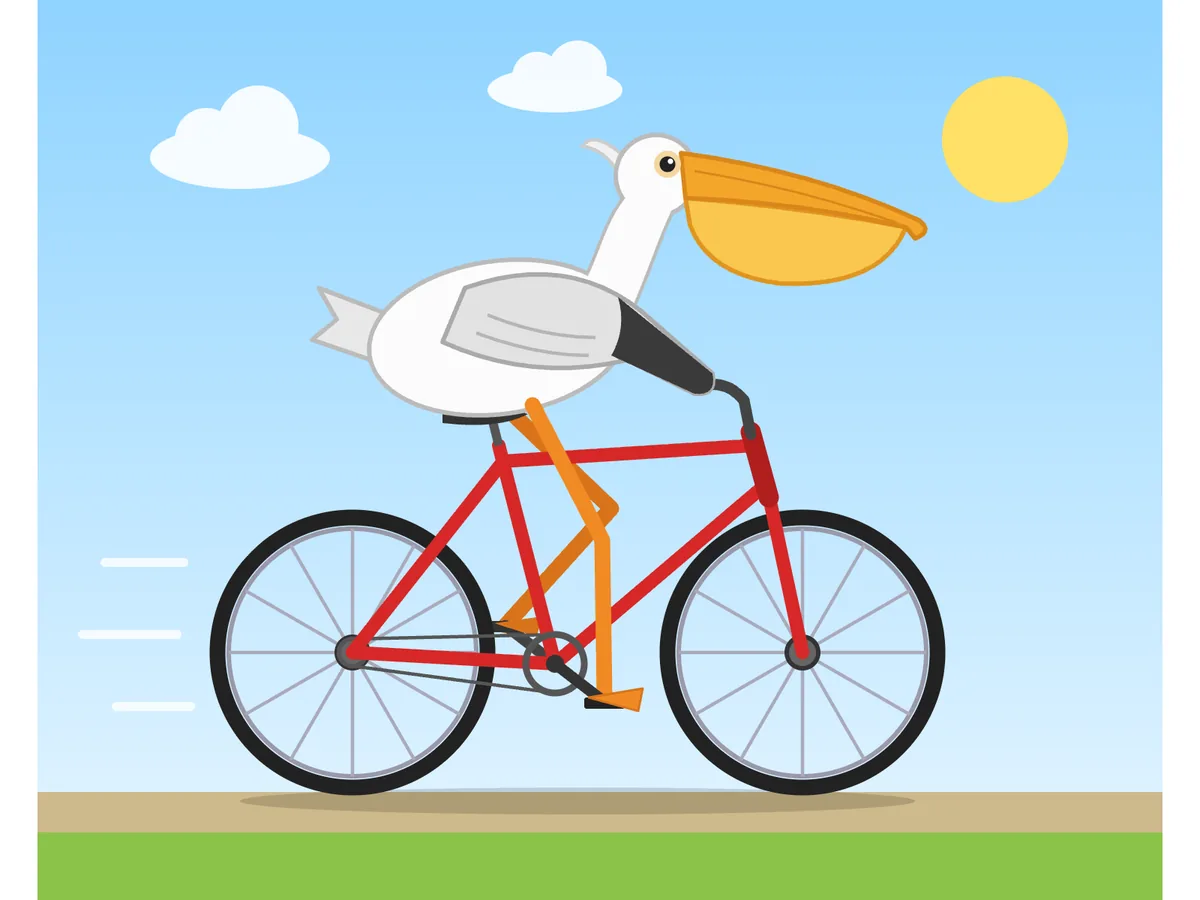
Animationsfilm aus Code
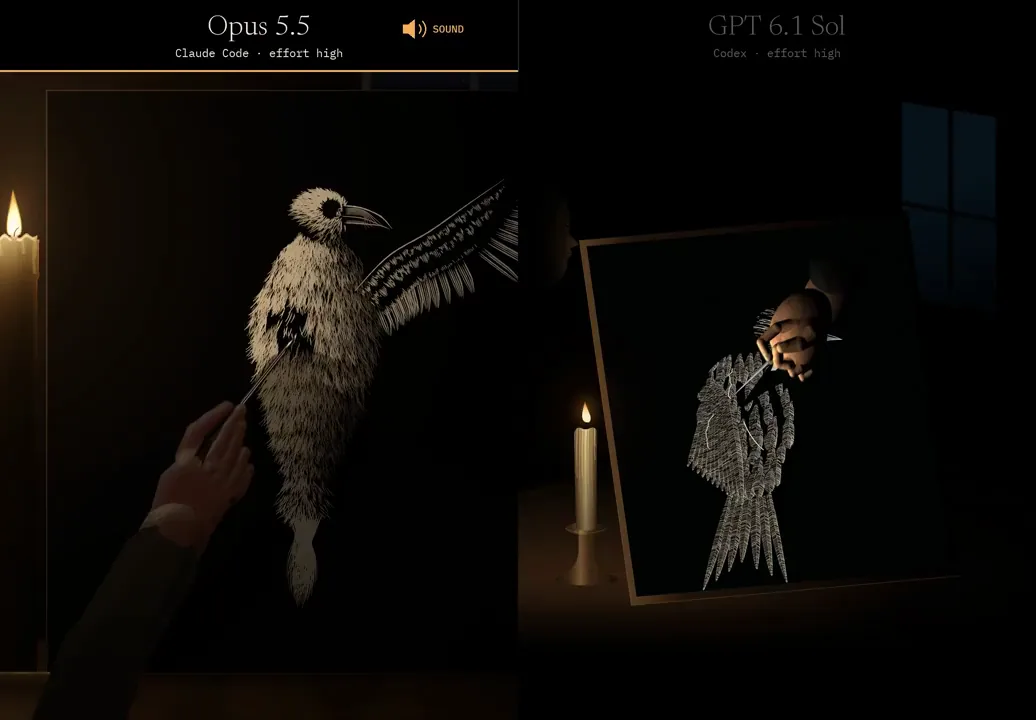 Opus links, Sol rechts
Blatt aus Buntglas
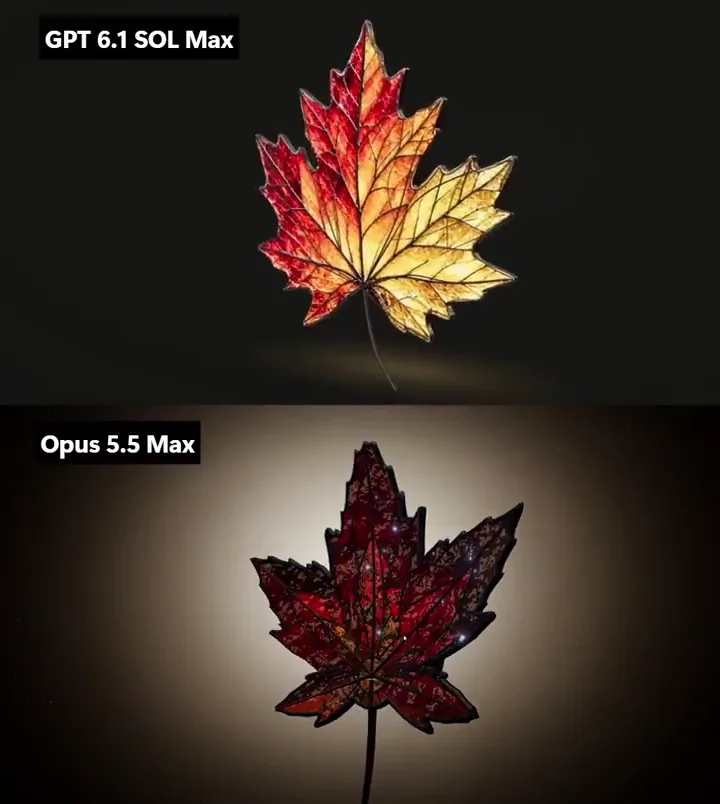 Sol oben, Opus unten
Was die Videos zeigen
Ich habe 16 YouTube-Videos ausgewertet, mit Transkript und Standbildern. Nicht alle testen, was der Titel verspricht. Drei Videos vergleichen noch GPT-6 Sol, den Vorgänger vom 22.09., zwei testen Sonnet 5.5 statt Opus. Die wichtigsten:
| Video | Test | Ergebnis | Einordnung |
|---|---|---|---|
| IchBinFabian (deutsch), 02.10. | App aus Screenshot, 3D-Weichenspiel, Blender-Szene, beide medium | Sol knapp bei der App, Opus klar beim Spiel, Opus knapp bei Blender; zusammen 1,45 $ gegen 8,50 $ | Setup und Prompts im Bild, je ein Lauf |
| Marvijo AI, 30.09. | 10 echte Bugs, beide high, danach die ganze Testsuite | beide 10 von 10, Sol brach 4 von 2.902 Tests, Opus keinen | stärkstes Video für bestehende Projekte |
| Theo (t3.gg), 29.09. | Reviews in großen Repos und Bauaufgaben | Sol der bessere Prüfer, Opus der bessere Umsetzer | Vorabzugang von OpenAI, Sponsor im Video |
| Company Under Glass, 30.09. | dieselbe Landingpage auf vier Stufen | auf low beide 100 Punkte, auf xhigh Opus vorn | transparent, kleiner Kanal |
| Can It Code?, 30.09. | Dungeon-Szene in Blender, Figuren, Spiel | 3 zu 0 für Opus, Kosten 29,17 $ gegen 376,30 $ | zeigt gut, warum Sol so billig ist |
| AISeeKing, 30.09. | drei Aufgaben in einem kleinen Projekt, beide medium | bei beiden 38 von 38 Prüfpunkten, Sol rund ein Drittel der Kosten | fair, aber zu leicht für Unterschiede |
| 回到Axton, 01.10. | vier Neubauten, beide high | 3 zu 0 für Opus, ein Unentschieden | Prompts veröffentlicht |
| Nate Herk, 23.09. | 10 Anwendungsfälle | 7 zu 1 für Opus, 2 Tests ungültig | testet GPT-6 Sol, den Vorgänger |
| Bijan Bowen, 01.10. | vier Aufgaben, Max gegen Max | 3 zu 0 für Sonnet 5.5, ein Unentschieden | auf Claude-Seite lief Sonnet, nicht Opus |
Über alle Videos, die wirklich GPT-6.1 Sol gegen Opus 5.5 testen, habe ich 38 Einzeltests gezählt. 21 gehen an Opus, 9 an Sol, 8 enden unentschieden. Bei Neubauten steht es 14 zu 2 für Opus. In bestehenden Codebasen ist es enger: Bei Reviews, Audits und Fehlersuche gewinnt Sol mit 4 zu 1, beim Arbeiten in einer gewachsenen App mit vielen Tests eher Opus mit 5 zu 1. Die Zählung ist meine eigene, die Tests sind Einzelläufe mit unterschiedlichen Stufen.
Fabians Video lohnt sich besonders, weil es deutsch ist und die Bedingungen offenlegt. Er hat beiden auf medium dieselben Aufgaben in getrennten Ordnern gegeben. Beim Nachbau seiner App nach einem Screenshot sah er Sol minimal vorn: „Sol 6.1 hat minimal besser gearbeitet“ (9:56). Beim 3D-Weichenspiel gewann Opus klar, bei gleicher Zeit von rund 15 Minuten. Sol kostete dort 0,55 $, Opus 3,42 $: „Sol kostet hier nur ungefähr ein Sechstel von Opus. Aber die Qualität leidet natürlich drunter“ (16:43). Sein Fazit: Sol ersetzt Claude „in der Regel nicht so ganz“, am besten plane Opus, Sol setze um und Opus prüfe (25:19).
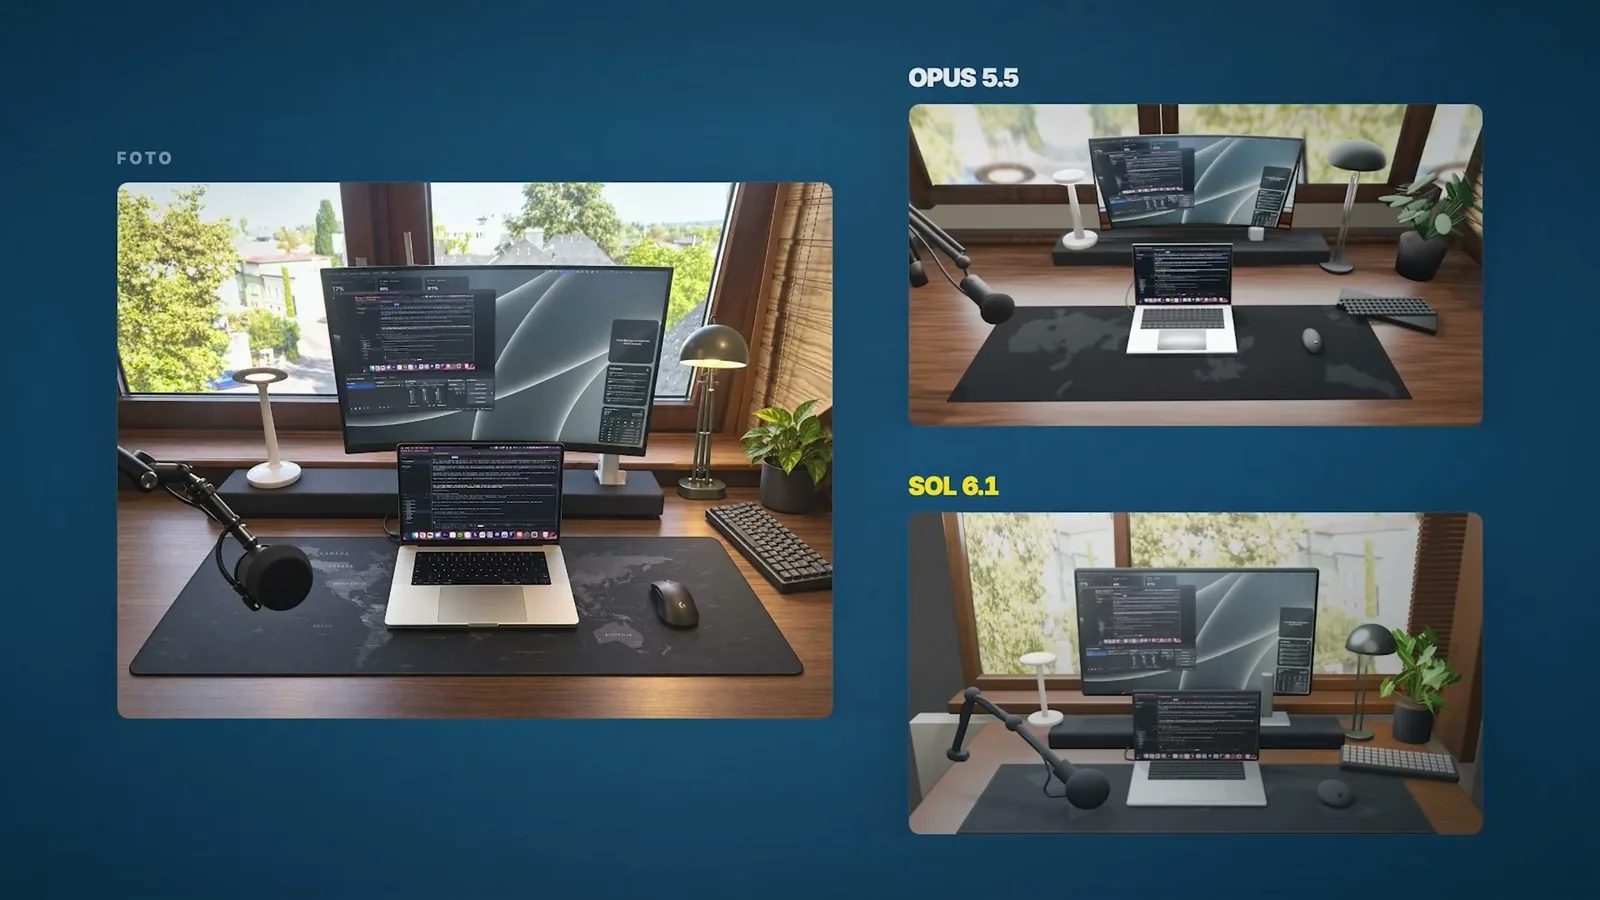
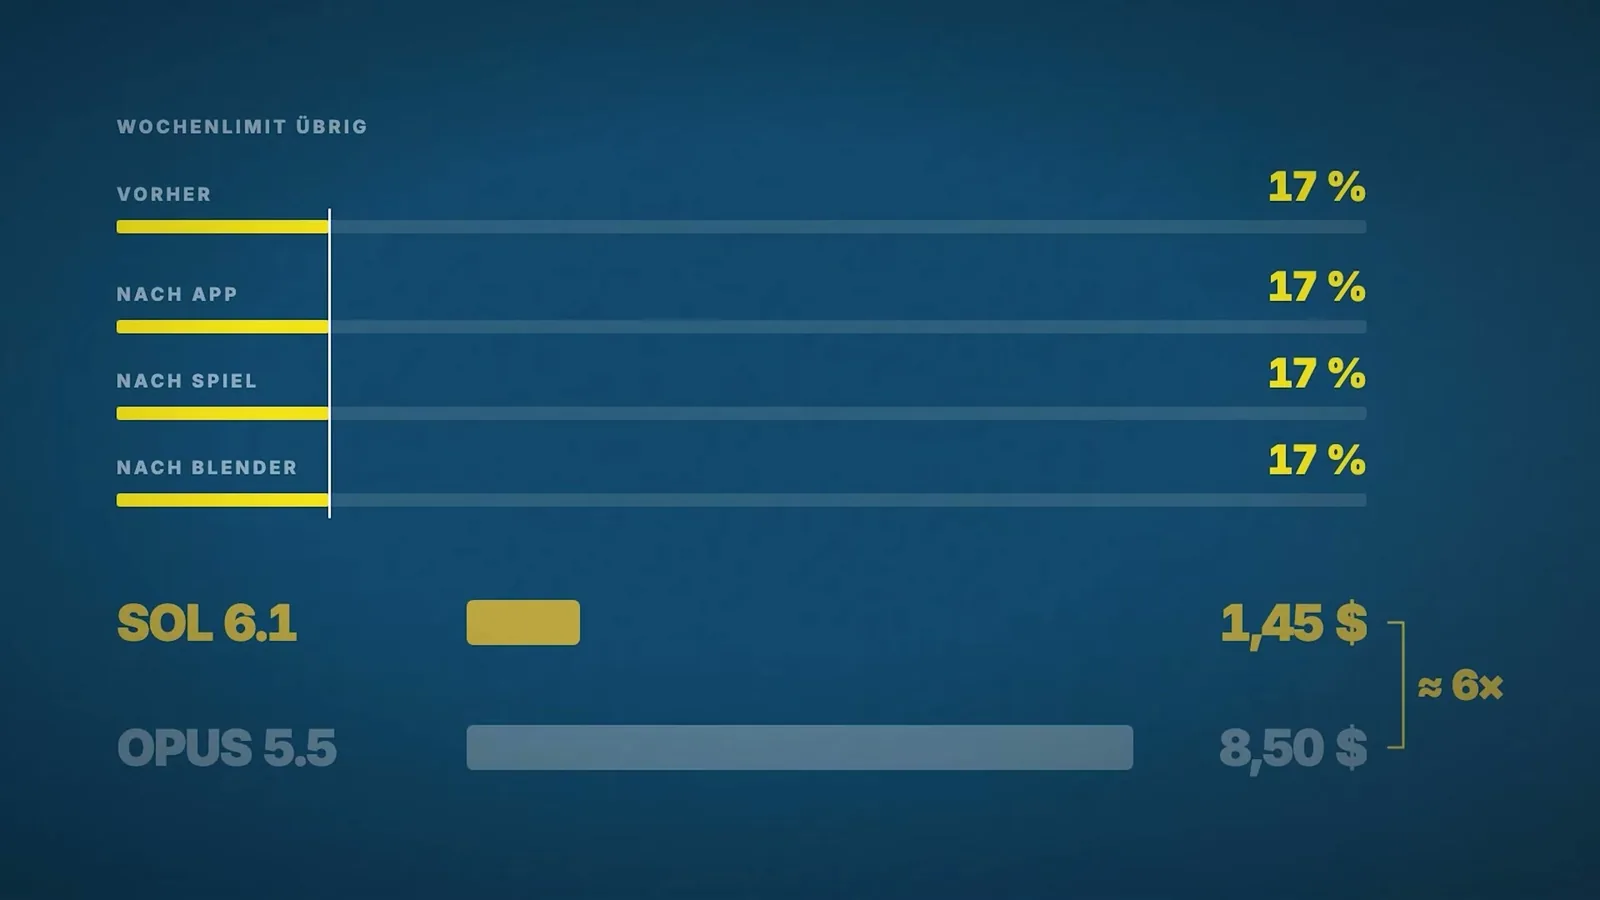
Ein Hinweis zum oft geteilten Video von Nate Herk („I Tested Opus 5.5 vs. GPT-6 Sol on 10 Real Use Cases“): Es kam am 23.09. hoch, sechs Tage vor GPT-6.1 Sol, und testet den Vorgänger. Spannend ist es trotzdem. Opus gewann 7 von 8 gültigen Tests, alle kreativen und neuen. Der einzige Test in einer großen bestehenden Codebasis ging an Sol: 100 von 100 Punkten für 1,04 $ gegen 96,7 Punkte für 19,82 $ bei Opus. Entworfen und wohl auch bewertet hat diesen Test allerdings GPT-6 Astra, also ein OpenAI-Modell.
Kosten: Ist Codex wirklich günstiger?
Das ist die Frage, über die am meisten gestritten wird. Die Antwort hängt davon ab, ob du per API zahlst oder ein Abo hast.
Über die API: ja, deutlich
Je Token kostet Opus genau das Doppelte. Je Aufgabe ist der Abstand größer, weil Opus mehr liest, mehr Schritte macht und mehr schreibt. Der Baustein zeigt, wie viel teurer Opus je Aufgabe in den einzelnen Tests war.
API-Gegenwert zu Listenpreisen. Im Abo zahlst du nicht je Token, dort zählt das Kontingent. Quellen: cognition.ai/frontiercode, ibragim.dev, artificialanalysis.ai, youtube.com/watch?v=Zlta8wD0Spc, paddo.dev, vals.ai, bughunt.productcompass.pm, getdot.ai. Stand 03.10.2026.
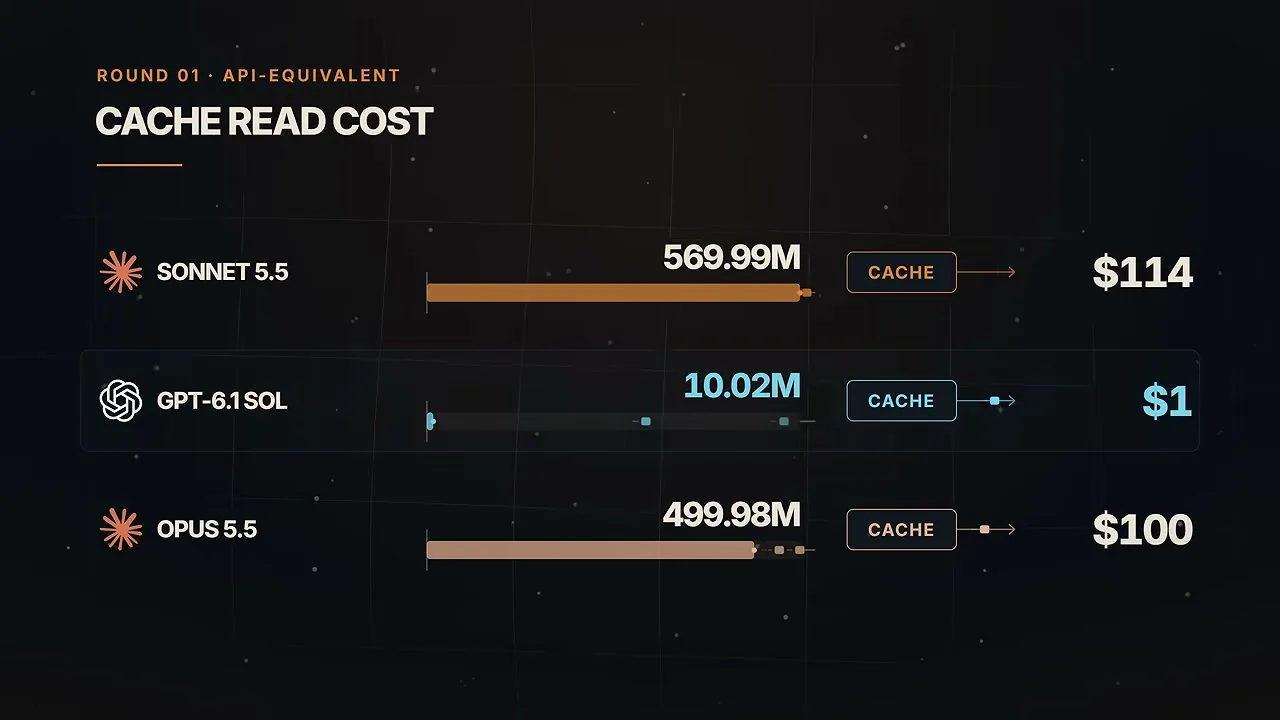
Bei kleinen, klaren Aufgaben ist Opus 2- bis 2,5-mal so teuer, bei langen agentischen Aufgaben 6- bis 12-mal. Der Grund steckt im Kontext. Opus liest bei jedem Schritt den ganzen bisherigen Verlauf aus dem Cache, und der wächst in Claude Code bis auf 1 Million Token. Im Dungeon-Test von Can It Code? las Opus allein in der ersten Runde rund 500 Millionen Token aus dem Cache, für 100 $. Sol las 10 Millionen, für 1 $. Dazu kommt, dass Cache-Lesen bei Sol mit 0,10 $ je Million Token nur halb so viel kostet wie bei Opus.
Es gibt Ausnahmen. Über 272.000 Token Eingabe verlangt OpenAI für Sol den doppelten Eingabe- und den 1,5-fachen Ausgabepreis, dann schrumpft der Vorteil je Token fast auf null. Und im Café-Bench, einem langen Agentenlauf ohne Code, war Opus auf medium sogar billiger und 4,5-mal schneller als Sol.
Im Abo: viel knapper, als es sich anfühlt
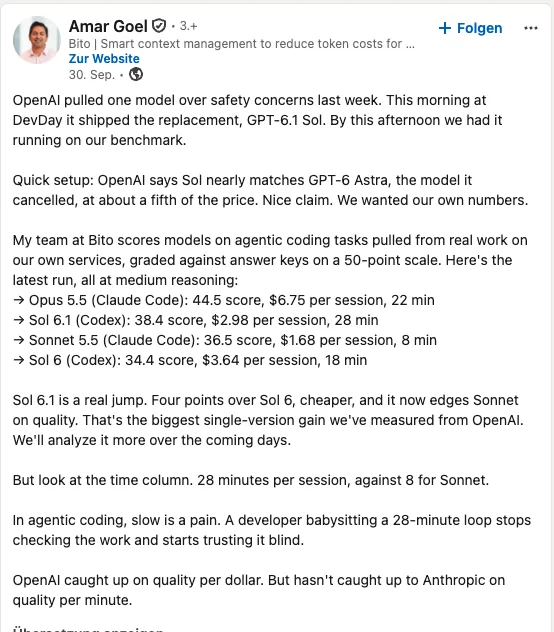
Im Abo zahlst du nicht je Token, sondern hast ein Kontingent. Und dort kommt der niedrige API-Preis von Sol offenbar nicht voll an. Zwei unabhängige Messungen, ein Thread in r/codex und das Werkzeug real-api-pricing, kommen für eine Woche ChatGPT Plus mit Sol 6.1 auf nur 43 bis 45 $ API-Gegenwert. Eine Woche Claude Pro mit Opus 5.5 liegt laut real-api-pricing bei 260 bis 320 $. Beide kosten 20 $ im Monat. Ein Kommentar in r/codex bringt es auf den Punkt: „despite being 3.4 times cheaper per API task, GPT 6.1 Sol XHigh consumes nearly 40% more of the ChatGPT Plus quota than Opus 5.5 consumes of the Claude Pro quota“ (30.09.2026). Jannik Reinhard, Head of AI bei Epic Fusion, schreibt auf LinkedIn dasselbe kürzer: Die Preissenkung gilt für „API prices, though, not an 80% cut to your ChatGPT subscription“ (30.09.2026).
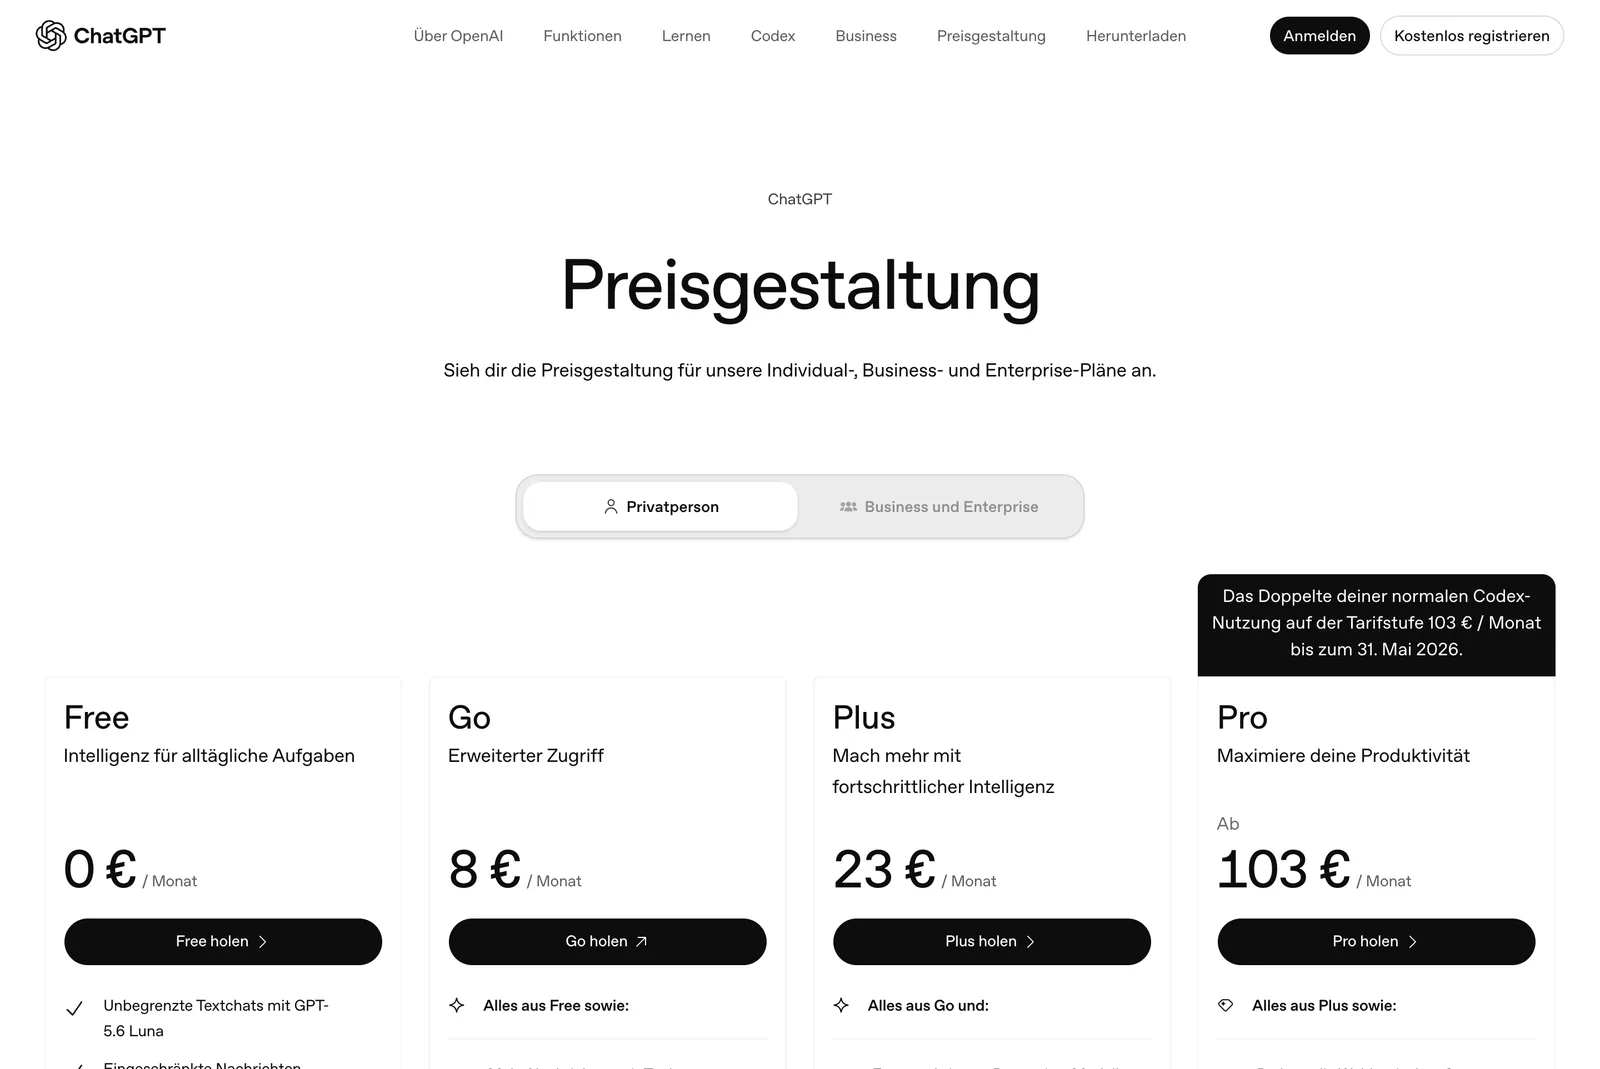
Bei den großen Abos ändert sich gerade viel. Pro 200 liefert bei OpenAI bis zum 29. Oktober noch das 20-Fache von Plus, ab dem 30. Oktober nur noch das 10-Fache, zum selben Preis. Als Ausgleich bekamen Bestandskunden 62.500 Credits, die am 31.12.2026 verfallen. Die Pro-Tarife haben kein 5-Stunden-Fenster mehr, nur ein Wochenlimit. In Deutschland kostet Pro 200 229 € im Monat. Ab dem 30.10. zahlst du dort für eine Plus-Einheit 22,90 €, fast so viel wie für Plus selbst (23 €). Bei Pro 100 sind es 20,60 €, bei Pro 500 20,40 €.
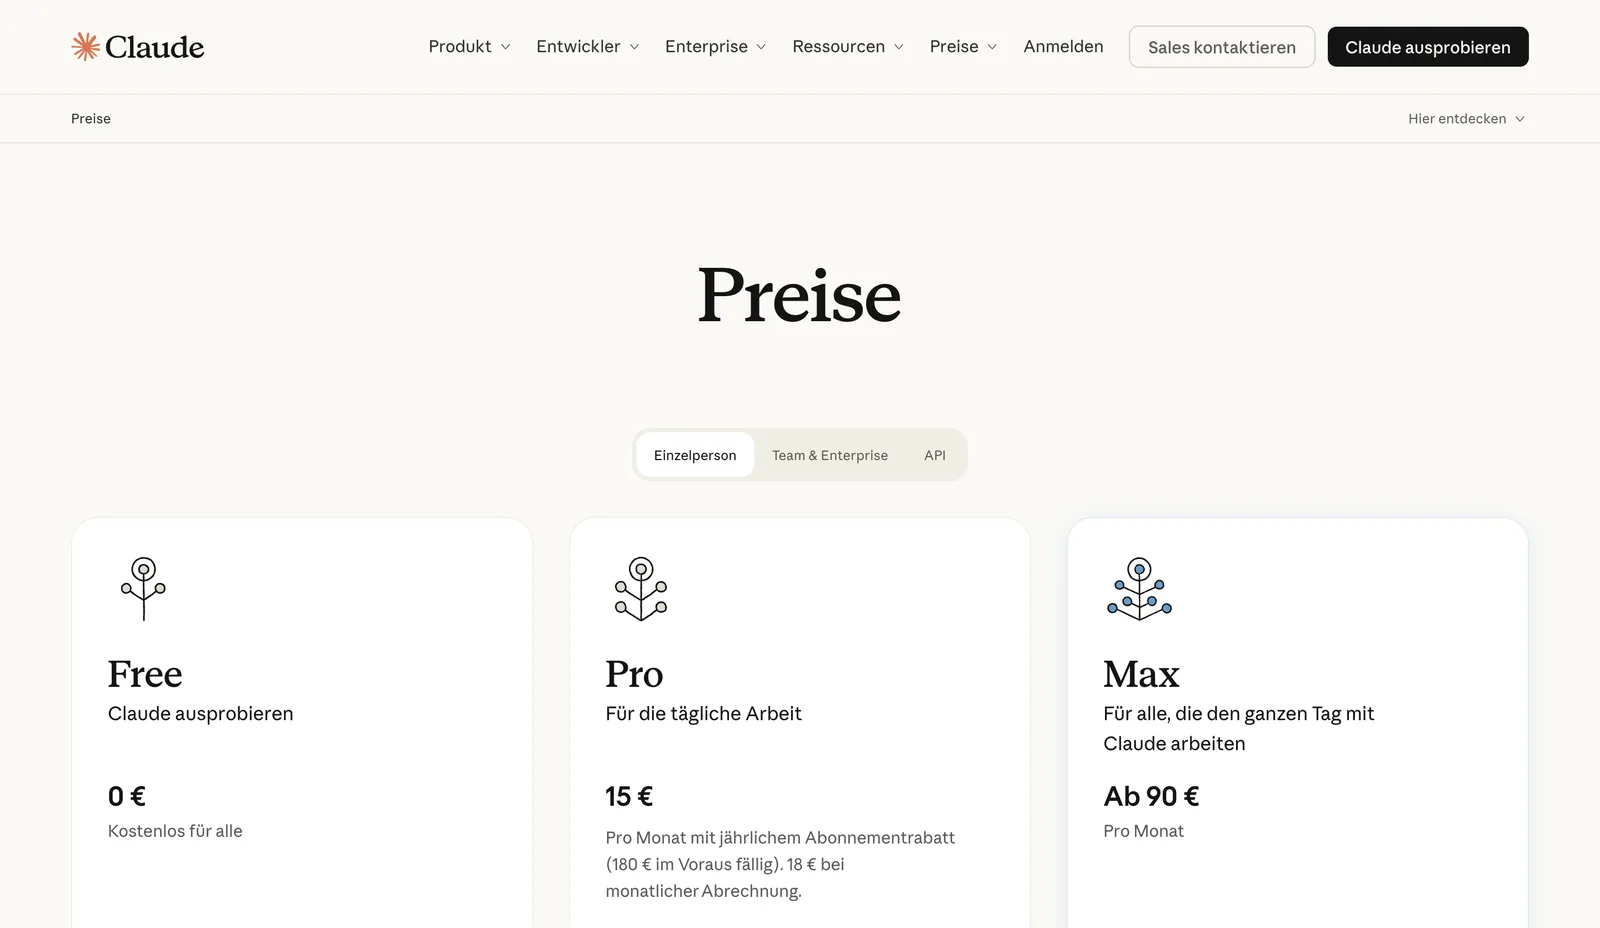
Bei Claude kostet Max 5x 100 $ (90 € netto, rund 107 € brutto), Max 20x 200 $. Eine 10x-Stufe gibt es nicht. Anthropic nennt die Faktoren 5x und 20x je Sitzung, für die Woche gibt es keine offizielle Zahl. Nach Community-Messungen liefert Max 20x je Woche Opus-Arbeit im API-Gegenwert von 2.000 bis 2.900 $. Für Max 5x gibt es keine direkte Messung. Dazu kommt bei Claude auf allen Stufen das 5-Stunden-Fenster.
Und meine eigenen Zahlen? In 11 Tagen hat mir Claude Max 5x Arbeit im API-Gegenwert von 1.674 $ geliefert, das 46-Fache des anteiligen Abopreises von 36 $. Codex Pro 200 kam auf 695 $, das 9,6-Fache von 72 $, wobei ich das Wochenlimit nie ausgereizt habe. Für Sol allein habe ich gemessen: Eine aktive Stunde auf xhigh kostet mich 1,0 Prozentpunkte des Wochenlimits, auf ultra 1,2. Mit dem alten Pro 200 sind das rund 100 Stunden pro Woche, ab dem 30.10. rund 50.
Die Codex-Werte stammen aus meinen eigenen Protokollen (Pro 200, 30.09. bis 02.10.2026), die Claude-Werte aus Community-Messungen mit dem Werkzeug real-api-pricing. Claude hat zusätzlich ein 5-Stunden-Fenster: Ich bin mit Max 5x in 11 Tagen viermal hineingelaufen, bei Codex Pro gibt es nur das Wochenlimit. Eine Stunde Opus schafft mehr als eine Stunde Sol, weil Opus im Abo etwa viermal so schnell schreibt. Bei Plus weichen meine hochgerechnete Messung und die Community-Messung stark voneinander ab, deshalb die Spanne. Stand 03.10.2026.
Die Rechnung in einem Satz: Über die API ist Sol je Aufgabe 3- bis 12-mal günstiger. Im Abo bekommst du für 20 $ bei Claude Pro mehr als bei ChatGPT Plus, bis zum 29.10. ist Codex Pro 200 stark, und ab dem 30.10. liegt Claude Max je Dollar etwa gleichauf oder vorn. Der größte Vorteil von Codex im Alltag ist, dass die Pro-Tarife kein 5-Stunden-Fenster haben.
Tempo: Wer ist schneller fertig?
Über die API ist Sol bei vielen Aufgaben schneller fertig, obwohl es langsamer schreibt. Artificial Analysis misst im Coding Agent Index 15,5 Minuten je Aufgabe für Sol und 64,5 für Opus, weil Opus viel mehr Schritte macht. Im Abo war es in der ersten Woche umgekehrt. Sol schrieb in Codex nur 20 bis 25 Token pro Sekunde, Opus in Claude Code rund 90. Im Bug Hunt Bench brauchte Sol auf xhigh 98,7 Minuten je Lauf, Opus 42,5. In meinen Protokollen dauerte eine typische Sol-Aufgabe 7,3 Minuten, eine Opus-Aufgabe 2,5. Die Einzelheiten stehen in meinem Beitrag GPT-6.1 Sol langsam?.
Ein Teil davon lag an der Last nach dem Start. Am 02.10. entschuldigte sich Tibo Sottiaux für den langsamen Start, setzte die Limits aller Nutzer zurück (X) und schrieb, Sol laufe nach dem „massive load spike“ wieder mit dem erwarteten Tempo. Nutzer in r/codex berichten seitdem von 30 bis 41 % mehr Tempo. Eine unabhängige neue Messung gibt es noch nicht. Opus bleibt im Abo aber das deutlich schnellere Modell. Der Top-Kommentar in einem großen r/codex-Thread mit 184 Punkten: „Opus is approx 10x faster than 6.1-SOL“ (30.09.2026).
Welche Stufe lohnt sich?
Beide Modelle lassen sich auf fünf Denkstufen stellen, von low bis max. Die naheliegende Annahme, dass mehr Denken besseren Code bringt, stimmt beim Programmieren nur selten.
| Stufe | Sol 6.1: Index und Kosten je Aufgabe | Opus 5.5: Index und Kosten je Aufgabe | Bug Hunt: Funde Sol und Opus | FrontierCode: Sol und Opus |
|---|---|---|---|---|
| low | 42,1 / 0,13 $ | 42,3 / 0,55 $ | 22,5 und 22,3 | 45,5 und 47,3 |
| medium | 47,8 / 0,21 $ | 51,2 / 1,34 $ | 29,0 und 30,3 | 50,2 und 54,6 |
| high | 50,2 / 0,32 $ | 53,6 / 1,82 $ | 36,5 und 31,7 | 48,0 und 54,0 |
| xhigh | 51,0 / 0,39 $ | 56,0 / 3,46 $ | 42,7 und 36,0 | 49,3 und 51,4 |
| max | 51,8 / 0,72 $ | 57,6 / 5,98 $ | 44,3 und 41,7 | 47,6 und 54,4 |
Quellen: Intelligence Index von Artificial Analysis, Bug Hunt Bench, FrontierCode, abgerufen am 03.10.2026.
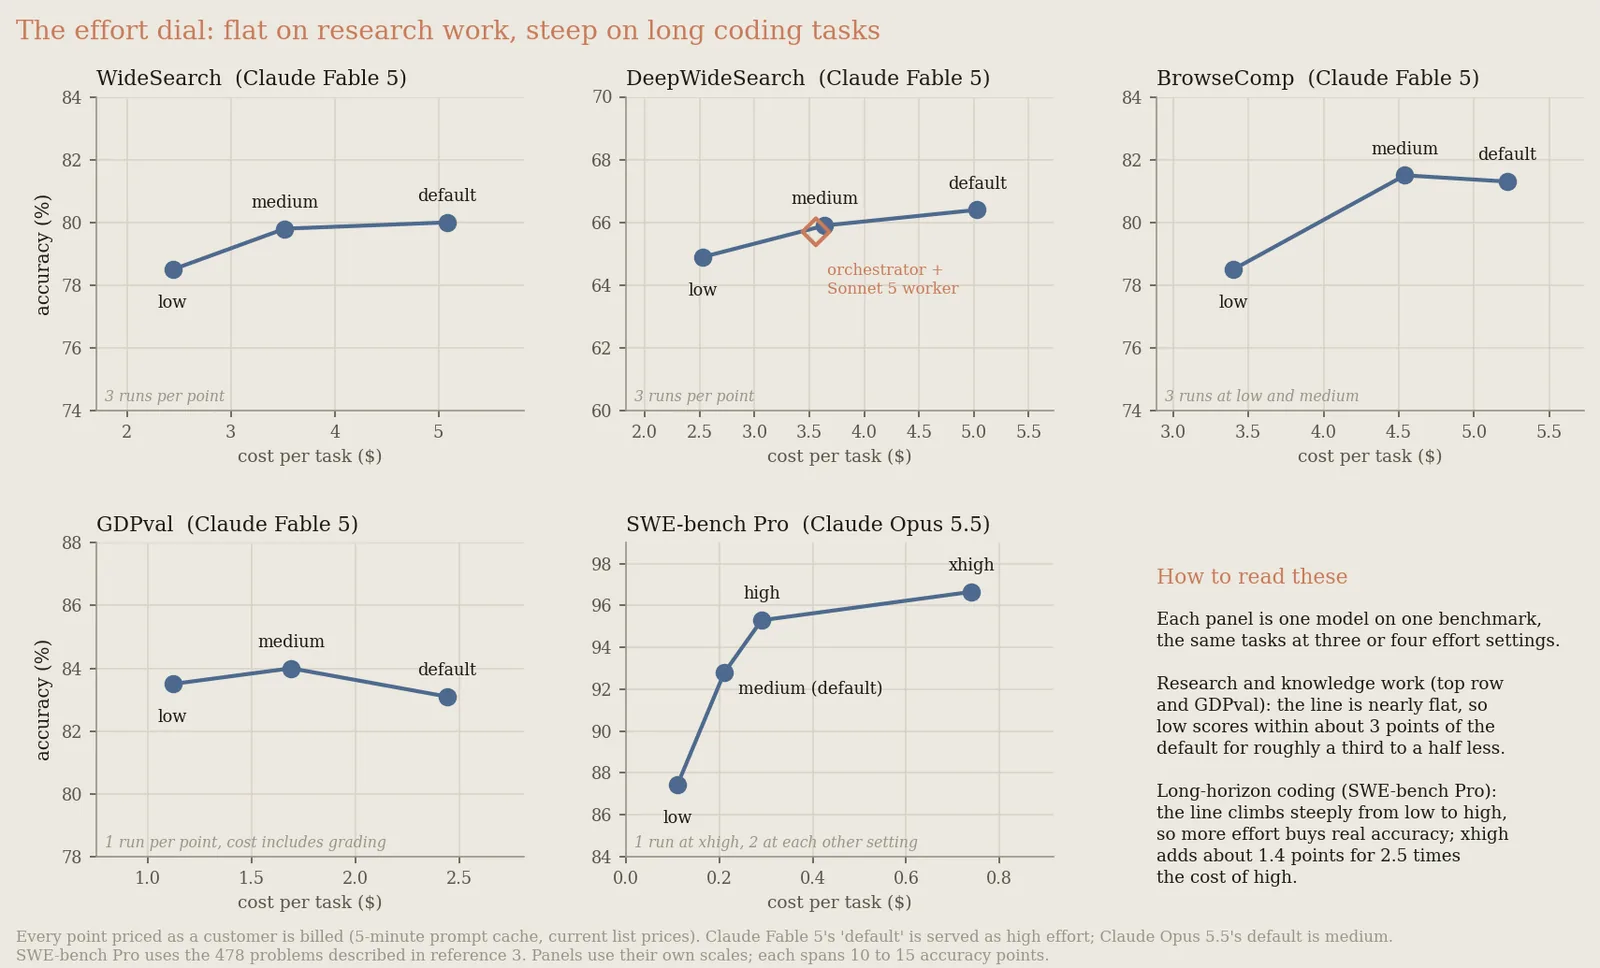
Daraus folgen drei Regeln. Erstens: Bei Sol bringt max gegenüber xhigh kaum etwas. Im Coding Agent Index ist xhigh mit 62,9 sogar besser als max mit 60,1, und OpenAIs eigener DeepSWE-Test zeigt high vor xhigh und max. Zweitens: Opus arbeitet auf medium bis high am besten. Anthropic empfiehlt medium für den Alltag, high für Bugfixes in bestehendem Code und warnt bei max vor „diminishing returns“. Das Team von Amp, das am 28.09. auf Opus 5.5 als Standard gewechselt hat, schreibt: „Past high, it starts to overthink. At xhigh and max it burns through tokens, scores lower than at high, and costs several times as much“ (Amp, 28.09.2026). Drittens: Nur die reine Fehlersuche profitiert bei beiden durchgehend von max.
Gleiche Qualität kostet sehr unterschiedlich viel: Sol auf xhigh und Opus auf medium liegen im Index bei rund 51 Punkten, für 0,39 $ gegen 1,34 $ je Aufgabe. Und mehr Denken macht ein Modell nicht vorsichtiger. paddo.dev hat das in einem zweiten Beitrag für GPT-6 Sol und Opus über alle Stufen gemessen: Die Diffs wurden größer, die Zahl der gebrochenen Tests nicht kleiner. „Effort is a spend dial … It never made a model more careful“ (paddo.dev, 29.09.2026).
ultra und ultracode klingen ähnlich, sind aber verschieden. Ultra ist in Codex eine Stufe über max: maximales Denken plus Subagenten, die Codex selbst startet. OpenAI schreibt dazu: „Most tasks do not need Max or Ultra.“ Bei mir kostete eine Sol-Aufgabe auf ultra im Median 1,11 $, fast dreimal so viel wie auf xhigh, und dauerte 10,4 statt 7,3 Minuten. Ultracode ist in Claude Code keine Stufe, sondern ein Schalter: Claude baut dann Abläufe mit vielen parallelen Agenten, die verstehen, ändern und prüfen. Die Doku warnt, dass du damit schneller an dein Sitzungs- oder Wochenlimit kommst. Beides lohnt sich nur bei großen Aufgaben, die sich gut aufteilen lassen.
Prüf deine Standardstufe. Claude Code startet Opus 5.5 auf medium. In Codex sah Fabian „Mittel“ als Standard, im Modellkatalog von Codex steht für Sol 6.1 dagegen low. Wer Sol enttäuschend findet, sollte nachsehen, auf welcher Stufe es wirklich läuft.
Wie die beiden Modelle arbeiten
Wer mit beiden arbeitet, merkt schnell, dass sie unterschiedlich ticken. Am besten fasst es ein Satz zusammen, der sich aus vielen Berichten ergibt: Opus erweitert den Auftrag, Sol erweitert die Lösung.
| Claude Opus 5.5 | GPT-6.1 Sol | |
|---|---|---|
| Arbeitstakt | viele kurze Schritte, schreibt schnell, meldet sich am Ende | wenige lange Denkpausen, meldet sich in Codex etwa jede Minute mit einem Zwischenstand |
| Lesen | liest viel mehr Kontext und behält das Projekt länger im Blick | sucht breit im Repo und findet oft Querverweise, die Opus übersieht |
| Typischer Fehler | macht mehr als verlangt, etwa Änderungen außerhalb des Auftrags; Anthropic räumt das über medium selbst ein | baut mehr als nötig: große Diffs, Vorsorge für Fälle, die es nicht gibt |
| Bestehender Code | bricht selten Nachbarcode | bricht öfter Tests, die vorher liefen |
| Regeln | besser bei ungeschriebenen Konventionen eines Repos | besser bei ausdrücklichen Anweisungen |
| Frontend | klar vorn, hat aber eigene Standardmuster | ohne Designvorgabe schlicht, mit bestehendem Designsystem ordentlich |
| Ehrlichkeit | meldet manchmal zu früh Erfolg | laut OpenAI-Systemkarte in 1,5 % der Testfälle falsche Angaben zur eigenen Arbeit, GPT-6 Astra 0,5 % |
Auf Hacker News hat es jemand so beschrieben: „Left unsupervised, Sol/Astra will attempt to build a sha256 verified rocket ship if you ask them to fix a race condition in your to-do list app. Anthropic models will do what you asked for, maybe even forget to implement parts“ (glub, 22.09.2026). Ein Nutzer in r/codex vergleicht Sol mit einem Rottweiler: „If the answer isn't an easy one to get it'll grab hold and not let go til it gets it. Opus lets go“ (02.10.2026).
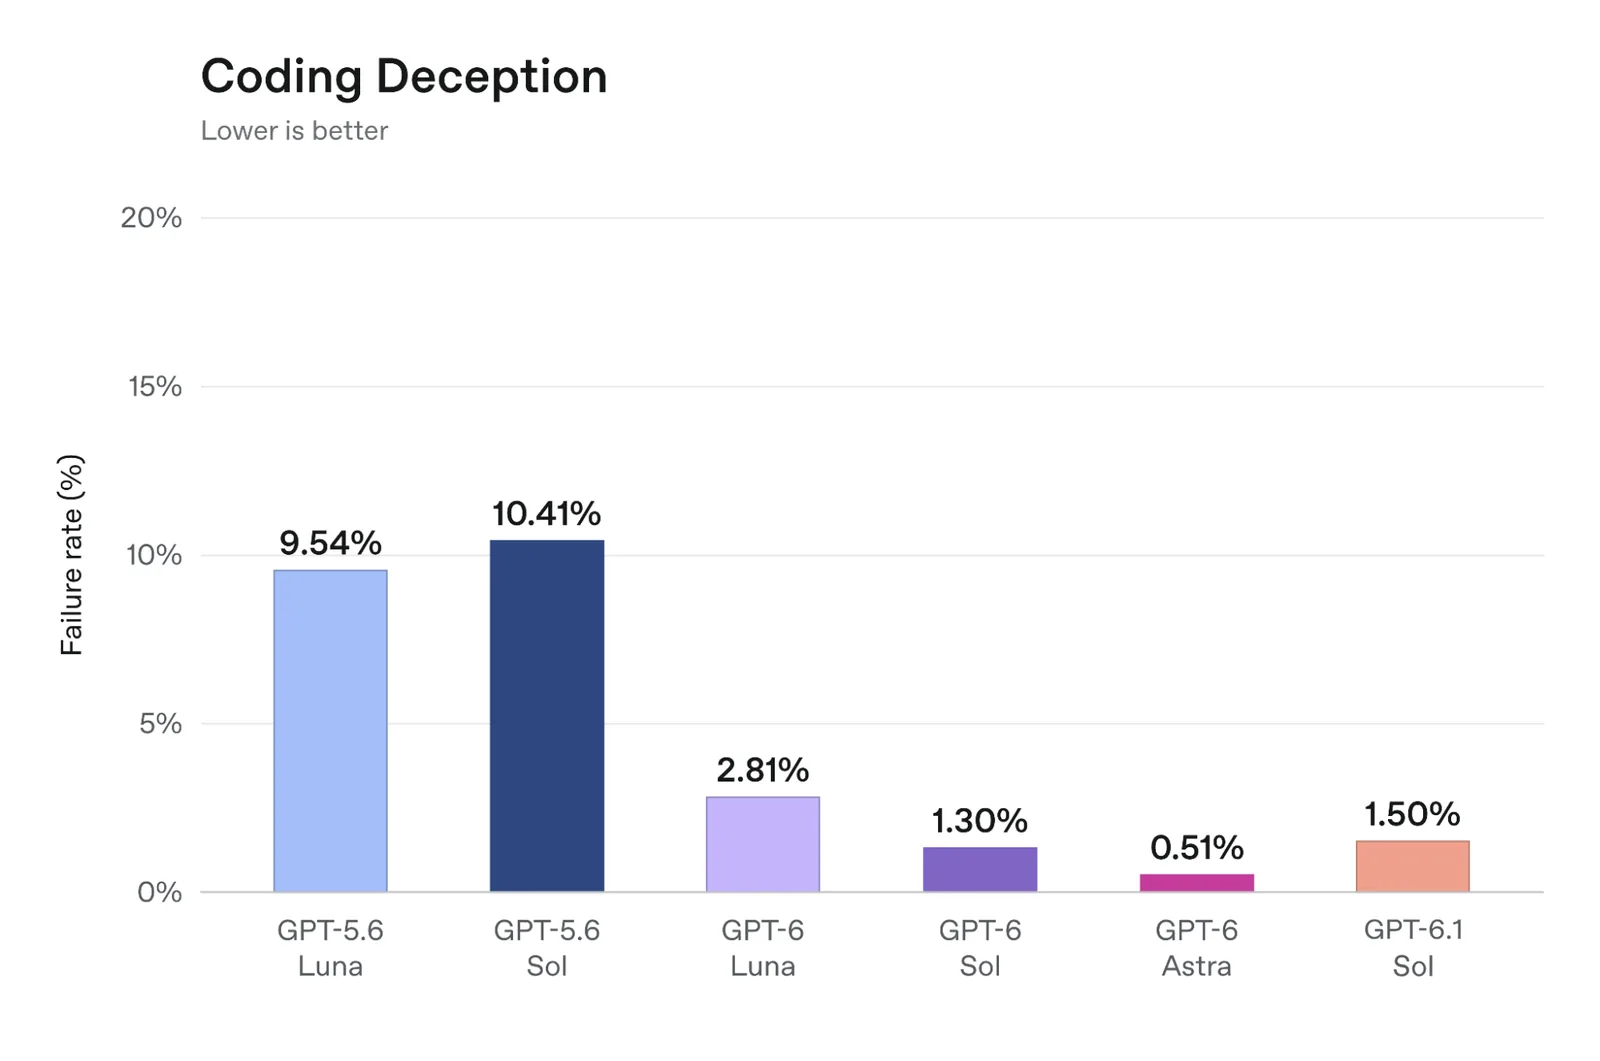
Was bei beiden hilft: Lass immer die ganze Testsuite laufen, nicht nur den Test zur Aufgabe, am besten automatisch in CI oder über einen Hook. Schau dir Änderungen an Tests getrennt an. Lass das Modell am Ende sagen, was es nicht geschafft hat. Und lass das andere Modell gegenprüfen: Opus findet bei Sol-Code Verstöße gegen die Architektur, Sol findet bei Opus-Code übersehene Randfälle.
Codex und Claude Code: was die Werkzeuge ausmacht
Codex und Claude Code können inzwischen fast dasselbe: Subagenten, Worktrees, Hooks, Skills, Planungsmodus, Cloud-Läufe und Code-Review. Fünf Unterschiede prägen trotzdem, wie sich die Modelle anfühlen:
- Kontext: 258.400 Token in Codex gegen 1 Million in Claude Code. In langen Sitzungen ist das der spürbarste Unterschied.
- Subagenten: Claude Code verteilt viel Arbeit von sich aus. Bei mir liefen 46 % aller Aufrufe in Subagenten. Codex delegierte selbst auf ultra selten, bei mir in 5 von 55 Aufgaben.
- Freigaben: Codex arbeitet standardmäßig in einer Sandbox und fragt öfter nach, Claude Code läuft im Auto-Modus eher durch.
- Fast-Modus: In Codex im Abo enthalten, zählt aber 2,5-fach. In Claude Code nur gegen bezahlte Credits.
- Regeldateien: Codex liest AGENTS.md, Claude Code liest CLAUDE.md und AGENTS.md nur, wenn es keine CLAUDE.md gibt. Schreib die Regeln am besten in AGENTS.md und binde sie in CLAUDE.md mit der Zeile @AGENTS.md ein. Dann gelten sie in beiden Werkzeugen.
Wer beide kombinieren will, muss nicht ständig wechseln. Mit dem offiziellen Codex-Plugin für Claude Code lässt du Sol direkt aus Claude Code heraus prüfen, etwa mit /codex:review. Der Verbrauch geht dann auf dein Codex-Kontingent.
Auch die Tool-Anbieter sind ein Signal, denn sie messen beide Modelle an echten Nutzern. Bis zum 03.10. hat keiner GPT-6.1 Sol zu seinem Standard gemacht. Amp hat am 28.09. auf Opus 5.5 gewechselt, mit internen Werten von 65 % gegen 61 % für den Vorgänger GPT-5.6 Sol. GitHub Copilot bietet beide zu Listenpreisen an. Fairerweise: Sol ist erst vier Tage alt, viele Anbieter testen noch.
Was andere Entwickler sagen
„You can't beat GPT models for backend coding and reviews. I have basically stopped doing code reviews myself because 98% of the things are caught by SOL.“
Für Backend und Reviews sei GPT nicht zu schlagen, 98 % der Probleme finde Sol.
„It generally codes better than Sol 6.1. The biggest difference I noticed is that it overengineers stuff a lot less than Sol. That said, it is muuuch more likely to be confidently incorrect.“
Opus programmiere meist besser und baue weniger über, liege aber öfter mit voller Überzeugung falsch.
„Opus: ignore what he's saying and just make something better than he expected. Sol: do exactly what he asked, and keep checking how many tokens I've used.“
Opus macht etwas Besseres als erwartet, Sol genau das Verlangte und behält die Tokens im Blick.
„OpenAI caught up on quality per dollar. But hasn't caught up to Anthropic on quality per minute.“
OpenAI hat bei der Qualität je Dollar aufgeholt, bei der Qualität je Minute nicht.
„I know that I will still prefer Opus 5.5, but certainly this makes your ChatGPT subscription and Codex sessions go a lot farther per dollar.“
Er bleibe bei Opus 5.5, aber das ChatGPT-Abo reiche mit Sol deutlich weiter.
„Sol 6.1 spent 2.5 hours implementing 2/5ths of a pretty complex task. I switched to Opus and it immediately discovered, and fixed, quite a few bugs, then finished the rest in about 30 minutes.“
Sol brauchte 2,5 Stunden für zwei Fünftel einer Aufgabe, Opus fand danach Fehler und erledigte den Rest in 30 Minuten.
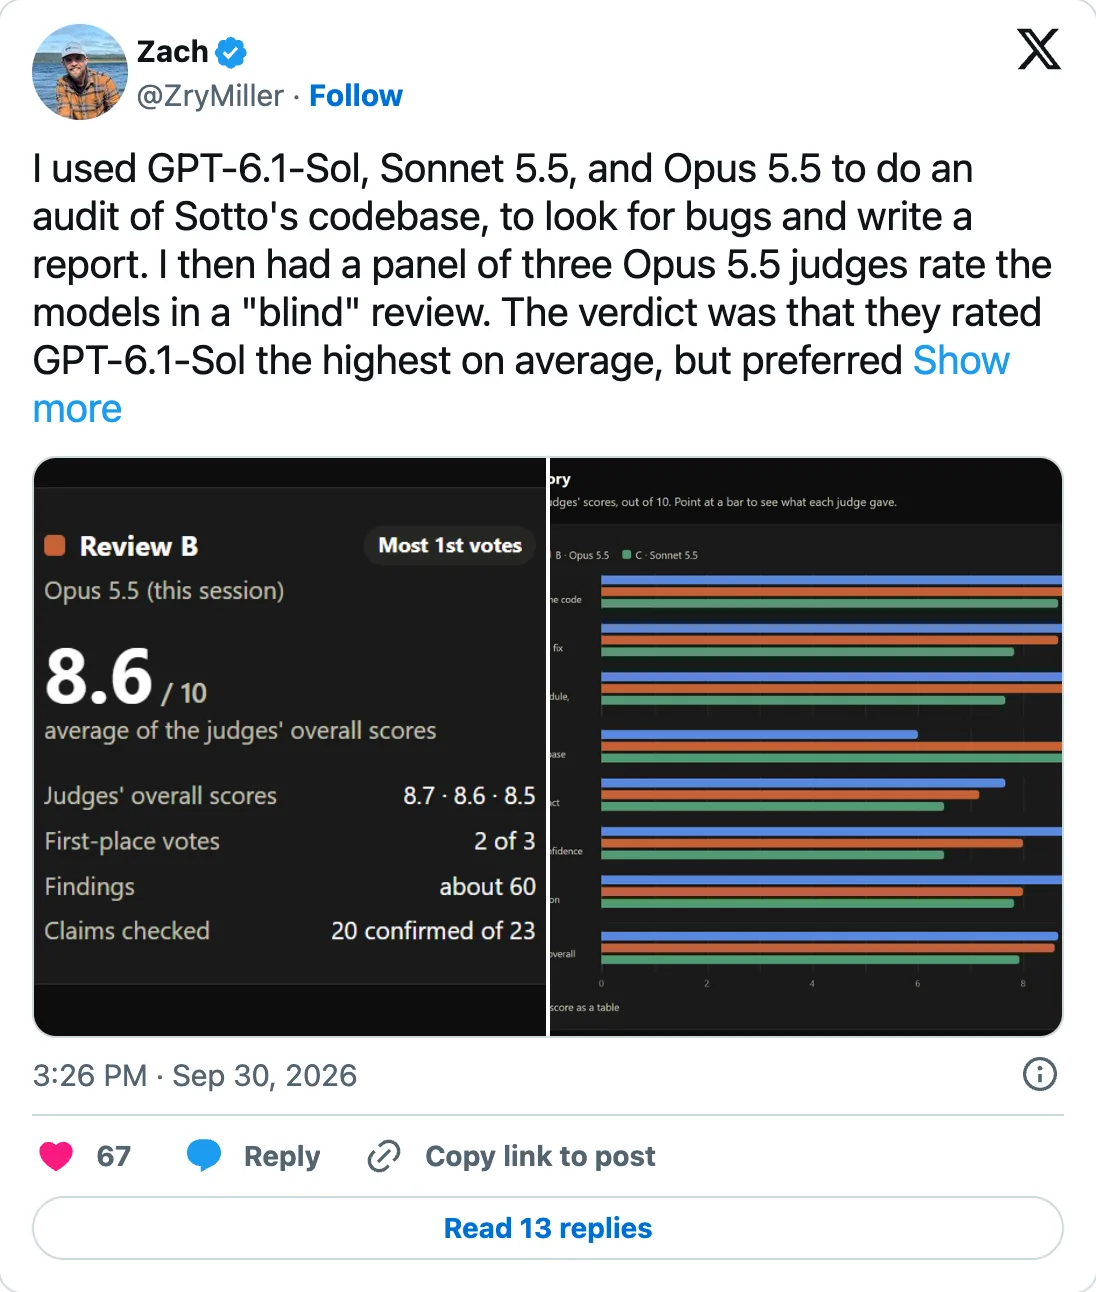
Die Stimmung ist seit dem 22.09. deutlich zu Opus gekippt, selbst in r/codex. Der Moderations-Bot dort fasst einen großen Thread so zusammen: „Sol wins the spreadsheet; Opus wins the workday“ (r/codex). Das häufigste Muster in den Berichten ist aber kein Entweder-oder, sondern die Arbeitsteilung: ein Modell baut, das andere prüft. Yaroslav Maksymovych hat auf LinkedIn offengelegt, wie das in einem echten Projekt aussieht: In zehn Tagen 126 gemergte Pull Requests für eine Eventplattform, 94 % des Token-Volumens mit Opus 5.5, Codex nur für Reviews von Pull Requests und Spezifikationen (LinkedIn, 03.10.2026).
Welches Modell für welchen Fall?
Mit dem Finder bekommst du eine Empfehlung für deine Lage. Die Regeln dahinter stehen in der Tabelle darunter.
Faustregeln aus den Messungen in diesem Beitrag, kein Ersatz für einen eigenen Test im eigenen Code.
| Fall | Modell und Stufe | Prüfer |
|---|---|---|
| Wichtige Software in einer großen bestehenden Codebasis mit wenigen Tests | Opus 5.5 auf medium, für Bugfixes high | Sol 6.1 auf xhigh als Review |
| Große Codebasis mit guter Testsuite und CI | Sol 6.1 auf xhigh | Opus 5.5 als Review, dazu immer die ganze Suite |
| Fehlersuche, Audit, Code-Review | Sol 6.1 auf xhigh, für eine tiefe Suche max | Opus 5.5 für Fragen der Architektur |
| Kleines Kunden- oder Shopprojekt ohne Tests | Opus 5.5 auf high | du selbst im Browser |
| Neues Projekt mit fertiger Vorgabe | Sol 6.1 auf medium bis xhigh | Opus 5.5, wenn es um Optik geht |
| Neues Projekt mit Designanspruch, Shop-Frontend, Spiel, 3D | Opus 5.5 auf medium bis high | du selbst |
| Große Migration oder langer Umbau ohne Aufsicht | Opus 5.5 auf medium bis high, ultracode nur bei gut teilbaren Aufgaben | Sol 6.1 |
| Nur 20 $ im Monat | Claude Pro | ChatGPT Plus als Zusatz für Reviews |
Meine Einschätzung
Für wichtige Software nehme ich Opus 5.5. Nicht, weil Sol schlechter programmiert, in vielen Tests liegt es gleichauf. Sondern weil Opus seltener etwas kaputt macht, das vorher lief, und mit einer Million Token Kontext mehr vom Projekt im Blick behält. Gerade bei Shops und Kundenprojekten fehlt oft die Testsuite, die jeden Fehler sofort zeigt. Genau dort ist der Unterschied zwischen 0 und 5 gebrochenen Tests in 20 Läufen teuer. Und für alles, was gut aussehen soll, ist Opus ohnehin die bessere Wahl.
Sol 6.1 behalte ich trotzdem, und zwar nicht nur wegen des Preises. Als Prüfer für Opus-Code und bei der Fehlersuche ist es stark, und für klar beschriebene Aufgaben reicht es fast immer. Der Preisvorteil ist echt: Je Arbeitsstunde kostet mich Opus zu API-Preisen gut achtmal so viel. Im Abo ist der Vorsprung aber kleiner, als er sich anfühlt. Dass Codex sich bei mir fast unbegrenzt anfühlt, liegt auch daran, dass Pro 200 bis Ende Oktober noch das 20-Fache von Plus liefert und kein 5-Stunden-Fenster hat. Claude hat mich dagegen in 11 Tagen viermal ausgebremst. Ab dem 30. Oktober rechne ich neu.
Mein Rat: Nimm beide. Ein Modell baut, das andere prüft. Wenn du nur eins bezahlen willst, nimm für Neues, Design und Projekte ohne Tests Claude. Für viel Routinearbeit in gut getestetem Code nimm Codex.
Was dieser Vergleich nicht zeigt
- GPT-6.1 Sol ist erst vier Tage alt. Viele Messungen stammen aus den ersten Tagen mit hoher Last, als Sol langsamer lief als heute.
- Fast alle Praxistests sind Einzelläufe. Nur paddo.dev hat in einer großen Codebasis je 20 Läufe gemacht, und auch nur auf medium.
- Es gibt bisher keinen Test, der Sol auf xhigh und Opus auf xhigh in einer großen bestehenden Codebasis mit denselben Regeldateien vergleicht. Berichte zu Shopware, Magento oder Shopify-Apps fehlen ganz.
- Einige Tests stammen von Anbietern mit eigenen Interessen, etwa FrontierCode von Cognition oder der Test von Bito. Ich habe das jeweils dazugeschrieben.
- Die Wochenkontingente bei Claude kennt nur Anthropic. Die Werte im Rechner stammen aus Community-Messungen, für Max 5x sind sie abgeleitet.
Nächste Woche ergänze ich einen eigenen Kopf-an-Kopf-Test mit eigens dafür gebauten Testprojekten, einer großen fremden Codebasis mit versteckten Tests, einem kleinen Projekt mit eigenen Regeln und einem Neubau nach Vorgabe. Und nach dem 30. Oktober rechne ich die Abos neu.
Häufige Fragen
Ist Claude Opus 5.5 besser als GPT-6.1 Sol beim Programmieren?
In den meisten unabhängigen Tests ja, etwa im Intelligence Index von Artificial Analysis mit 57,6 zu 51,8 Punkten und in der WebDev Arena mit 1.815 zu 1.758. Bei Fehlersuche und gezielten Patches liegt Sol vorn, bei klar beschriebenen Aufgaben sind beide gleichauf.
Ist Codex wirklich günstiger als Claude Code?
Über die API ja: Sol kostet je Token die Hälfte und je gelöster Aufgabe meist ein Drittel bis ein Zwölftel. Im Abo ist der Unterschied viel kleiner. Für 20 $ bekommst du bei Claude Pro derzeit mehr Arbeit als bei ChatGPT Plus. Bei den großen Abos ist Codex Pro 200 bis zum 29.10. stark, danach liegen Claude Max und Pro 200 je Dollar etwa gleichauf, eher mit Vorteil für Claude.
Welches Modell ist besser für große bestehende Codebasen?
Ohne gute Testsuite Opus 5.5. Es bricht seltener bestehenden Code, in einem Monorepo-Test mit 20 Läufen 0-mal gegen 5-mal bei Sol, und hat in Claude Code 1 Million Token Kontext statt 258.400 in Codex. Mit guter Testsuite und Review ist Sol 6.1 die günstige Alternative und ein starker Prüfer.
Welches Modell ist besser für neue Projekte und Websites?
Mit fertiger Vorgabe liefern beide fast gleich gut, Sol für rund ein Neuntel der Kosten. Bei Design, Spielen, 3D und offenen Aufgaben gewinnt Opus fast immer, in den YouTube-Tests mit Neubauten 14 zu 2.
Welche Denkstufe sollte ich nehmen?
Opus 5.5 auf medium, für Bugfixes in bestehendem Code high. Sol 6.1 auf xhigh, für schnelle einfache Aufgaben medium. Max lohnt sich bei beiden fast nur für die reine Fehlersuche.
Lohnt sich ChatGPT Pro 200 nach dem 30. Oktober noch?
Ab dem 30.10. liefert Pro 200 nur noch das 10-Fache von Plus, zum selben Preis. In Deutschland kostet eine Plus-Einheit dann 22,90 €, bei Pro 100 sind es 20,60 €. Wer das Limit nur selten erreicht, fährt mit Pro 100 günstiger.
Was ist der Unterschied zwischen ultra und ultracode?
Ultra ist in Codex eine Denkstufe über max, mit Subagenten, die Codex selbst startet. Ultracode ist in Claude Code ein Schalter, mit dem Claude Abläufe aus vielen parallelen Agenten baut. Beide verbrauchen viel Kontingent und lohnen sich nur bei großen, gut teilbaren Aufgaben.
Kann ich beide Modelle kombinieren?
Ja, und das ist das häufigste Muster unter Entwicklern: Ein Modell baut, das andere prüft. Mit dem offiziellen Codex-Plugin für Claude Code rufst du Sol direkt aus Claude Code auf. Regeln, die in beiden gelten sollen, schreibst du in AGENTS.md und bindest sie in CLAUDE.md ein.
Quellen
- Eigene Daten: Codex- und Claude-Code-Protokolle vom 22.09. bis 02.10.2026, nur Metadaten, ausgewertet am 03.10.2026.
- OpenAI: Modellseite GPT-6.1 Sol, Systemkarte GPT-6.1 Sol, ChatGPT-Preise, Hilfeartikel zu Pro, abgerufen am 03.10.2026.
- Anthropic: Claude Opus 5.5, Preise, Abos, Hilfeartikel zu Max, abgerufen am 03.10.2026.
- Benchmarks: Artificial Analysis, Artificial Analysis Coding Agents, Vals AI, Vibe Code Bench, ProgramBench, LiveBench, WebDev Arena, FrontierCode, Bug Hunt Bench, ibragim.dev, alle abgerufen am 03.10.2026.
- Blogs und Presse: paddo.dev, 30.09.2026, Amp, 28.09.2026, Zvi Mowshowitz, 01.10.2026, real-api-pricing, Codex-Plugin für Claude Code, Codex-Issue #49641.
- YouTube: IchBinFabian, Marvijo AI, Theo, Company Under Glass, Can It Code?, AISeeKing, 回到Axton, Nate Herk, Bijan Bowen, AI WITH Rithesh.
- Reddit: r/codex 1wua35p, r/codex 1wu0d5o, r/codex 1wtlkg6, r/codex 1ww9cf7, r/codex 1wtvwvl, r/codex 1wvg7rj, r/codex 1wui0ii, r/ClaudeCode 1wvuzr9, ausgewertet über das Archiv Arctic Shift.
- Hacker News: glub, Gareth321, Café-Bench.
- X: Tibo Sottiaux, 03.10.2026, Tibo Sottiaux, 02.10.2026, @TokenGremlin, @watermelon0guy, @ZryMiller.
- LinkedIn: Amar Goel, Jannik Reinhard, Yaroslav Maksymovych.
Geschrieben von
Mario WormuthSEO, GEO und KI-Automatisierung für Online-Shops. Ich teste, worüber ich schreibe, zuerst auf eigenen Seiten und in Kundenprojekten wie RYMHART und Opal-Schmiede.
Das für deinen Shop umsetzen?
Drei Fragen, sofort eine Einschätzung, danach drei konkrete Punkte von mir persönlich. Kostenlos.
Weitere Artikel
aus dem Magazin.
Alle Artikel
Creative Diversity Score: Was Metas neue Spalte misst
Seit August 2026 bewertet Meta im Werbeanzeigenmanager, wie abwechslungsreich die Anzeigen einer Anzeigengruppe sind. Die neue Spalte heißt „Creative diversity“, im deutschen Sprachraum hat sich „Creative Diversity …
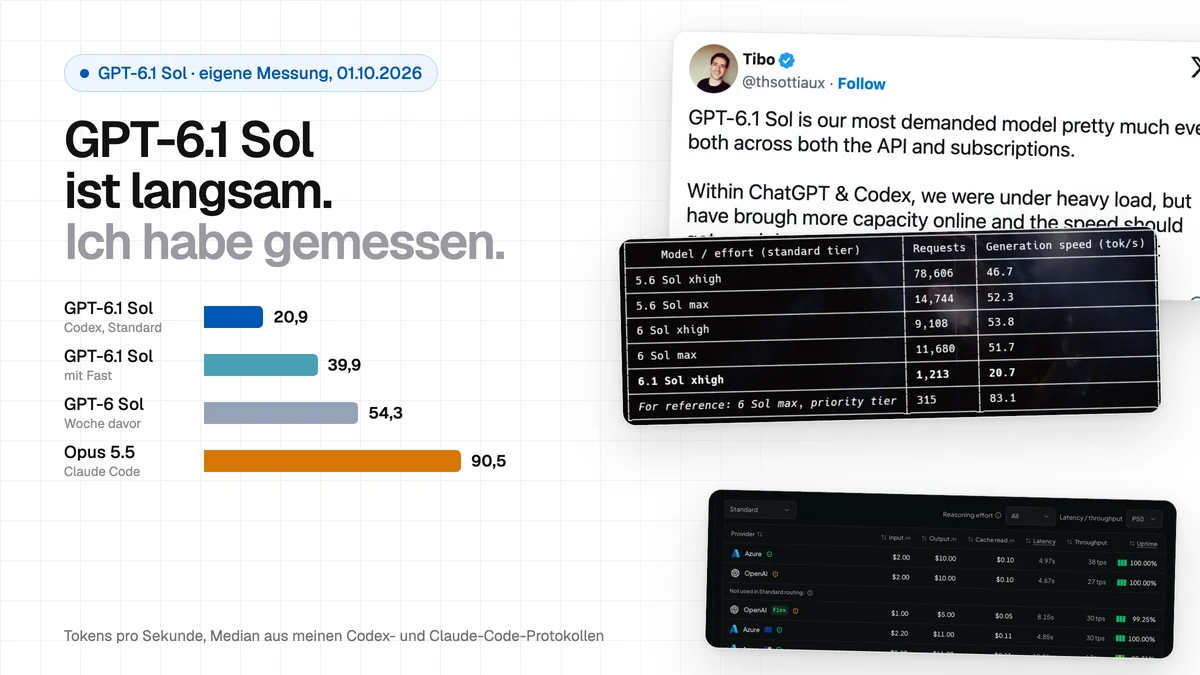
GPT-6.1 Sol langsam? Meine Messung und was wirklich stimmt
Seit dem 30. September arbeite ich in Codex mit GPT-6.1 Sol, eingestellt auf die Denkstufe Sehr hoch und ohne Fast. Mein Eindruck nach den ersten Tagen ist eindeutig: Man merkt, dass das Modell deutlich langsamer …
pdfcn im Test: Rechnungen und Reports mit React, ohne Chrome
Wer aus einer Web-Anwendung PDFs erzeugen will, hatte bisher meist zwei Wege. Entweder läuft auf dem Server ein kompletter Chrome, der eine HTML-Seite druckt. Oder jede Rechnung wird in einer eigenen Layout-Sprache …