Start / Magazin / KI, Automatisierung & Reporting
Opus 5.5 oder GPT-6.1 Sol: Wer schreibt bessere Texte?
ArtikelKI, Automatisierung & Reporting04.10.2026/img/magazin/opus-5-5-vs-gpt-6-1-sol-texte-schreiben-vergleich.webp Mario WormuthSEO, GEO & KI-Automatisierung
11 Min. Lesezeit
Alles auf einen Blick
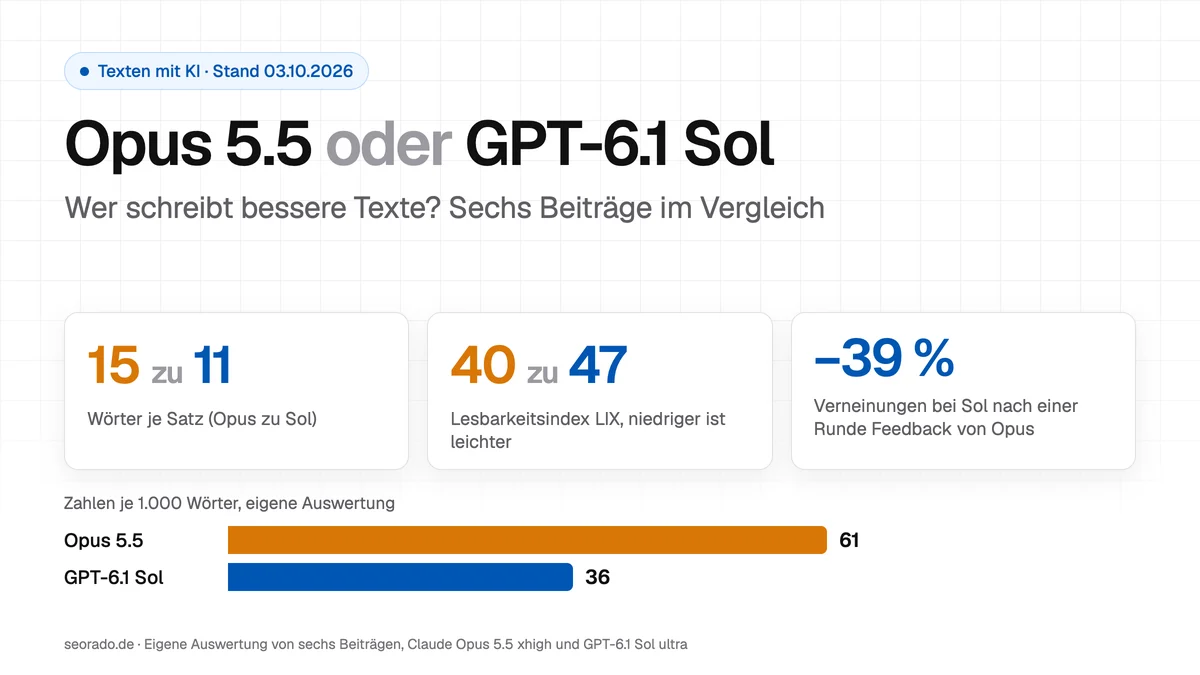
- GPT-6.1 Sol schreibt kürzere Sätze, im Schnitt 11 Wörter gegen 15 bei Opus 5.5. Lesbarer sind die Sol-Texte trotzdem nicht: Im Lesbarkeitsindex LIX liegen sie bei 47, die Opus-Texte bei 40, wegen vieler langer zusammengesetzter Wörter.
- Sol spricht den Leser rund viermal so oft mit du an und arbeitet Quellen sehr gründlich ab, mit Klickwegen und Webarchiv-Vergleichen. Opus erzählt mehr, bringt mehr eigene Zahlen und zieht klarere Schlüsse.
- Die größte Schwäche von Sol ist die Absicherung. Die erste Fassung des Ziel-ROAS-Beitrags las sich wie ein Gutachten. Nach einer Runde Feedback von Opus sanken die Verneinungen und Absicherungen um 39 %.
- Opus macht dafür eher Zahlenfehler im Detail. Zwei davon habe ich heute selbst erwischt, bevor sie online gingen.
- Am besten funktioniert die Arbeitsteilung: Sol prüft Fakten und Quellen, Opus schreibt und redigiert. Oder Sol schreibt, und Opus liest gegen.
- Meine Meinung: Mit Claude zu texten ist deutlich angenehmer. Die Daten stimmen, und er sichert sich nicht ständig unnötig ab.
Inhaltsverzeichnis14 Abschnitte
- So habe ich verglichen
- Die Zahlen: zwei Schreibstile
- Was Sol beim Schreiben gut macht
- Wo Sol schwächelt
- Was Opus beim Schreiben gut macht
- Wo Opus schwächelt
- Die Feedbackschleife: Opus liest Sol gegen
- Zeit und Aufwand
- Wer wofür?
- Prüfliste für KI-Texte
- Meine Einschätzung
- Was dieser Vergleich nicht zeigt
- Häufige Fragen
- Quellen
Zwischen dem 1. und 3. Oktober sind auf seorado.de mehrere Beiträge entstanden, mit zwei verschiedenen KI-Werkzeugen. Claude Code mit Claude Opus 5.5 auf der Stufe xhigh hat unter anderem den Vergleich von GPT-6.1 Sol und Opus 5.5 beim Programmieren und den Beitrag zu den verschwundenen Produktkarussells geschrieben. Codex mit GPT-6.1 Sol auf der höchsten Stufe ultra hat den Beitrag zum Ziel-ROAS-Update bei Google Ads geschrieben, dazu einen Beitrag zu llms.txt bei Shopify und einen zu KI-Texten, die noch Entwürfe sind. Gleiche Website, gleiche Stilregeln, fast derselbe Zeitraum. Und jeden Codex-Entwurf habe ich vor der Veröffentlichung von Claude gegenlesen lassen.
So einen direkten Vergleich unter gleichen Bedingungen bekommt man selten. Ich habe deshalb die Texte per Skript ausgewertet, die Gegenlesungen und die Überarbeitungen nebeneinandergelegt und die Codex-Protokolle ausgelesen. Ein wichtiger Hinweis vorab: Bei der Auswertung und beim Schreiben dieses Beitrags hat mir Claude geholfen, also eines der beiden Modelle, um die es geht. Deshalb stütze ich mich vor allem auf Messwerte, die ein Skript gezählt hat, und auf mein eigenes Urteil. Stand ist der 3. Oktober 2026.
So habe ich verglichen
| Claude Code | Codex | |
|---|---|---|
| Modell und Stufe | Claude Opus 5.5, xhigh | GPT-6.1 Sol, ultra (höchste Stufe, mit Subagenten) |
| Abo | Claude Max 5x | ChatGPT Pro 200 |
| Ausgewertete Beiträge | 4, alle veröffentlicht | 2, jeweils erste und überarbeitete Fassung, dazu die Gegenlesung eines dritten Entwurfs |
| Regeln | dieselben Stilregeln der Website: Du-Form, keine Gedankenstriche, keine Floskeln, Quellen mit Datum, eigene Meinung | |
| Gegenlesen | durch mich | durch Claude, dann durch mich |
Gezählt habe ich an den veröffentlichten Fassungen, ohne Tabellen, Fragen und Quellenlisten: Wörter, Sätze, Anteil langer Sätze, Verneinungen wie kein, nicht und ohne, die direkte Ansprache mit du, die eigene Stimme mit ich und mein, Zahlen und Links. Dazu kommt der Lesbarkeitsindex LIX. Er zählt die Wörter je Satz und den Anteil der Wörter mit mehr als sechs Buchstaben. Unter 40 gilt ein Text als leicht, über 50 als schwer. Die Themen sind verschieden, die Zahlen sind deshalb Hinweise auf einen Stil, keine Laborwerte.
Die Zahlen: zwei Schreibstile
| Beitrag | Wörter je Satz | Anteil Sätze über 20 Wörter in % | Lesbarkeitsindex LIX | Verneinungen je 1.000 Wörter | Ansprache mit du je 1.000 Wörter | eigene Stimme je 1.000 Wörter | Zahlen je 1.000 Wörter | Links zu Quellen je 1.000 Wörter |
|---|---|---|---|---|---|---|---|---|
| Sol vs. Opus beim Programmieren (Opus 5.5) | 14,4 | 15 | 35 | 7,7 | 4,8 | 8,0 | 74,3 | 21,8 |
| Google streicht Produktkarussells (Opus 5.5) | 13,3 | 14 | 42 | 19,3 | 8,8 | 7,7 | 33,6 | 11,6 |
| GPT-6.1 Sol langsam? (Opus 5.5) | 17,9 | 28 | 39 | 9,3 | 3,7 | 14,1 | 79,0 | 4,5 |
| Google Ads vs. Meta Ads vs. ChatGPT Ads (Opus 5.5) | 15,4 | 25 | 42 | 13,2 | 4,8 | 3,6 | 57,2 | 20,5 |
| Ziel-ROAS-Update bei Google Ads (Sol 6.1) | 10,8 | 3 | 46 | 12,8 | 14,5 | 3,3 | 46,8 | 24,8 |
| Shopify liefert llms.txt (Sol 6.1) | 10,8 | 3 | 48 | 18,2 | 32,1 | 9,7 | 24,2 | 22,4 |
Quelle: Eigene Auswertung der Beiträge auf seorado.de vom 01. bis 03.10.2026, Stand 03.10.2026. Wörter und Sätze per Regel gezählt, LIX nach Björnsson.
Das Bild ist eindeutiger, als ich erwartet hatte. Sol schreibt fast nur kurze Sätze: Nur 3 % sind länger als 20 Wörter, bei Opus sind es 21 %. Trotzdem liegt Sol beim LIX schlechter, weil es Fachwörter aneinanderreiht: „veröffentlichungsnahe Produktansicht“, „Effizienzanforderung“, „Betroffenheits-Check“. Opus wechselt kurze und lange Sätze und nutzt öfter einfache Wörter. Opus bringt fast doppelt so viele Zahlen je 1.000 Wörter, weil es eigene Messungen in den Text einbaut. Sol spricht den Leser dagegen viel häufiger direkt an und schreibt mehr Handlungsanweisungen.
Was Sol beim Schreiben gut macht
- Quellenarbeit: Für den KI-Texte-Beitrag hat Codex die Google-Seiten vom 27.09. und 02.10. im Webarchiv verglichen und den neuen Satz wörtlich zitiert. Im Ziel-ROAS-Beitrag hat es über das Webarchiv geprüft, ob Google die Hilfe heimlich geändert hat.
- Klickwege: Sol beschreibt genau, wo man in Google Ads klickt, und hat die Wege im Konto geprüft.
- Saubere Trennung der Belege: Was Google bestätigt, was Praktiker beobachten und was nur ein Modell ist, steht klar getrennt.
- Regeltreue: Keine Gedankenstriche, keine Floskeln, Du-Form, Quellen mit Datum. Die formalen Regeln hält Sol sehr zuverlässig ein.
- Fairness: Den App-Vergleich im Shopify-Beitrag hat Sol ohne Verriss geschrieben, mit Preisen und klar gekennzeichneten Anbieterangaben.
Wo Sol schwächelt
- Absicherung: Die erste Fassung des Ziel-ROAS-Beitrags enthielt 22,9 Verneinungen je 1.000 Wörter, gefühlt sagte jeder dritte Satz, was nicht belegt ist. Ein Beispiel: „‚Nicht gefunden‘ bedeutet keine vollständige Abwesenheit unveröffentlichter Daten.“ Im KI-Texte-Entwurf heißt es in einer Bildunterschrift sogar: „Keine vorgeschriebene Google-Prozessgrafik“.
- Hypothetische Stimme: Statt „ich habe gemessen“ schreibt Sol gern „ich würde“, in der ersten Fassung des KI-Texte-Entwurfs neunmal. Das klingt nach Beratung aus der Ferne, nicht nach Erfahrung.
- Wir statt ich: In der ersten Fassung des Shopify-Beitrags stand „wir haben fünf Angebote gelesen“, obwohl die Website in der Ich-Form schreibt.
- Offenlegung, die den Autor kleinmacht: „KI (Codex) hat recherchiert und ausgewertet. Ich habe das Thema ausgewählt und die Prüfung beauftragt.“ Das ist ehrlich gemeint, macht aus dem Autor aber einen Auftraggeber.
- Kein eigener Befund: Die Kernaussage des KI-Texte-Entwurfs lautet sinngemäß „KI für den Entwurf, Freigabe erst nach Prüfung“. Das stimmt, ist aber banal und steht viermal im Text. Ein eigener Test fehlt.
- Bausteine als Dekoration: Ein Check, der fragt „Hast du X geprüft?“ und antwortet „Prüfe X“, hilft niemandem. Die Rechner in der ersten Fassung starteten leer.
Was Opus beim Schreiben gut macht
- Einstiege mit Szene und Zahl: Opus beginnt mit einer konkreten Beobachtung, etwa „Seit Mitte September sind sie in Deutschland verschwunden“, statt mit einer Ermahnung.
- Eigene Befunde: Protokolle aus 11 Tagen, Werte aus dem Merchant Center, 40 eigene Suchanfragen. Opus baut eigene Messungen ins Zentrum und leitet daraus die Aussage ab.
- Klare Schlüsse: „Für wichtige Software nehme ich Opus 5.5“ oder „Erst messen, dann umschichten“. Opus legt sich fest und begründet es.
- Vorbehalte an einer Stelle: Die Grenzen der Daten stehen gebündelt in einem Kasten statt in jedem zweiten Satz.
- Stimmen mit Links: Reddit, LinkedIn, X und YouTube werden zitiert und verlinkt, nicht nur erwähnt.
Wo Opus schwächelt
- Zahlenfehler im Detail: Heute hat Opus zwei Fehler gemacht, die ich erwischt habe, bevor sie online gingen. Beim Video von Can It Code? standen zuerst falsche Cache-Werte im Text (570 statt 500 Millionen Token für Opus). Bei den RYMHART-Klicks waren zwei Indexwerte vor dem 17.09. falsch übertragen. Beide Male stand die richtige Zahl in der Quelle, Opus hatte sie nur falsch abgeschrieben.
- Längere Sätze: Jeder fünfte Satz hat mehr als 20 Wörter. Das liest sich flüssig, kann aber ermüden.
- Verbrauch: Opus kostet mehr Kontingent. Bei einer großen Recherche mit vielen Agenten war mein 5-Stunden-Fenster bei Claude Max 5x in 85 Minuten zu 77 % aufgebraucht.
Die Feedbackschleife: Opus liest Sol gegen
Den spannendsten Teil zeigt keine Rangliste, sondern der Ablauf. Ich habe jeden Codex-Entwurf von Claude lesen lassen und das Feedback an Codex zurückgegeben. Codex hat jedes Mal sauber umgesetzt.
| Beitrag | Feedback von Opus | Ergebnis nach der Überarbeitung |
|---|---|---|
| Ziel-ROAS | weniger Absicherung, eine klare eigene Empfehlung, Rechner mit Beispielwerten, passende Kategorie | Verneinungen von 22,9 auf 14,0 je 1.000 Wörter, eigene Stimme von 1,3 auf 3,0, Empfehlung „Erst das Ziel korrigieren. Danach über mehr Budget entscheiden“, Rechner mit sofortigem Ergebnis, neue Kategorie Ads und Tracking |
| Shopify llms.txt | Offenlegung umformulieren, ich statt wir, Fazit mit Haltung, eine Erwähnung streichen | alle vier Punkte umgesetzt, neuer Einstieg mit einem Satz aus der Praxis, Fazit „Ein Abo nur für llms.txt würde ich keinem Shop empfehlen“ |
| KI-Texte | Bewertung 6 von 10 gegenüber 8,5 bis 9 für die Opus-Beiträge: eigener Test fehlt, zu viel Absicherung, Bausteine ohne Nutzen, fehlende Klickwege | Codex hat das Feedback bekommen, jetzt überarbeitet Claude den Entwurf |
Aus dem Feedback hat Codex selbst einen Redaktionsstil für die Website abgeleitet, eine Datei mit Regeln für künftige Texte. Ob die nächste Fassung dadurch von Anfang an besser wird, prüfe ich beim nächsten Beitrag.
Feedback, das bei Sol wirkt: Nenne die Stelle und den Grund, nicht nur das Gefühl. „Gefühlt jeder dritte Satz sagt, was nicht belegt ist, bündle die Vorbehalte in einer Box“ wirkt. „Klingt zu vorsichtig“ wirkt kaum. Gib ein Beispiel für die gewünschte Formulierung. Und sag ausdrücklich, dass du die Expertise hast und eine klare Meinung willst. Sol setzt Anweisungen sehr wörtlich um, das ist hier ein Vorteil.
Zeit und Aufwand
Für den Ziel-ROAS-Beitrag brauchte Codex mit Sol 6.1 auf ultra 8 Aufträge und 162 Minuten reine Agentenzeit, verteilt über den Vormittag, mit rund 304.000 Ausgabe-Token. Claude Code mit Opus 5.5 ist pro Aufgabe deutlich schneller, verbraucht aber spürbar mehr vom Kontingent. Je Arbeitsstunde kostet Opus in meinen Protokollen zu API-Preisen etwa achtmal so viel wie Sol. Die Einzelheiten stehen im Vergleich der beiden Modelle beim Programmieren.
Wer wofür?
| Aufgabe | Meine Wahl |
|---|---|
| Ratgeber mit Meinung, eigenen Daten und Erzählung | Opus 5.5 |
| Anleitungen mit Klickwegen, Doku-Vergleiche, Faktenprüfung | GPT-6.1 Sol |
| Gegenlesen eines fertigen Textes auf Ton, Aufbau und Haltung | Opus 5.5 |
| Gegenprüfen von Zahlen und Quellen in einem fertigen Text | GPT-6.1 Sol |
| Viele ähnliche Texte mit festen Regeln, etwa Produkttexte nach Vorlage | GPT-6.1 Sol, mit Stichproben |
Prüfliste für KI-Texte
Egal welches Modell schreibt: Diese acht Fragen stelle ich jedem Entwurf, bevor er online geht.
- Steht im Text ein eigener Befund, also eine Messung, ein Test oder eine Erfahrung, die es woanders nicht gibt?
- Stimmt jede Zahl mit der Quelle überein? Bei Opus prüfe ich das besonders.
- Stehen die Vorbehalte gebündelt an einer Stelle statt verteilt in jedem Absatz?
- Spricht der Autor in der Ich-Form über das, was er getan hat, statt im Konjunktiv?
- Gibt es eine klare Empfehlung, die sich aus den Belegen ergibt?
- Ist jede zitierte Person und jede Quelle verlinkt?
- Rechnen die Bausteine etwas, das der Leser selbst nicht im Kopf rechnet?
- Würde ich den Text unter meinem Namen auch ohne KI-Hinweis vertreten?
Meine Einschätzung
Ehrlich gesagt hatte ich erwartet, dass Codex besser ist. Ich arbeite mit beiden Systemen und finde Claude beim Texten deutlich angenehmer. Claude gibt die Daten korrekt wieder und sichert sich nicht andauernd unnötig ab. Bei GPT fällt mir immer wieder auf, wie vorsichtig es ist, obwohl ich genau vorgebe, was ich will, dass ich die Expertise habe und nur Hilfe brauche, sie in Worte zu fassen. Die Qualität der Texte ist bei Claude für mich deutlich höher: weitreichender durchdacht und besser recherchiert.
Die Messwerte stützen das an den entscheidenden Stellen: weniger Absicherung, mehr eigene Zahlen, klarere Schlüsse. Die zwei Zahlenfehler von heute zeigen aber auch, dass ich Opus nicht blind vertraue. Deshalb bleibt Sol bei mir im Einsatz, als gründlicher Prüfer für Quellen und Klickwege und für Aufgaben, bei denen Regeln wichtiger sind als Stil.
Was dieser Vergleich nicht zeigt
- Es sind sieben Beiträge zu verschiedenen Themen, kein Test mit demselben Auftrag für beide Modelle. Einen solchen Test mit identischem Briefing trage ich nach.
- Claude hat beim Auswerten geholfen und ist selbst Teil des Vergleichs. Die Messwerte stammen deshalb aus einem Skript, das Urteil in der Einschätzung ist meins.
- Die Kennzahlen messen Stil, nicht Wahrheit. Ob ein Text stimmt, zeigt nur der Abgleich mit den Quellen.
- Sol lief auf ultra, Opus auf xhigh. Mit anderen Stufen oder anderen Vorgaben kann das Bild anders aussehen.
Häufige Fragen
Schreibt Claude Opus 5.5 bessere Texte als GPT-6.1 Sol?
In meinem Vergleich lesen sich die Opus-Texte leichter (LIX 40 gegen 47), enthalten mehr eigene Zahlen und klarere Schlüsse. Sol schreibt kürzere Sätze, arbeitet Quellen sehr gründlich ab, sichert sich aber deutlich mehr ab.
Warum klingt GPT-6.1 Sol so vorsichtig?
Sol trennt Belege sehr streng und schreibt diese Trennung gern in jeden Satz. Mit klarem Feedback lässt sich das stark reduzieren, im Ziel-ROAS-Beitrag sanken die Verneinungen nach einer Runde um 39 %.
Welche Stufe sollte ich zum Texten nehmen?
Hier lief Sol auf ultra und Opus auf xhigh. Für Texte kommt es weniger auf die Stufe an als auf ein gutes Briefing und eine Gegenlesung. Wie sich die Stufen beim Programmieren auswirken, steht im Vergleich der beiden Modelle.
Kann ich beide Modelle kombinieren?
Ja. Bei mir schreibt meist Claude, und Sol prüft Zahlen und Quellen. Oder Codex schreibt, und Claude liest auf Ton, Aufbau und Haltung gegen. Beides bringt bessere Texte als ein Modell allein.
Quellen
- Eigene Auswertung der Beiträge auf seorado.de vom 01. bis 03.10.2026: GPT-6.1 Sol vs. Opus 5.5 beim Programmieren, Google streicht Produktkarussells, GPT-6.1 Sol langsam?, Google Ads vs. Meta Ads vs. ChatGPT Ads, Ziel-ROAS-Update bei Google Ads, dazu zwei Entwürfe von Codex.
- Eigene Daten: Codex-Protokoll vom 03.10.2026 (Aufträge, Agentenzeit, Token), Gegenlesungen durch Claude und erste Fassungen der Codex-Entwürfe, ausgewertet am 03.10.2026.
- Lesbarkeitsindex LIX nach Carl-Hugo Björnsson, 1968.
Geschrieben von
Mario WormuthSEO, GEO und KI-Automatisierung für Online-Shops. Ich teste, worüber ich schreibe, zuerst auf eigenen Seiten und in Kundenprojekten wie RYMHART und Opal-Schmiede.
Das für deinen Shop umsetzen?
Drei Fragen, sofort eine Einschätzung, danach drei konkrete Punkte von mir persönlich. Kostenlos.
Weitere Artikel
aus dem Magazin.
Alle Artikel
GPT-6.1 Sol vs. Opus 5.5: Wer programmiert besser?
Seit dem 22. September gibt es Claude Opus 5.5, seit dem 29. September GPT-6.1 Sol. Mit diesen beiden Modellen bauen gerade die meisten Entwickler: Opus in Claude Code, Sol in Codex. Und beide Lager sind sich …
Creative Diversity Score: Was Metas neue Spalte misst
Seit August 2026 bewertet Meta im Werbeanzeigenmanager, wie abwechslungsreich die Anzeigen einer Anzeigengruppe sind. Die neue Spalte heißt „Creative diversity“, im deutschen Sprachraum hat sich „Creative Diversity …
GPT-6.1 Sol langsam? Meine Messung und was wirklich stimmt
Seit dem 30. September arbeite ich in Codex mit GPT-6.1 Sol, eingestellt auf die Denkstufe Sehr hoch und ohne Fast. Mein Eindruck nach den ersten Tagen ist eindeutig: Man merkt, dass das Modell deutlich langsamer …