Start / Magazin / Relaunch & Technik
Wie funktioniert SEO? Was mein Server-Log über Crawler zeigt
ArtikelRelaunch & Technik06.10.2026/img/magazin/wie-funktioniert-seo-server-log-crawler-test-2026.webp Mario WormuthSEO, GEO & KI-Automatisierung
23 Min. Lesezeit
Das Wichtigste auf einen Blick
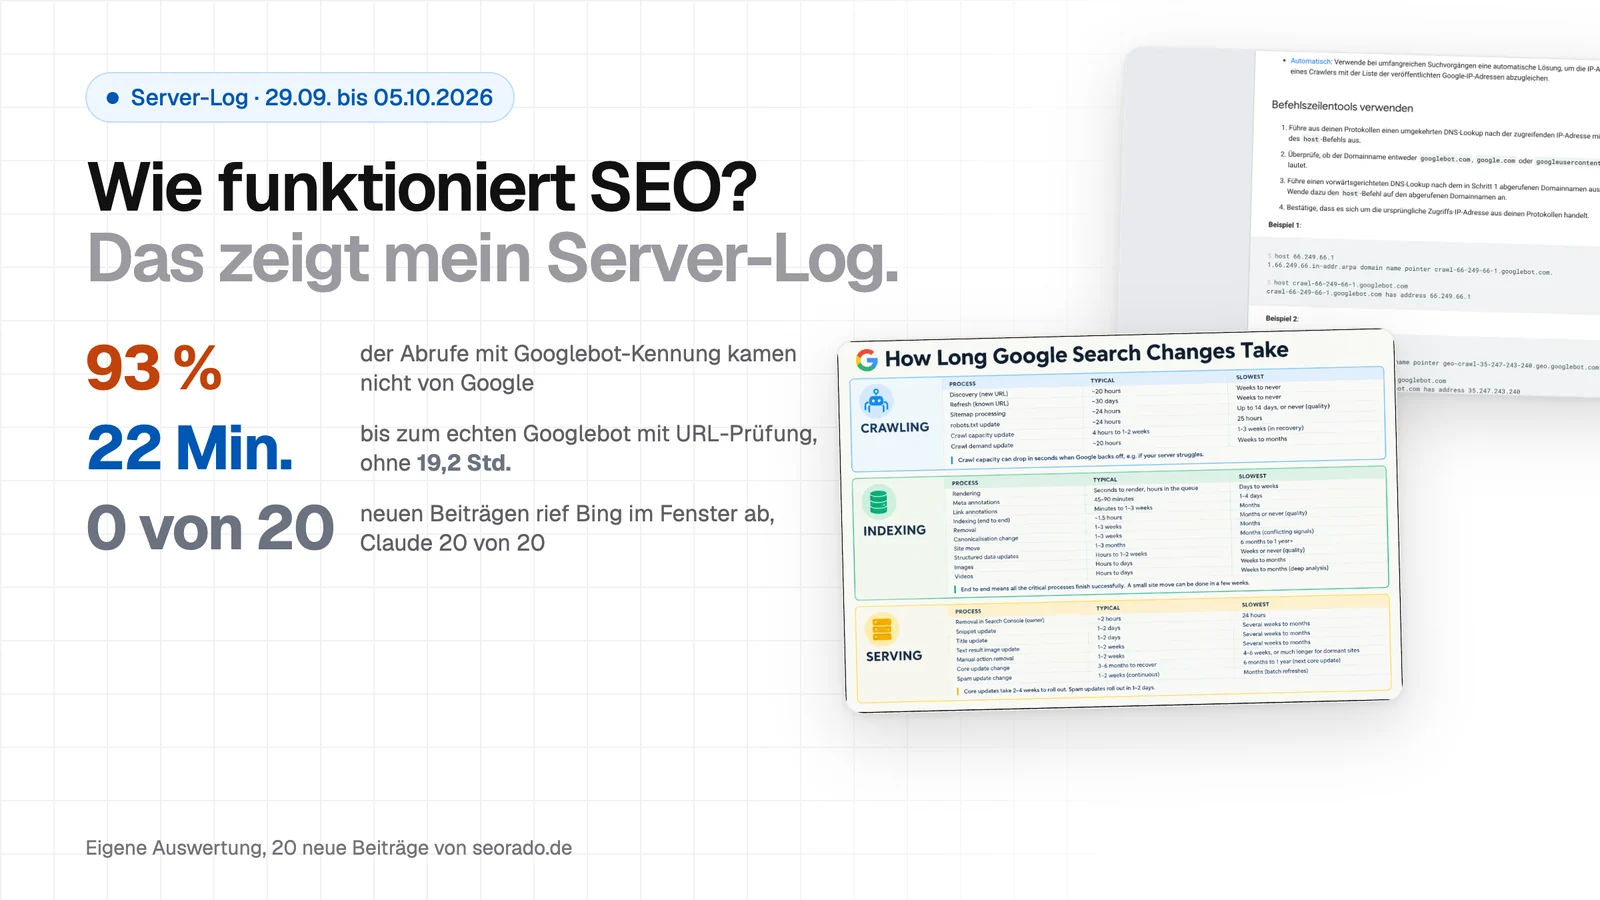
- SEO läuft in drei Schritten: Google ruft deine Seite ab (crawlen), speichert sie (indexieren) und zeigt sie bei einer Suche (ausspielen). Schritt eins ist schnell. Schritt drei ist der Engpass.
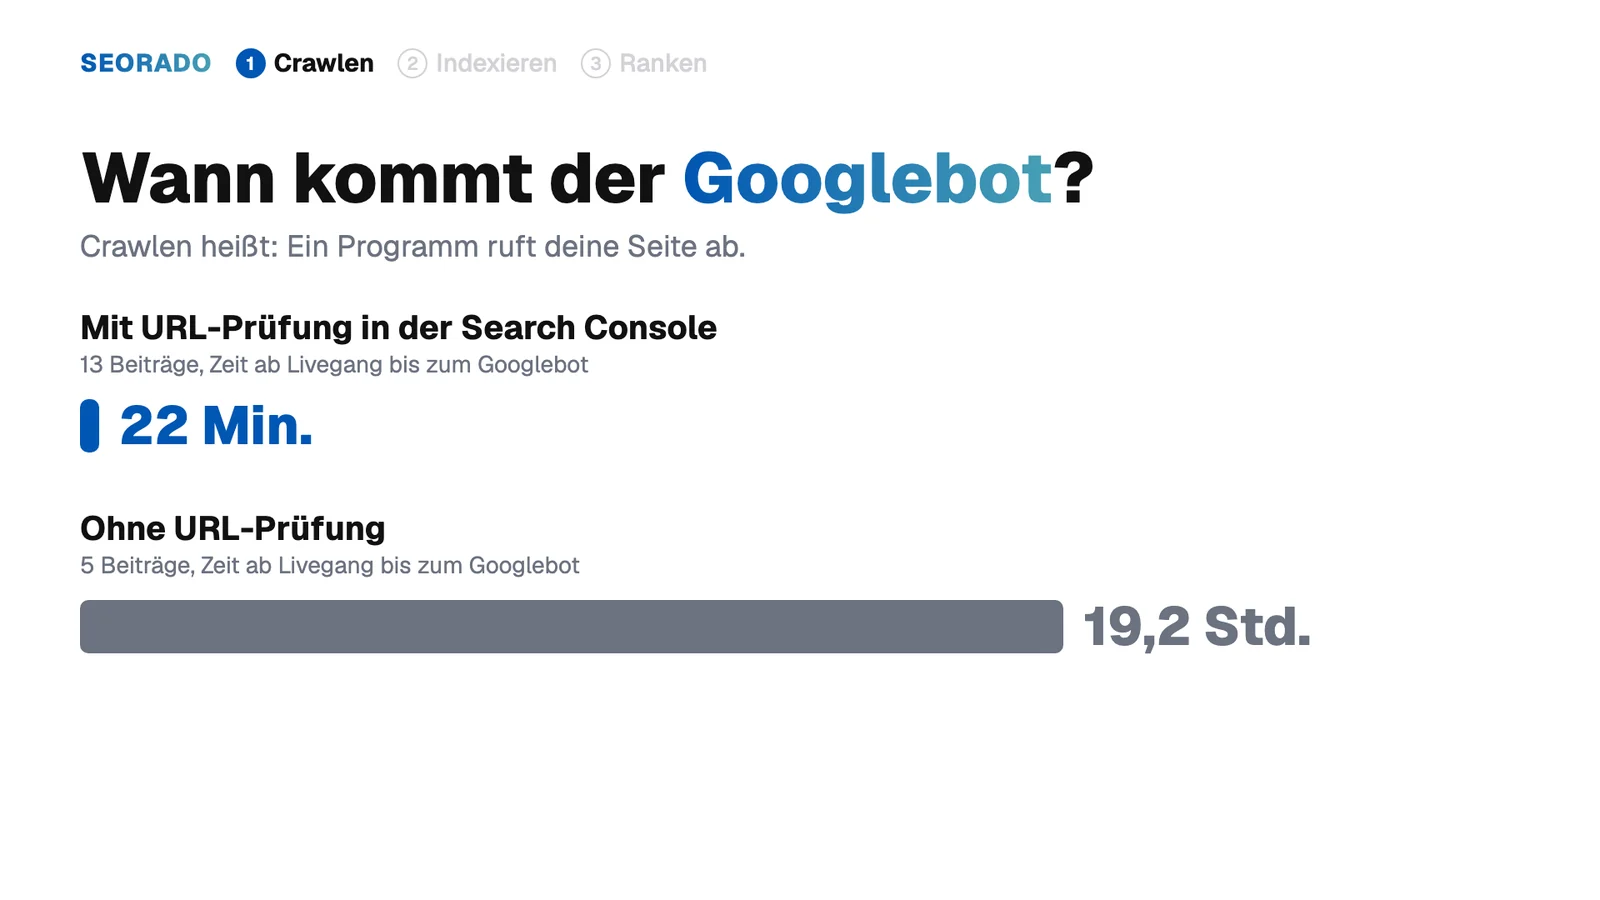
- Bei meinen 20 neuen Beiträgen kam der echte Googlebot im Median 1,1 Stunden nach dem Livegang. Mit einer URL-Prüfung in der Search Console waren es 22 Minuten (13 Beiträge), ohne 19,2 Stunden (5 Beiträge). Das ist kein Experiment, passt aber zu den rund 20 Stunden, die Google in Barcelona genannt hat.
- 93,2 Prozent der Abrufe mit Googlebot-Kennung stammten nicht aus Googles IP-Bereichen. Wer Crawler nur nach dem Namen zählt, zählt Fälschungen mit.
- Abgerufen heißt nicht indexiert, und indexiert heißt nicht sichtbar. Google garantiert keinen der drei Schritte. 10 von 20 Beiträgen hatten bis zum 04.10. eine Impression. Neue Themen standen am ersten Tag auf Seite 1, ein Dauerthema liegt auf Position 75,6 bis 84,5.
- KI-Crawler haben eigene Rhythmen: ClaudeBot kam nach 1,7 Stunden, PerplexityBot nach 33,8, Applebot nach 82,3 (7 von 20 Beiträgen). Bing rief keinen der 20 Beiträge ab.
- Mein Rat: Richte die Search Console ein, prüfe wichtige neue Seiten nach dem Livegang, lies Logs nur mit geprüften IP-Adressen und entscheide bewusst, welche KI-Crawler du in der robots.txt zulässt.
Inhaltsverzeichnis11 Abschnitte
- So habe ich gemessen
- Das Video: So funktioniert SEO in 84 Sekunden
- Schritt 1: Crawlen. Wie schnell kommt Google?
- Wer ruft deine Seite wirklich ab? Der Name Googlebot beweist nichts
- Schritt 2: Indexieren. Abgerufen heißt nicht gespeichert
- Schritt 3: Ausspielen. Hier liegt der Engpass
- KI-Crawler und KI-Antworten: gleicher Ablauf, andere Rhythmen
- Das kannst du heute tun
- Grenzen der Daten
- Häufige Fragen
- Quellen
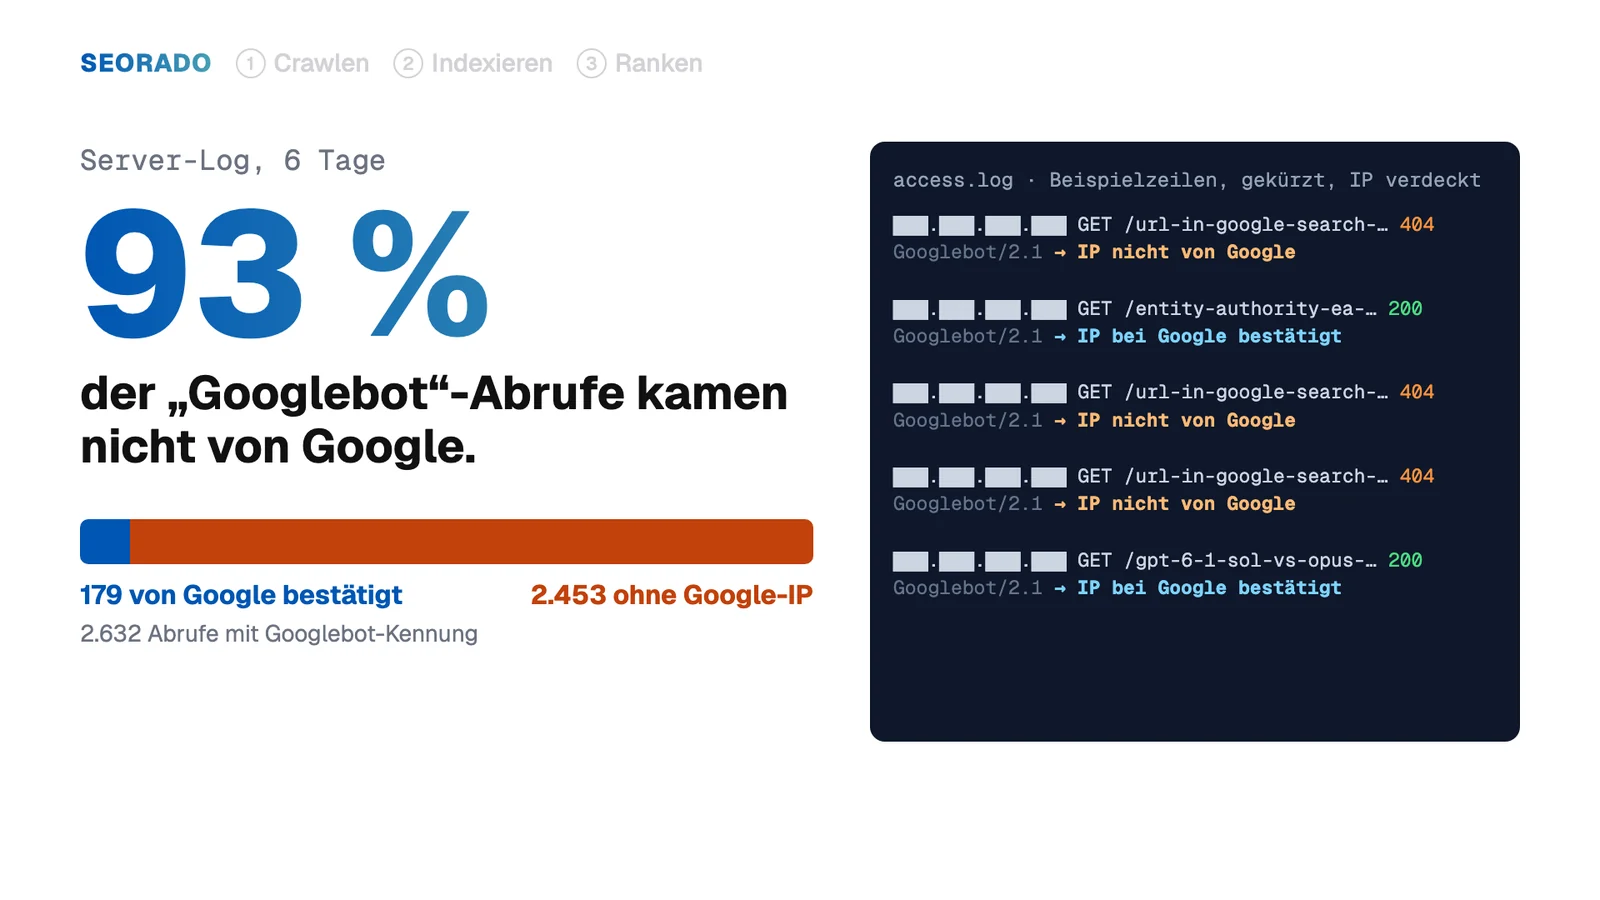
93 Prozent der Abrufe, die sich in meinem Server-Log „Googlebot“ nannten, kamen nicht von Google. Von 2.632 Abrufen stammten nur 179 von IP-Adressen, die Google selbst als Crawler-Adressen veröffentlicht. Die übrigen 2.453 kamen von 1.270 verschiedenen Adressen, und 63 Prozent davon liefen ins Leere (404).
Das ist der Nebenbefund einer Auswertung, mit der ich eine einfache Frage beantworten wollte: Wie funktioniert SEO in der Praxis? Was passiert zwischen „Seite veröffentlicht“ und „Seite bei Google sichtbar“? Mit KI-Unterstützung habe ich dafür den Server-Log von seorado.de vom 29.09.2026 bis 05.10.2026 ausgewertet (19.312 Zeilen), bei den Abrufen, die sich als Google, Bing, OpenAI, Perplexity, Apple oder Anthropic ausgaben, die IP-Adresse mit den veröffentlichten Bereichen der Betreiber abgeglichen und das Ergebnis mit den Search-Console-Zahlen zu 20 neuen Beiträgen verknüpft. Die Einführung ins Thema steht in Was ist SEO?. Hier geht es um den Ablauf dahinter, mit eigenen Messwerten.
Dazu gibt es ein Erklärvideo und zwei Werkzeuge, mit denen du dieselben Prüfungen für deine Seite machst. Animation und Werkzeuge habe ich mit KI-Unterstützung als Code gebaut. Die Stimme im Video ist synthetisch.
So habe ich gemessen
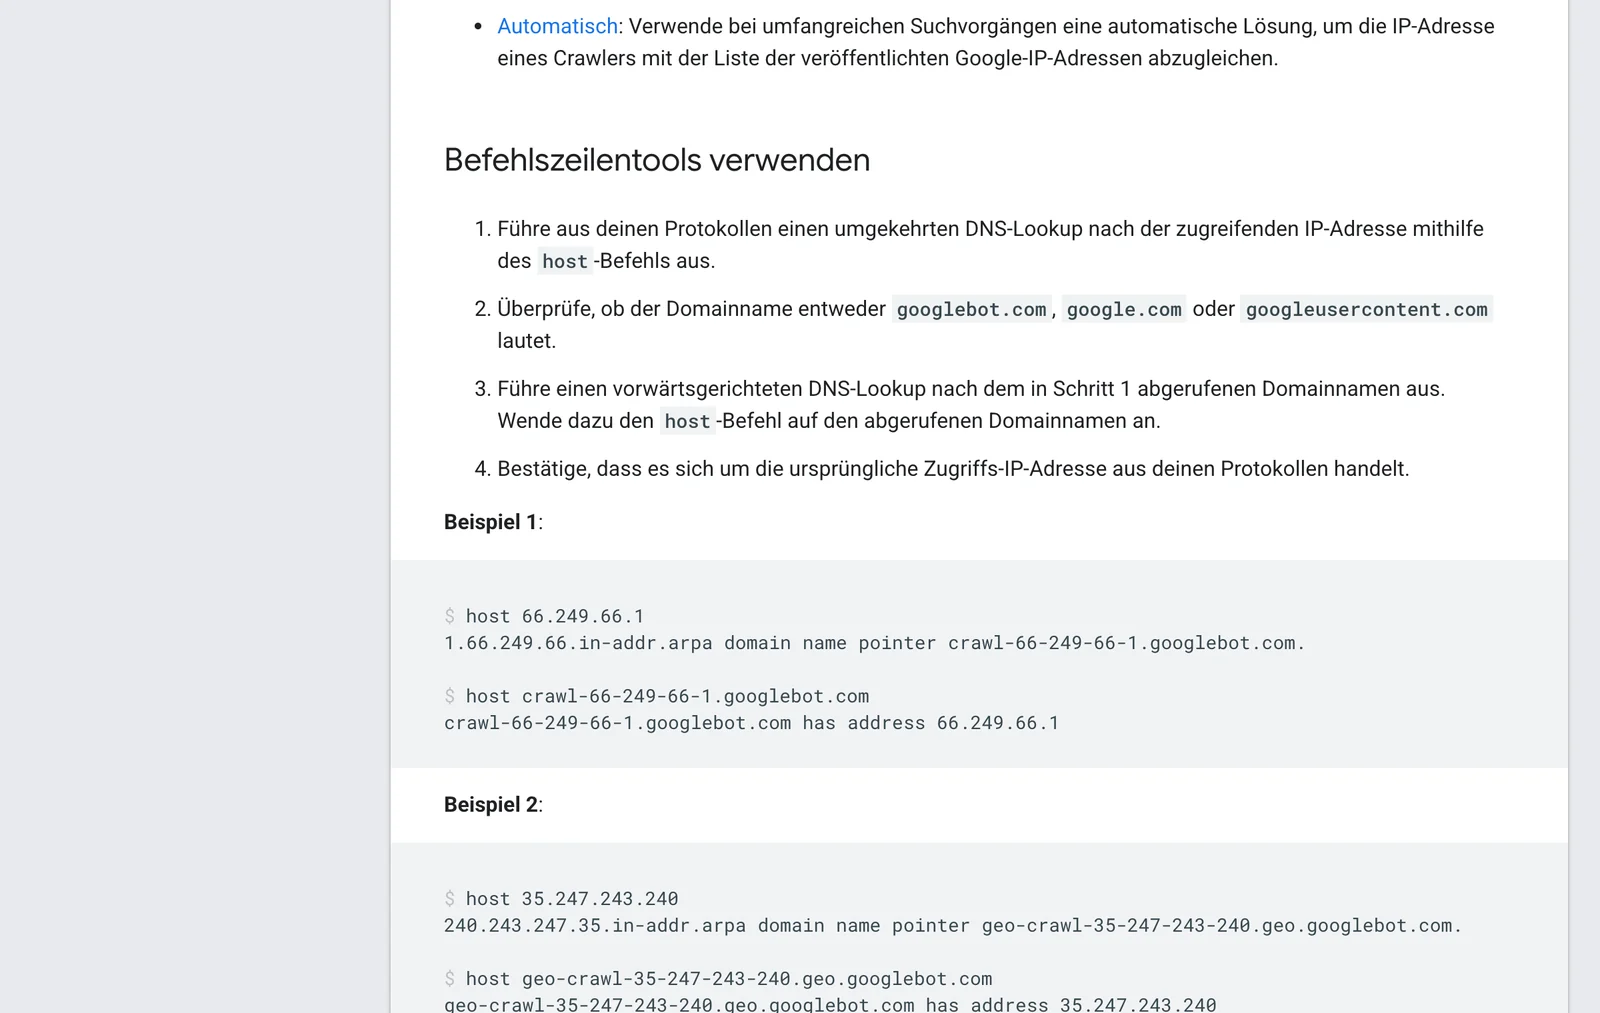
Der Server von seorado.de schreibt jeden Abruf in ein Log: Uhrzeit, IP-Adresse, Adresse der Seite, Antwortcode und die Selbstbezeichnung des Programms, den User-Agent. „Googlebot“ steht dort, weil sich das Programm so nennt. Beweisen kann es das nicht, denn jedes Skript kann sich so nennen. Deshalb habe ich zwei Prüfungen kombiniert, die Google in der Doku Anfragen von Google-Crawlern und -Fetchern überprüfen selbst beschreibt: den Abgleich der IP mit Googles veröffentlichten Bereichen und eine Reverse-DNS-Probe. Für Bing, OpenAI, Perplexity, Apple und Anthropic gilt derselbe Abgleich mit den Listen der jeweiligen Betreiber.
Als Livegang eines Beitrags zähle ich die erste erfolgreiche Antwort im Log. Die Stichprobe sind alle 20 neuen Beiträge dieser Woche, ohne die Überarbeitungen bestehender Beiträge. Impressionen und Positionen stammen aus der Search Console von seorado.de bis zum 04.10.2026. Die Auswertung lief lesend auf dem Server, es wurden nur Summen ausgegeben, keine IP-Adressen. Die Grenzen der Methode sammle ich am Ende in einem eigenen Abschnitt.
Das Video: So funktioniert SEO in 84 Sekunden
Das Video zeigt die drei Schritte mit den Zahlen aus diesem Beitrag. Die deutschen Untertitel lassen sich im Player einschalten.
Schritt 1: Crawlen. Wie schnell kommt Google?
Crawlen heißt: Ein Programm ruft deine Seite ab und folgt ihren Links. Google entdeckt neue Seiten laut seiner Doku über Links und Sitemaps und rendert sie wie ein Browser. Die Crawler sind so programmiert, dass sie deine Website nicht zu schnell abrufen. Eine Garantie gibt es nicht: „Google garantiert nicht, dass deine Seite gecrawlt, indexiert oder bereitgestellt wird“, steht im Leitfaden So funktioniert die Google Suche.
Wie lange das dauert, beantwortet Google im Starter-Guide nur grob: Änderungen werden „innerhalb weniger Stunden“ oder erst nach „mehreren Monaten“ wirksam. Genauer wurde Gary Illyes am 02.10.2026 beim Search Central Live in Barcelona. Laut der Mitschrift der Agentur ROAST und den Berichten von Search Engine Journal (04.10.2026) und Search Engine Roundtable (05.10.2026) nannte er typische Werte: Eine neue URL wird nach etwa 20 Stunden entdeckt, die Indexierung läuft Ende zu Ende in etwa 1,5 Stunden, eine bekannte URL wird nach etwa 30 Tagen erneut geholt. Illyes hat Barry Schwartz zufolge klargestellt, es sei eine Übung gewesen, ob sich das Publikum in den intern gezogenen Zahlen wiederfindet, und keine offizielle Statistik.
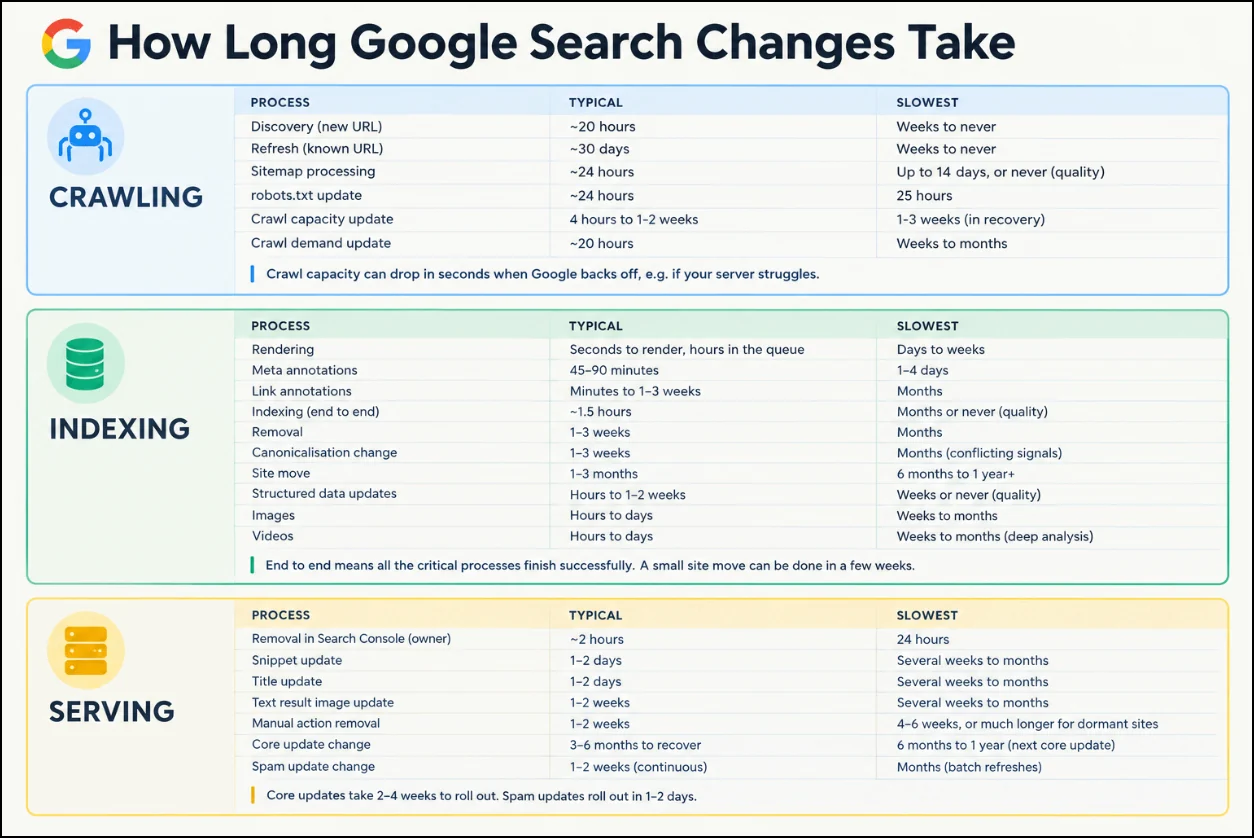
Diese Werte kann ich an meinem eigenen Log prüfen. Bei den 20 neuen Beiträgen kam der echte Googlebot in 18 Fällen vorbei, im Median 1,1 Stunden nach dem Livegang. Dahinter stecken zwei sehr verschiedene Gruppen.
Bei 15 Beiträgen lief in den ersten sechs Stunden eine URL-Prüfung in der Search Console. Im Log erkennst du sie am Abruf durch das Google-InspectionTool. Bei den 13 davon, die einen Googlebot-Besuch bekamen, kam er im Median 22 Minuten nach dem Livegang (zwischen etwa 4 und 214 Minuten) und im Median etwa 2 bis 3 Minuten nach der Prüfung (nie mehr als etwa 4 Minuten). Die Minutenwerte sind auf rund eine halbe Minute genau. Bei den 5 Beiträgen ohne Prüfung dauerte es im Median 19,2 Stunden (zwischen 3,3 und 20,6). Das liegt nah an den rund 20 Stunden aus Barcelona.
Zwei Ausnahmen gehören dazu. Beim pdfcn-Beitrag lief die URL-Prüfung etwa eine Minute nach dem Livegang, ein echter Googlebot kam bis zum Ende des Logs aber nicht, also über vier Tage lang. Beim Conversion-Ratgeber lief sie nach 3,6 Stunden, und gut zwei Stunden später hatte noch keiner angeklopft. Eine URL-Prüfung ist also kein Schalter. Das Log zeigt nur den Abruf durch das Prüftool. Google schreibt in der Search-Console-Hilfe: „Das Einreichen einer Anfrage garantiert nicht, dass die Seite im Google-Index erscheint.“ Außerdem gilt ein Tageslimit, dessen Höhe Google nicht nennt, und mehrere Anfragen für dieselbe URL beschleunigen laut Doku nichts.
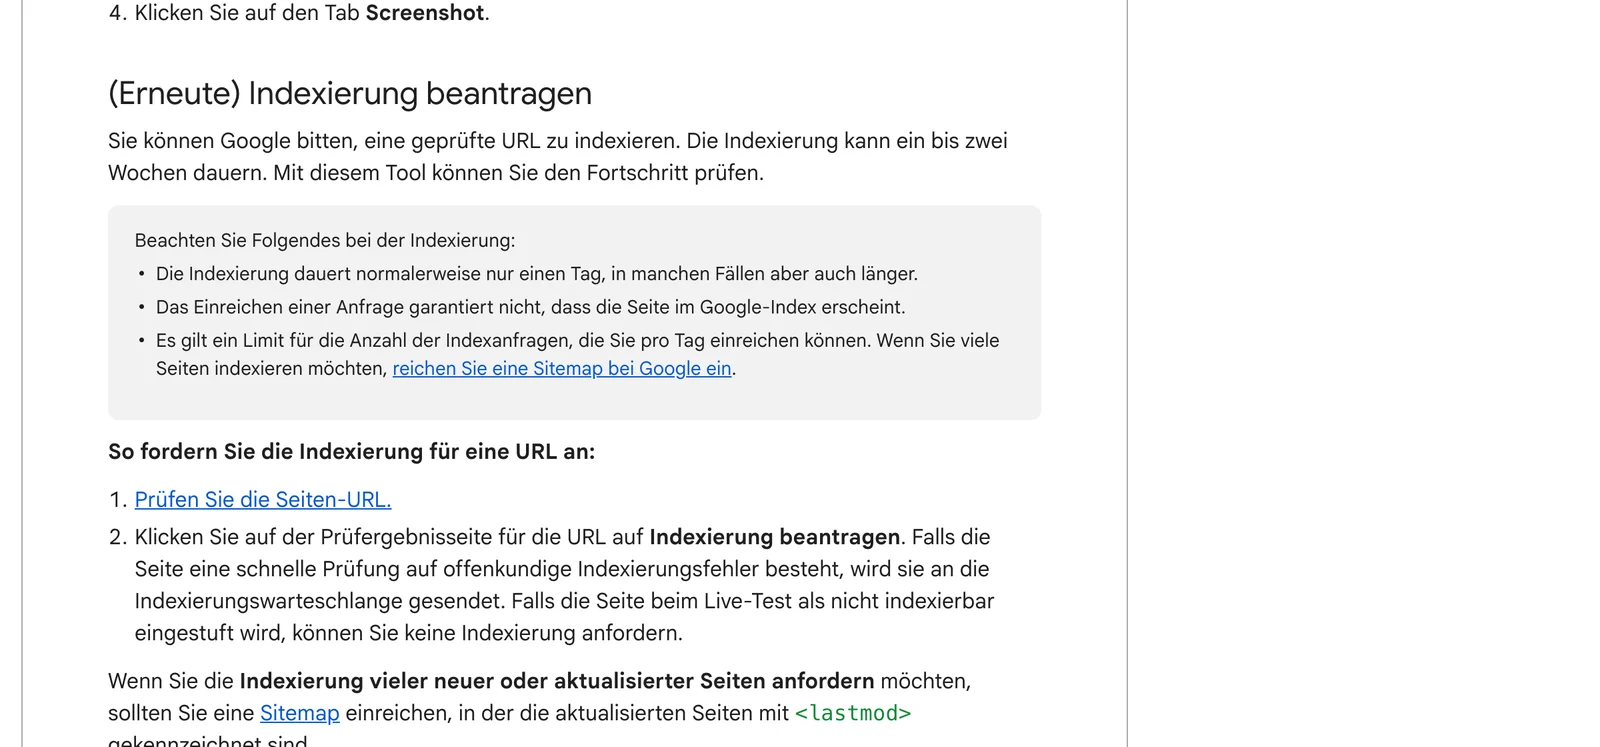
So gehe ich bei neuen Beiträgen vor: Search Console öffnen, die vollständige Adresse oben in die Prüfleiste eingeben, Enter drücken und auf „Indexierung beantragen“ klicken. Das deckt sich mit dem Weg in der Google-Hilfe, die den Button nur anbietet, wenn die Live-Prüfung die Seite als indexierbar zeigt. Die einzelnen Schritte stehen im Beitrag URL in der Google Search Console einreichen. Bei Problemen mit dem Button hilft ein Blick auf u/wmtips auf r/SEO: Am 04.09.2026 meldete er den Fehler „We had a problem submitting your indexing request“ und schrieb, dass dabei trotzdem Kontingent verbraucht wurde.
Mathias Goldhan beschreibt auf LinkedIn (18.08.2026) einen ähnlichen Ablauf: Livegang eines neuen Clusters sonntags um 17 Uhr, Indexierung der Hauptseite um 18:55 Uhr beantragt, keine zwei Stunden später stand sie in den Ergebnissen, und am Montagmorgen waren 6 von 13 neuen Unterseiten im Index. Er führt das Tempo auf Varnish-Cache, sauberes Schema-Markup und effizientes Crawling zurück. In beiden Fällen, seinem und meinem, hat vorher jemand Google aktiv auf die Seite gestoßen. Ob Technik oder Anfrage mehr zum Tempo beitragen, lässt sich aus Einzelfällen nicht trennen.
Was du bei einer neuen wichtigen Seite tust
- Seite veröffentlichen und prüfen, dass sie ohne noindex und mit Statuscode 200 antwortet. Das erledigt die Index-Diagnose weiter unten.
- Die Adresse in die URL-Prüfung der Search Console eingeben und, wenn möglich, die Indexierung einmal beantragen. Nicht mehrfach: Das beschleunigt laut Google nichts.
- Die Seite in die Sitemap aufnehmen, mit ehrlichem Änderungsdatum. Google nutzt das Datum laut dem Podcast Search Off the Record (01.10.2026) nur, wenn es plausibel wirkt.
- Nach 24 Stunden im Log oder in der Search Console nachsehen, ob der Googlebot da war.
Crawl-Budget: für die meisten Shops kein Thema
Google richtet seine Anleitung zum Crawling-Budget an Websites mit mehr als einer Million Seiten, die sich wöchentlich ändern, oder mit mehr als 10.000 Seiten, die sich täglich ändern. Die Zahlen sind laut Google eine grobe Schätzung: „Es sind keine genauen Grenzwerte.“ Wer weniger Seiten hat, braucht die Anleitung nicht. Für kleine Seiten genügen eine aktuelle Sitemap und der Blick in den Bericht zur Seitenindexierung. Das Kapazitätslimit startet laut Search Engine Roundtable (22.07.2026) bei jeder Website mit demselben vorsichtigen Standardwert und wächst, wenn Bedarf besteht und der Server gesund bleibt. Eine höhere Crawling-Frequenz lässt sich nicht beantragen.
Anders sieht es bei Shops mit vielen Filter-URLs aus. Ein Nutzer berichtet am 21.09.2026 auf r/TechSEO, Googlebot habe sein Budget überwiegend auf Facetten-URLs verbraucht, nach Korrekturen an robots.txt und Canonicals sei die Indexierung binnen zwei Wochen spürbar schneller geworden. Daten nennt der Beitrag nicht, er zeigt aber, wo Verschwendung entsteht. Wie du Filter-Adressen sperrst, steht in der robots.txt-Anleitung mit Vorlagen für Shops.
Zur Größenordnung: Der echte Googlebot hat in knapp sechs Tagen 179 Abrufe auf 64 verschiedene Adressen von seorado.de gemacht, davon allein 77 auf die robots.txt. Er liest sie also immer wieder neu. Gary Illyes erklärt im Podcast Search Off the Record (Episode 105, 12.03.2026), der Name „Googlebot“ sei ein „misnomer“: Dahinter steht keine einzelne Software, sondern eine zentrale Crawling-Plattform, bei der Googlebot nur einer von vielen Kunden ist.
Wer ruft deine Seite wirklich ab? Der Name Googlebot beweist nichts
Zurück zum Einstieg. Aus 2.632 Abrufen mit Googlebot-Kennung stammen 179 (6,8 Prozent) von 11 IP-Adressen innerhalb der Bereiche, die Google als common-crawlers.json veröffentlicht. Alle 11 habe ich zusätzlich per Reverse-DNS geprüft, und alle lösen auf googlebot.com auf (11 von 11). Die übrigen 2.453 Abrufe verteilen sich auf 1.270 Adressen. In einer Stichprobe von 30 davon hatte keine einen Reverse-DNS-Eintrag. 63 Prozent dieser Abrufe waren 404-Antworten, 1.536 allein auf eine einzige abgeschnittene Adresse.
Ähnlich sieht es bei den KI-Kennungen aus. Der Abgleich mit den Listen der Betreiber ergibt:
| Kennung im Log | Abrufe mit dieser Kennung | aus den veröffentlichten IP-Bereichen | ohne passende IP |
|---|---|---|---|
| Googlebot | 2.632 | 179 | 2.453 |
| ClaudeBot | 238 | 176 | 62 |
| PerplexityBot | 129 | 96 | 33 |
| Applebot | 130 | 118 | 12 |
| ChatGPT-User | 123 | 109 | 14 |
| OAI-SearchBot | 32 | 15 | 17 |
| GPTBot | 17 | 0 | 17 |
Ein echter GPTBot war in diesem Zeitraum nicht dabei. Auch OpenAI, Perplexity, Apple und Anthropic veröffentlichen die IP-Bereiche ihrer Crawler. Anthropic führt alle drei Bots in einer gemeinsamen Liste (bots.json), die Listen von Bing, Perplexity und OpenAI haben teils ältere Stände, die Daten stehen im Werkzeug unten.
Ich bin damit nicht allein. Duane Forrester wertete für einen Beitrag vom 25.06.2026 14 Tage Server-Logs einer neuen, unbeworbenen Plattform aus und fand bei Search Engine Journal, dass von 799 Anfragen mit dem Namen Googlebot nur 107 von einer verifizierten Google-Adresse kamen. Sein Satz dazu: „The name is the claim. The IP is the proof.“ Der SEO-Spezialist Mohib Khan rät in einem LinkedIn-Beitrag vom 02.10.2026, 30 Tage Logs gegen die veröffentlichten IP-Bereiche abzugleichen, „because anyone can fake a user agent“. Sein Beitrag bewirbt ein eigenes Audit-Werkzeug, der Rat deckt sich mit Googles Anleitung.
Was das für dich bedeutet
- Bot-Zahlen in Statistik-Tools sind oft Namenszählungen. Ein Dashboard, das „Googlebot“ nach dem User-Agent zählt, zeigt Fälschungen als Google.
- Dein 404-Bericht aus dem Log ist verfälscht. Bei mir gingen 1.536 Abrufe mit Googlebot-Kennung auf eine einzige abgeschnittene Adresse, keiner davon kam aus Googles IP-Bereichen. In der Search Console können solche Abrufe nicht auftauchen, im Log-Werkzeug schon. Richte dich bei 404-Fehlern nach der Search Console, nicht nach dem Namen im Log.
- Der Name allein ist keine Grundlage für Regeln. Wer „Googlebot“ per Name zulässt, lässt auch Fälschungen durch. Verlass dich auf IP-Bereiche und Reverse-DNS.
Mit dem Crawler-Log-Leser prüfst du dein eigenes Log. Füge Zeilen aus dem Server-Log ein, Combined-Format von nginx und Apache oder JSON-Zeilen. Wo du das Log findest, hängt vom Hosting ab, oft im Hosting-Panel unter „Zugriffsprotokolle“. Bei gehosteten Shop-Systemen wie Shopify gibt es keine Rohlogs. Dort zeigt die Search Console unter Einstellungen den Bericht Crawling-Statistik mit Antworten, Dateitypen und Googlebot-Typen, allerdings nur die Sicht von Google. Der Pfad stammt aus der Hilfe, ich konnte ihn für seorado.de nicht selbst öffnen.
Schritt 2: Indexieren. Abgerufen heißt nicht gespeichert
Nach dem Abruf wertet Google die Seite aus: Text, Titel, Canonical, Sprache, Duplikate. Dann entscheidet es, ob die Seite in den Index kommt, die große Datenbank, aus der die Suchergebnisse stammen. Google sagt dazu klar: „Die Indexierung wird nicht garantiert.“ Wie schnell es geht, steht wieder in der Barcelona-Grafik: Die Indexierung dauert Ende zu Ende typischerweise etwa 1,5 Stunden, im langsamsten Fall Monate oder nie, wenn es an der Qualität liegt.
Dass Qualität bremsen kann, sagt Google auch im Podcast Search Off the Record (01.10.2026). Dort geht es um die Sitemap-Meldung „Konnte nicht abgerufen werden“. Der Grund sei entweder, dass Google keine Zeit hat, oder dass der Bedarf gering ist, weil Google die Qualität der Website niedrig einschätzt. Es sei „not purely a technical thing“, also nicht nur eine technische Frage.
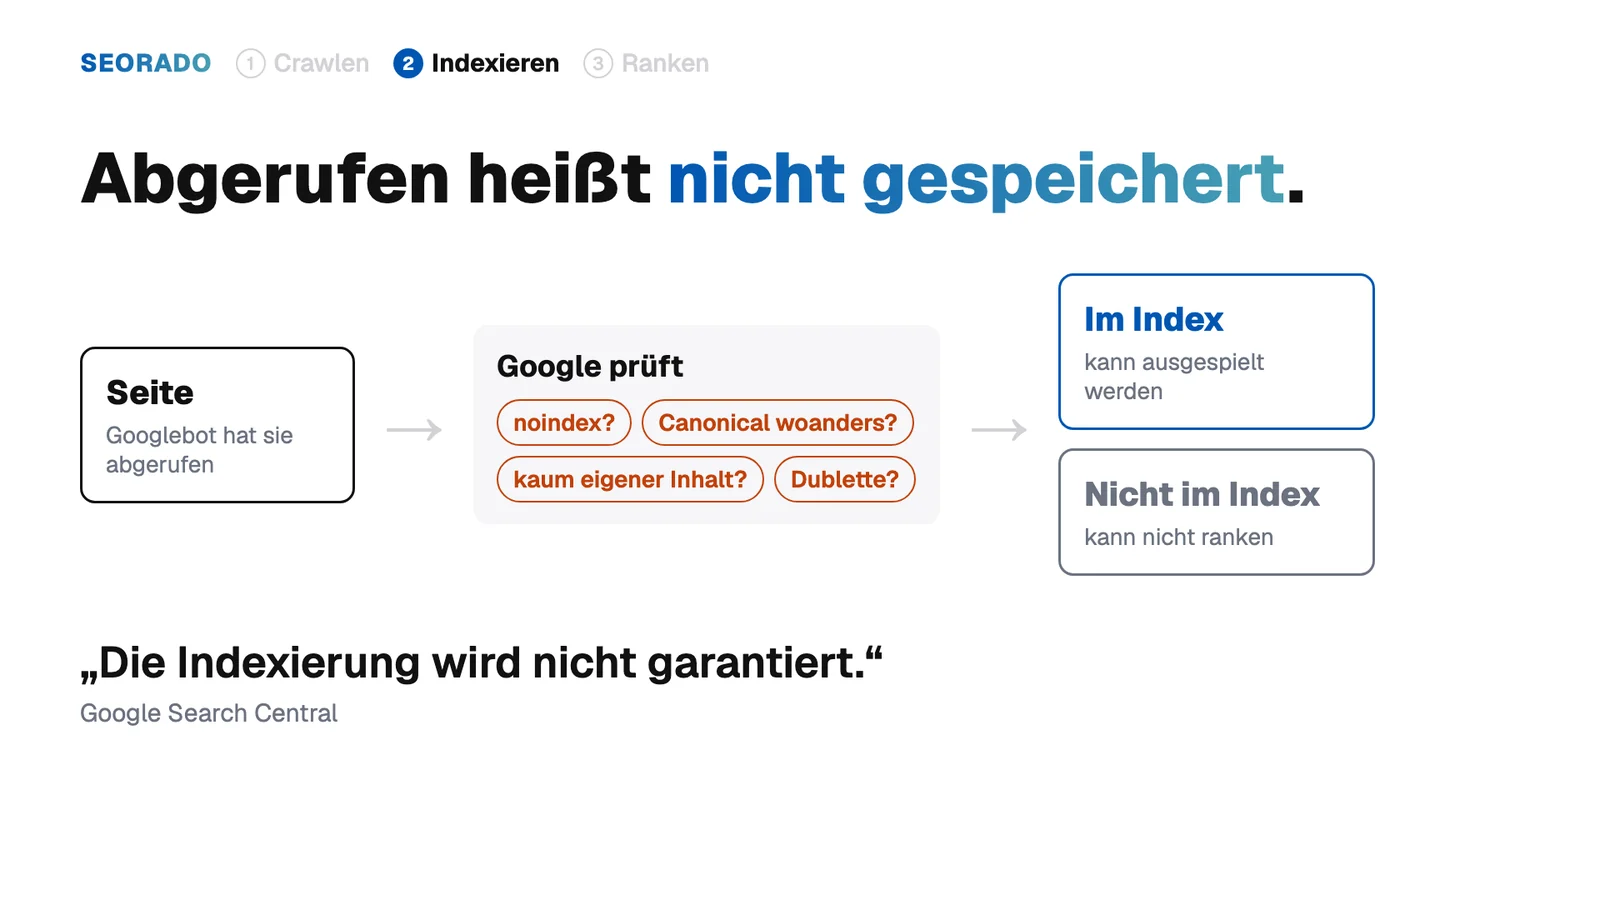
Die häufigsten Ursachen, wenn eine abgerufene Seite nicht im Index steht:
- noindex. Eine Meta-Angabe oder ein X-Robots-Tag verbietet die Aufnahme. Das passiert nach Relaunches, wenn eine Testumgebung gesperrt war und die Einstellung mitwandert. Die Relaunch-Checkliste führt das als einen der ersten Punkte.
- Ein Canonical auf eine andere Adresse. Dann geht Google davon aus, dass die andere Seite die Hauptversion ist. Ein Canonical ist laut Google ein Hinweis und keine Regel.
- Dubletten und Filter-Varianten. Google fasst sie zusammen und zeigt eine Adresse.
- Inhalt, der erst per JavaScript erscheint. Im Quelltext steht dann kaum Text. Google rendert zwar, du solltest aber in der URL-Prüfung nachsehen, was Google tatsächlich sieht.
- Zu wenig Eigenes. Hersteller-Text, den hundert Händler teilen, gibt Google wenig Anlass, ausgerechnet deine Seite zu speichern.
Eine Besonderheit führt oft in die Irre: Sperrt die robots.txt eine Adresse, kann Google ein dort stehendes noindex nicht lesen, weil es die Seite gar nicht abrufen darf. Wer eine Seite aus dem Index haben will, braucht also zuerst den Abruf und dann das noindex. Wie du Adressen sauber entfernst, erklärt der Beitrag URLs aus Google entfernen.
Mit der Index-Diagnose findest du die Stufe, an der eine Seite hängt. Du fügst Adresse, Statuscode, robots.txt und den Quelltext ein. Die Diagnose wendet die robots.txt-Regeln nach dem Standard an (längste passende Regel gewinnt, bei Gleichstand gilt Allow), liest Meta-Robots, X-Robots-Tag, Canonical und Titel und zeigt dir pro Stufe, was sie findet und was du ändern kannst. Das Beispiel ist erfunden und zeigt den typischen Konflikt einer Filterseite: gesperrt per robots.txt, noindex im Quelltext und ein Canonical auf die Kategorie.
Ob eine Seite tatsächlich im Index steht, zeigt dir die Search Console: in der URL-Prüfung für einzelne Adressen und im Bericht zur Seitenindexierung für alle. Wie du die Berichte liest, steht im Beitrag Google Search Console richtig lesen.
Schritt 3: Ausspielen. Hier liegt der Engpass
Im dritten Schritt wählt Google aus dem Index die Seiten aus, die zu einer Suchanfrage passen, und sortiert sie. Google nennt dafür im Leitfaden zu Ranking-Systemen 17 aktuelle Systeme, darunter BERT, RankBrain, neuronalen Abgleich, das Ranking von Passagen, Aktualitäts- und Originalinhalte-Systeme und die Spamerkennung. Dazu schreibt Google: „Unsere Ranking-Systeme sind für den Einsatz auf Seitenebene konzipiert.“ Zusätzlich fließen websiteweite Signale ein.
Wie viel dabei in der Praxis ankommt, zeigt die Search Console. Von meinen 20 neuen Beiträgen hatten 10 bis zum 04.10. mindestens eine Impression in der Google-Suche. Von den 11, die vor dem 03.10. live gingen und damit mindestens zwei Tage Zeit hatten, waren es 8. Wie unterschiedlich das aussieht, zeigen vier Beiträge:
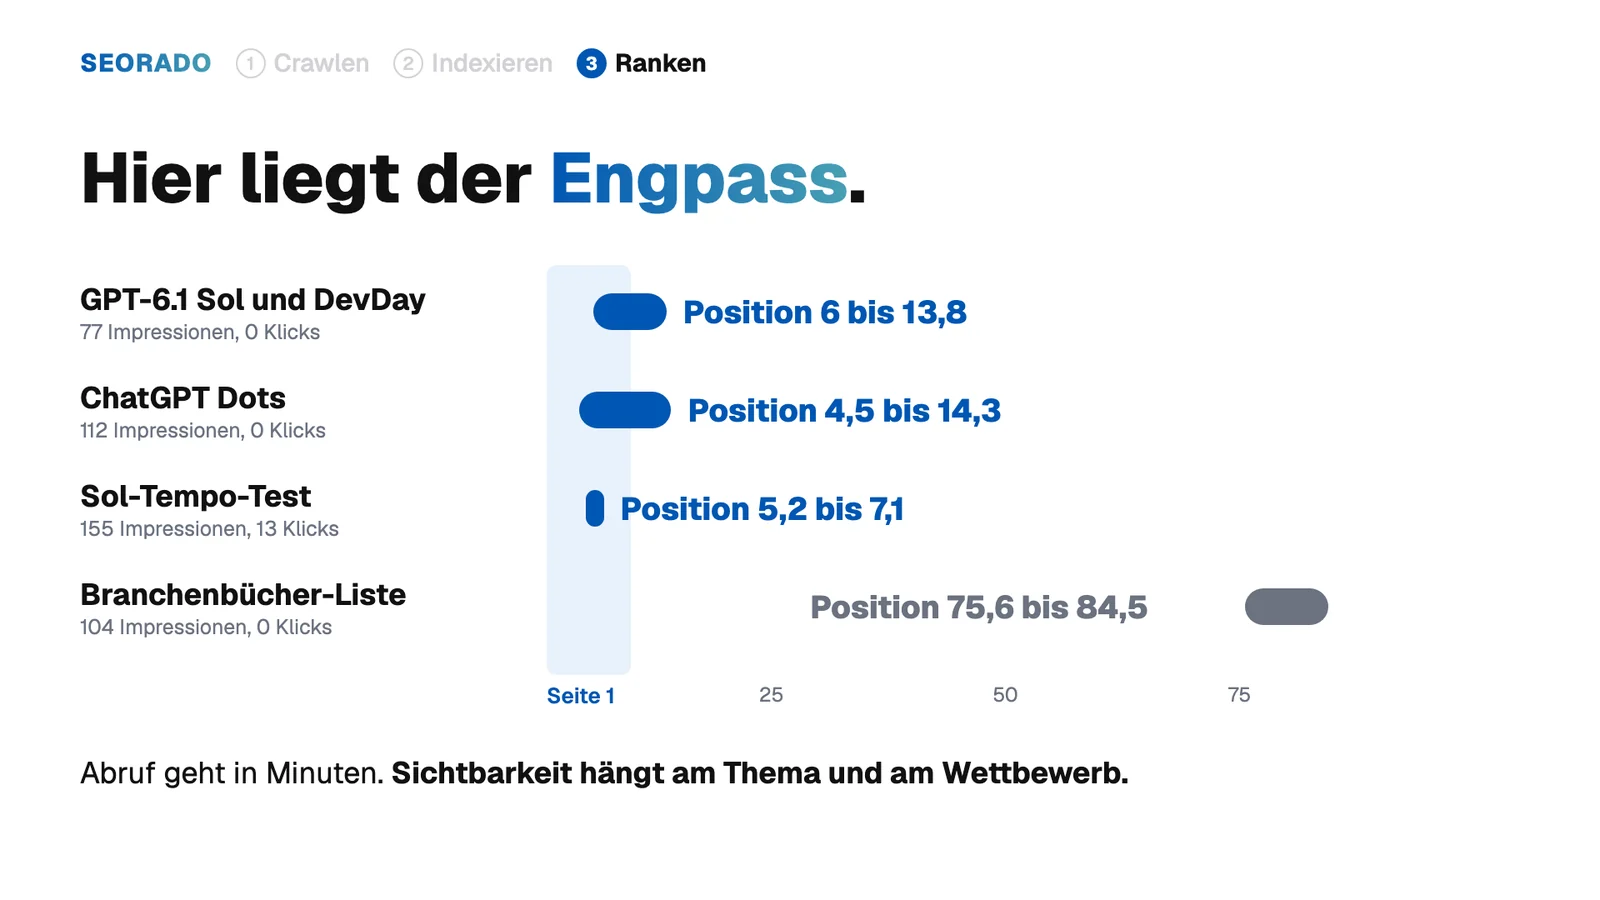
- Sol-Tempo-Test: 155 Impressionen, 13 Klicks, Position 5,2 bis 7,1.
- GPT-6.1 Sol und DevDay 2026: 77 Impressionen, 0 Klicks, Position 6 bis 13,8.
- ChatGPT Dots: 112 Impressionen, 0 Klicks, Position 4,5 bis 14,3.
- Kostenlose Branchenbücher: 104 Impressionen, 0 Klicks, Position 75,6 bis 84,5.
Die drei Beiträge zu brandneuen Themen standen am ersten Tag in der Suche auf Seite eins. Die Liste zu einem Dauerthema, auf das viele etablierte Seiten antworten, liegt auf Seite acht bis neun: Sie wird gesehen, aber nicht angeklickt. Meine Einordnung: Crawlen und Indexieren kosten Minuten bis Stunden, das Ranking hängt am Wettbewerb um die Suchanfrage. Das ist eine Beobachtung an vier Beiträgen und kein Beleg, und die Durchschnittspositionen beruhen auf wenigen Impressionen pro Tag. Für die Praxis heißt das: Ein schneller Abruf ist kein Ergebnis. Er ist die Voraussetzung dafür, dass Inhalt, Wettbewerb und Zeit überhaupt wirken können.
Wie lange diese Wirkung dauert, ist damit nicht beantwortet. Google rät im Starter-Guide, einige Wochen zu warten, bevor du eine Änderung beurteilst. Bei größeren Eingriffen nennt die Barcelona-Grafik deutlich längere Zeiträume, etwa drei bis sechs Monate Erholung nach einem Core-Update. Was du für das Ranking beeinflussen kannst, steht in den Beiträgen zur Keyword-Recherche, zu E-E-A-T und zu den Core Web Vitals.
KI-Crawler und KI-Antworten: gleicher Ablauf, andere Rhythmen
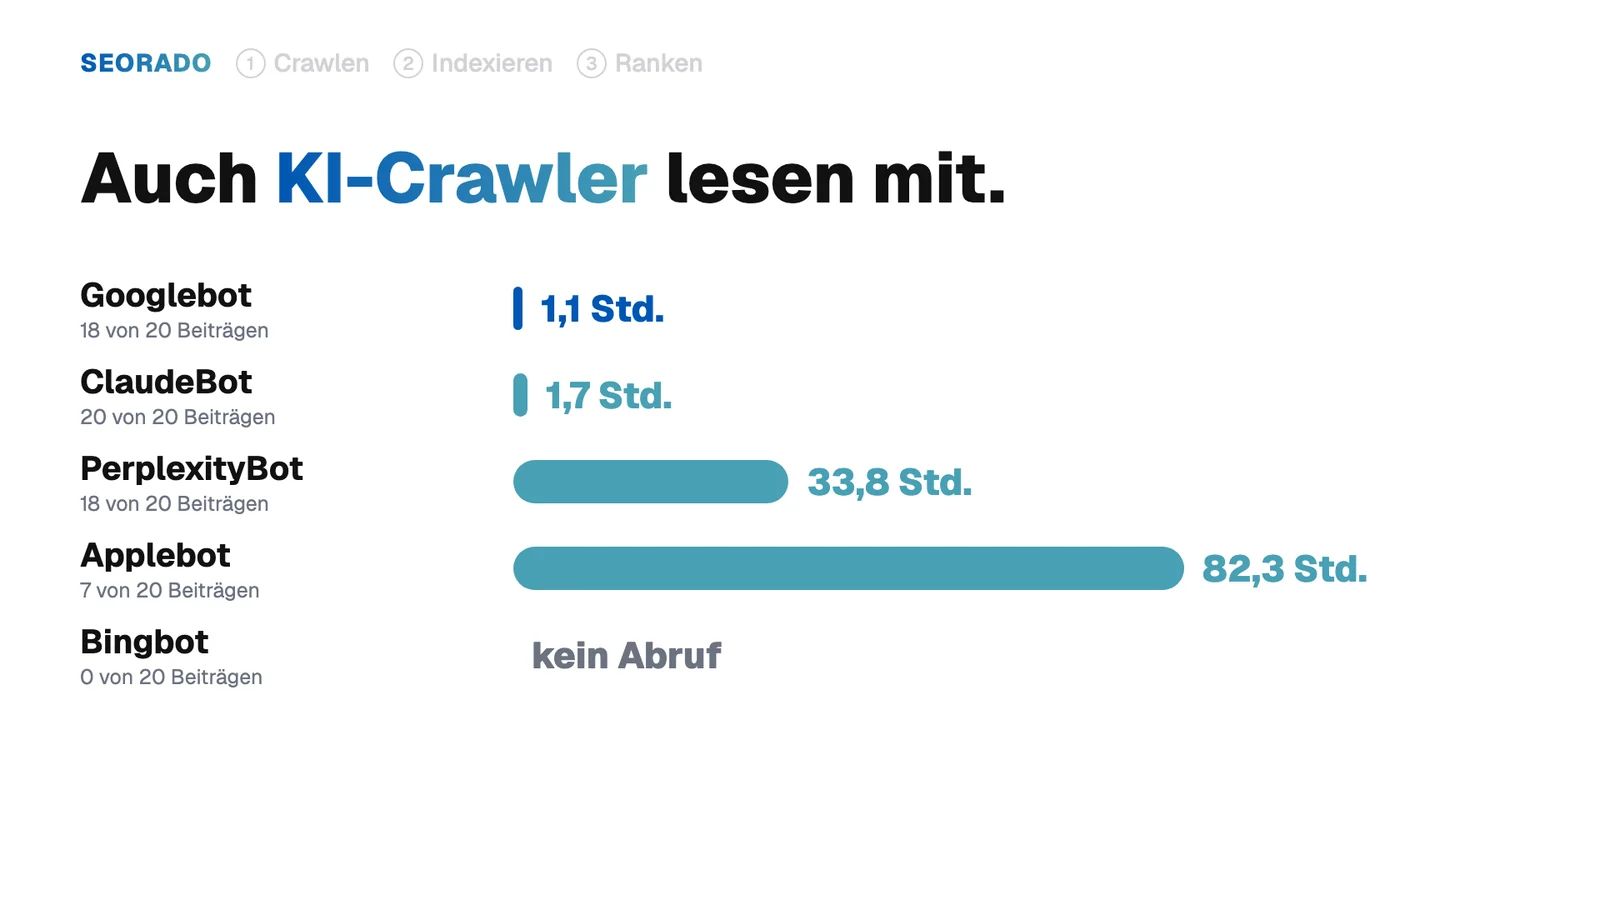
Auch KI-Dienste holen sich Seiten über Crawler, und die folgen demselben Dreischritt. Die Unterschiede liegen im Tempo und in den Regeln. Die Tabelle stellt die Angaben der Betreiber neben meine Beobachtung. Die Zeiten sind der Median vom Livegang bis zum ersten Abruf bei den 20 neuen Beiträgen, jeweils nur für Abrufe aus den veröffentlichten IP-Bereichen.
| Crawler | Wofür laut Anbieter | robots.txt laut Anbieter | Mein Log |
|---|---|---|---|
| Googlebot | Google Suche, auch Grundlage der KI-Übersichten | wird immer beachtet | 18 von 20 Beiträgen, Median 1,1 Std. |
| Bingbot | Bing | nicht geprüft | 0 von 20 Beiträgen, aber 198 Abrufe auf 57 verschiedene Adressen, knapp die Hälfte der Abrufe an Sitemaps |
| ClaudeBot | Modelltraining (Anthropic) | wird beachtet, Anthropic nennt das für alle drei Bots | 20 von 20 Beiträgen, Median 1,7 Std. |
| PerplexityBot | Suchergebnisse, kein Modelltraining | Empfehlung: erlauben | 18 von 20 Beiträgen, Median 33,8 Std. |
| Applebot | nicht geprüft | nicht geprüft | 7 von 20 Beiträgen, Median 82,3 Std. |
| OAI-SearchBot | ChatGPT-Suche | wird beachtet | holte nur die robots.txt (15 Abrufe), keine Seite |
| ChatGPT-User | Aktionen eines Nutzers in ChatGPT | „robots.txt rules may not apply“ | 109 Abrufe auf 18 Seiten, eigene Tests nicht ausgeschlossen |
Die Anbieterangaben in der Tabelle stammen aus den Dokus von Google, Anthropic, OpenAI und Perplexity. Wichtig ist die Unterscheidung nach dem Zweck. Such-Crawler wie OAI-SearchBot und PerplexityBot entscheiden, ob du in KI-Antworten als Quelle auftauchen kannst. Wer OAI-SearchBot sperrt, erscheint laut OpenAI nicht in den Suchantworten von ChatGPT. Trainings-Crawler wie GPTBot und ClaudeBot betreffen nur die Frage, ob deine Inhalte für Modelltraining genutzt werden. Und Fetcher, die ein Nutzer auslöst, richten sich nicht unbedingt nach der robots.txt: Bei ChatGPT-User steht in der Doku „robots.txt rules may not apply“, Perplexity-User „generally ignores robots.txt rules“. Anthropic dagegen schreibt, auch Claude-User beachte die robots.txt. Cloudflare hat Perplexity im August 2025 vorgeworfen, Crawler zu tarnen und Sperren zu umgehen, so die Beobachtung von Cloudflare. Perplexitys Antwort darauf habe ich nicht gelesen. Die robots.txt ist also eine Bitte, die sich nicht jeder merkt. Vorlagen findest du in der robots.txt-Anleitung.
Ein Befund aus dem Log: ClaudeBot war bei allen 20 Beiträgen im Median nach 1,7 Stunden da, deutlich vor Perplexity und Apple. Bing hat in der Woche keinen der 20 Beiträge abgerufen, obwohl es andere Seiten geholt hat. Für Bing und einige andere Suchmaschinen gibt es das Protokoll IndexNow: ein einfacher Ping, dass sich eine URL geändert hat. Teilnehmer sind laut Betreiber Bing, Naver, Seznam, Yandex und Yep. Google steht in der Liste nicht, eine ausdrückliche Absage von Google habe ich nicht gefunden. Auch IndexNow garantiert nichts: „Submitting a URL does not guarantee immediate indexing.“ Ob es bei seorado.de das Bing-Tempo ändern würde, habe ich nicht getestet.
Ändert die KI-Suche das Spiel?
Google beantwortet das in seinem Leitfaden zu generativen KI-Funktionen (Stand der Seite 15.07.2026) so: Die Optimierung dafür sei „weiterhin SEO“. Eine Seite muss indexiert und snippetfähig sein, damit sie als Link in KI-Übersichten erscheinen kann. Zusätzliche Dateien wie eine llms.txt braucht es für die Google Suche nicht, im Beitrag zu llms.txt steht, was Coding-Agents damit machen. Die Grundlagen für KI-Sichtbarkeit fasst Was ist GEO? zusammen. Der Ablauf bleibt derselbe, die drei Schritte oben gelten auch hier.
Wie viele Klicks die KI-Antworten kosten, ist dagegen offen. Drei Quellen zeigen unterschiedliche Bilder:
- Ein vorab registriertes Feldexperiment der Universität Pennsylvania und der Northeastern University (Preprint vom 18.08.2026, 1.100 Teilnehmende in den USA) fand: Wer in den AI Mode gezwungen wurde, klickte 18,8 Prozentpunkte seltener auf externe Links. Für die AI Overviews allein ist die Aussage unsicherer, weil die Erweiterung der Studie sie nur bei rund 51 Prozent der angezeigten AI Overviews ausblenden konnte.
- Das Pew Research Center zählte im März 2025 bei 900 Erwachsenen und 68.879 Google-Suchen: In 8 Prozent der Besuche mit KI-Zusammenfassung wurde ein klassisches Ergebnis angeklickt, ohne Zusammenfassung in 15 Prozent. Auf einen Link in der Zusammenfassung klickten 1 Prozent (Pew, 22.07.2025).
- Die Agentur Seer Interactive sah in den Daten ihrer Konten (53 Marken) die organische Klickrate bei Anfragen mit AI Overview von 1,3 Prozent im Dezember 2025 auf 2,4 Prozent im Februar 2026 steigen (Seer, 24.04.2026). Google selbst spricht von „höherer Klickqualität“, nennt aber keine Zahlen (Google-Blog, 06.08.2025).
Die Studien messen Verschiedenes: ein Experiment mit erzwungenem AI Mode, Browserdaten von US-Erwachsenen im März 2025 und Agenturdaten von Marken bis Februar 2026. Ich ziehe daraus keine Prognose für deinen Shop. Sicher ist nur, dass eine Seite ohne Abruf, Index und Snippet in keiner dieser Antworten vorkommen kann.
Das kannst du heute tun
- Search Console einrichten und prüfen. Ohne sie siehst du nur, was dein Server sieht. Sie zeigt, was Google sieht: Indexierung, Impressionen und die Crawling-Statistik.
- Wichtige neue Seiten nach dem Livegang in der URL-Prüfung testen. Bei mir kam der Googlebot mit Prüfung im Median 22 Minuten nach dem Livegang, ohne Prüfung nach 19,2 Stunden. Zwischen Prüfung und Googlebot lagen im Median etwa 2 bis 3 Minuten. Beantrage die Indexierung einmal, nicht mehrfach, und rechne damit, dass es nicht immer klappt.
- Bleibt eine Seite nach einer Woche aus, nutze die Index-Diagnose. noindex, Canonical, robots.txt und ein Statuscode abseits von 200 sind typische Gründe, und alle lassen sich mit der URL-Prüfung und der Index-Diagnose prüfen.
- Lies Logs nur mit geprüften IP-Adressen. Mit dem Crawler-Log-Leser siehst du, welche Abrufe echt sind. Bereinige 404-Fehler nach der Search Console.
- Entscheide bewusst über KI-Crawler. Such-Crawler (OAI-SearchBot, PerplexityBot) ermöglichen Quellenangaben in KI-Antworten, Trainings-Crawler (GPTBot, ClaudeBot) betreffen die Nutzung für Modelltraining. Beides sind getrennte Entscheidungen.
- Miss nach vier und nach acht Wochen. Notiere Datum und Änderung, vergleiche Klicks, Impressionen und Position in der Search Console und übertrage, was funktioniert, auf die nächsten Seiten.
Meine Empfehlung daraus: Investiere nicht in Tricks für schnelleres Crawlen. Es ist der Schritt, der ohnehin schnell geht. Investiere in den dritten Schritt, in Inhalte, die auf eine konkrete Suchanfrage besser antworten als die Seiten, die dort heute stehen. Wie der Einstieg in alle drei Felder aussieht, erklärt Was ist SEO?.
Grenzen der Daten
Was die Zahlen nicht können
- Die Auswertung umfasst knapp sechs Tage, eine Domain und 20 neue Beiträge. Das ist ein Beispiel aus der Praxis und keine repräsentative Studie.
- Die URL-Prüfung war nicht zufällig verteilt und kein Experiment. Das Log zeigt nur den Abruf durch das Prüftool und lässt offen, bei welchem Beitrag zusätzlich die Indexierung beantragt wurde. Der Befund betrifft das erste Crawlen, nicht das Ranking, und beweist keine Ursache und Wirkung.
- Als Livegang zähle ich die erste erfolgreiche Antwort im Log. Die Zeiten im Log sind UTC, die Search-Console-Tage richten sich nach Pacific Time, und die letzten Tage sind dort unvollständig.
- Die Durchschnittspositionen beruhen auf wenigen Impressionen pro Tag. Impressionen sind keine Klicks: Auf Position 76 bis 85 steht eine Seite auf Seite 8 oder 9 der Ergebnisse.
- Die IP-Listen haben unterschiedliche Stände (Bing 2024, Perplexity 2025, OpenAI von Januar bis September 2026, Google, Anthropic und Apple Herbst 2026). Anthropic führt alle Bots in einer gemeinsamen Liste. Google-Nutzer-Fetcher und viele andere Crawler sind im Werkzeug nicht geprüft. Dass in einer Stichprobe von 30 Adressen keine einen Reverse-DNS-Eintrag hatte, ist kein Beweis für alle.
- Die Barcelona-Zeitwerte stammen aus einer Mitschrift der Agentur ROAST und aus Berichten darüber, Gary Illyes nennt sie laut Barry Schwartz eine Übung und keine offizielle Statistik. Search Engine Land und Backlinko ließen sich bei der Recherche nicht abrufen und fehlen deshalb. Ein ausgebliebener Fund beweist keine Nichtexistenz.
Häufige Fragen
Wie lange braucht Google, bis es eine neue Seite findet?
Google nennt im Starter-Guide wenige Stunden bis mehrere Monate. In Barcelona fielen laut Mitschrift rund 20 Stunden für eine neue URL. Bei mir kam der echte Googlebot ohne URL-Prüfung im Median nach 19,2 Stunden, mit Prüfung nach 22 Minuten. Gefunden ist aber noch nicht indexiert und schon gar nicht sichtbar.
Muss ich die Indexierung beantragen?
Nein. Google entdeckt Seiten auch über Links und Sitemaps. Bei wichtigen neuen Seiten kann die URL-Prüfung das Crawling beschleunigen, garantiert aber nichts. Mehrere Anfragen für dieselbe URL helfen laut Google nicht.
Woran erkenne ich einen echten Googlebot?
An der IP-Adresse, nicht am Namen. Google beschreibt zwei Wege: die IP mit den veröffentlichten Bereichen abgleichen oder per Reverse-DNS prüfen, ob der Name auf googlebot.com, google.com oder googleusercontent.com endet, und den Namen dann per Vorwärts-Abfrage gegen die IP bestätigen. Der Crawler-Log-Leser oben macht den Abgleich für dein Log.
Blockiere ich mit der robots.txt auch KI-Antworten?
Für Such-Crawler wie OAI-SearchBot ja: Wer ihn sperrt, erscheint laut OpenAI nicht in den ChatGPT-Suchantworten. Wer Googlebot sperrt, bleibt aus dem Index und damit auch aus den KI-Funktionen der Google Suche, die eine indexierte, snippetfähige Seite voraussetzen. Vom Nutzer ausgelöste Abrufe richten sich dagegen nicht unbedingt nach der robots.txt.
Brauche ich als kleiner Shop ein Crawl-Budget-Konzept?
In der Regel nicht. Google richtet die Anleitung an Websites mit über einer Million wöchentlich geänderter oder über 10.000 täglich geänderter Seiten. Für kleine Seiten genügen eine aktuelle Sitemap und der Blick in den Bericht zur Seitenindexierung.
Wie funktioniert SEO in einem Satz?
Google muss deine Seite abrufen, speichern und bei einer passenden Suche zeigen, und nur der erste Schritt lässt sich schnell erzwingen.
Quellen
Alle Quellen habe ich am 05.10. und 06.10.2026 gelesen. Eigene Daten: Server-Logs von seorado.de vom 29.09.2026 bis 05.10.2026 und Google Search Console, Property seorado.de.
- Google Search Central: So funktioniert die Google Suche (Stand der Seite 18.12.2025)
- Google Search Central: Anfragen von Google-Crawlern und -Fetchern überprüfen
- Google: IP-Bereiche der gängigen Crawler (common-crawlers.json)
- Search Console-Hilfe: URL-Prüftool
- Search Console-Hilfe: Bericht Crawling-Statistik
- Google Search Central: Google um erneutes Crawlen deiner URLs bitten (Stand der Seite 31.12.2025)
- Google Search Central: Startleitfaden zur Suchmaschinenoptimierung (Stand der Seite 18.12.2025)
- Google Search Central: Crawling-Budget optimieren (Stand der Seite 16.09.2026)
- Google Search Central: Leitfaden zu Ranking-Systemen (Stand der Seite 18.12.2025)
- Google Search Central: Website für generative KI-Funktionen optimieren (Stand der Seite 15.07.2026)
- Google Search Central auf YouTube: Google crawlers behind the scenes (Search Off the Record, 12.03.2026)
- Google Search Central auf YouTube: Do sitemaps still matter? (Search Off the Record, 01.10.2026)
- Google Blog: AI in Search is driving more queries and higher quality clicks (06.08.2025)
Search Central Live Barcelona und Fachmedien
- ROAST: Google Search Central Live Deep Dive, Barcelona, Day 3 Recap (02.10.2026, Mitschrift einer Agentur)
- Search Engine Journal: Google Shows How Long Crawling, Indexing & Recovery Can Take (04.10.2026)
- Search Engine Roundtable: Google Search Data On Crawling, Indexing & Serving Timelines (05.10.2026)
- Search Engine Roundtable: Google Updates Its Optimize Your Crawl Budget Document (22.07.2026)
- Search Engine Journal: 81.8% Of My „AI Assistant“ Traffic Was Fake. The Googlebot Number Was Worse (Duane Forrester, 25.06.2026)
Crawler-Betreiber und Protokolle
- Anthropic: Does Anthropic crawl data from the web, and how can site owners block the crawler? (Stand der Seite 07.04.2026) und bots.json (Stand 02.10.2026)
- OpenAI: Overview of OpenAI Crawlers
- Perplexity: Perplexity Crawlers
- Cloudflare: Perplexity is using stealth, undeclared crawlers to evade website no-crawl directives (04.08.2025, Beobachtung des Anbieters)
- IndexNow.org und FAQ
Studien zur KI-Suche
- arXiv 2608.18352: AI in Search Reduces Publisher Referrals Without Improving User Experience (Preprint, 18.08.2026)
- Pew Research Center: Google users are less likely to click on links when an AI summary appears in the results (22.07.2025)
- Seer Interactive: AIO Impact on Google CTR: 2026 Update (24.04.2026, Agenturdaten)
Praktiker und Communities
- LinkedIn: Mohib Khan zur Prüfung von KI-Crawlern (02.10.2026)
- LinkedIn: Mathias Goldhan zur Indexierung eines neuen Clusters (18.08.2026)
- Reddit r/TechSEO: Fixed a crawl budget issue that was quietly tanking our indexing for months (21.09.2026)
- Reddit r/SEO: Problem with Request Indexing in GSC (04.09.2026)
Geschrieben von
Mario WormuthSEO, GEO und KI-Automatisierung für Online-Shops. Ich teste, worüber ich schreibe, zuerst auf eigenen Seiten und in Kundenprojekten wie RYMHART und Opal-Schmiede.
Das für deinen Shop umsetzen?
Drei Fragen, sofort eine Einschätzung, danach drei konkrete Punkte von mir persönlich. Kostenlos.
Weitere Artikel
aus dem Magazin.
Alle Artikel
Relaunch-Tagebuch: seorado.de von WordPress auf statisch
Ich ziehe für meine Kunden Shops um: RYMHART von PrestaShop auf Shopify, Opal-Schmiede von Gambio auf Shopware. Im September 2026 war meine eigene Seite dran. seorado.de lief bisher auf WordPress mit …
Google Search Console: URL einreichen und Indexierung beantragen
Eine neue Kategorieseite ist online, ein Produkttext überarbeitet oder ein versehentliches noindex endlich weg. Jetzt soll Google die Seite sehen. Dafür gibt es in der Google Search Console die URL-Prüfung mit der …
URLs aus Google entfernen: Search Console, 410 und noindex
Eine Seite soll aus der Google-Suche verschwinden? Dafür hast du mehrere Werkzeuge. Das Entfernen-Tool der Search Console blendet eine URL schnell aus, aber nur für etwa sechs Monate. Dauerhaft verschwindet sie …