Start / Magazin / Relaunch & Technik
Screaming Frog Alternativen im Test: 41 Fehler, 8 Crawler
ArtikelRelaunch & Technik07.10.2026/img/magazin/screaming-frog-alternativen-crawler-test-2026.webp Mario WormuthSEO, GEO & KI-Automatisierung
49 Min. Lesezeit
Das Wichtigste auf einen Blick
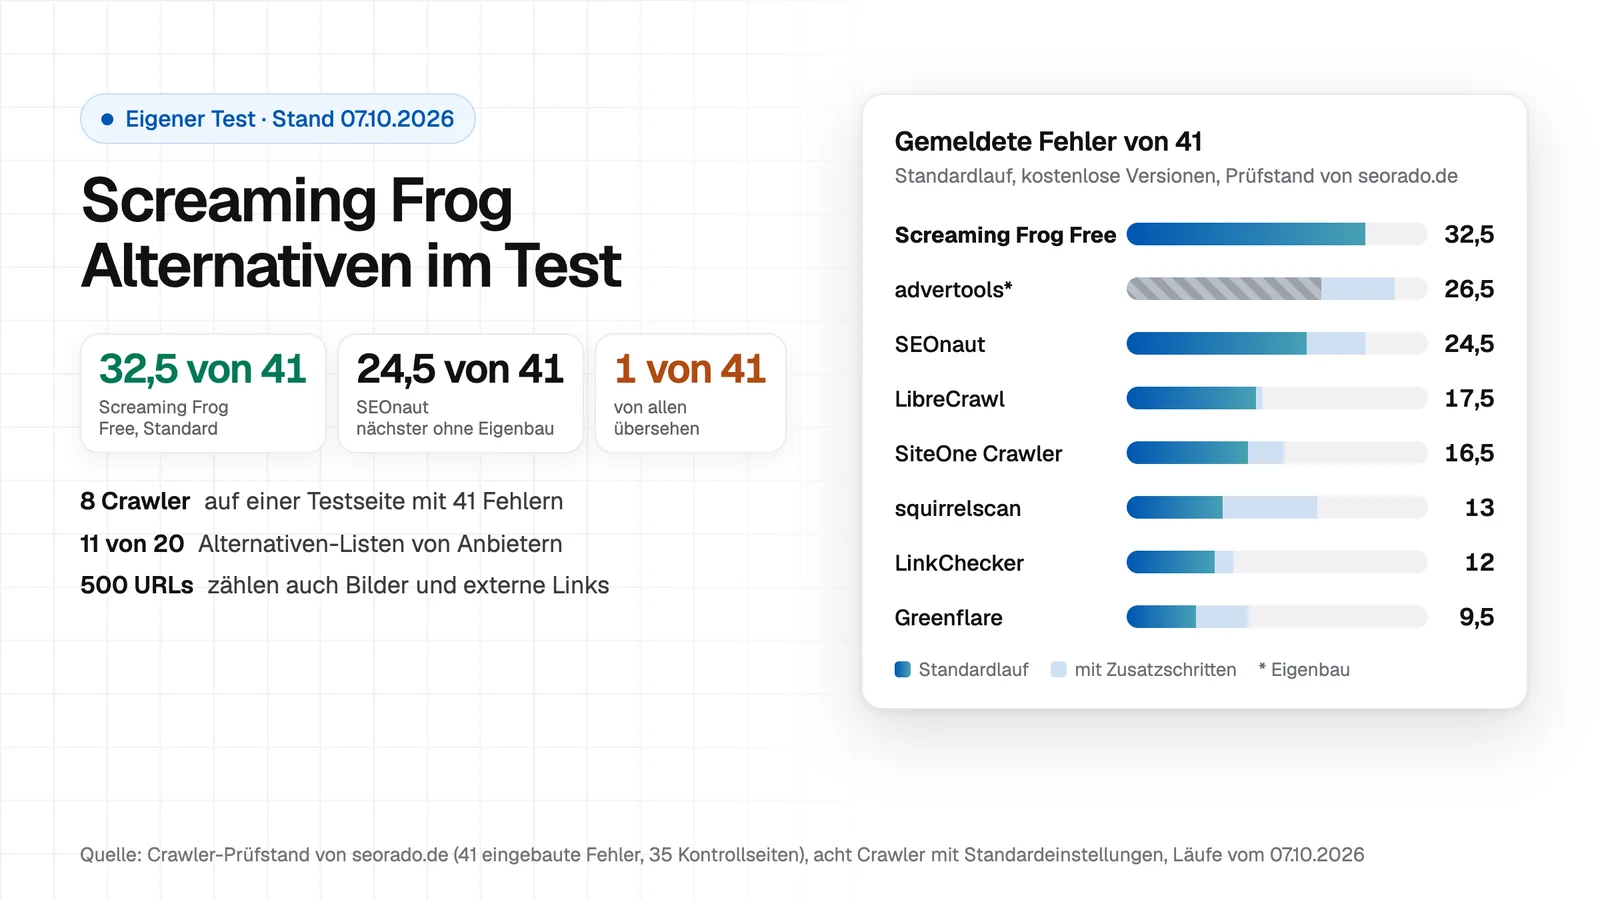
- Screaming Frog Free ist die vollständigste kostenlose Wahl. Im Standardlauf meldet es 32,5 von 41 eingebauten Fehlern, ohne Anmeldung. SEOnaut kommt auf 24,5, LibreCrawl auf 17,5, SiteOne auf 16,5, squirrelscan auf 13, LinkChecker auf 12 und Greenflare auf 9,5.
- Die 500-URL-Grenze zählt mehr als Seiten. In meiner Messung füllten die 105 HTML-Seiten von seorado.de die 500 URLs mit 225 Bildern, 20 Skript- und Stildateien, einem Video und 149 externen Links. Ahrefs Free zählt dagegen nur interne HTML-Seiten mit Status 200 und erlaubt 5.000 je Projekt und Monat.
- Mit Zusatzschritten rücken die Alternativen auf. SEOnaut erreicht mit den richtigen Optionen 32,5, squirrelscan mit voller Abdeckung 26. Screaming Frog Free hat keinen Zusatzschritt, weil die Konfiguration in der kostenlosen Version gesperrt ist.
- Nicht jeder gemeldete Fehler ist ein Problem. Für 29 der 41 Fehler nennt Googles Dokumentation eine Wirkung, für 9 gibt es keine Regel, für 3 nur einen Teilaspekt. Titellänge, Anzahl der H1 und doppelte Meta-Beschreibungen sind Faustregeln der Werkzeuge, keine Google-Vorgaben.
- Alternativen-Listen sind oft Eigenwerbung. Von 20 geprüften Seiten stammen 11 von Anbietern, 11 nennen die 500-URL-Grenze, nur eine erklärt, dass auch Bilder, CSS und JavaScript zählen.
- Die Rangliste aller 19 Werkzeuge: Platz 1 Screaming Frog (7,4 von 9 Punkten), Platz 2 Ahrefs Free (6), Platz 3 LibreCrawl (5,8), Platz 4 SEOnaut (5,3). Mein Prüfstand zählt dreifach, nicht getestete Werkzeuge erreichen höchstens 6 Punkte.
- Meine Empfehlung: Starte mit Screaming Frog Free, solange deine Seite unter etwa 100 Seiten liegt. Für größere eigene Seiten nimm Ahrefs Free mit verifizierter Domain, wenn du im Browser arbeiten willst, oder SEOnaut, wenn du Docker kennst. Eine Lizenz (£199, €245 oder $279 im Jahr) lohnt, sobald du JavaScript-Rendering, den Sitemap-Abgleich oder mehr als 500 URLs brauchst.
Inhaltsverzeichnis14 Abschnitte
- Alternativen-Listen: Wer schreibt sie eigentlich?
- Der Prüfstand: 41 Fehler, 35 saubere Seiten
- Ergebnis: Wer meldet was?
- Was Google dazu sagt: Nicht jeder Fund ist ein Problem
- Die 500-URL-Grenze: Was zählt wirklich?
- Die Rangliste: 19 Crawler im Überblick
- Welcher Crawler passt zu dir?
- Was Praktiker sagen
- So startest du in zehn Minuten
- Meine Empfehlung
- Grenzen der Daten
- Häufige Fragen zu Screaming Frog und seinen Alternativen
- Fazit
- Quellen
Wer am 07.10.2026 bei Google nach „screaming frog alternativen“ sucht, landet bei gut jedem zweiten Treffer bei Anbietern. Von 20 Vergleichsseiten, die ich dazu geprüft habe, stammen 11 von Herstellern eines Crawlers oder eines verwandten Dienstes. Sechs von ihnen stellen sich in ihrer eigenen Rangliste selbst auf, viermal auf Platz 1. Bei Sebastian Kraus stand am selben Tag eine Spaßseite von Screaming Frog selbst auf Platz 1: ein Vergleich mit Brüllaffen und Knallkrebsen, den der Hersteller schon am 30.05.2024 veröffentlicht hat.
Ich wollte deshalb nicht noch eine Liste schreiben, sondern messen. Ich habe eine Testseite gebaut, den Crawler-Prüfstand: ein kleiner, erfundener Wollshop mit 119 abrufbaren Adressen, 41 absichtlich eingebauten SEO-Fehlern und 35 sauberen Kontrollseiten. Darauf habe ich acht Crawler mit ihren Standardeinstellungen laufen lassen und gezählt, welche der 41 Fehler sie melden: Screaming Frog in der kostenlosen Version, SEOnaut, LibreCrawl, SiteOne Crawler, squirrelscan, Greenflare, LinkChecker und advertools.
Das Ergebnis: Screaming Frog Free meldet 32,5 von 41 Fehlern, ohne dass du etwas einstellst. Danach folgen im Standardlauf SEOnaut mit 24,5 und LibreCrawl mit 17,5 (mein Python-Eigenbau advertools liegt mit 26,5 dazwischen, zählt aber nicht mit, weil ich die Fehlerliste kannte). Wer die Zusatzschritte der anderen Werkzeuge kennt, holt aus SEOnaut ebenfalls 32,5 heraus. Ein einziger Fehler blieb im Standardlauf bei allen acht unentdeckt: ein Link, den erst JavaScript erzeugt. Dazu kommt ein Befund, den fast keine Vergleichsliste erwähnt: Die Grenze von 500 URLs in der kostenlosen Version von Screaming Frog zählt jede abgerufene Adresse, also auch Bilder, Skripte und externe Links.
Bei Aufbau der Testseite, den Läufen und beim Lesen der Herstellerseiten hat mir KI geholfen (Claude Code). Sie hat die Crawler installiert und gestartet, die Ausgaben gegen die Fehlerliste geprüft, die Preis-, Hilfe- und Dokumentationsseiten der Anbieter und von Google gelesen und jedes Zitat per Skript gegen den gespeicherten Rohtext verglichen. LinkedIn und X habe ich mit KI-Hilfe über meinen Browser gelesen, die X-Suche war an diesem Tag nicht erreichbar. Alle Läufe habe ich mit den kostenlosen Versionen gemacht. Wie ich bewerte und was ich empfehle, ist meine Einschätzung.
Lieber ansehen als lesen? Das Erklärvideo fasst die Befunde in gut anderthalb Minuten zusammen.
Transkript des Videos lesen
Wer nach Screaming Frog Alternativen sucht, landet meist bei Anbietern. Von 20 geprüften Seiten stammen elf von Anbietern, sechs setzen sich selbst in die Rangliste, viermal auf Platz eins. Darum habe ich nicht verglichen, sondern gemessen. Mit KI-Unterstützung habe ich eine Testseite gebaut: ein erfundener Wollshop mit 41 eingebauten Fehlern und 35 sauberen Seiten. Darauf liefen acht Crawler mit Standardeinstellungen. Das Ergebnis: Screaming Frog Free meldet 32,5 von 41 Fehlern, ohne Anmeldung. SEOnaut kommt auf 24,5, LibreCrawl auf 17,5. Der Python-Eigenbau liegt bei 26,5, zählt aber nicht mit. Mit den richtigen Optionen holt SEOnaut ebenfalls 32,5 heraus. Ein Fehler blieb bei allen unentdeckt: ein Link, den erst JavaScript erzeugt. Die Grenze von 500 URLs zählt jede Adresse. Bei seorado.de füllten 105 Seiten sie mit Bildern, Skripten und externen Links. Ahrefs Free zählt nur HTML-Seiten, 5.000 pro Projekt und Monat. Meine Empfehlung: Starte mit Screaming Frog Free, solange du unter etwa 100 Seiten bleibst. Für größere eigene Seiten nimm Ahrefs Free, mit Docker SEOnaut. Eine Lizenz lohnt bei JavaScript, Sitemap-Abgleich oder mehr als 500 URLs. Und arbeite die Funde in der Reihenfolge ab, die Googles Dokumentation hergibt.
Alternativen-Listen: Wer schreibt sie eigentlich?
Bevor ich die Crawler getestet habe, wollte ich wissen, worauf sich ein Leser bei der Suche verlassen kann. Ich habe 20 Seiten gesammelt: die neun und neun organischen Treffer meiner beiden Google-Suchen („screaming frog alternativen“ und „screaming frog alternative“, google.de, 07.10.2026, in meinem Chrome; fünf Seiten standen in beiden Suchen, zusammen 13) und sieben weitere Listen, die DuckDuckGo zur selben Frage lieferte. Zu jeder Seite habe ich festgehalten, wer sie veröffentlicht, ob das eigene Produkt in der Liste steht, was sie zur kostenlosen Version von Screaming Frog sagt und ob es Hinweise auf Partnerprovisionen gibt. Alle Zitate habe ich gegen die gespeicherten Seiten geprüft.
Das Bild ist eindeutig. 11 der 20 Seiten kommen von Anbietern: acht von Herstellern eines Crawlers oder SEO-Tools, drei von Anbietern eines verwandten Dienstes. Dazu kommen fünf Vergleichsportale, zwei Redaktions- und Bildungsseiten, ein Forum und die Seite von Screaming Frog selbst. Sechs Anbieter führen sich in ihrer Rangliste selbst auf, und zwar auf den Plätzen 1, 1, 1, 1, 4 und 6, im Mittel auf Platz 2,3. Neun der 20 Seiten bewerben ein eigenes Produkt. Das ist legitim, solange es offen steht. squirrelscan nennt sein Produkt in der Liste ausdrücklich „Ours“, das ist ein faires Beispiel. Bei einem Vergleich, der Rankings versprechen soll, solltest du aber wissen, wer da vergleicht.
| Herausgeber | Seiten | nennen die 500-URL-Grenze |
|---|---|---|
| Anbieter eines Crawlers oder SEO-Tools | 8 | 6 |
| Anbieter eines verwandten Dienstes | 3 | 3 |
| Vergleichsportal oder Verzeichnis | 5 | 2 |
| Redaktions- oder Bildungsseite | 2 | 0 |
| Forum | 1 | 0 |
| Screaming Frog selbst (Spaßseite) | 1 | 0 |
Sechs Anbieter führen sich selbst in ihrer Rangliste auf, im Mittel auf Platz 2,3:
- crawlraven.comPlatz 1 von 9
- librecrawl.comPlatz 1 von 10
- prerender.ioPlatz 1 von 12
- searchatlas.comPlatz 1 von 29
- chatseo.appPlatz 4 von 6
- squirrelscan.comPlatz 6 von 6
Nur eine der 20 Seiten (Search Atlas) schreibt dazu, dass auch Bilder, CSS und JavaScript zählen. Zwei Seiten tragen belegbare Affiliate-Links (Credo, AnswerIQ), drei weitere weisen auf Vergütung oder Anzeigen hin (OMT, Tolodora, DataStackHub). Stichprobe, keine Marktübersicht.
Wichtiger für deine Entscheidung ist ein anderer Befund. 11 der 20 Seiten nennen die Grenze von 500 URLs, aber nur eine, die von Search Atlas, schreibt dazu, dass auch Bilder, CSS und JavaScript mitzählen. Genau dieser Punkt entscheidet, ob die kostenlose Version für deine Seite reicht. Dazu unten mehr. Und von den zehn Seiten, die einen Preis für Screaming Frog nennen, stimmen sieben mit der Herstellerseite überein (£199, €245 oder $279 pro Lizenz und Jahr). Drei weichen ab, eine davon nennt fünf verschiedene Beträge auf derselben Seite.
Die Parodie von Screaming Frog ist übrigens der ehrlichste Beitrag in dieser Reihe. Sie beginnt mit „we’re probably not the best people to offer an impartial review“ und vergleicht den SEO Spider mit Brüllaffe, Pistolenkrebs und anderen lauten Tieren. Tabellen mit Preisen oder Limits enthält sie nicht. Wie wirksam so etwas bei Google ist, zeigt ein Test von Jan-Willem Bobbink vom 23.09.2026. Er stellte eine absichtlich unsinnige „GSC Wizard Alternatives“-Seite ins Netz und schreibt, sie habe nach 36 Stunden auf Platz 1 gestanden, „and ChatGPT also seems to like it“. Unter dem Beitrag kommentierte Dan Sharp, Mitgründer von Screaming Frog, „Heheh. brilliant“. Das ist eine Einzelbeobachtung eines Praktikers, keine kontrollierte Messung, aber sie erklärt, warum ich Rankings der Listen nicht als Qualitätssignal nehme.
Der Prüfstand: 41 Fehler, 35 saubere Seiten
Ein Crawler ist ein Programm, das deiner Website folgt wie der Googlebot, jede Seite abruft und aufschreibt, was es dort findet. Ein SEO-Crawler zeigt dir dann Probleme: tote Links, fehlende Titel, falsche Weiterleitungen. Um zu messen, welcher das zuverlässig tut, braucht man eine Seite, bei der man die richtige Antwort kennt. Auf echten Websites kennst du sie nie vollständig, deshalb habe ich eine gebaut.
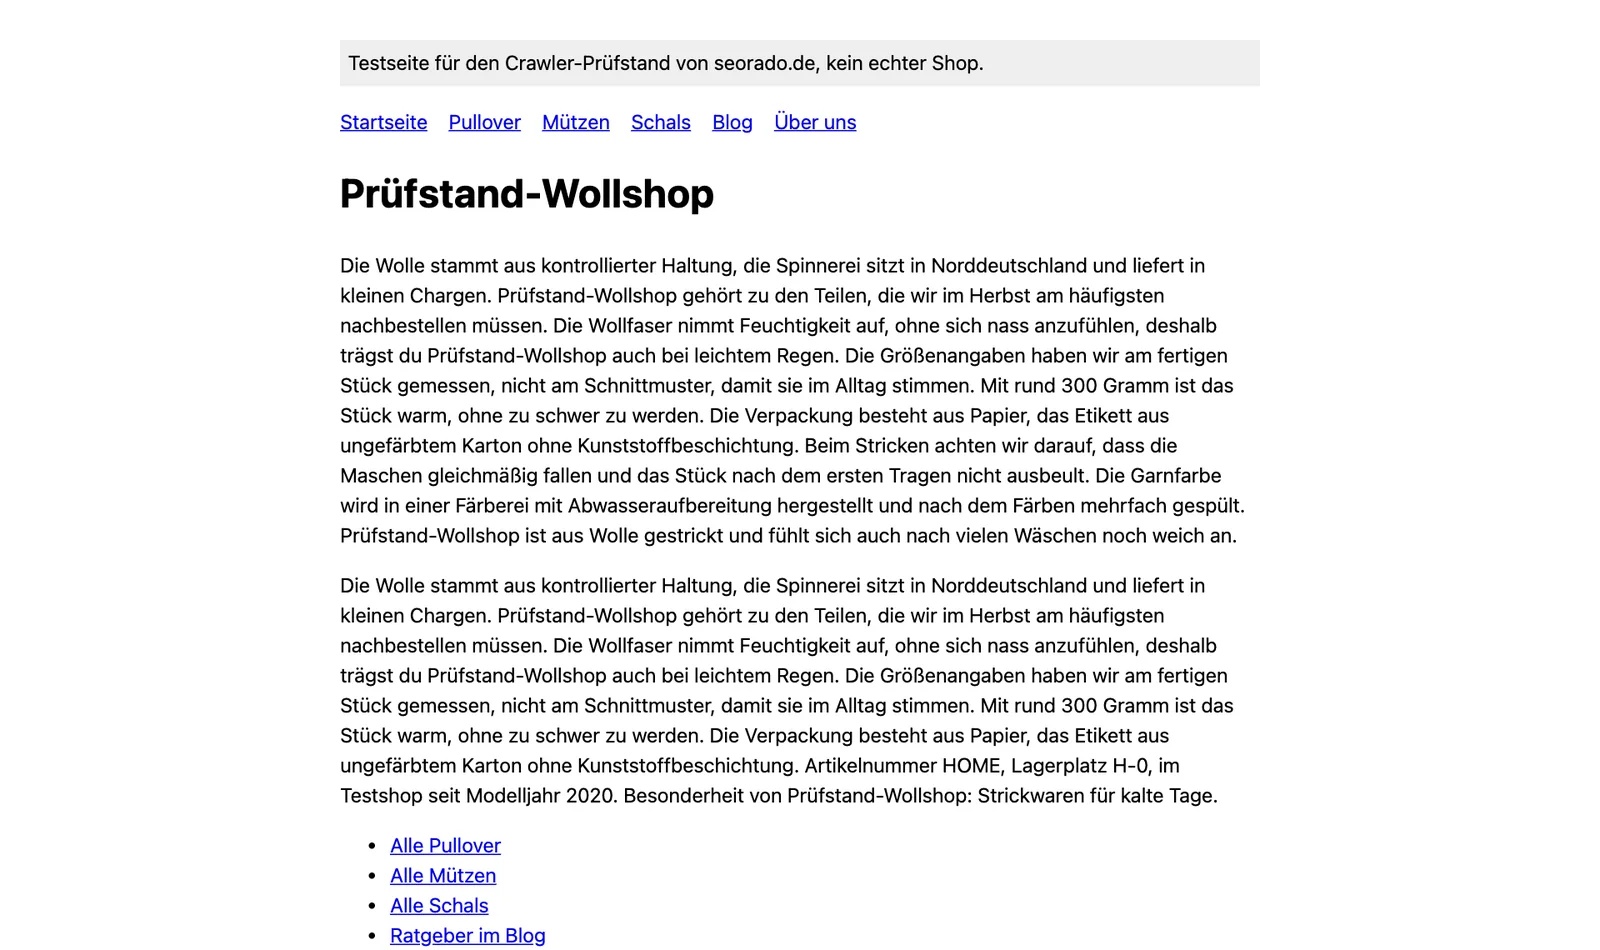
Der Prüfstand ist ein erfundener Wollshop („Prüfstand-Wollshop“) mit 3 Kategorien, 32 Produktseiten, 10 Blogartikeln und ein paar Infoseiten. Er läuft auf meinem Rechner, jede Seite trägt den Hinweis, dass es kein echter Shop ist. In diese Seite habe ich 41 Fehler in vier Gruppen eingebaut und für jeden aufgeschrieben, wo er steckt und was ein guter Crawler melden sollte. Alle anderen Seiten sind absichtlich sauber: eindeutige Titel zwischen 30 und 60 Zeichen, eindeutige Beschreibungen zwischen 70 und 155 Zeichen, genau eine H1, Alt-Texte und in der Regel mehr als 200 Wörter.
Die Regeln waren für alle gleich. Jedes Werkzeug startete bei der Startseite, mit den Standardeinstellungen und in der kostenlosen Version, so wie es ein Einsteiger tut. Als Treffer zählt, wenn das Werkzeug die betroffene URL selbst als Problem meldet. Meldet es das Problem nur für einen Teil der URLs, zählt es als „teilweise“ (halber Punkt). Steht die Information nur in einer Datenspalte, ohne dass das Werkzeug sie als Problem benennt, steht dort „nur Rohdaten“: Du müsstest selbst filtern und wissen, wonach du suchst. Dazu kommt „nicht gefunden“ und „nicht möglich“, wenn das Werkzeug die Funktion nicht hat. Wo ein Werkzeug mit zusätzlichen Schritten mehr findet, etwa einer Option, einem Plugin oder eigenem Code, steht das als eigene Zahl daneben und nicht im Standardergebnis.
Ein Wort zur Fairness bei advertools: Es meldet von sich aus keinen einzigen Fehler, sondern liefert Daten. Die 26,5 Punkte stammen aus einer Auswertung, die ich mit KI-Hilfe in 64 Zeilen Python geschrieben habe, nachdem ich die Fehlerliste kannte. Das ist ein Eigenbau und kein Einsteiger-Ergebnis, deshalb kennzeichne ich es überall so. Bei den übrigen Werkzeugen ist der Standardlauf ein echter Einsteigerlauf.
Ergebnis: Wer meldet was?
Die Balken zeigen, wie viele der 41 Fehler jedes Werkzeug im Standardlauf meldet (volle Punkte) und wie weit es mit Zusatzschritten kommt (helle Verlängerung). „Nur Rohdaten“ zählt nicht mit.
- Screaming Frog FreeKonfiguration gesperrt, kein Zusatzschritt möglich32,5 von 41kein Zusatzgewinn
- advertools (Eigenbau)Eigenbau nach der Fehlerliste26,5 von 41mit Zusatzschritten 36,5
- SEOnaut24,5 von 41mit Zusatzschritten 32,5
- LibreCrawl17,5 von 41mit Zusatzschritten 18,5
- SiteOne Crawler16,5 von 41mit Zusatzschritten 21,5
- squirrelscanStandard: nur 25 Seiten (Quick)13 von 41mit Zusatzschritten 26
- LinkChecker12 von 41mit Zusatzschritten 14,5
- Greenflare9,5 von 41mit Zusatzschritten 16,5
Screaming Frog Free führt mit 32,5 Punkten. In der Gruppe Seitenelemente meldet es 12 von 13 Fehlern, bei Statuscodes und Weiterleitungen 11,5 von 12. Schwächer ist es bei Indexierung und Sitemap (5 von 9) und bei Technik und Struktur (4 von 7). Ohne Lizenz fehlen der Sitemap-Abgleich, die Prüfung strukturierter Daten und JavaScript. Die Konfiguration ist gesperrt, deshalb lässt sich dort nichts nachschalten. Zwei Fehler meldet es als einziges Werkzeug: den defekten externen Link und die zu große Bilddatei.
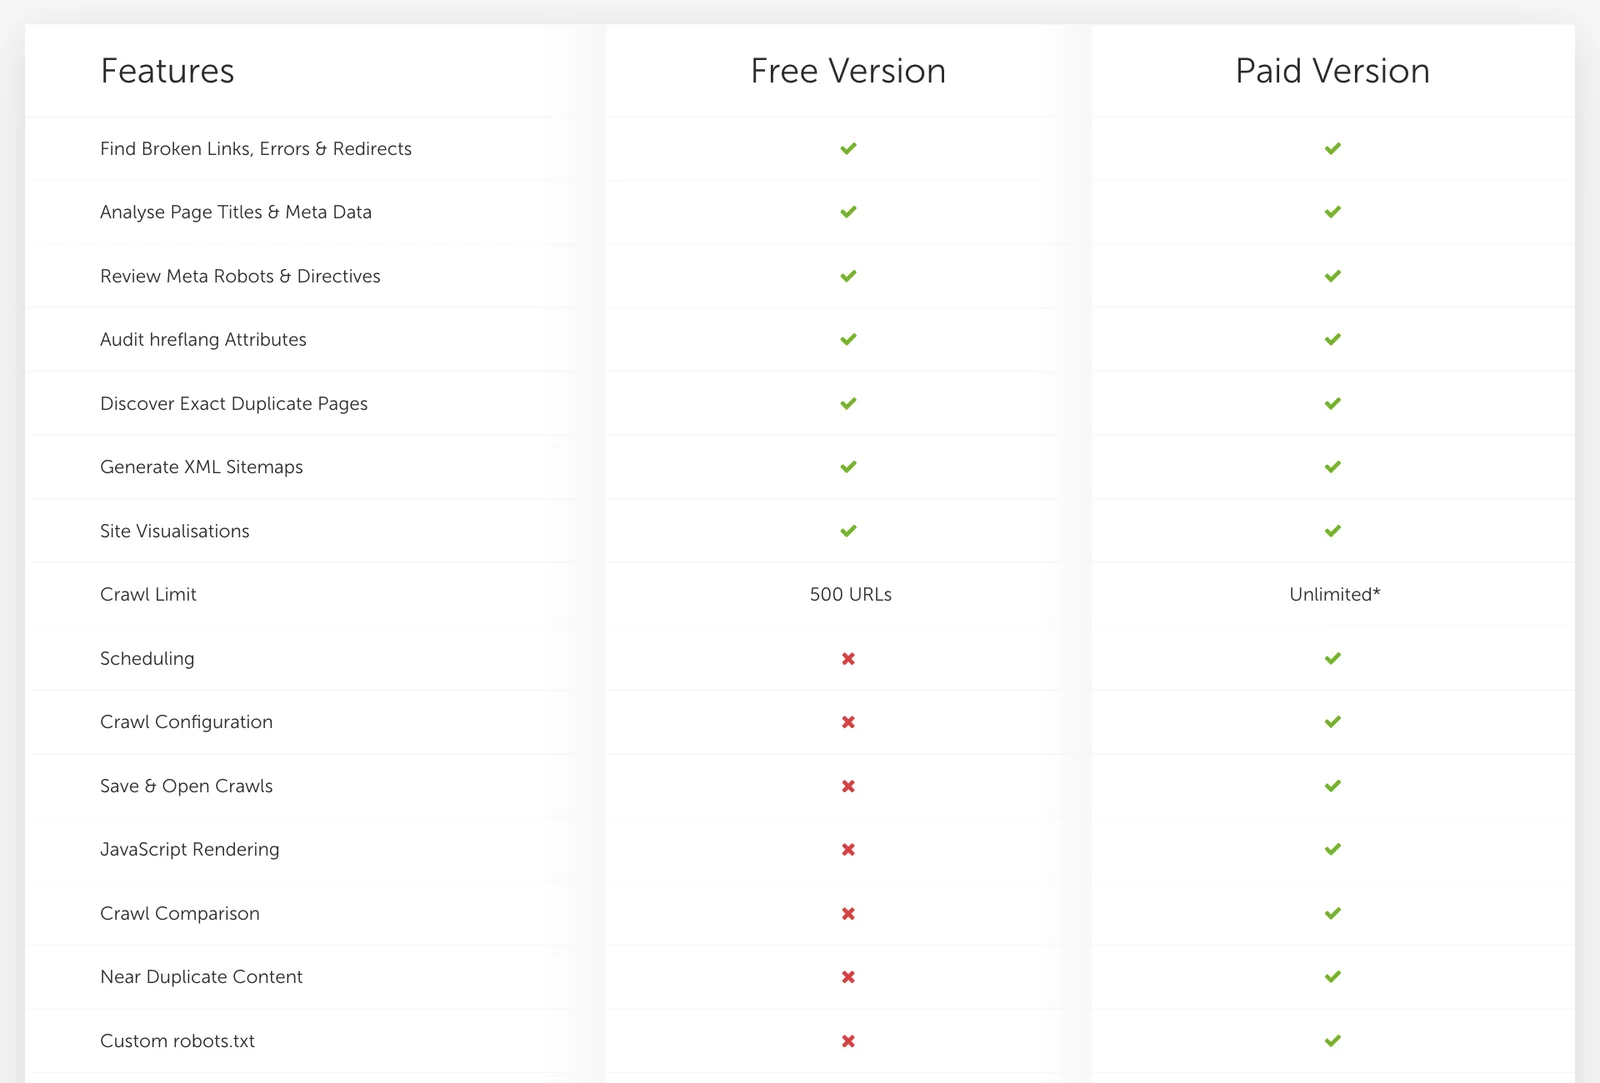
SEOnaut ist die ernsthafteste Open-Source-Alternative. Im Standardlauf sind alle Optionen ausgeschaltet, auch das Lesen der Sitemap, die Prüfung externer Links und der Nachweis von noindex. Mit den richtigen Häkchen kommt es auf 32,5 und damit auf Augenhöhe mit Screaming Frog Free. Der Preis ist der Aufbau: Docker mit MySQL, von „git clone“ bis zum ersten fertigen Crawl vergingen 16 Minuten 25 Sekunden, davon rund 14,5 Minuten Docker-Build. LibreCrawl und SiteOne sind jünger und schwächer: LibreCrawl folgt Weiterleitungen still und zeigt die URL unter dem Status der Zielseite, sodass Ketten, 301 und 302 in keinem Bericht auftauchen. SiteOne nennt Titel- und Meta-Probleme nur als Zähler in der Zusammenfassung, die betroffene Seite steht erst in der Tabelle des HTML-Berichts.
squirrelscan zeigt, wie stark die Voreinstellung das Ergebnis bestimmt. Ohne Anmeldung wählt das Programm automatisch eine „Quick“-Abdeckung: höchstens 25 Seiten aus der Sitemap, keine Linkverfolgung. Das ergibt 13 Punkte. Mit der Option „-C full“ liest es 78 Seiten und kommt auf 26,5. Greenflare liefert Rohdaten statt Prüfungen und liest keine Sitemap, LinkChecker prüft nur Links und lässt Titel, Überschriften und Indexierung aus. Beide gehören zu den Werkzeugen, die ich nicht als Ersatz für einen SEO-Crawler empfehle.
Was auffällt: Nur ein Fehler blieb im Standardlauf bei allen acht Werkzeugen unentdeckt, der Link, den erst JavaScript erzeugt. Mit Zusatzschritten fand ihn LibreCrawl im JavaScript-Modus (141 statt 11 Sekunden Laufzeit) und SiteOne mit angebundenem Browser. Die kostenlose Version von Screaming Frog rendert kein JavaScript. Wenn deine Seite wichtige Links erst im Browser baut, ist das eine echte Lücke. Der Prüfstand zeigt auch, wo Crawler nur Daten statt Befunde liefern: Die Klicktiefe von 9 steht bei Screaming Frog in einer Spalte, der Filter „Pages With High Crawl Depth“ blieb leer.
Im Explorer siehst du alle 41 Fehler mit dem Ergebnis jedes Werkzeugs. Klick auf einen Fehler zeigt dir, wie ich ihn eingebaut habe, was Google dazu sagt, wie du ihn behebst und welcher Rohzeile in den Ausgaben der Treffer entstammt.
Legende: ● gemeldet, ◐ teilweise, ○ nur Rohdaten, ✕ nicht gefunden, ⊘ nicht möglich. Der Standardlauf nutzt nur die Standardeinstellungen. Der Eigenbau mit advertools meldet von sich aus nichts, seine Werte stammen aus meiner Auswertung.
Zwei Beobachtungen stecken in dieser Matrix. Erstens: Wenn du nur ein Werkzeug nutzt, siehst du die Lücken nicht. Der Fehler „Sitemap enthält eine weitergeleitete URL“ wurde im Standardlauf nur von LinkChecker gemeldet, „Sitemap enthält eine noindex-Seite“ nur von squirrelscan. Zweitens: Ein Werkzeug, das viel meldet, ist nicht automatisch hilfreich. Auf den 35 sauberen Seiten meldete squirrelscan auf jeder fehlendes HTTPS und fehlende Social-Tags, LibreCrawl auf 18 „Thin Content“ (Schwelle 300 Wörter) und auf 23 eine zu kurze Meta-Beschreibung (Schwelle 120 Zeichen), und SiteOne warnte vor einer DNS-Analyse für den lokalen Testhost. Solche Hinweise sind keine Fehler des Prüfstands und zum Teil Folge der Testumgebung (http, 127.0.0.1), sie zeigen aber, wie viel Aussortieren dich ein Bericht kostet.
Was Google dazu sagt: Nicht jeder Fund ist ein Problem
Ein Crawler markiert viel, und vieles davon ist Geschmackssache. Damit du weißt, was zuerst dran ist, habe ich zu allen 41 Fehlern die offizielle Dokumentation von Google gelesen (Abruf 07.10.2026). Bei 29 Fehlern nennt Google ausdrücklich eine Wirkung, bei 9 gibt es keine Regel, bei 3 nur einen Teilaspekt. Das ändert die Reihenfolge, in der du Berichte abarbeitest.
Einige Beispiele aus der Dokumentation. Zu langen Titeln schreibt Google, es gebe keine Grenze: „there’s no limit on how long a <title> element can be“, der Titel werde in den Suchergebnissen nur gekürzt dargestellt. Die 60 Zeichen und 561 Pixel sind eine Faustregel der Werkzeuge. Zur Textmenge sagt Googles Einsteigerleitfaden, es gebe kein „magical word count target, minimum or maximum“. 404 und 410 behandelt Google gleich, und die Hilfe zu den Crawling-Statistiken sagt, es sei „not possible, worthwhile, or even desirable to fix all 404 errors“. Anders ist es bei Serverfehlern (5xx): Google drosselt dann das Crawlen der ganzen Website im Verhältnis zur Zahl der Fehler-URLs. Weiterleitungen folgt der Googlebot bis zu zehn Schritten, die Umzugsdokumentation rät aber, Ketten kurz zu halten. Eine Schleife ist ein „Redirect error“. Ein Canonical ist ein starkes Signal, aber keine Anweisung. Eine Sperre in der robots.txt verhindert das Crawlen, nicht die Indexierung, und ein noindex auf einer gesperrten Seite liest Google gar nicht erst. Bei hreflang gilt: Fehlt der Rücklink, werden die Angaben ignoriert.
Daraus habe ich eine Reihenfolge gebaut. Sie ist meine Einschätzung auf Basis der Dokumentation, keine Regel von Google.
| Stufe | Fehler im Prüfstand | Was Google sagt |
|---|---|---|
| 1Zuerst: Seiten, die nicht in den Index kommen oder nicht gelesen werden |
| noindex wird befolgt, ein 5xx bremst das Crawlen der ganzen Website, eine Schleife ist ein „Redirect error“, ein Canonical ist ein starkes Signal. |
| 2Danach: Verschwendung und verwässerte Signale |
| Tote Links sind laut Google nicht automatisch ein Problem, Ketten sollen kurz bleiben, die Sitemap soll nur URLs enthalten, die in der Suche stehen sollen, hreflang braucht Rücklinks. |
| 3Darstellung und Nutzer |
| Fehlende Titel und Beschreibungen ersetzt Google durch Text aus der Seite, du verlierst nur die Kontrolle über die Anzeige. Pflichtfelder bei strukturierten Daten entscheiden über Rich Results (kein Rankingabzug), große Bilder und langsame Antworten betreffen Ladezeit und Crawl-Tempo. |
| 4Faustregeln ohne eigene Google-Regel |
| Längenlimits, H1-Anzahl, doppelte Beschreibungen, Textmenge, Klicktiefe und URL-Form sind Empfehlungen der Werkzeuge oder bestenfalls Empfehlungen von Google, keine Pflicht. |
Dabei fällt auf, wo die Lücken der Werkzeuge liegen. Tote interne Links (404, 410, 500) melden sechs bis sieben der acht Werkzeuge. Bei Fehlern der ersten Stufe, die nicht auffallen, wird es dünn: noindex nur im HTTP-Header melden im Standardlauf nur Screaming Frog, Greenflare und mein Eigenbau mit advertools, ein Canonical auf eine 404-Seite nur Screaming Frog, Greenflare und LinkChecker (als gewöhnlichen toten Link). Die Weiterleitungskette melden nur Screaming Frog, SEOnaut und LinkChecker. Und alles rund um die Sitemap fällt fast überall durch. Wer einen Relaunch macht, findet in meiner Relaunch-Checkliste die passenden Schritte, und die Grundlagen zu Weiterleitungen stehen im Beitrag zur 301-Weiterleitung.
Die 500-URL-Grenze: Was zählt wirklich?
Die kostenlose Version von Screaming Frog crawlt bis zu 500 URLs je Crawl. Was eine „URL“ ist, sagt die Preisseite nicht. Ich habe es gemessen, schon beim Test kostenloser SEO-Tools: Der Crawl von seorado.de brach bei 500 URLs ab, obwohl die Sitemap nur 94 Seiten nennt. Gezählt wurden 351 interne URLs (105 HTML-Seiten, 225 Bilder, 13 JavaScript-Dateien, 7 Stildateien, 1 Video) und 149 externe Links. Bei einem zweiten Projekt aus meinem Umfeld waren es 457 interne URLs (186 HTML-Seiten) plus 43 externe. Beide Male stand im Protokoll „crawled 500 urls“. Das sind Stichproben von zwei Seiten, aber das Muster ist eindeutig: Jede abgerufene Adresse verbraucht das Kontingent, und weil der Crawl bei 500 stoppt, sind die gezählten Werte Mindestwerte.
Andere Werkzeuge zählen anders. Ahrefs verbraucht Crawl-Credits nur für interne HTML-Seiten mit Status 200. Weiterleitungen, Fehlerseiten, Bilder, CSS, JavaScript und externe URLs kosten nichts. Im Free-Konto gelten 5.000 Credits je verifiziertem Projekt und Monat. Bei Semrush (100 Seiten pro Monat im Gratis-Konto), Seobility (100 Seiten je Crawl) und Visual SEO Studio (500 „crawlable pages“) sprechen die Hersteller von Seiten, bei Netpeak Spider, WebSite Auditor und Integrity nennen die Herstellerseiten die Zählweise nicht. Im Rechner kannst du prüfen, ob deine Seite in die jeweilige Grenze passt.
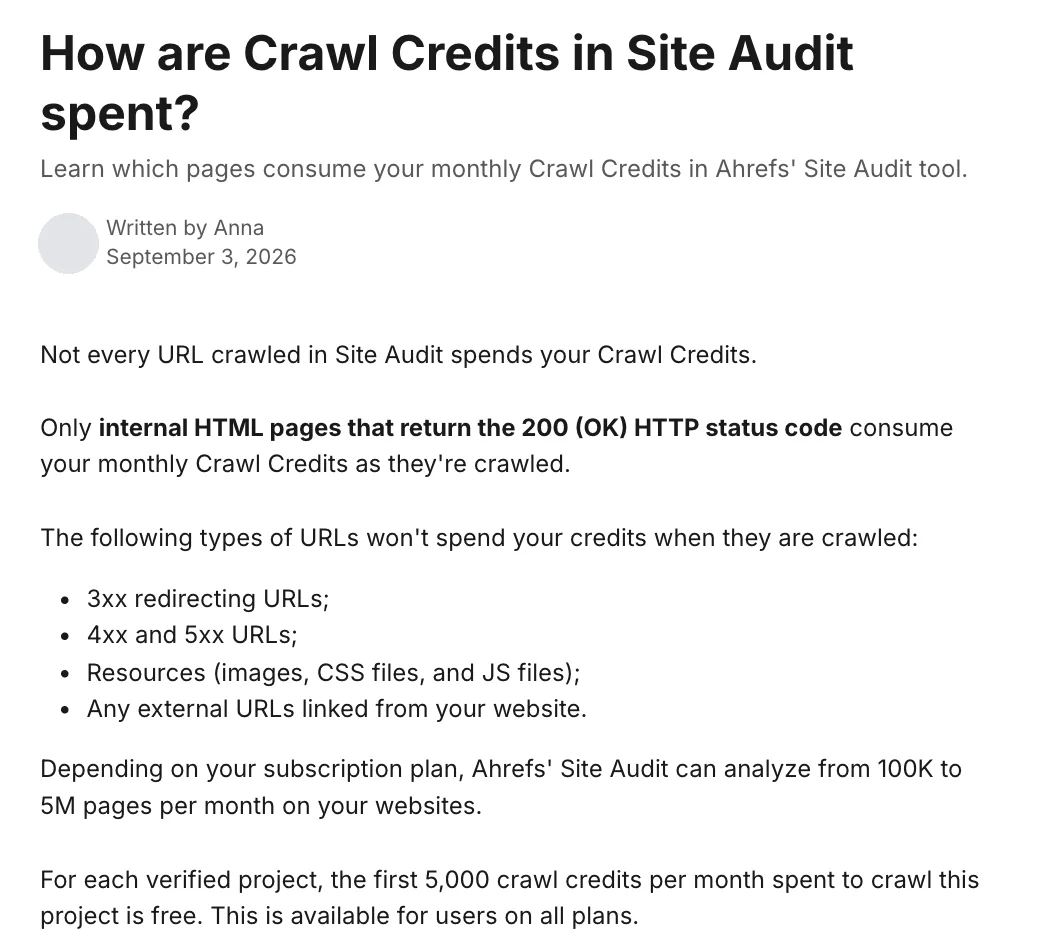
Gemessen bei seorado.de am 06.10.2026: Der Crawl stoppte bei 500 URLs, die Werte sind deshalb Mindestwerte. Wie viele Bilder, Dateien und externe Links dein Crawl abruft, siehst du in einem Probelauf oder in deinem Hosting. Bei Ahrefs zählen laut Hersteller nur interne HTML-Seiten mit Status 200.
Wenn das Limit knapp wird, gibt es einen Ausweg, den ich selbst nachgemessen habe. Screaming Frog kennt einen Sitemap-Modus (Kommandozeile: --crawl-sitemap). In meinem Lauf auf dem Prüfstand wurden dabei nur die 59 URLs der Sitemap gezählt, plus die Sitemap-Datei selbst: 60 URLs, keine Bilder, keine externen Links. Der normale Crawl desselben Prüfstands kam auf 119 URLs, davon 31 Bilder. Der Haken: Der Sitemap-Modus folgt keinen Links. Du siehst dann Titel, Überschriften und Statuscodes der Sitemap-Seiten, aber keine toten Links zwischen Seiten und keine Seiten außerhalb der Sitemap. Für eine Seite mit bis zu 499 Sitemap-URLs ist das eine brauchbare Ergänzung, für eine Link-Prüfung nicht.
Die Rangliste: 19 Crawler im Überblick
Hier sind alle Werkzeuge, die ich geprüft oder wenigstens gelesen habe, als Rangliste mit Nummer, Name und Adresse. Wo es eine Zahl aus dem Prüfstand gibt, steht sie bei der Karte. Die übrigen habe ich nicht getestet, weil sie nur ein Testkonto mit Registrierung anbieten, eine verifizierte Domain brauchen oder nur über eine Oberfläche bedienbar sind, die ich hier nicht automatisieren konnte. Das steht jeweils dabei, und die Preise stammen von den Herstellerseiten (Abruf 07.10.2026, Währung wie dort angezeigt).
So habe ich gerankt: Maximal 9 Punkte aus sieben Kriterien. Dauerhaft gratis nutzbar (1 Punkt), Gratis-Grenze reicht für echte Seiten (1 Punkt bei keiner Grenze oder ab 5.000 Seiten, ½ bei 500, sonst 0), Einstieg ohne Programmieren (1 Punkt für Programm oder Browser, ½ für Docker oder Python-Installation, 0 für reine Kommandozeile), JavaScript-Rendering (1 Punkt in jeder Stufe, ½ erst ab einer bezahlten Stufe), geplante Crawls (1 Punkt), aktiv gepflegt (1 Punkt, ½ unklar, 0 kaum gepflegt) und mein Prüfstand dreifach (3 mal Anteil der gemeldeten Fehler). Nicht getestete Werkzeuge bekommen für den Prüfstand 0 Punkte und können deshalb höchstens 6 erreichen. Die Rangliste bevorzugt Werkzeuge, die du ohne Zahlung nutzen kannst; wer bereit ist zu zahlen, nimmt die Auswahlhilfe weiter unten.
Platz 1 geht mit 7,4 von 9 Punkten an Screaming Frog, vor Ahrefs Free mit 6 Punkten (ohne Prüfstand-Zahl) und LibreCrawl mit 5,8. Das ist ein Modell mit meinen Gewichten, keine Messung: Ein Punkt Unterschied sagt nichts über deine Seite, die Gründe in den Karten schon.
- 1Screaming Frog SEO Spiderscreamingfrog.co.uk/seo-spider · Desktop-Programm500 URLs£199 im Jahr7,4
- 2Ahrefs Free (Site Audit)ahrefs.com/webmaster-tools · Cloud, im Browser5.000 Seiten, eigene Domain€27 im Monat6
- 3LibreCrawllibrecrawl.com · selbst gehostet (Docker), im Browserohne Grenze, Dockerkostenlos5,8
- 4SEOnautseonaut.org · selbst gehostet (Docker), im Browserohne Grenze, Dockerkostenlos5,3
- 5SiteOne Crawlercrawler.siteone.io · Programm ohne Installation (Rust)10.000 URLs, einstellbarkostenlos5,2
- 6Integrity und Scrutinypeacockmedia.software/mac/scrutiny · Mac-Programm (nativ)nur Linkprüfung (Integrity)$149 einmalig5
- 7advertoolsadvertools.readthedocs.io · Python-Bibliothekohne Grenze, Codekostenlos4,9
- 8Semrush Site Auditsemrush.com/siteaudit · Cloud, im Browser100 Seiten im Monat€134 im Monat4,5
- 9Seobilityseobility.net/de/website-audit · Cloud, im Browser100 Seiten je Crawl€59,90 im Monat4,5
- 10WebSite Auditorlink-assistant.com/website-auditor · Desktop-Programm500 URLs, ohne Speichern€149 im Jahr4,5
- 11JetOctopusjetoctopus.com · Cloud, im Browser7 Tage Test€299 im Monat4
- 12Netpeak Spidernetpeaksoftware.com/spider · Desktop-Programm500 URLs, ohne Export$193 im Jahr4
- 13SE Ranking Website Auditseranking.com/website-audit.html · Cloud, im Browser14 Tage Test€109 im Monat4
- 14Sitebulbsitebulb.com · Desktop-Programm und Cloud14 Tage Test€150 im Jahr (Lite)4
- 15Sitecheckersitechecker.pro · Cloud, im Browser14 Tage Test€89 im Monat4
- 16LinkCheckergithub.com/linkchecker/linkchecker · Kommandozeileohne Grenzekostenlos3,9
- 17squirrelscansquirrelscan.com · Kommandozeileanonym nur 25 Seitenkostenlos3,5
- 18Greenflaregithub.com/beb7/gflare-tk · Desktop-Programm (Python)ohne Grenzekostenlos3,2
- 19Visual SEO Studiovisual-seo.com · Desktop-Programm500 Seiten, ohne Konto€149 im Jahr2,5
Unter der Liste folgt je Werkzeug eine Karte in der Reihenfolge der Rangliste, mit Adresse, Preis, Limits, JavaScript, meinem Urteil und den Herstellerseiten als Beleg.
1Screaming Frog SEO SpiderDer Maßstab unter den Desktop-Crawlern: Die Gratis-Version prüft bis 500 URLs, die Lizenz kostet £199 im Jahr.
screamingfrog.co.uk/seo-spider · Screaming Frog (Großbritannien) · 7,4 von 9 Punkten
- Plattform
- macOS, Windows, Linux
- Gratis
- 500 URLs gratis, ohne Registrierung
- Preis
- £199, €245 oder $279 pro Lizenz und Jahr
- Crawl-Umfang
- Gratis 500 URLs je Crawl, mit Lizenz standardmäßig bis 5 Millionen (kein hartes Limit)
- JavaScript
- nur mit Lizenz
- Geplante Crawls
- nur mit Lizenz
Mein UrteilIm Prüfstand der klare Spitzenreiter, und das ohne einen Cent. Zum Lernen und für kleine Seiten ist die Gratis-Version die beste Wahl. Die Grenze von 500 URLs zählt aber jede abgerufene URL, nicht nur Seiten, und die Konfiguration bleibt gesperrt: der Sitemap-Abgleich im Crawl, JavaScript-Rendering und die Soft-404-Texte gibt es nur mit Lizenz.
Punkte: Gratis 1 · Grenze 0,5 · Einstieg 1 · JavaScript 0,5 · Planung 1 · Pflege 1 · Prüfstand 2,4 (Prüfstand zählt dreifach)
Herstellerseiten, Abruf 07.10.2026: Preisseite und Funktionsvergleich · FAQ mit Preisverlauf · Release-Historie
2Ahrefs Free (Site Audit)Bilder, CSS, JavaScript und externe Links kosten kein Kontingent, aber du musst beweisen, dass dir die Domain gehört.
ahrefs.com/webmaster-tools · Ahrefs (Singapur) · 6 von 9 Punkten
- Plattform
- im Browser, keine Installation
- Gratis
- dauerhaft gratis für eigene, verifizierte Websites: 5.000 Seiten je Projekt und Monat
- Preis
- Starter €27 im Monat, Lite €119, Standard €229, Advanced €419 (Euro-Anzeige für Deutschland)
- Crawl-Umfang
- Gratis 5.000 Credits je Projekt und Monat, nur interne HTML-Seiten mit Status 200 zählen; bezahlt Starter 10.000, Lite 100.000 bis Advanced 1,5 Millionen
- JavaScript
- als Option „Execute JavaScript“
- Geplante Crawls
- täglich, wöchentlich oder monatlich
Mein UrteilDer größte Gratis-Spielraum der Cloud-Werkzeuge und für die eigene Seite oft der bequemste Weg, weil nur HTML-Seiten zählen. Fremde Kundenseiten ohne Zugriff lassen sich erst mit einem bezahlten Plan prüfen. Nicht im Prüfstand getestet, weil die Domain verifiziert sein muss. Aus „Ahrefs Webmaster Tools“ wurde zwischen April und September 2026 „Ahrefs Free“.
Punkte: Gratis 1 · Grenze 1 · Einstieg 1 · JavaScript 1 · Planung 1 · Pflege 1 · Prüfstand 0 (Prüfstand zählt dreifach)
Herstellerseiten, Abruf 07.10.2026: Was ist in Ahrefs gratis? · Wofür gehen Crawl-Credits drauf? · Preise
3LibreCrawlNeuer Open-Source-Crawler mit Weboberfläche, der Sitemap und JavaScript beherrscht, aber Weiterleitungen still verschluckt.
librecrawl.com · Open Source (MIT) · 5,8 von 9 Punkten
- Plattform
- macOS, Windows, Linux
- Gratis
- gratis, keine Grenze („Unlimited URLs“ laut Website)
- Preis
- gratis (Spendenaufruf in der README)
- Crawl-Umfang
- laut Website unbegrenzt, Standardtiefe 3 Klicks
- JavaScript
- als Zusatzmodus mit Chromium (im Test 141 statt 10,7 Sekunden)
- Geplante Crawls
- nicht vorhanden
Mein UrteilFolgt Weiterleitungen still und zeigt die URL unter dem Status der Zielseite: Ketten, 301 und 302 tauchen in keinem Bericht auf. Dafür liest es die Sitemap von selbst und rendert JavaScript auf Wunsch. Das Repository hat weder Release noch Tag (Stand: Commit 05a1372 vom 29.09.2026). Der Docker-Build dauerte 7 Minuten 20 Sekunden und das Image belegt 3,66 GB.
Punkte: Gratis 1 · Grenze 1 · Einstieg 0,5 · JavaScript 1 · Planung 0 · Pflege 1 · Prüfstand 1,3 (Prüfstand zählt dreifach)
4SEOnautDie ernsthafteste Open-Source-Alternative im Test: 75 aktive Prüfungen, Weboberfläche, aber Docker und MySQL nötig.
seonaut.org · Open Source (MIT) · 5,3 von 9 Punkten
- Plattform
- macOS, Windows, Linux
- Gratis
- gratis, selbst gehostet, keine Grenze genannt
- Preis
- gratis; Cloud-Version gratis bis 500 URLs, Growth $9 im Monat
- Crawl-Umfang
- selbst gehostet ohne genannte Grenze; Cloud 500 oder 10.000 URLs je Projekt
- JavaScript
- kein JavaScript-Rendering (geprüft)
- Geplante Crawls
- nur in der Cloud-Version Growth
Mein UrteilIm Standardlauf 24,5 von 41, mit den Optionen, die ein Einsteiger erst finden muss, 32,5. Alle Optionen sind ab Werk aus, auch Sitemap, externe Links und noindex. Von git clone bis zum ersten fertigen Crawl vergingen 16 Minuten, davon rund 14,5 für den Docker-Build. Wer ohnehin Docker nutzt, bekommt viel Prüfung für null Euro.
Punkte: Gratis 1 · Grenze 1 · Einstieg 0,5 · JavaScript 0 · Planung 0 · Pflege 1 · Prüfstand 1,8 (Prüfstand zählt dreifach)
Herstellerseiten, Abruf 07.10.2026: GitHub · Cloud-Version
5SiteOne CrawlerBinary laden, ein Befehl, nach etwa einer Minute ein HTML-Bericht mit Qualitätswert, aber Titel- und Meta-Probleme nur als Zähler ohne URL.
crawler.siteone.io · Open Source (MIT) · 5,2 von 9 Punkten
- Plattform
- macOS, Windows, Linux
- Gratis
- gratis, Standard bis 10.000 URLs (einstellbar)
- Preis
- gratis; Hochladen von Berichten auf crawler.siteone.io optional
- Crawl-Umfang
- Standardmäßig bis 10.000 besuchte URLs (einstellbar), kein Gratis-Limit; Standardlauf auf dem Prüfstand: 114 URLs in 13 Sekunden
- JavaScript
- mit --browser und einem installierten Chrome, Chromium, Edge oder Brave (47 statt 13 Sekunden)
- Geplante Crawls
- nicht vorhanden
Mein UrteilVon allen Werkzeugen am schnellsten startklar: eine 10-MB-Datei, keine Abhängigkeiten, ein Assistent mit 11 Voreinstellungen. Stark bei kaputten Links, Bildern, CSS und JavaScript mit Fundstelle, bei robots.txt und bei der Liste der Weiterleitungen samt 302. Ketten, Schleifen, Canonical, Meta-Refresh, Duplikate und Klicktiefe prüft es nicht, die Sitemap liest es nur als Startadresse, und die README auf main beschreibt Prüfungen (--ai-geo), die das Release 2.5.1 vom 27.06.2026 ablehnt. Im Standardlauf 16,5 von 41, mit Browser- und Sitemap-Lauf 21,5.
Punkte: Gratis 1 · Grenze 1 · Einstieg 0 · JavaScript 1 · Planung 0 · Pflege 1 · Prüfstand 1,2 (Prüfstand zählt dreifach)
6Integrity und ScrutinyNur für den Mac, ohne Abo: Einmalkauf statt Jahreslizenz, die Gratis-Stufe prüft nur Links.
peacockmedia.software/mac/scrutiny · PeacockMedia · 5 von 9 Punkten
- Plattform
- macOS
- Gratis
- Integrity gratis als Linkprüfer, ohne Export, Filter und SEO-Prüfungen
- Preis
- einmalig: Integrity Plus $20, Integrity Pro $59, Scrutiny $149 (keine Abos)
- Crawl-Umfang
- Seitengrenze in den Herstellerseiten nicht genannt
- JavaScript
- erst ab Integrity Pro und in Scrutiny
- Geplante Crawls
- geplante Scans nur in Scrutiny
Mein UrteilNicht getestet. Wer auf dem Mac einmal zahlen will statt jährlich, findet hier die Gegenposition zu Screaming Frog: Scrutiny kostet $149 einmalig, der Hersteller vergleicht es selbst mit weniger als einem Jahr Screaming Frog. Die Gratis-Stufe Integrity exportiert nichts und bietet keine SEO-Prüfungen. Version 12.13.0 vom September 2026.
Punkte: Gratis 1 · Grenze 0,5 · Einstieg 1 · JavaScript 0,5 · Planung 1 · Pflege 1 · Prüfstand 0 (Prüfstand zählt dreifach)
7advertoolsEin Crawler als Python-Funktion: liefert Rohdaten, die Prüfungen schreibst du selbst.
advertools.readthedocs.io · Open Source (MIT) · 4,9 von 9 Punkten
- Plattform
- macOS, Windows, Linux
- Gratis
- gratis, Stopp nach x Seiten einstellbar
- Preis
- gratis
- Crawl-Umfang
- Skript, Seitengrenze einstellbar
- JavaScript
- kein JavaScript-Rendering (geprüft)
- Geplante Crawls
- über Skript und Scrapy-Einstellungen
Mein Urteiladvertools meldet von sich aus keinen einzigen Fehler. Mit einer 64-Zeilen-Auswertung kam der Eigenbau im Standardlauf auf 26,5 von 41, mit Zusatzläufen auf 36,5. Fallstricke: Eine Adresse mit Portnummer lieferte zunächst null Zeilen ohne Fehlermeldung, und der Duplikatfilter von Scrapy lässt die Quellen von Weiterleitungen aus den Daten verschwinden. Version 0.18.0 vom 17.06.2026.
Punkte: Gratis 1 · Grenze 1 · Einstieg 0 · JavaScript 0 · Planung 0 · Pflege 1 · Prüfstand 1,9 (Prüfstand zählt dreifach)
8Semrush Site AuditÜber 140 Prüfungen, aber als reiner Crawler-Ersatz teuer: Der Gratis-Zugang endet nach 100 Seiten im Monat.
semrush.com/siteaudit · Semrush · 4,5 von 9 Punkten
- Plattform
- im Browser, keine Installation
- Gratis
- Gratis-Konto: 100 Seiten pro Monat
- Preis
- Plan „SEO“ €134 im Monat, Starter €190, Pro+ €286, Advanced €526
- Crawl-Umfang
- Gratis 100 Seiten pro Monat; Starter (früher Pro SEO Toolkit) 20.000 Seiten je Audit und 100.000 im Monat, Pro+ (Guru) 20.000 je Audit und 300.000 im Monat
- JavaScript
- erst ab Guru bzw. Business (Semrush One: Pro+ oder Advanced)
- Geplante Crawls
- täglich oder wöchentlich
Mein UrteilSinnvoll, wenn Semrush ohnehin im Haus ist. Als Ersatz für Screaming Frog allein rechnet es sich nicht, und JavaScript-Rendering gibt es erst in den höheren Plänen. Nicht im Prüfstand getestet, weil das Gratis-Konto mit 100 Seiten pro Monat und nur öffentlich erreichbaren Domains ungeeignet ist.
Punkte: Gratis 1 · Grenze 0 · Einstieg 1 · JavaScript 0,5 · Planung 1 · Pflege 1 · Prüfstand 0 (Prüfstand zählt dreifach)
Herstellerseiten, Abruf 07.10.2026: Site-Audit-Hilfe · Preise
9SeobilityDas Gratis-Konto crawlte bis zum 15.09.2026 bis zu 1.000 Seiten, heute nennt die Seite 100.
seobility.net/de/website-audit · Seobility (Deutschland) · 4,5 von 9 Punkten
- Plattform
- im Browser, keine Installation
- Gratis
- Gratis-Konto: 100 Seiten je Crawl, nur manuell
- Preis
- Premium €59,90, Professional €99,90, Agentur €209,90 im Monat zuzüglich USt.
- Crawl-Umfang
- Gratis 100 Seiten je Crawl (bis 15.09.2026: 1.000); Premium 25.000, Agentur 100.000
- JavaScript
- in bezahlten Paketen
- Geplante Crawls
- Intervall in Tagen, nur bezahlt
Mein UrteilDie 1.000 Seiten stehen in Archiv-Snapshots von Preisseite und FAQ (zuletzt 15.09.2026), die 100 Seiten auf den heutigen Seiten. Damit fällt das Gratis-Konto für die meisten Shops und Blogs als Crawler aus. Nicht im Prüfstand getestet. Die Hersteller-Seiten widersprechen sich bei der Wartezeit nach einem Crawl (3 oder 7 Tage).
Punkte: Gratis 1 · Grenze 0 · Einstieg 1 · JavaScript 0,5 · Planung 1 · Pflege 1 · Prüfstand 0 (Prüfstand zählt dreifach)
10WebSite AuditorLäuft auf allen drei Systemen, gratis bis 500 URLs, aber ohne Projekte zu speichern.
link-assistant.com/website-auditor · Link-Assistant (SEO PowerSuite) · 4,5 von 9 Punkten
- Plattform
- macOS, Windows, Linux
- Gratis
- 500 URLs ohne Zeitlimit, aber ohne Speichern
- Preis
- Professional €149 im Jahr, Enterprise €359 im Jahr; im Paket SEO PowerSuite ab €349 im Jahr
- Crawl-Umfang
- Gratis 500 URLs, Professional ohne genannte Grenze
- JavaScript
- Einstellung „Execute JavaScript“ genannt, Stufe nicht belegt
- Geplante Crawls
- Scheduler ab Professional
Mein UrteilNicht getestet. Die Gratis-Version ist unbefristet, speichert aber keine Projekte, hat keinen Scheduler und kopiert keine Daten in die Zwischenablage. Die Preisseite wirbt vor allem mit dem Paket; das Einzelprodukt steht weiter unten. Aktuelle Version 4.62.10 vom 06.10.2026.
Punkte: Gratis 1 · Grenze 0,5 · Einstieg 1 · JavaScript 0 · Planung 1 · Pflege 1 · Prüfstand 0 (Prüfstand zählt dreifach)
Herstellerseiten, Abruf 07.10.2026: Preisseite · WebSite Auditor
11JetOctopusFür große Seiten: JavaScript-Rendering in jeder Stufe, Log-Analyse als eigenes Modul, 7 Tage Test mit 10.000 URLs.
jetoctopus.com · JetOctopus · 4 von 9 Punkten
- Plattform
- im Browser, keine Installation
- Gratis
- keine dauerhafte Gratis-Stufe
- Preis
- Growth €299 im Monat bei Jahreszahlung (€399 vierteljährlich), Pro €699 (€949), Ultra €1.359 (€1.799)
- Crawl-Umfang
- Growth 500.000 URLs im Monat, Pro 2 Millionen, Ultra 5 Millionen
- JavaScript
- in allen Stufen
- Geplante Crawls
- in den Preisseiten nicht als Zeile gefunden
Mein UrteilNicht getestet und für kleine Shops und Blogs überdimensioniert. Interessant ab einigen zehntausend Seiten, wenn ein Desktop-Programm an RAM und Laufzeit stößt. Noch am 13.04.2026 kostete eine JavaScript-Seite im Volumenmodell so viel wie zwei HTML-Seiten.
Punkte: Gratis 0 · Grenze 0 · Einstieg 1 · JavaScript 1 · Planung 1 · Pflege 1 · Prüfstand 0 (Prüfstand zählt dreifach)
Herstellerseiten, Abruf 07.10.2026: Preise
12Netpeak SpiderRendert JavaScript schon in der Gratis-Version, erlaubt dort aber weder Export noch Speichern noch Filter.
netpeaksoftware.com/spider · Netpeak Software · 4 von 9 Punkten
- Plattform
- macOS, Windows
- Gratis
- 500 URLs gratis, aber ohne Export und ohne Speichern
- Preis
- $20 im Monat, $193 im Jahr, einmalig $496 (Lifetime)
- Crawl-Umfang
- Gratis 500 URLs und 5 Threads, Pro ohne Grenze
- JavaScript
- auch in der Gratis-Version
- Geplante Crawls
- in den Produktseiten nicht genannt
Mein UrteilNicht getestet. Auf dem Papier der Gegenentwurf zu Screaming Frog: JavaScript-Rendering gratis, dafür kein Export. Wer Ergebnisse weitergeben will, braucht Pro. Der jüngste Eintrag im öffentlichen Changelog stammt vom 10.06.2024, die Preise und die Tabelle Gratis gegen Pro blieben in drei Archiv-Snapshots seit April 2025 gleich.
Punkte: Gratis 1 · Grenze 0,5 · Einstieg 1 · JavaScript 1 · Planung 0 · Pflege 0,5 · Prüfstand 0 (Prüfstand zählt dreifach)
Herstellerseiten, Abruf 07.10.2026: Preise für den Spider · Changelog
13SE Ranking Website AuditNur 14 Tage Test ohne Kreditkarte, danach ab €109 im Monat.
seranking.com/website-audit.html · SE Ranking · 4 von 9 Punkten
- Plattform
- im Browser, keine Installation
- Gratis
- keine dauerhafte Gratis-Stufe
- Preis
- Core €109 im Monat (€87,20 bei Jahreszahlung), Growth €235 (€188)
- Crawl-Umfang
- Core 250.000 Seiten im Monat, Growth 2 Millionen
- JavaScript
- zuschaltbar, Stufe nicht belegt
- Geplante Crawls
- wöchentlich oder monatlich
Mein UrteilNicht getestet. Kein dauerhaft kostenloser Plan. Die Plannamen wechselten zwischen November 2025 und April 2026 von Essential, Pro und Business zu Core und Growth. Der Seitentitel der Audit-Seite nennt „115+ Checks“.
Punkte: Gratis 0 · Grenze 0 · Einstieg 1 · JavaScript 1 · Planung 1 · Pflege 1 · Prüfstand 0 (Prüfstand zählt dreifach)
Herstellerseiten, Abruf 07.10.2026: Preise · Website Audit
14SitebulbHinweise mit Priorität statt Rohdaten, aber keine dauerhafte Gratis-Version: nur 14 Tage Test mit Registrierung.
sitebulb.com · Sitebulb (Großbritannien) · 4 von 9 Punkten
- Plattform
- macOS, Windows
- Gratis
- keine dauerhafte Gratis-Stufe
- Preis
- Lite €150 im Jahr (€15 im Monat), Pro €365 im Jahr (€36 im Monat), Cloud ab €110 im Monat
- Crawl-Umfang
- Lite 10.000 URLs je Audit, Pro 500.000 (einstellbar bis 2 Millionen)
- JavaScript
- in allen Plänen
- Geplante Crawls
- nur Pro und Cloud
Mein UrteilNicht getestet: Der Test ist an eine Registrierung gebunden und läuft nur über die Oberfläche, deshalb habe ich keine Prüfstand-Zahl. Nach Herstellerangaben der nächste Schritt, wenn du Erklärungen statt Tabellen willst (300 und mehr Hinweise in Pro, 100 und mehr in Lite). JavaScript-Rendering ist in jedem Plan dabei, das ist bei Screaming Frog nur mit Lizenz so.
Punkte: Gratis 0 · Grenze 0 · Einstieg 1 · JavaScript 1 · Planung 1 · Pflege 1 · Prüfstand 0 (Prüfstand zählt dreifach)
Herstellerseiten, Abruf 07.10.2026: Preisseite · Cloud-Preise · Release Notes
15Sitechecker14 Tage Test, danach ab €89 im Monat; die Server stehen laut Datenschutzerklärung in Deutschland.
sitechecker.pro · Sitechecker · 4 von 9 Punkten
- Plattform
- im Browser, keine Installation
- Gratis
- keine dauerhafte Gratis-Stufe
- Preis
- Basic €89 im Monat (€75 bei Jahreszahlung), Standard €219, Premium €379
- Crawl-Umfang
- Basic 10.000 Seiten, Standard 50.000, Premium 200.000 je Account
- JavaScript
- in allen Stufen
- Geplante Crawls
- wöchentlich, täglich oder alle 12 Stunden
Mein UrteilNicht getestet. Zahlt sich vor allem aus, wenn Audit, Rank-Tracking und Berichte in einem Werkzeug gewünscht sind. Als Ersatz nur für den Crawler ist es teurer als Screaming Frog.
Punkte: Gratis 0 · Grenze 0 · Einstieg 1 · JavaScript 1 · Planung 1 · Pflege 1 · Prüfstand 0 (Prüfstand zählt dreifach)
Herstellerseiten, Abruf 07.10.2026: Tarife
16LinkCheckerEin reiner Linkprüfer: findet tote Links, Weiterleitungsketten und Ressourcen, nichts zu Titeln oder Überschriften.
github.com/linkchecker/linkchecker · Open Source (GPL) · 3,9 von 9 Punkten
- Plattform
- macOS, Windows, Linux
- Gratis
- gratis, keine Grenze
- Preis
- gratis
- Crawl-Umfang
- keine Grenze genannt
- JavaScript
- „Javascript links are currently ignored“ (Hilfetext)
- Geplante Crawls
- nicht vorhanden
Mein Urteil12 von 41 im Standardlauf, mit Zusatzläufen 15. Der Rest sind Seitenelemente und Indexierung, die ein Linkprüfer nicht kennt. Externe Links prüft er nur mit --check-extern, und je Ziel nennt er nur die erste verlinkende Seite. Einen Pflichtplatz hat er trotzdem: tote Links ohne Programm und ohne Konto zu finden. Version 10.6.0 vom 28.07.2025.
Punkte: Gratis 1 · Grenze 1 · Einstieg 0 · JavaScript 0 · Planung 0 · Pflege 1 · Prüfstand 0,9 (Prüfstand zählt dreifach)
Herstellerseiten, Abruf 07.10.2026: GitHub
17squirrelscan295 Regeln für KI-gestützte Arbeitsabläufe, beachtet robots.txt standardmäßig nicht und bleibt anonym bei 25 Seiten.
squirrelscan.com · Open Source (MIT) · 3,5 von 9 Punkten
- Plattform
- macOS, Linux, Windows
- Gratis
- lokal gratis, ohne Konto; ohne Anmeldung nur „Quick“-Abdeckung mit höchstens 25 Seiten
- Preis
- lokal gratis; Cloud-Funktionen mit Credits (Pro 19 US-Dollar im Monat laut Website)
- Crawl-Umfang
- ohne Anmeldung Quick (25 Seiten), mit Option -C full alle Seiten
- JavaScript
- nur über die Cloud (Anmeldung, Credits)
- Geplante Crawls
- nicht vorhanden
Mein UrteilDie Standardabdeckung ohne Konto ist ein Schnelltest (25 Seiten, keine Linkverfolgung). Erst mit -C full crawlt es tiefer, wertet aber nur 78 von etwa 84 HTML-Seiten aus und erwähnt die Seite mit Serverfehler 500 nirgends. Es ruft vor dem Crawl 28 Entdeckungsabfragen (23 verschiedene Pfade) ab und lädt die Startseite zusätzlich als GPTBot und Claude-User. Version 0.0.105 vom 07.10.2026.
Punkte: Gratis 1 · Grenze 0 · Einstieg 0 · JavaScript 0,5 · Planung 0 · Pflege 1 · Prüfstand 1 (Prüfstand zählt dreifach)
18GreenflareLiefert Rohdaten statt Prüfungen, liest keine Sitemap, und das letzte Release stammt von 2021.
github.com/beb7/gflare-tk · Open Source (GPLv3) · 3,2 von 9 Punkten
- Plattform
- macOS, Windows, Linux
- Gratis
- gratis, keine Grenze genannt
- Preis
- gratis
- Crawl-Umfang
- keine Grenze laut Website-Archiv
- JavaScript
- kein JavaScript-Rendering (geprüft)
- Geplante Crawls
- nicht vorhanden
Mein UrteilNur 9,5 von 41, weil Titel, Meta-Beschreibung und H1 als Rohspalten kommen und nichts als Problem melden. Das letzte Release stammt vom 15.02.2021, der letzte Commit vom 07.07.2023, und greenflare.io zeigt heute nur noch „Nothing has been published here yet“. Die Oberfläche startete auf meinem Mac nicht (tkinter fehlt), der Test lief über die Crawl-Klasse.
Punkte: Gratis 1 · Grenze 1 · Einstieg 0,5 · JavaScript 0 · Planung 0 · Pflege 0 · Prüfstand 0,7 (Prüfstand zählt dreifach)
Herstellerseiten, Abruf 07.10.2026: GitHub (gflare-tk) · PyPI
19Visual SEO StudioGratis und ohne Konto bis 500 Seiten, aber das letzte Release stammt vom 26.02.2023.
visual-seo.com · aStonish Studio (Italien) · 2,5 von 9 Punkten
- Plattform
- macOS, Windows
- Gratis
- Community Edition: 500 Seiten, 2 Verbindungen, ohne Registrierung
- Preis
- Professional €149 pro Jahr und PC, netto
- Crawl-Umfang
- Community 500 Seiten, Professional 150.000
- JavaScript
- in den Produktseiten nicht erwähnt
- Geplante Crawls
- nicht erwähnt
Mein UrteilNicht getestet. Die Download-Seite wirbt mit etwa monatlichen Releases, die Release-Liste endet aber am 26.02.2023. Ob das Produkt weitergepflegt wird, lässt sich aus den öffentlichen Seiten nicht erkennen. Sitemap-Crawl und URL-Listen gibt es erst in der bezahlten Edition.
Punkte: Gratis 1 · Grenze 0,5 · Einstieg 1 · JavaScript 0 · Planung 0 · Pflege 0 · Prüfstand 0 (Prüfstand zählt dreifach)
Herstellerseiten, Abruf 07.10.2026: Editionen im Vergleich · Release Notes
Lumar, Oncrawl und Botify lasse ich bewusst nur am Rand stehen: Sie richten sich laut ihren Websites an große Unternehmen, die Preise gibt es nur auf Anfrage, und die Oncrawl-Preisseite liefert heute einen Fehler 404 und zeigte in den Archivständen vom 06.10.2025 und 14.04.2026 keine Preise. Auch Xenu’s Link Sleuth, ein kostenloser Linkprüfer nur für Windows, wird auf der Herstellerseite zuletzt für 2010 geführt.
Welcher Crawler passt zu dir?
Die Auswahlhilfe sortiert die Werkzeuge nach deinen Vorgaben. Harte Ausschlüsse wie Betriebssystem, Bedienung, Budget und Seitengröße kommen zuerst, danach zählt das Ergebnis aus dem Prüfstand als Bonus oder Malus. Nicht getestete Werkzeuge starten neutral und sind als solche gekennzeichnet. Das ist ein Modell mit meinen Gewichten, keine Messung: Wenn dir JavaScript wichtiger ist als ein hoher Prüfstand-Wert, sieh dir die einzelnen Gründe an.
URLs, die Screaming Frog zählt, rechnet das Modell mit dem Vierfachen der Seitenzahl (vereinfachtes Modell; Messung bei seorado.de: 3,3 interne URLs je HTML-Seite, mit externen Links mindestens 4,8). Nicht getestete Werkzeuge starten neutral bei 50 Punkten, getestete bekommen je nach Prüfstand-Ergebnis bis zu 20 Punkte mehr oder weniger.
Was Praktiker sagen
Zur Frage nach Alternativen gibt es viele Meinungen, aber wenig Messung. Ich habe Reddit (26 Threads vollständig gelesen, 1.537 Kommentare zu 67 Beiträgen abgerufen, 459 davon gelöscht oder entfernt), Hacker News, YouTube, die Shopify Community und LinkedIn durchsucht. Das Bild ist ruhiger als die Listen im Netz.
Die meisten erfahrenen Nutzer halten die Lizenz für günstig. Der meistbewertete Kommentar in einem Thread, in dem der Entwickler von LibreCrawl seine Alternative vorstellt (162 Punkte, 88 Kommentare), nennt 250 Dollar im Jahr „the cheapest subscription on the market in this industry“. Preiskritik kommt fast nur von Entwicklern, die ein eigenes kostenloses Werkzeug bewerben. Gleichzeitig gibt es auffällig viele „Ich habe eine Alternative gebaut“-Beiträge aus 2025 und 2026, die Community reagiert skeptisch und Moderatoren entfernen Werbung. Für kleine Seiten empfehlen mehrere Nutzer die Gratis-Version ausdrücklich, ab einer Seite über 500 URLs gilt die Lizenz als selbstverständlich. Das deckt sich mit meiner Messung: Entscheidend ist, wie schnell die Grenze erreicht ist.
| Quelle | Aussage | Einordnung |
|---|---|---|
| Reddit, u/blmbmj23.12.2025 | „ScreamingFrog is the yearly tax that all professional SEOs must happily pay.“ | Fachleute nehmen den Preis als Pflichtausgabe hin (23 Punkte). |
| Reddit, u/Mikey11818.11.2025 | „$250 a year is like the cheapest subscription on the market in this industry lol“ | Meistbewerteter Kommentar (54 Punkte) unter der Vorstellung von LibreCrawl, widerspricht der Preiskritik des Entwicklers. |
| Reddit, u/Equivalent-Speed-48323.12.2025 | „If you only work with small sites, it's not worth it. But one site over 500 and yeah, it's a no-brainer!“ | Faustregel eines Nutzers: Lizenz erst ab Seiten über 500 URLs. |
| Reddit, u/yekedero11.03.2026 | „Open source is cool, but vibe coded and rough is a hard sell against Screaming Frog's free 500 URL crawl.“ | Für kleine Seiten genügt die kostenlose Stufe, deshalb haben Gratis-Alternativen es schwer. |
| Reddit, u/oslogrolls18.11.2025 | „Screaming Frong or Sitebulb don't see people who only need a crawler for their in-house project (an E-Commerce in our case).“ | Genau die Zielgruppe der Shopbetreiber: wer nur gelegentlich crawlt, findet das Lizenzmodell unpassend. |
| Reddit, u/LongjumpingLab812.03.2026 | „Running an older Mac so been told I need version 19.2 or earlier to work on my system.“ | Mac-Praxis: ein älterer Mac verträgt die aktuelle Version nicht. Nicht geprüft. |
| YouTube, Mehmet Ali Yassıca. 06.10.2026 | 39 eingebaute Fehler, 16 Open-Source-Werkzeuge (13 klassische Crawler mit Standardeinstellungen, dazu KI-Varianten; auf Türkisch, nach Transkript) | Der Parallelversuch zu meinem Prüfstand. Screaming Frog und Sitebulb waren nicht dabei. Aussagen des Sprechers, nicht nachgeprüft. |
| LinkedIn, Chris Long (Nectiv)11.09.2026 | Entity-Map mit dem Screaming-Frog-MCP-Server und Claude (218 Reaktionen, 26 Kommentare); Kommentar von Bree Sharp: Ohne Content-Bereich in der Konfiguration landen Navigation und Footer in der Auswertung (sinngemäß) | MCP, Konfiguration und Custom Extraction sind in der Gratis-Version gesperrt, die Praxisbeispiele laufen mit Lizenz. |
| LinkedIn, Edan Mizrahi15.09.2026 | Claude prüft über MCP generische interne Ankertexte: „Pretty useful tool.“ | Zweites Praxisbeispiel für den MCP-Server, ebenfalls Lizenzfunktion. |
| LinkedIn, Rodrigo Rocco21.01.2026 | „Or a FREE alternative LibreCrawl. I just found it, installed in minutes with Docker“ (Beitrag über Wettbewerbsanalyse für Jobbörsen) | Passt zu meiner Messung: Docker-Aufbau von LibreCrawl in etwa sieben Minuten. |
| X, Ayush K.08.07.2026 | „It already covers nearly 90% of what I used Screaming Frog for“ (751 Aufrufe, keine Antworten) | Eigenwerbung für ein selbst gebautes Gratis-Werkzeug, ohne Belege. |
| Shopify Community20.10.2025 | Hunderte 429-Fehler bei einem Shop mit über 100.000 URLs trotz Crawler-Signatur (sinngemäß) | Betrifft jeden Crawler, auch die Alternativen. |
Auf LinkedIn und X zeigt sich dasselbe Muster. Wer über Screaming Frog schreibt, zeigt meist Funktionen aus der Lizenz: Chris Long von Nectiv baute am 11.09.2026 mit dem neuen MCP-Server und Claude eine Entity-Map (218 Reaktionen), Edan Mizrahi ließ Claude am 15.09.2026 generische interne Ankertexte prüfen. Ein Kommentar von Bree Sharp unter Longs Beitrag erinnert daran, dass Screaming Frog sonst den ganzen Seitenkörper auswertet und du den Content-Bereich in der Konfiguration eingrenzen musst, sonst messen die Cluster deine Vorlage. Beides ist in der Gratis-Version gesperrt, den MCP-Server nennt die Anleitung von Screaming Frog ausdrücklich ein reines Lizenzfeature. Beiträge über Alternativen sind dagegen fast immer Eigenwerbung: Ayush K. schrieb am 08.07.2026 auf X, sein selbst gebautes Open-Source-Werkzeug decke „nearly 90%“ dessen ab, wofür er Screaming Frog genutzt habe (751 Aufrufe, keine Antworten). Ehrliche Erfahrungsberichte wie der von Rodrigo Rocco auf LinkedIn („installed in minutes with Docker“) sind selten. Die X-Suche war an dem Tag nicht erreichbar, die X-Beiträge habe ich über Google-Treffer und Profile gefunden.
In den Fachmagazinen sieht es ähnlich aus. SEO Südwest nennt Screaming Frog am 29.05.2026 in einem Meinungsbeitrag von Christian Kunz als Datenquelle für Crawling-Daten, wenn KI-Assistenten per MCP SEO-Aufgaben übernehmen. Einen Test mit Messung gibt es dort nicht. Einen unabhängigen Crawler-Test mit eigener Messung habe ich in den Medien, die ich durchsucht habe, für 2025 und 2026 nicht gefunden. Search Engine Land war für meinen Abruf gesperrt (Fehler 403). Das ist eine Lücke in meiner Sichtung und kein Beweis, dass es dort nichts gibt.
Den stärksten Vergleichspunkt liefert ein türkischer YouTuber. Mehmet Ali Yassı hat um den 06.10.2026 nach eigener Angabe 39 SEO-Fehler in eine Seite eingebaut und 16 Open-Source-Werkzeuge darauf losgelassen (13 klassische Crawler mit Standardeinstellungen, dazu KI-Varianten), gewertet mit +1 je gefundenem Fehler und -1 je Fehlalarm. Nach seinen Angaben fand der beste klassische Crawler 26 Fehler (mit 5 Fehlalarmen), SiteOne Crawler 15 ohne Fehlalarm, und 9 Fehler entdeckte keiner der 13 klassischen Werkzeuge, darunter Soft 404 und ein ungültiger hreflang-Code. Screaming Frog und Sitebulb gehörten nicht zu seinem Test. Das Video habe ich nur als Transkript gelesen, Testseite und Antwortschlüssel sind nicht verlinkt, deshalb gebe ich nur seine Aussagen wieder. Auffällig ist die Übereinstimmung mit meinem Prüfstand: SiteOne landet bei mir bei 16,5 Punkten im Standardlauf (15 vollständig gemeldete Fehler und 3 Teilfunde), und die Soft 404 fand keines der Werkzeuge als solche.
Ein Punkt betrifft jeden Crawler, auch die Alternativen: Shopify liefert bei großen Shops Fehler 429. In einem Thread der Shopify Community vom 20.10.2025 berichtet ein SEO bei einem Shop mit über 100.000 URLs von hunderten 429-Fehlern an Produkt-URLs, obwohl die von Shopify bereitgestellte Crawler-Signatur gesetzt war. Zwei weitere Threads in der Shopify-Entwickler-Community beschreiben dasselbe. Wenn du einen Shop crawlst, schalte die Geschwindigkeit herunter, soweit dein Werkzeug das erlaubt. In der kostenlosen Version von Screaming Frog geht das nicht (laut Hersteller nur mit Lizenz).
So startest du in zehn Minuten
Damit du nach dem Lesen nicht bei null anfängst, hier der kürzeste Weg zu den Ergebnissen, die in diesem Beitrag zählen. Die Schritte 1 bis 5 folgen dem Handbuch von Screaming Frog (Menüpfade nach Dokumentation), den Export (Schritt 6) und den Befehl habe ich auf dem Prüfstand ausgeführt.
- Programm holen. Lade den SEO Spider auf screamingfrog.co.uk herunter (Windows, macOS, Linux; aktuelle Version 24.3 vom 29.06.2026) und bestätige beim ersten Start die Lizenzvereinbarung. Ohne Lizenz-Schlüssel läuft die Gratis-Version mit 500 URLs.
- Crawl starten. Stelle „Mode“ auf „Spider“, trage deine Startadresse ein und starte. Wenn deine Seite viele Bilder und externe Links hat, brauchst du eventuell den Sitemap-Modus (siehe oben).
- Tote Links finden. Reiter „Response Codes“, Filter „Client Error (4xx)“ und „Server Error (5xx)“. Unten zeigt der Reiter „Inlinks“, welche Seiten auf die defekte URL verlinken. Wähle dort die Seite und korrigiere den Link.
- Weiterleitungsketten finden. Menü „Reports“, „Redirects“, „Redirect Chains“. Der gleichnamige Filter im Reiter „Response Codes“ blieb im Gratis-Lauf leer, der Bericht dagegen zeigte die Kette von /alt/a/ über drei Sprünge bis zum Ziel.
- Titel, Beschreibungen, Überschriften. Reiter „Page Titles“, „Meta Description“ und „H1“ mit den Filtern „Missing“, „Duplicate“ und „Multiple“. Die Längenfilter (60 und 155 Zeichen) sind Faustregeln, keine Google-Regeln.
- Exportieren. Über der Tabelle liegt der Export-Knopf. Im Test funktionierten Exporte in der Gratis-Version auch auf der Kommandozeile.
Auf der Kommandozeile (macOS, Windows und Linux ähnlich) lief im Test dieser Befehl ohne Lizenz. Der Ausgabeordner muss ein absoluter Pfad sein, und die Lizenzvereinbarung muss vorher einmal in der Oberfläche akzeptiert worden sein.
"/Applications/Screaming Frog SEO Spider.app/Contents/MacOS/ScreamingFrogSEOSpiderLauncher" \
  --crawl https://www.beispiel.de/ --headless --output-folder "$HOME/crawl" --overwrite \
  --export-tabs "Internal:All,Response Codes:Client Error (4xx),Page Titles:Missing,Page Titles:Duplicate" \
  --save-report "Redirects:Redirect Chains"
Die Tabellen- und Filternamen stehen in der Oberfläche in deiner Sprache. Auf meinem Mac mit deutscher Systemsprache lief der Aufruf mit „Internal:All“, die englischen Filternamen wie oben funktionierten, nachdem ich die Java-Sprache auf Englisch gestellt hatte (Umgebungsvariable JAVA_TOOL_OPTIONS="-Duser.language=en -Duser.country=GB"). Gibst du einen unbekannten Filter an, listet das Programm die gültigen Namen in der Fehlermeldung auf.
Wenn du den Prüfstand selbst ausprobieren willst, kannst du Quellcode und Fehlerliste herunterladen. Du brauchst nur Node.js.
Start mit node server.mjs 8820, Anleitung in der README. Enthält keine echten Daten.
Meine Empfehlung
Wenn du nur eine Antwort willst: Starte mit der kostenlosen Version von Screaming Frog. Sie hat im Test die meisten Fehler gemeldet, braucht keine Anmeldung und läuft auf Windows, Mac und Linux. Danach entscheidet deine Seite.
- Bis etwa 100 Seiten und kein JavaScript-Menü: Screaming Frog Free reicht. Prüfe mit dem Rechner oben, ob die 500 URLs bei deinen Bildern und externen Links halten, und nutze sonst den Sitemap-Modus.
- Größere eigene Seite, Arbeit im Browser: Ahrefs Free mit verifizierter Domain. Es zählt nur HTML-Seiten (5.000 je Projekt und Monat), rendert auf Wunsch JavaScript und plant Crawls. Fremde Kundenseiten ohne Zugriff gehen damit nicht.
- Du kennst Docker und willst nichts zahlen: SEOnaut. Schalte vor dem ersten Crawl die Optionen für Sitemap, externe Links und noindex ein, dann liegt es im Test auf Augenhöhe mit Screaming Frog Free.
- Du prüfst regelmäßig, brauchst JavaScript-Rendering, Sitemap-Abgleich oder mehr als 500 URLs: Lizenz für Screaming Frog (£199, €245 oder $279 pro Jahr) oder Sitebulb, wenn du Erklärungen mit Priorität statt Tabellen willst (Lite €150 im Jahr, 14 Tage Test). Auf dem Mac gibt es mit Scrutiny ($149, einmalig) die Variante ohne Abo.
- Nicht als Hauptwerkzeug: Greenflare (Rohdaten statt Prüfungen, seit 2021 kein Release), LinkChecker (nur Links), squirrelscan (anonym nur 25 Seiten) und LibreCrawl (verschluckt Weiterleitungen). Das sind Urteile aus meinem Prüfstand, keine Pauschalurteile über die Projekte.
Drei Regeln helfen bei jedem Werkzeug. Nimm das Ergebnis nicht für bare Münze, sondern arbeite es in der Reihenfolge aus dem Abschnitt zu Googles Dokumentation ab. Prüfe, ob dein Werkzeug die Sitemap liest, robots.txt beachtet und JavaScript rendert, bevor du seinem „alles in Ordnung“ traust. Und lass dich von Alternativen-Listen nicht lenken: Teste selbst, auf deiner Seite oder auf dem Prüfstand.
Grenzen der Daten
- Der Prüfstand ist künstlich. Er läuft auf 127.0.0.1 ohne HTTPS, deshalb gehören Hinweise zu fehlendem HTTPS, localhost-Links, Sicherheits-Headern und DNS nicht zu den 41 Fehlern. Die 41 Fehler sind meine Auswahl und zählen jeweils gleich viel. Dass ein Fehler gemeldet wird, heißt nicht, dass das Werkzeug ihn auf jeder echten Seite findet.
- Ich kannte die Fehlerliste. Die Standardläufe sind Einsteigerläufe mit Standardeinstellungen. Die Zusatzschritte (Optionen, Plugins, eigener Code) zeigen, was jemand erreicht, der weiß, wonach er sucht. Der Eigenbau mit advertools wurde nach der Fehlerliste geschrieben und ist deshalb kein fairer Vergleichswert.
- Einstufungen nach Rohzeilen, Grenzfälle einheitlich. Die KI hat jede Einstufung gegen die Ausgabe des Werkzeugs belegt. Wo ein Werkzeug nur Nebensignale liefert oder die Seite nur über ein eigenes Suchmuster trifft, etwa bei Soft 404 (kurzer Titel, wenig Inhalt, Stichwortsuche), habe ich einheitlich „teilweise“ gewertet, auch im Zusatzlauf. Wo das Werkzeug nur die Anzahl nennt und die URL erst in der Tabelle steht, zählt es als gemeldet.
- Einige Werkzeuge liefen nicht über ihre Oberfläche. Die Oberfläche von Greenflare startete auf meinem Mac nicht (tkinter fehlt), der Test lief über die Crawl-Klasse. LibreCrawl wurde über dieselben Schnittstellen wie die Weboberfläche gesteuert, squirrelscan in einer Sandbox ohne Netz außer Loopback. Das Layout der Oberflächen habe ich nicht beurteilt.
- Kommerzielle Werkzeuge sind nicht getestet. Sitebulb, Netpeak, WebSite Auditor, Visual SEO Studio, Integrity, Scrutiny und alle Cloud-Werkzeuge stehen mit Herstellerangaben da, aus den genannten Gründen (Registrierung, Domain-Verifizierung, nur Oberfläche). Dass ich ein Werkzeug nicht gefunden habe, beweist nicht, dass es eine Funktion nicht hat.
- Die Listen-Analyse ist eine Stichprobe. Sie stammt aus einer personalisierten Suche in meinem Chrome am 07.10.2026 und sieben DuckDuckGo-Funden. Ergebnisse unterscheiden sich von Nutzer zu Nutzer: Bei Sebastian Kraus stand die Seite von Screaming Frog bei der deutschen Suche auf Platz 1, bei mir fehlte sie dort und stand bei der englischen Suche auf Platz 6.
- Preise und Limits sind Herstellerangaben vom 07.10.2026. Preisseiten zeigen je nach Standort Pfund, Euro oder Dollar, und nicht jede Seite nennt netto oder brutto. Bei Seobility widersprechen sich FAQ und Preisseite bei der Wartezeit, bei Ahrefs der Export in Produktseite und Hilfe. Die YouTube-Zitate stammen aus automatischen Transkripten.
Häufige Fragen zu Screaming Frog und seinen Alternativen
Ist Screaming Frog wirklich kostenlos?
Ja, bis zu 500 URLs je Crawl und ohne Anmeldung. Laut Herstellerseite fehlen in der Gratis-Version unter anderem die Konfiguration, JavaScript-Rendering, geplante Crawls, das Speichern von Crawls, die Prüfung strukturierter Daten und die Anbindungen an Search Console und Analytics. Die Lizenz kostet £199, €245 oder $279 pro Nutzer und Jahr.
Gibt es eine kostenlose Alternative ohne 500er-Grenze?
Ja, mehrere, aber mit Abstrichen. SEOnaut, LibreCrawl, SiteOne Crawler und squirrelscan nennen keine feste Grenze. Ahrefs Free erlaubt 5.000 Seiten je Projekt und Monat für verifizierte eigene Domains. Im Prüfstand meldete davon SEOnaut am meisten (24,5 von 41, mit Optionen 32,5), danach LibreCrawl (17,5) und SiteOne (16,5).
Reicht die Gratis-Version für einen Online-Shop?
Für einen kleinen Shop mit wenigen Dutzend Seiten ja, für einen Shop mit einigen hundert Produktseiten meist nicht, weil Bilder und Skripte mitzählen. Probiere den Limit-Check mit deinen Zahlen aus. Ein Sitemap-Lauf kann helfen, prüft aber keine Links zwischen Seiten.
Brauche ich JavaScript-Rendering?
Nur wenn wichtige Links oder Inhalte erst im Browser entstehen, etwa ein Menü oder eine Produktliste, die ein Skript nachlädt. Im Prüfstand blieb genau dieser Fall im Standardlauf bei allen acht Werkzeugen unentdeckt. Mit Zusatzschritten fanden ihn LibreCrawl und SiteOne, bei Screaming Frog braucht es dafür die Lizenz.
Ersetzt die Search Console einen Crawler?
Nein. Die Search Console zeigt, was Google gefunden und indexiert hat. Ein Crawler zeigt dir, was auf deiner Seite steht, auch wenn Google es noch nicht gesehen hat, zum Beispiel einen Link auf eine tote Seite oder eine Weiterleitungsschleife.
Welche Alternative passt für den Mac?
Screaming Frog, Sitebulb, Netpeak Spider (ab macOS 13.5), WebSite Auditor, Visual SEO Studio und Scrutiny laufen auf dem Mac, SiteOne als Binary, SEOnaut und LibreCrawl über Docker. Ein Nutzer berichtet auf Reddit, dass ein älterer Mac nur Screaming Frog 19.2 oder früher verträgt und ältere Versionen kosten sollen. Das habe ich nicht geprüft.
Fazit
Für die meisten kleinen Seiten gibt es keine bessere kostenlose Wahl als Screaming Frog, solange die 500 URLs reichen. Wer darüber hinaus will, hat Alternativen, die auf dem Papier viel versprechen und im Test sehr unterschiedlich abschneiden: SEOnaut kommt mit den richtigen Optionen heran, Ahrefs Free zählt am großzügigsten, der Rest ist eher Ergänzung. Wichtiger als der Werkzeugname ist die Reihenfolge, in der du die Meldungen abarbeitest, und dass du weißt, was dein Crawler nicht sieht.
Wenn du die Ergebnisse für deine eigene Seite nachbauen willst, nimm den Prüfstand als Messlatte. Dann weißt du, bevor du einem Bericht vertraust, welche Fehler dein Werkzeug überhaupt melden kann.
Quellen
Hersteller und Dokumentation der Werkzeuge (Abruf 07.10.2026)
- Screaming Frog, Anleitung MCP Server (veröffentlicht 17.03.2026, zuletzt geändert 19.08.2026): Lizenzfeature, läuft nicht in der Gratis-Version
- Screaming Frog: Preise und Funktionsvergleich, FAQ mit Preisverlauf, Handbuch, Release-Historie und die Spaßseite zu Alternativen (30.05.2024)
- Sitebulb: Preise und Cloud-Preise; Netpeak: Preise; WebSite Auditor: Preise; Visual SEO Studio: Editionen; Integrity und Scrutiny: Scrutiny
- Ahrefs: Gratis-Umfang, Crawl-Credits, Preise; Semrush: Site Audit, Preise; Seobility: Preise, FAQ; SE Ranking: Preise; JetOctopus: Preise; Sitechecker: Tarife
- Open Source: SEOnaut, LibreCrawl, SiteOne Crawler, squirrelscan, Greenflare, advertools, LinkChecker
Google-Dokumentation
- HTTP-Statuscodes und Netzwerkfehler, Crawling-Statistiken, Umzug mit URL-Änderungen, Duplikate und Canonical, noindex, robots.txt, hreflang, Titel, SEO-Einsteigerleitfaden
Alternativen-Listen, Praktiker und Community
- Die 20 geprüften Alternativen-Seiten mit Abrufdatum stehen in meiner Rechercheübersicht; genannt sind hier nur die zitierten: Search Atlas (Hinweis auf Bilder, CSS und JavaScript), squirrelscan („Ours“)
- LinkedIn: Jan-Willem Bobbink, 23.09.2026 mit Kommentar von Dan Sharp; Sebastian Kraus, 07.10.2026 (über die LinkedIn-Suche gelesen, der Beitrag hat keine abrufbare Einzeladresse)
- X: Profil von Screaming Frog mit der Ankündigung von Version 24 vom 19.05.2026 (die X-Suche war am 07.10.2026 nicht erreichbar)
- Reddit: r/
TechSEO zur Vorstellung von LibreCrawl , r/SEO, Dezember 2025, r/SEO, März 2026, r/bigseo zu alten Versionen - YouTube: Mehmet Ali Yassı, 39 eingebaute Fehler und 16 Werkzeuge (ca. 06.10.2026); Shopify Community: Thread zu 429-Fehlern, 20.10.2025
Eigene Messung
- Crawler-Prüfstand mit 41 eingebauten Fehlern und 35 Kontrollseiten, acht Crawler mit Standardeinstellungen, Läufe vom 07.10.2026; Screaming Frog 24.3, SEOnaut (Commit 880b312), LibreCrawl (Commit 05a1372), SiteOne Crawler 2.5.1, squirrelscan 0.0.105, Greenflare 0.98.1, advertools 0.18.0, LinkChecker 10.6.0
- Limit-Messung von Screaming Frog Free auf seorado.de und einem zweiten Projekt, 06.10.2026, siehe Test kostenloser SEO-Tools
- Google-Suchen „screaming frog alternativen“ und „screaming frog alternative“ in google.de, 07.10.2026, dazu 20 Alternativen-Seiten mit Herausgeber- und Affiliate-Prüfung
Geschrieben von
Mario WormuthSEO, GEO und KI-Automatisierung für Online-Shops. Ich teste, worüber ich schreibe, zuerst auf eigenen Seiten und in Kundenprojekten wie RYMHART und Opal-Schmiede.
Das für deinen Shop umsetzen?
Drei Fragen, sofort eine Einschätzung, danach drei konkrete Punkte von mir persönlich. Kostenlos.
Weitere Artikel
aus dem Magazin.
Alle Artikel
Wie funktioniert SEO? Was mein Server-Log über Crawler zeigt
93 Prozent der Abrufe, die sich in meinem Server-Log „Googlebot“ nannten, kamen nicht von Google. Von 2.632 Abrufen stammten nur 179 von IP-Adressen, die Google selbst als Crawler-Adressen veröffentlicht. Die …
Relaunch-Tagebuch: seorado.de von WordPress auf statisch
Ich ziehe für meine Kunden Shops um: RYMHART von PrestaShop auf Shopify, Opal-Schmiede von Gambio auf Shopware. Im September 2026 war meine eigene Seite dran. seorado.de lief bisher auf WordPress mit …
Google Search Console: URL einreichen und Indexierung beantragen
Eine neue Kategorieseite ist online, ein Produkttext überarbeitet oder ein versehentliches noindex endlich weg. Jetzt soll Google die Seite sehen. Dafür gibt es in der Google Search Console die URL-Prüfung mit der …