Start / Magazin / GEO & KI-Suche
Entity Authority im Test: Was der EA-Wert wirklich misst
ArtikelGEO & KI-Suche03.10.2026/img/magazin/entity-authority-ea-wert-test.webp Mario WormuthSEO, GEO & KI-Automatisierung
43 Min. Lesezeit
Alles auf einen Blick
- Eine Entität ist für Google eine Person, Firma oder Marke mit eindeutiger Identität. Google nutzt Organization-Markup, um Firmen auseinanderzuhalten, und der KI-Modus greift auf den Knowledge Graph zu. Für die KI-Funktionen braucht es laut Google aber kein spezielles Markup und keine llms.txt.
- „Entity Authority“ ist kein Google-Begriff. Er stammt aus dem Umfeld von Kalicube und Agenturen. Den EA-Wert gibt es seit dem 01.10.2026, Version 2 seit dem 02.10.2026, umgebaut nach diesem Test.
- Version 1 maß vor allem Markup: 94 von 113 Punkten prüfte sie auf der eigenen Startseite, der Knowledge-Graph-Check war in allen 8 Messungen rot, und dieselbe Seite bekam je nach Common-Crawl-Abfrage verschiedene Werte.
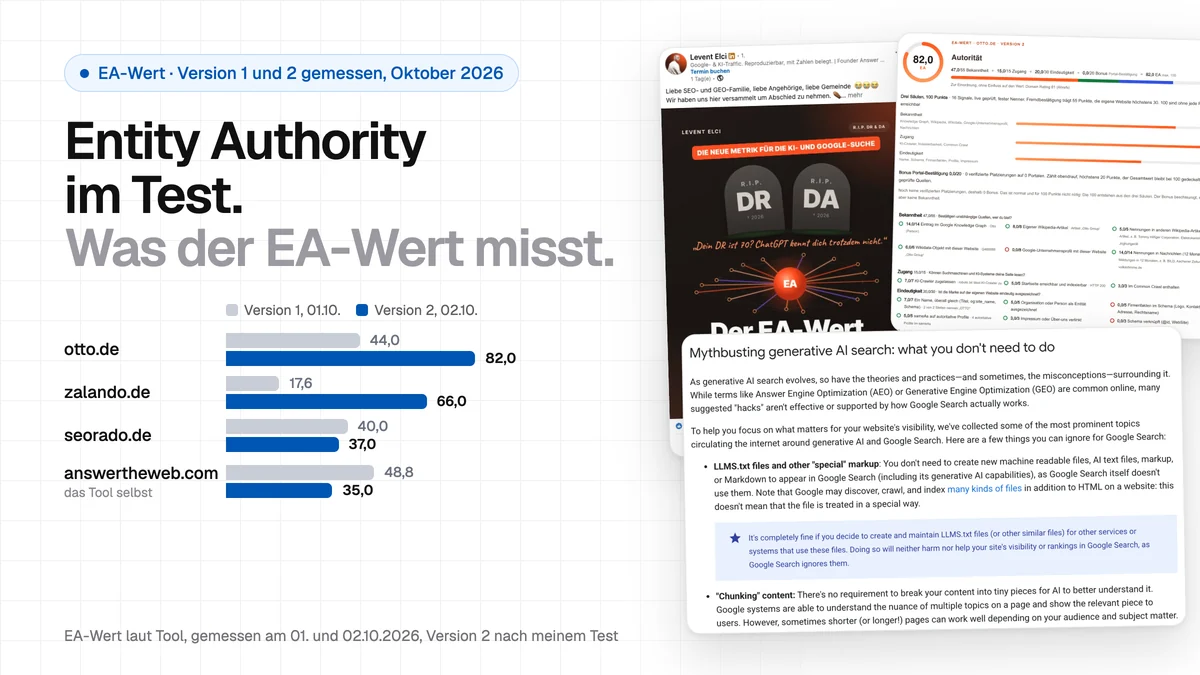
- Version 2 behebt das weitgehend: 55 Punkte kommen von außen, die eigene Website bringt höchstens 30, alle Gewichte sind offen. OTTO steigt von 44,0 auf 82,0, Zalando von 17,6 auf 66,0. Offen bleibt die Suche über den Namen: Bei OTTO zählte das Tool einen Knowledge-Graph-Eintrag für „Otto (Person)“.
- In meinem Test trennt keine der beiden Versionen die Betriebe, die KIs nennen, von denen, die sie nicht nennen. Die Trefferquote liegt bei 0,56 und 0,51, ein Münzwurf läge bei 0,50. Keiner der 44 genannten Betriebe steht auf Wikidata.
- Was nachweislich zählt, sind ein einheitlicher Name, gepflegte Unternehmensprofile und echte Erwähnungen auf fremden Seiten. Markup ist die Grundlage dafür, aber kein Hebel.
Inhaltsverzeichnis14 Abschnitte
- Was eine Entität ist
- Woher der Begriff „Entity Authority“ kommt
- Was Google, Microsoft und die KI-Anbieter wirklich sagen
- Was Studien zeigen
- Version 1 im Test (01.10.2026)
- Version 2: Was Answer the Web nach meinem Test geändert hat
- Das Fallbeispiel rund-helden.de
- Mein Test: Haben die Betriebe, die KIs nennen, einen höheren EA-Wert?
- Mein Selbsttest: seorado vor und nach dem Schema-Umbau
- Was wirklich hilft, sortiert nach Belegen
- Was die Community sagt
- Häufige Fragen
- Fazit
- Quellen
Am 1. Oktober hat Levent Elci auf LinkedIn Domain Rating und Domain Authority für tot erklärt, mit Grabsteinen und dem Satz „Dein DR ist 70? ChatGPT kennt dich trotzdem nicht.“ Als Nachfolger bietet seine Agentur Answer the Web den EA-Wert an, kurz für Entity Authority: ein kostenloser Test, der von 0 bis 100 messen soll, wie sicher Google, ChatGPT, Gemini und Perplexity wissen, wer hinter einer Website steht. Spam-Links zählen nicht, Traffic zählt nicht, die Formel sei offen.
Die Idee dahinter ist richtig. Suchmaschinen und KI-Systeme denken in Entitäten, also in Dingen mit eindeutiger Identität, und nicht mehr nur in Wörtern. Ob ein Score das messen kann, ist eine andere Frage. Ich habe deshalb vier Dinge gemacht. Ich habe den EA-Wert für acht Domains gemessen und alle 21 Gewichte zurückgerechnet. Ich habe zusammengetragen, was Google, Microsoft und die KI-Anbieter selbst sagen und was Studien zeigen. Ich habe meinen Test aus dem Beitrag Was ist GEO? genommen und geprüft, ob die Betriebe, die ChatGPT, Gemini und Co. dort genannt haben, einen höheren EA-Wert haben als ihre Mitbewerber. Und ich habe das Schema meiner eigenen Startseite umgebaut, um zu sehen, wie stark der Wert darauf reagiert. Beim Recherchieren und Auswerten hat mir KI geholfen (Claude Code). Die Messungen, den Test und die Einordnung habe ich selbst gemacht und die Zahlen an den Originalquellen geprüft.
Den fertigen Entwurf habe ich Levent Elci vorab gezeigt, weil ich ihn darin namentlich nenne. Seine Antwort kam am Abend des 2. Oktober: „go, raus damit“, und er hatte den EA-Wert auf Grundlage meiner Messungen komplett umgebaut. In Version 2 kommen 55 von 100 Punkten aus Quellen außerhalb der eigenen Website, die eigene Website bringt höchstens 30, Platzierungen bei Answer the Web sind nur noch ein Bonus, und alle Gewichte sind öffentlich. Ich habe Version 2 noch am selben Abend nachgemessen, ebenfalls nachgebaut und meinen Test damit wiederholt. In diesem Beitrag steht beides: die Prüfung von Version 1, die den Umbau ausgelöst hat, und das Ergebnis für Version 2.
Was eine Entität ist
Google hat das Prinzip im Mai 2012 in vier Worte gefasst: „things, not strings“. Mit dem Knowledge Graph wollte Google nicht mehr nur Zeichenketten abgleichen, sondern wissen, welches Ding gemeint ist. Damals umfasste er laut Google 500 Millionen Objekte und 3,5 Milliarden Fakten, im Jahr 2020 nannte Google 500 Milliarden Fakten über fünf Milliarden Entitäten. Eine Entität ist dabei jede Person, Firma, Marke, jeder Ort oder jedes Produkt, das sich eindeutig von anderen unterscheiden lässt. „Apple“ kann eine Frucht oder ein Konzern sein, erst der Zusammenhang macht daraus eine Entität.
Für deine Website heißt das: Google versucht herauszufinden, welche Firma hinter ihr steht, wie sie heißt, wo sie sitzt und welche Profile zu ihr gehören. Dabei helfen strukturierte Daten. Google schreibt in seiner Doku zum Organization-Markup, dass es Google helfen kann, „your organization's administrative details“ zu verstehen und deine Organisation in den Suchergebnissen von anderen zu unterscheiden. Einige Angaben steuern sichtbare Dinge wie das Logo im Knowledge Panel, andere wirken „behind the scenes“. Pflichtfelder gibt es keine.
Für lokale Betriebe gilt etwas anderes. Hier verweist Google beim Knowledge Panel ausdrücklich auf das Unternehmensprofil: Firmen haben eigene Profil-Panels und sollen sie über das Unternehmensprofil anlegen und pflegen. Unternehmensprofile haben eine Kennung im Knowledge Graph, du findest sie im Google-Maps-Link als Zeichenfolge, die meist mit /g/ beginnt. Ein Dachdecker mit gepflegtem Profil ist für Google also längst eine Entität, auch ohne eine Zeile Schema auf der Website.
Knowledge Graph, Knowledge Panel, Wikidata: der Unterschied
Knowledge Graph: Googles interne Datenbank über Entitäten und ihre Beziehungen. Du kannst nicht hineinsehen, nur über eine Programmierschnittstelle prüfen, ob es einen Eintrag gibt. Google warnt selbst, diese Schnittstelle sei „not suitable for use as a production-critical service“.
Knowledge Panel: der Kasten rechts in den Suchergebnissen, der Fakten aus dem Knowledge Graph zeigt. Er entsteht laut Google automatisch, „when there is enough information available on the open web“. Für lokale Betriebe ist das Unternehmensprofil das Panel.
Wikidata: eine offene Datenbank der Wikimedia-Stiftung, die jeder bearbeiten kann. Google hat 2014 die Daten seiner früheren offenen Datenbank Freebase an Wikidata gegeben. Dass Google Wikidata heute als Quelle für den Knowledge Graph nutzt, hat Google nicht bestätigt.
Auch ChatGPT baut inzwischen eigene Entitäten. Seit Oktober 2025 markiert ChatGPT Marken in seinen Antworten als Entität vom Typ „brand“, wie das Analyse-Tool Profound und Christian Kunz von SEO Südwest beschrieben haben. Woher OpenAI diese Daten nimmt, ist nicht dokumentiert.
Woher der Begriff „Entity Authority“ kommt
In keiner der Google-Quellen, die ich gesichtet habe, taucht „Entity Authority“ auf. Der Begriff stammt aus der Beraterszene. Am prominentesten nutzt ihn Jason Barnard mit seiner Firma Kalicube, der auch den Begriff „Entity Home“ für sich beansprucht: die eine Seite, meist die Über-uns-Seite, die ein Algorithmus als maßgebliche Quelle über eine Entität nutzt. Bei Kalicube heißt es, Domain Authority messe das Rankingpotenzial einer Website, Entity Authority dagegen das Vertrauen von Suchmaschinen, Knowledge Graphs und Sprachmodellen in eine Entität. Verwandt ist der Begriff „Topical Authority“ von Koray Tuğberk Gübür, der aber nach Themen fragt, nicht nach der Identität.
Im deutschsprachigen SEO hat Levent Elci den Begriff im September 2026 gezielt eingeführt. Am 11.09. schrieb er auf LinkedIn: „Ich möchte einen Begriff im deutschsprachigen SEO etablieren“. Seine These: „KI-Sichtbarkeit“ beschreibe, was passiert, Entity Authority, warum. Danach ging es schnell:
- 21.09.2026: Elci kritisiert KI-Sichtbarkeits-Checks, die nur einen ChatGPT-Prompt ausführen, und stellt einen eigenen „Entity Authority Score von 0 bis 100“ vor, gebaut aus seinem Framework, „Google-Patenten“ und eigenen Feldstudien mit über 200 Domains. Die Analyse gab es damals nur gegen E-Mail-Adresse. Er schreibt selbst: „Das ist kein offizieller Google-Score.“
- 01.10.2026, vormittags: ein kostenloser Test mit „17 Signale[n], Google Knowledge Graph inklusive“.
- 01.10.2026, gegen 10 Uhr: der EA-Wert mit 21 Signalen, ohne Anmeldung, unter answertheweb.com/ea-wert. Dazu der Post „Die Metriken: Domain Rating (DR) und Domain Authority (DA) sind tot.“
Diskutiert wird das Thema auch an anderer Stelle. Stefan Mayr von der Grizzly GmbH fragte im September, wo man seine Entitäten eigentlich verwaltet, wenn die Identität einer Firma in einem SEO-Plugin steckt und beim nächsten Relaunch verloren geht. Das ist ein echtes Problem, das ich aus Relaunch-Projekten kenne.
Was Google, Microsoft und die KI-Anbieter wirklich sagen
Google hat am 15. Mai 2026 einen eigenen Leitfaden für generative KI in der Suche veröffentlicht. Die wichtigste Aussage steht gleich oben: Für Google sei die Optimierung für KI-Suche eine Optimierung für das Sucherlebnis „and thus still SEO“. Darunter folgt ein Abschnitt, der für das Thema dieses Beitrags entscheidend ist: „Mythbusting generative AI search: what you don't need to do“.
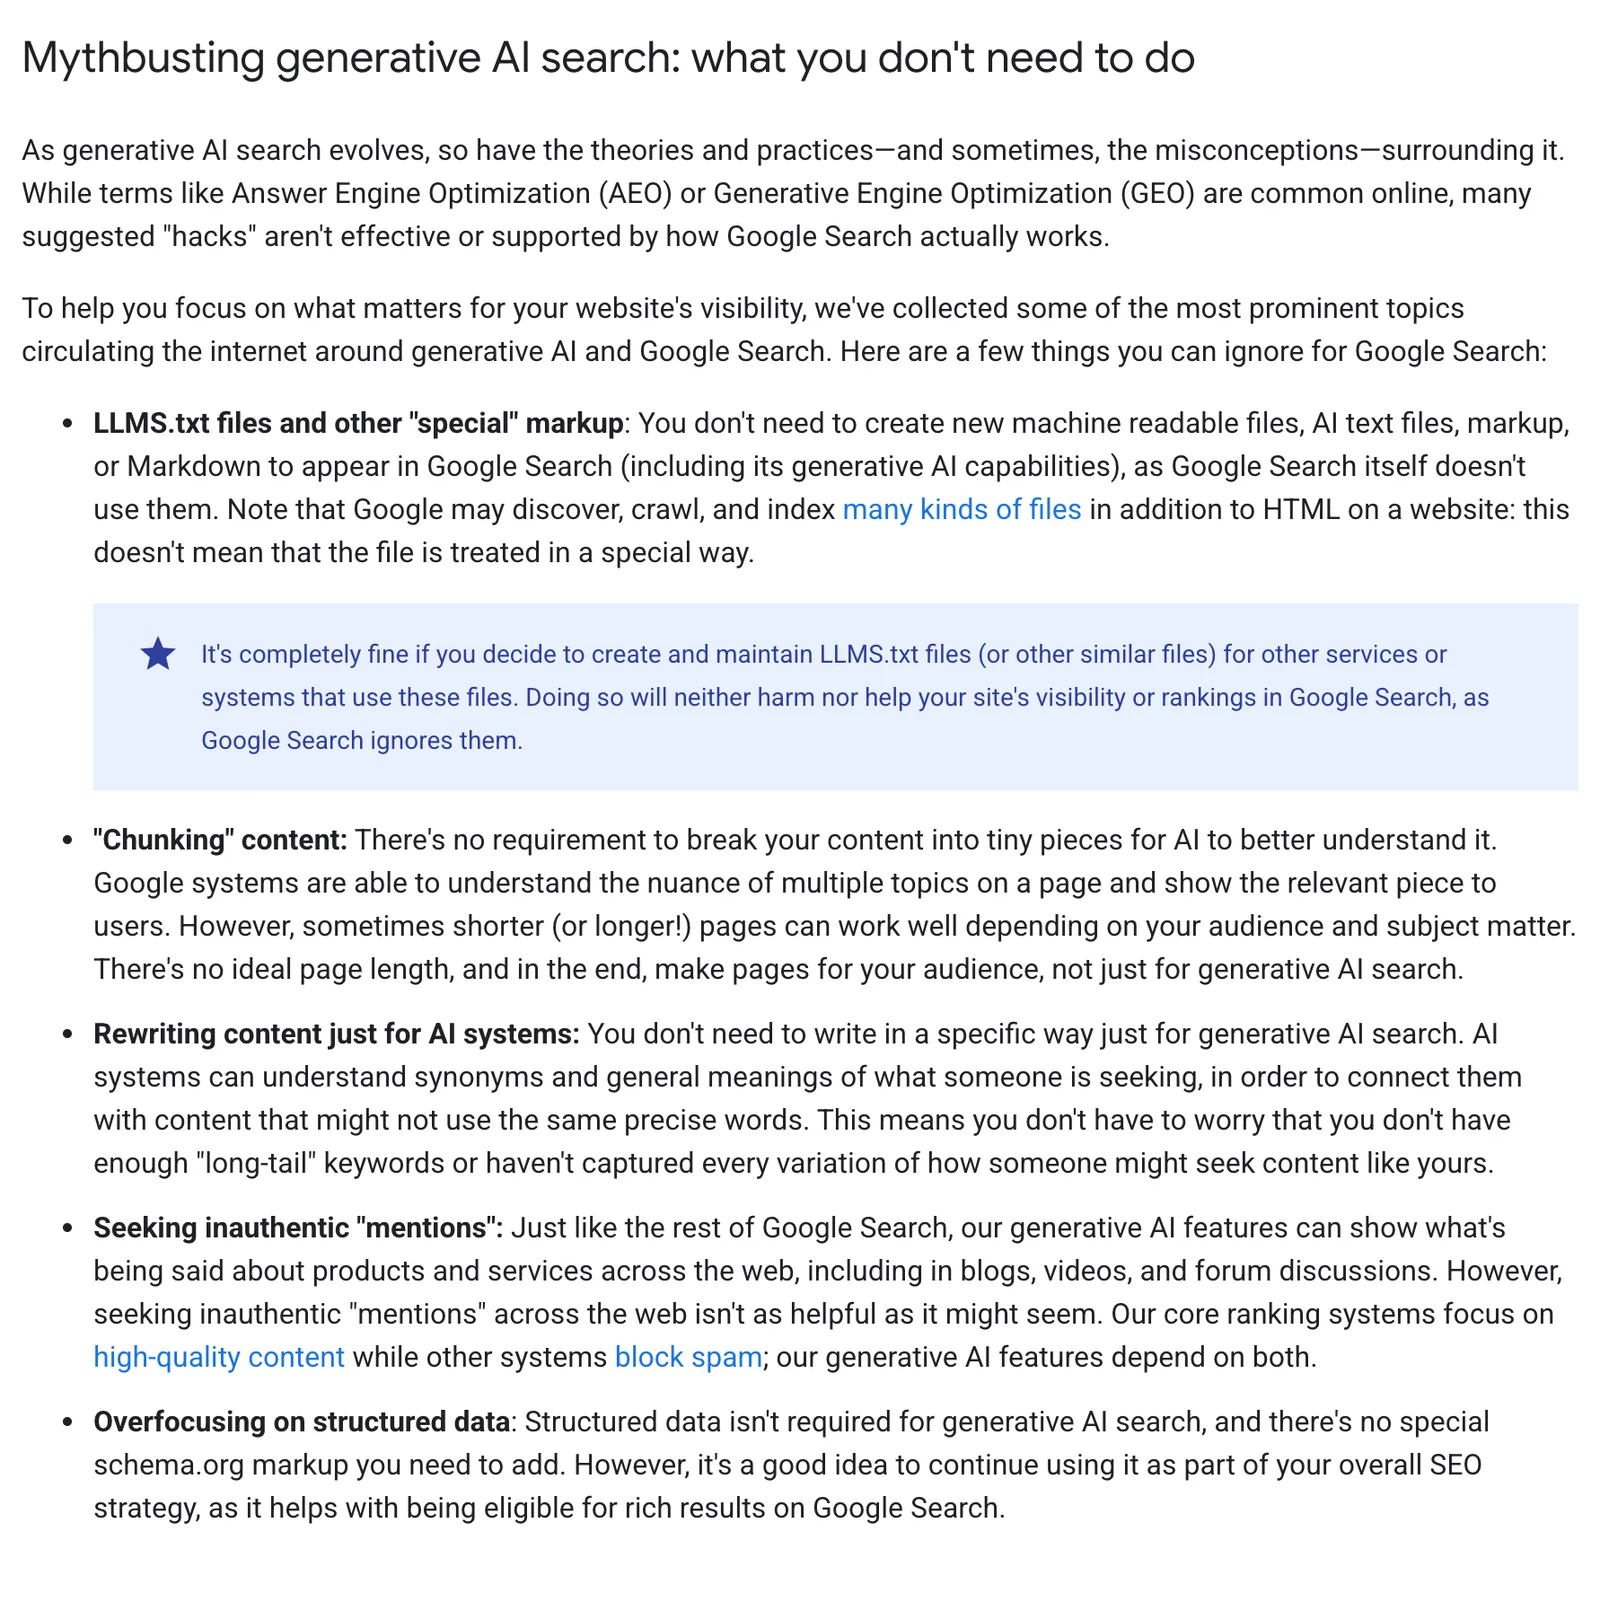
Drei Punkte daraus betreffen den EA-Wert direkt:
- llms.txt: „You don't need to create new machine readable files, AI text files, markup, or Markdown to appear in Google Search (including its generative AI capabilities), as Google Search itself doesn't use them.“ Im Juni ergänzte Google, die Dateien würden die Sichtbarkeit weder positiv noch negativ beeinflussen. Der EA-Wert gibt für eine llms.txt 4 Punkte. Mehr dazu in meinem Beitrag llms.txt: Google ignoriert sie, Coding-Agents lesen sie.
- Unechte Erwähnungen: Die KI-Funktionen zeigten zwar, was im Netz über Produkte und Firmen gesagt wird, „however, seeking inauthentic "mentions" across the web isn't as helpful as it might seem.“
- Strukturierte Daten: „Structured data isn't required for generative AI search, and there's no special schema.org markup you need to add.“ Es sei aber eine gute Idee, sie weiter zu nutzen, weil sie für Rich Results wichtig sind.
Dieselbe Aussage steht auch in Googles Seite „AI features and your website“:

Das heißt aber nicht, dass Entitäten egal sind. Google selbst schreibt beim Start des KI-Modus im März 2025, man könne damit auf hochwertige Webinhalte und „fresh, real-time sources like the Knowledge Graph“ zugreifen. Der Knowledge Graph fließt also in Googles KI-Antworten ein. Und Googles Doku zum Website-Namen sagt klar, dass Google den Namen aus dem WebSite-Markup, aus og:site_name, aus dem Seitentitel und aus Überschriften zusammensetzt und dass du ihn überall gleich schreiben sollst. Ein einheitlicher Name ist also belegt sinnvoll, für den Namen im Suchergebnis.
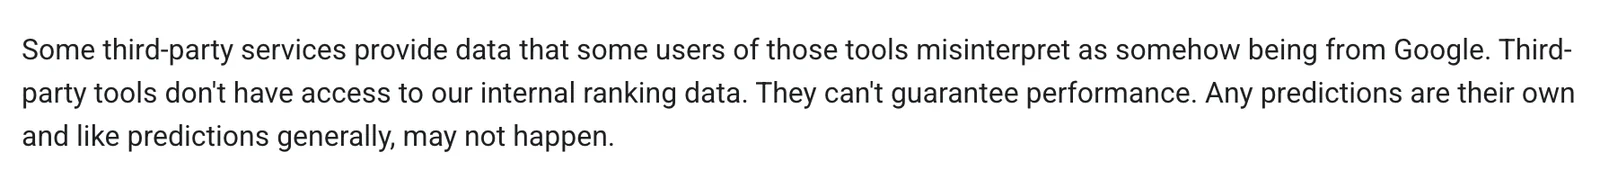
Am 5. Juni 2026 hat Google außerdem eine eigene Seite zu SEO-Tools von Drittanbietern veröffentlicht. Sie nennt ausdrücklich Tools, die Verbesserungen für KI-Funktionen versprechen, also „AEO“- oder „GEO“-Tools:
Microsoft ist bei strukturierten Daten freundlicher. Krishna Madhavan, Produktmanager bei Bing, schrieb im Oktober 2025, Schema helfe Suchmaschinen und KI-Systemen, Inhalte „with confidence“ zu deuten, und Titel, H1 und Beschreibung sollten zueinander passen. Die oft zitierte Aussage von Bings Fabrice Canel auf der SMX München 2025, Schema helfe den Sprachmodellen von Microsoft, ist dagegen nur aus zweiter Hand überliefert. Mark Williams-Cook hält sie für „misquoted to an industrial scale“.
Von OpenAI, Anthropic und Perplexity gibt es keine einzige offizielle Aussage, dass ihre Systeme JSON-LD, Organization-Markup oder eine llms.txt auswerten. Belegt ist nur das Gegenteil der Sperre: Wer OAI-SearchBot, Claude-SearchBot oder PerplexityBot aussperrt, taucht in deren Suchantworten nicht mehr auf. Googles John Mueller fasste die Frage, ob viel Schema den Sprachmodellen hilft, Anfang 2026 auf Reddit so zusammen: „yes, no, and it depends“. Für Preise und Verfügbarkeit im Shopping seien maschinenlesbare Daten nötig, bei den meisten anderen Typen gebe es aber „a lot of wishful thinking“.
Was Studien zeigen
Erwähnungen korrelieren stärker als Links
Die Zahl, auf die sich der EA-Wert beruft, stammt von Ahrefs. Im Mai 2025 hat Ahrefs 75.000 Marken untersucht und verglichen, welche Kennzahlen mit Nennungen in Googles KI-Übersichten zusammenhängen. Markenerwähnungen im Web kamen auf eine Rangkorrelation von 0,664, Backlinks auf 0,218. Die Aussage auf der EA-Seite, Erwähnungen hingen „dreimal so stark“ mit der Sichtbarkeit zusammen wie Backlinks, stimmt rechnerisch: 0,664 geteilt durch 0,218 ergibt 3,05. Gegenüber dem Domain Rating (0,326) ist es etwa das Doppelte. In einer Folgestudie vom Dezember 2025 lagen Erwähnungen auf YouTube mit rund 0,74 sogar noch höher, für den KI-Modus kamen Web-Erwähnungen auf 0,709.
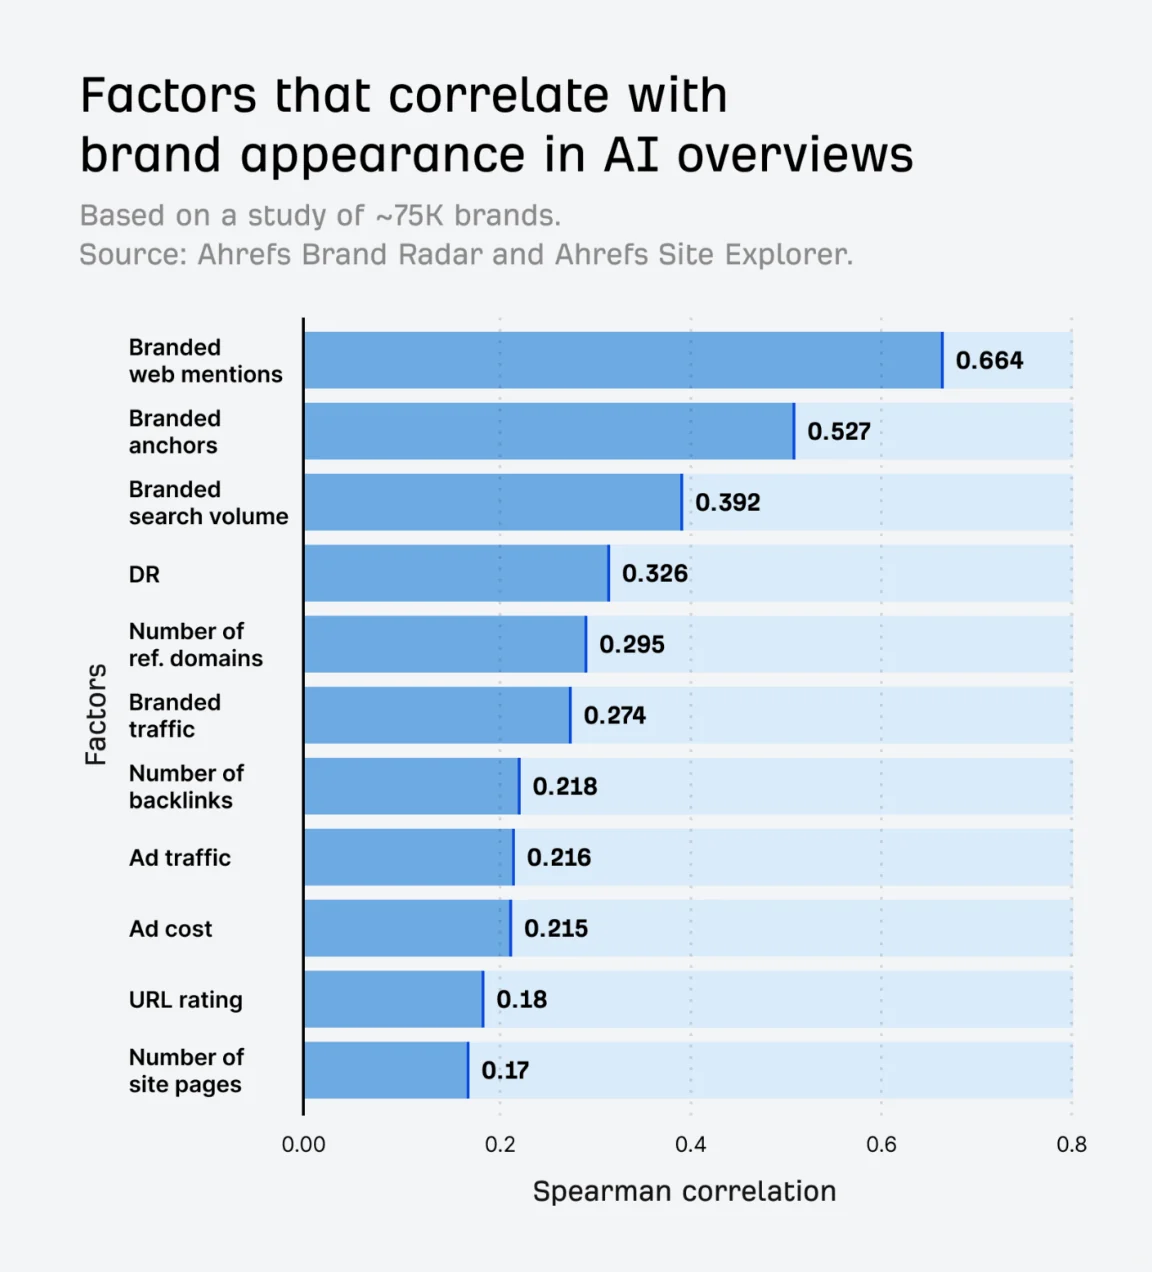
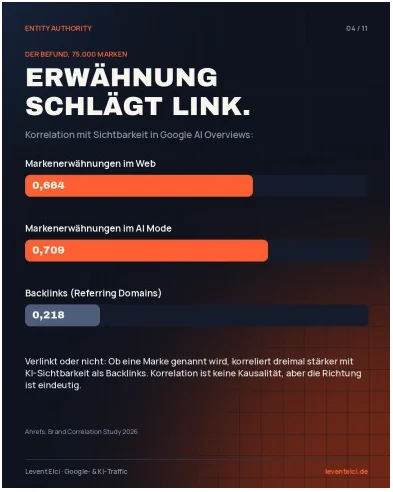
Zwei Einschränkungen sind wichtig. Erstens hat Ahrefs nur Domains mit einem Domain Rating über 40 untersucht, also keine kleinen Betriebe, und schreibt selbst „correlation ≠ causation“: Erwähnungen könnten einfach „markers of existing brand strength“ sein. Große, bekannte Marken haben eben mehr Erwähnungen, mehr Markensuchen und mehr KI-Nennungen. Zweitens misst die Studie Erwähnungen auf fremden Seiten im ganzen Web. Genau das misst der EA-Wert nicht. Er zählt Bestätigung von außen nur, wenn sie aus dem Portfolio von Answer the Web kommt.
Schema bringt keine zusätzlichen Zitate
Die bisher beste Studie zur Frage, ob strukturierte Daten KI-Zitate bringen, hat ebenfalls Ahrefs gemacht. Im Mai 2026 verglichen Louise Linehan und Xibeijia Guan 1.885 Seiten, die JSON-LD neu eingebaut hatten, mit 4.000 Kontrollseiten ohne Änderung. Nach Abzug der allgemeinen Schwankungen auf den Plattformen blieb bei ChatGPT ein Plus von 2,2 % und im KI-Modus von 2,4 %, beides statistisch nicht von null zu unterscheiden. In den KI-Übersichten gab es sogar ein kleines, signifikantes Minus von 4,6 %.
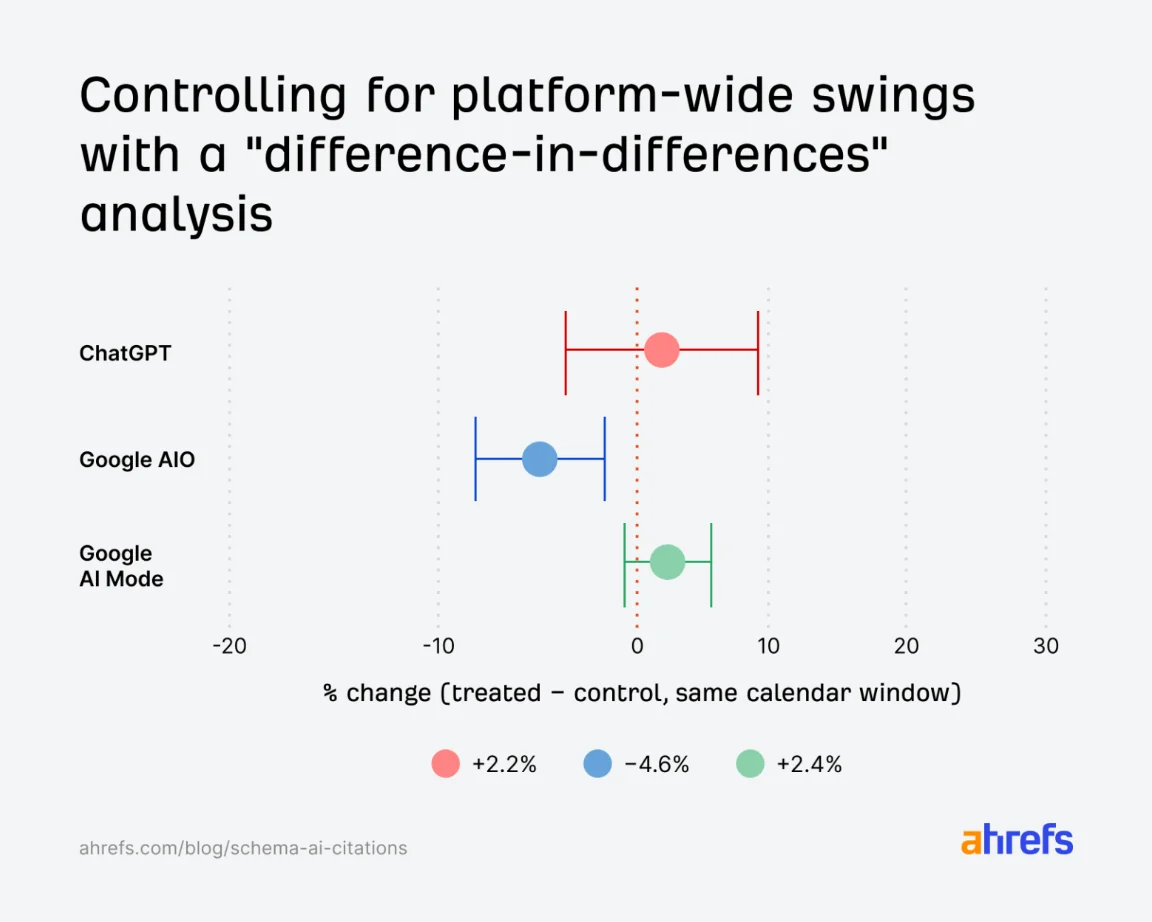
Die Studie hat Grenzen: Sie lief nur 30 Tage und nur mit Seiten, die schon oft zitiert wurden. Gianluca Fiorelli hält sie deshalb für richtig, aber für einen Test der falschen Frage, weil Schema eher Infrastruktur für die Eindeutigkeit sei als ein Hebel für Zitate. Daniel Cheung hat im Juli 2026 alle Studien zum Thema gesichtet und kam zu einem klaren Schluss: Jede Studie, die einen Nutzen fand, hatte keine Kontrollgruppe, und jede Studie mit Kontrollgruppe fand nichts oder ein kleines Minus.
Dazu passen mehrere Tests, wie Chatbots eine Seite beim Abruf lesen. Mark Williams-Cook hat eine erfundene Firma angelegt, deren Adresse nur in absichtlich ungültigem JSON-LD stand. ChatGPT und Perplexity gaben die Adresse trotzdem aus. Sein Schluss: Für das Modell war der JSON-LD-Block „just slightly weirdly-punctuated prose“, also Text mit seltsamen Satzzeichen, kein Schema. searchVIU fand im Herbst 2025, dass kein Chatbot Preise las, die nur im JSON-LD standen.
Und auch in den Trainingsdaten kommt JSON-LD nicht an. Laut einer Auswertung der Mozilla Foundation nutzen mindestens 64 % von 47 untersuchten Sprachmodellen den Common Crawl, ein offenes Archiv von Milliarden Webseiten. Ich habe am 01.10.2026 eine Datei aus dem aktuellen Crawl vom September 2026 ausgewertet: Von 255 Seiten mit JSON-LD im Quelltext war es in 0 der zugehörigen Textfassungen noch enthalten. Die Textfassung, mit der viele Trainingsdaten gebaut werden, enthält nur den sichtbaren Text.
Fremde Quellen dominieren
Wenn KI-Systeme über bekannte Marken schreiben, stützen sie sich fast nur auf fremde Quellen. Forscher der Universität Toronto haben im September 2025 gezählt, wie viele Quellen aus „Earned Media“ stammen, also aus Berichten Dritter statt von den Marken selbst: bei ChatGPT 93,5 %, bei Claude 87,3 %, bei Perplexity 67,4 % und bei Gemini 63,4 %. Der PR-Software-Anbieter Muck Rack kommt bei über 25 Millionen Links auf 84 %. Wikipedia ist dabei eine der wichtigsten Quellen: 7,8 % aller ChatGPT-Zitate laut Profound, in rund 17 % der Antworten im deutschen KI-Modus laut Sistrix.
Einzelne KI-Abfragen sind keine Messung
Rand Fishkin hat im Januar 2026 mit 600 Freiwilligen dieselben Fragen fast 3.000-mal gestellt. Die Chance, zweimal dieselbe Liste empfohlener Marken zu bekommen, lag unter 1 zu 100. Wer also einmal fragt, ob ChatGPT die eigene Marke kennt, bekommt eine Momentaufnahme. Brauchbar ist nur der Anteil über viele Abfragen.
Version 1 im Test (01.10.2026)
Alle Messungen in diesem Abschnitt stammen von Version 1, die vom 01. bis zum 02.10.2026 online war. Was Answer the Web danach geändert hat, steht im nächsten Abschnitt.
So rechnete das Tool
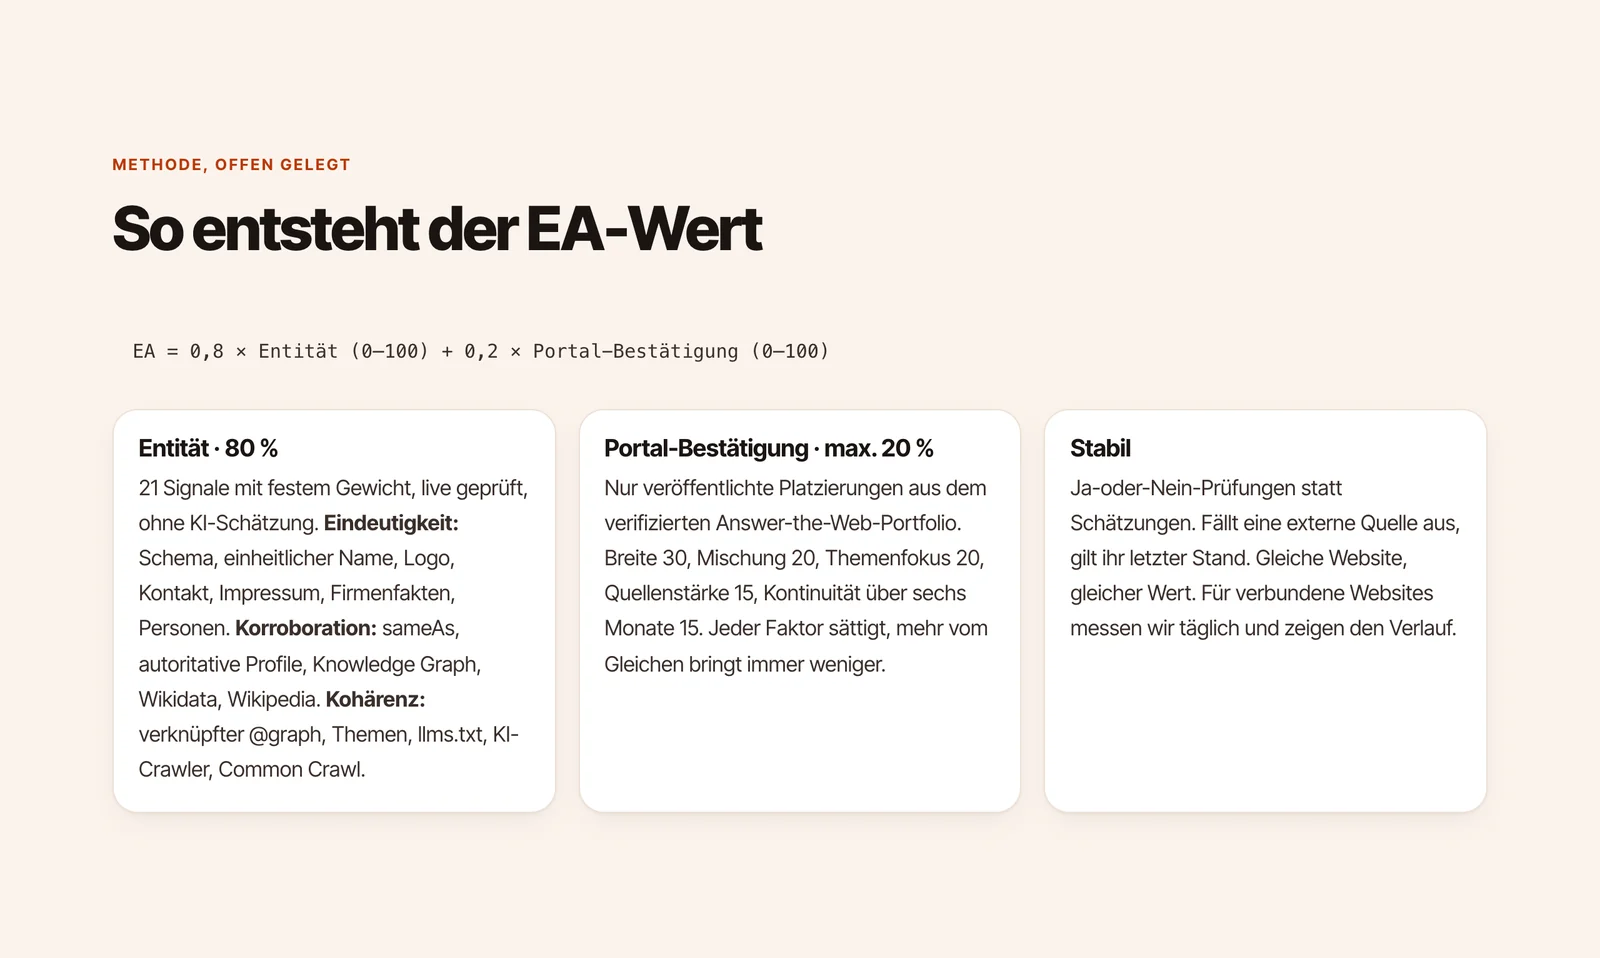
Die Formel steht auf der Seite: EA = 0,8 × Entität + 0,2 × Portal-Bestätigung. Die Entität setzt sich aus 21 Ja-oder-Nein-Prüfungen in drei Säulen zusammen, Eindeutigkeit, Korroboration und Kohärenz, jede mit einem festen Gewicht. Die Gewichte selbst veröffentlicht Answer the Web nicht, und sie stehen auch nicht im Code der Seite, denn gerechnet wird auf dem Server. Das Tool zeigt aber für jedes fehlende Signal an, wie viele Punkte es „bis zu“ bringen würde. Daraus lassen sich alle Gewichte zurückrechnen. Mit diesen Gewichten konnte ich alle Messungen auf die Nachkommastelle genau nachrechnen.
Das Ergebnis zeigt die folgende Tabelle. Drei Dinge fallen auf. Erstens prüfen 64 der 119 Punkte nur, ob bestimmte Felder im JSON-LD der Startseite stehen. Zählt man Seitentitel, Links, robots.txt und llms.txt dazu, sind es 94 von 113 Punkten, die allein von deiner eigenen Website abhängen. Zweitens stammen nur 34 Punkte aus Signalen, deren Wirkung eine Primärquelle oder kontrollierte Studie belegt, und auch die belegen oft etwas anderes als Bekanntheit, etwa den Website-Namen im Suchergebnis. Drittens ist die Schwelle „3 oder mehr sameAs“, die allein 10 Punkte bringt, eine Setzung des Tools. Google kennt sameAs ohne Mindestzahl.
| Signal | Punkte | Geprüft in | Beleg | Was die Quellen sagen |
|---|---|---|---|---|
| Unternehmen oder Person als Entität ausgezeichnetEindeutigkeit | 12 | JSON-LD der Startseite | umstritten | Google nutzt Organization-Markup, um Firmen zu unterscheiden. Für KI-Antworten braucht es laut Google kein spezielles Markup. |
| Markenname im SeitentitelEindeutigkeit | 5 | Startseite, robots.txt, llms.txt | belegt | Belegt für den Website-Namen, den Google im Suchergebnis zeigt. Eine Wirkung auf die Entität ist nicht belegt. |
| Einheitlicher Name (Schema, og:site_name, Titel)Eindeutigkeit | 6 | Startseite, robots.txt, llms.txt | belegt | Google: Website-Namen überall gleich schreiben. Das steuert den angezeigten Namen. |
| Logo in den strukturierten DatenEindeutigkeit | 4 | JSON-LD der Startseite | belegt | Belegt für die Anzeige im Suchergebnis und im Knowledge Panel, mindestens 112 × 112 Pixel. |
| Kontakt maschinenlesbar (Telefon, E-Mail oder Adresse)Eindeutigkeit | 4 | JSON-LD der Startseite | unbelegt | Als Markup-Signal nicht belegt. Belegt ist der Nutzen gepflegter Unternehmensprofile bei Google und Bing. |
| Impressum oder Über-uns verlinktEindeutigkeit | 4 | Startseite, robots.txt, llms.txt | umstritten | Für Googles Qualitätsprüfer wichtig, in Deutschland ohnehin Pflicht. Als maschinelles Signal nicht belegt. |
| Firmenfakten maschinenlesbar (Rechtsname, Gründung, Gründer oder Adresse)Eindeutigkeit | 4 | JSON-LD der Startseite | unbelegt | Google kennt legalName, foundingDate und address, founder steht nicht in der Doku. Eine Wirkung ist nicht belegt. |
| Menschen hinter der Marke ausgezeichnet (Person, Autor, Gründer)Eindeutigkeit | 4 | JSON-LD der Startseite | umstritten | Google nutzt Autoren-Markup, um Autoren zuzuordnen. Für die Marke selbst nicht belegt. |
| sameAs-Verknüpfungen (3 oder mehr)Korroboration | 10 | JSON-LD der Startseite | unbelegt | Google kennt sameAs ohne Mindestzahl. Die Schwelle von drei Profilen setzt das Tool. |
| Profile im Netz verlinkt (LinkedIn, Google, Branchenportale)Korroboration | 6 | Startseite, robots.txt, llms.txt | umstritten | Plausibel, aber nur Korrelationen: Profile auf Bewertungsportalen gehen mit mehr KI-Zitaten einher. |
| Eintrag im Google Knowledge GraphKorroboration | 9 | fremde Datenquelle | belegt | Der KI-Modus nutzt den Knowledge Graph. Ein Eintrag ist aber ein Ergebnis, kein Hebel. Im Tool war er in allen 8 Messungen rot. |
| Autoritative Profile in sameAs (Wikidata, LinkedIn, Google, Register, Bewertungsportale)Korroboration | 5 | JSON-LD der Startseite | unbelegt | Google nennt keine bevorzugten sameAs-Ziele. |
| Wikidata-EintragKorroboration | 5 | fremde Datenquelle | umstritten | Plausibel, von Google heute nicht bestätigt. Selbsteinträge ohne unabhängige Belege werden gelöscht. |
| Nennungen in Wikipedia-TextenKorroboration | 5 | fremde Datenquelle | belegt | Wikipedia ist eine Hauptquelle für Training und KI-Zitate. Für kleine Firmen kaum regelkonform erreichbar. |
| Strukturierte Daten vorhandenKohärenz | 5 | JSON-LD der Startseite | umstritten | Hilft Google beim Verstehen und für Rich Results. Die einzige kontrollierte Studie fand keinen Effekt auf KI-Zitate. |
| Verknüpfter @graph mit @idKohärenz | 7 | JSON-LD der Startseite | unbelegt | Gute Praxis, aber Google schreibt: Die url reicht als Kennung. |
| WebSite und WebPage beschriebenKohärenz | 4 | JSON-LD der Startseite | umstritten | WebSite ist für Googles Website-Namen wichtig, für WebPage gibt es keine Google-Funktion. |
| Themen benannt (knowsAbout, about oder mentions)Kohärenz | 5 | JSON-LD der Startseite | unbelegt | Steht nicht in Googles Doku. Markup muss außerdem sichtbaren Inhalt spiegeln. |
| llms.txt für KI-SystemeKohärenz | 4 | Startseite, robots.txt, llms.txt | unbelegt | Google nutzt sie nicht, weder positiv noch negativ. Kein KI-Anbieter hat bestätigt, sie für Antworten zu lesen. |
| KI-Crawler zugelassenKohärenz | 5 | Startseite, robots.txt, llms.txt | belegt | Such-Crawler wie OAI-SearchBot sind Voraussetzung für Zitate. Das Tool prüft aber auch Trainings-Crawler wie GPTBot und Google-Extended, die dafür nicht nötig sind. |
| Im Common Crawl enthaltenKohärenz | 6 | fremde Datenquelle | umstritten | Common Crawl ist eine Trainingsbasis. Im Tool war das Signal meist grau und fiel dann aus der Rechnung. |
| Zusammen: 34 Punkte aus belegten, 46 aus umstrittenen und 39 aus unbelegten Signalen. Geprüft werden 64 Punkte nur im JSON-LD der Startseite, 30 auf der übrigen Startseite und in robots.txt und llms.txt, 25 in fremden Datenquellen. „Belegt“ heißt: Eine Primärquelle oder kontrollierte Studie zeigt eine Wirkung, oft aber auf etwas anderes als die Bekanntheit der Marke, etwa auf den Website-Namen im Suchergebnis. | ||||
Meine Messungen
Ich habe am 01. und 02.10.2026 acht Domains gemessen, über das öffentliche Formular und mit Pausen dazwischen. Eine davon ist eine Seite aus meinem Umfeld, die ich hier nicht öffentlich auswerte. Die übrigen sieben:
| Domain | EA | Eindeutigkeit | Korroboration | Kohärenz | Stufe laut Tool |
|---|---|---|---|---|---|
| answertheweb.comdas Tool selbst | 48,8 | 43/43 | 0/40 | 26/30 | Im Aufbau |
| otto.de | 44,0 | 27/43 | 25/40 | 10/30 | Im Aufbau |
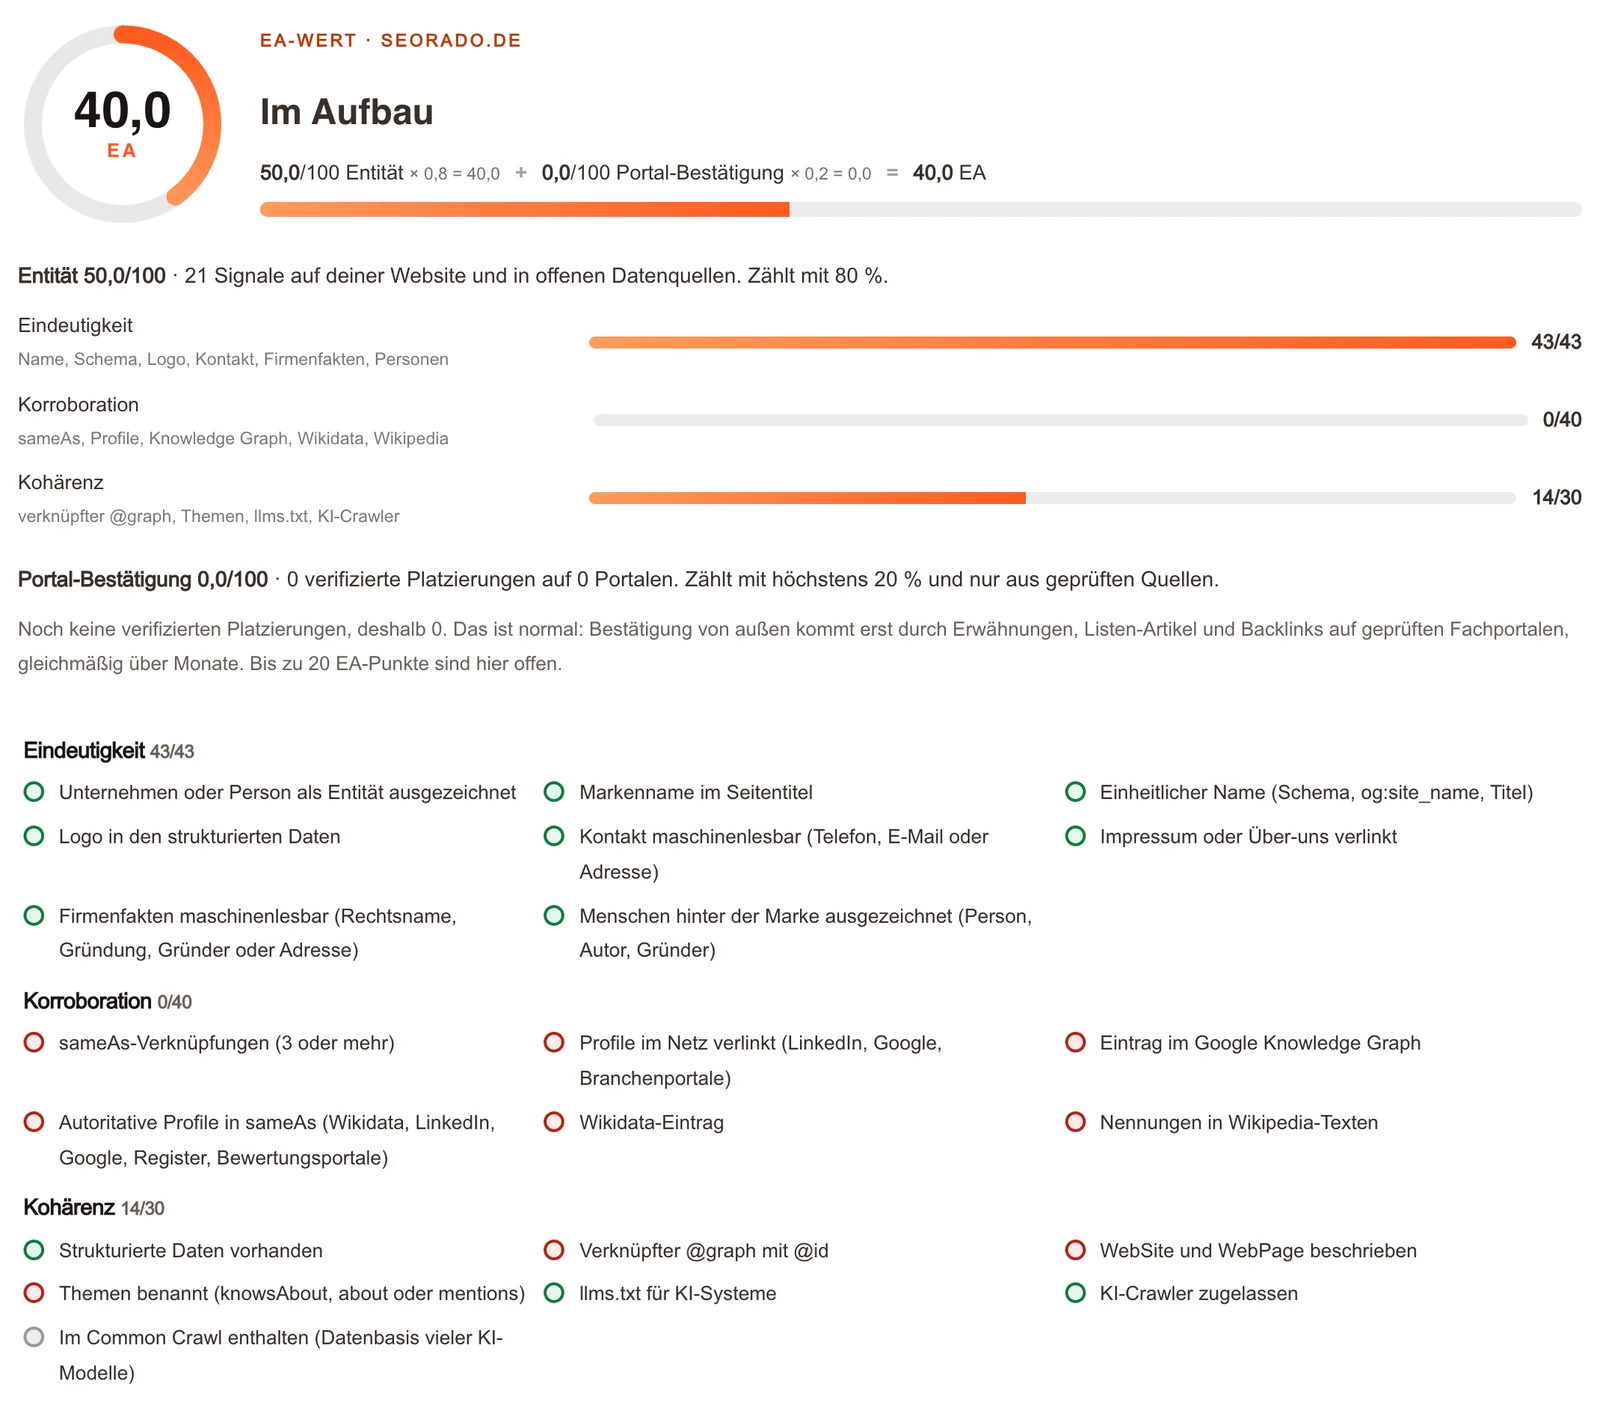
| seorado.devor der Schema-Änderung | 40,0 | 43/43 | 0/40 | 14/30 | Im Aufbau |
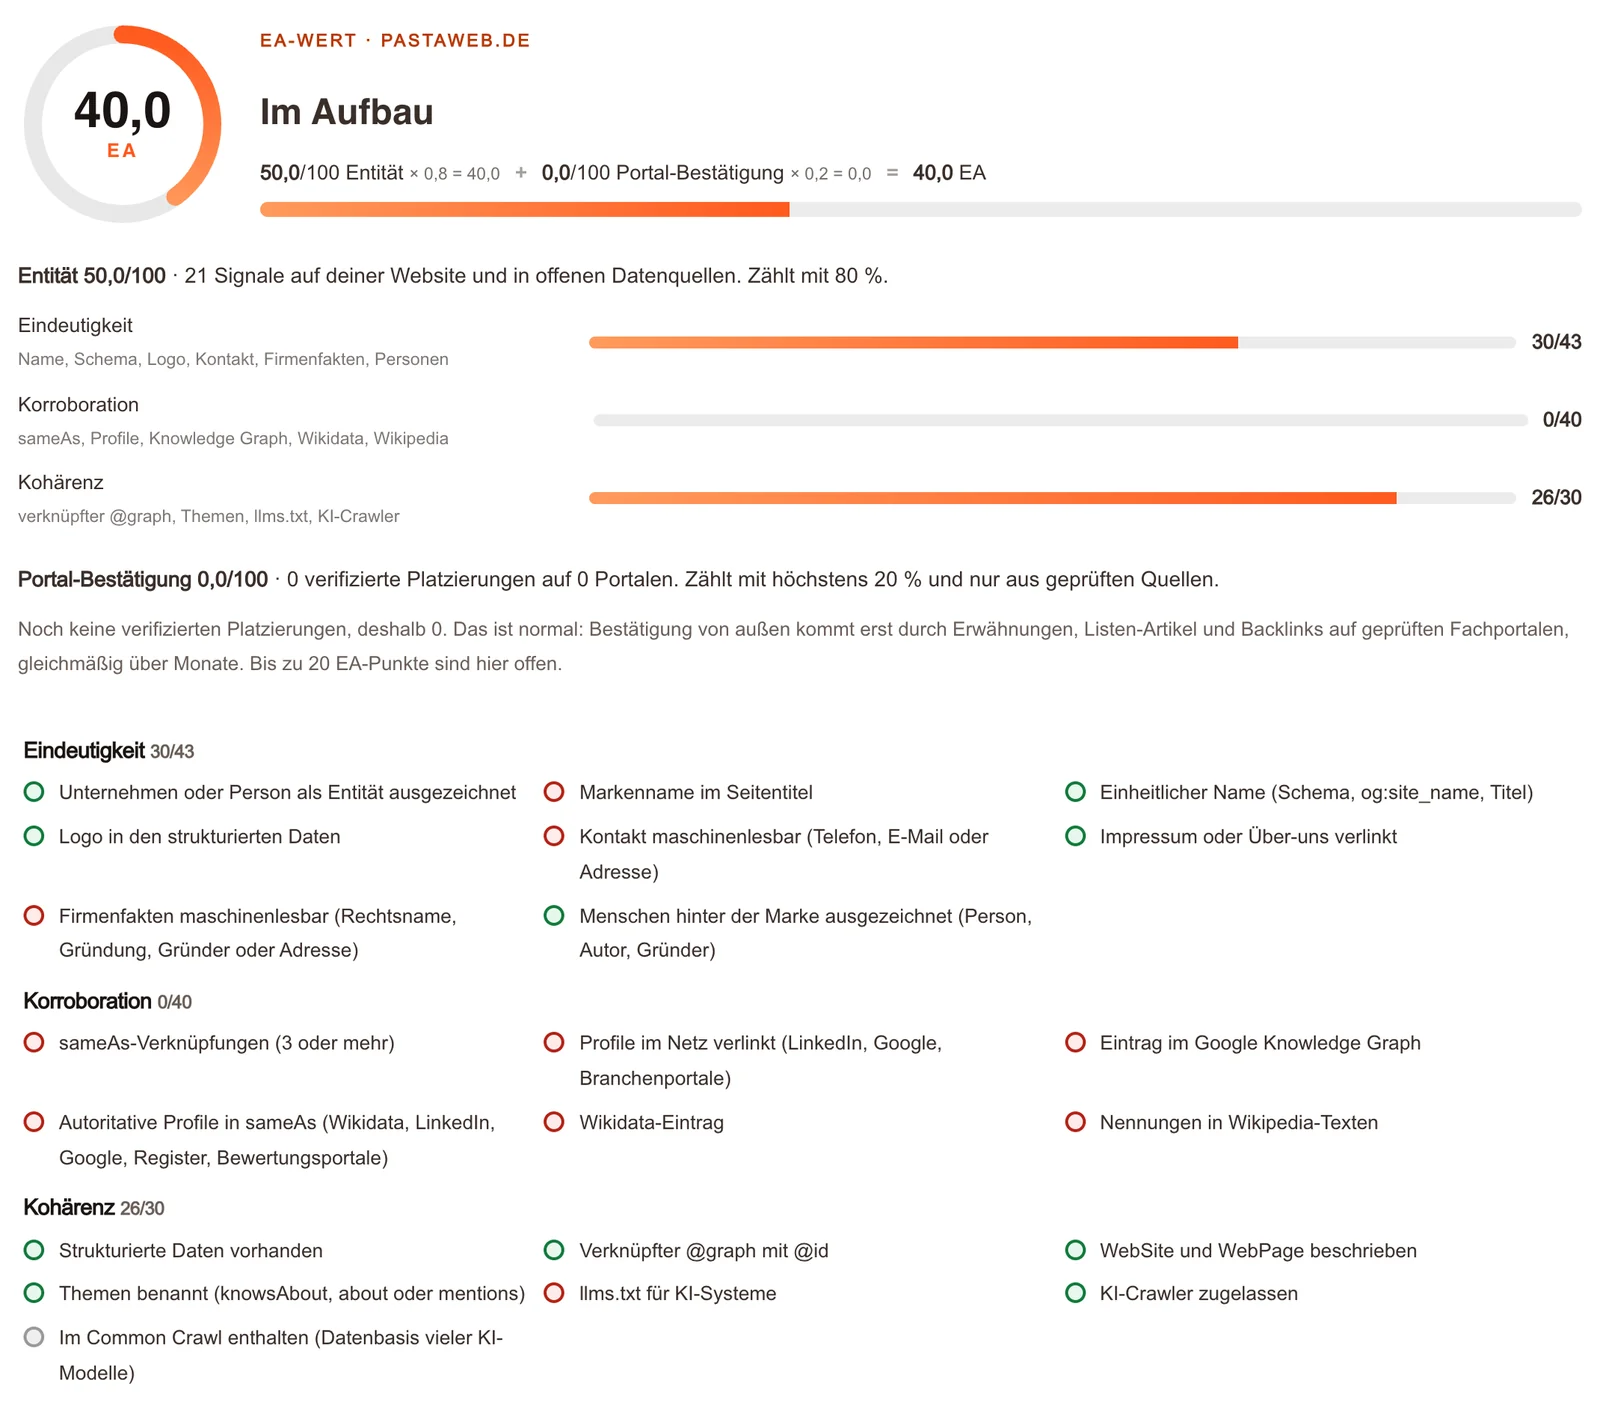
| pastaweb.demein Food-Magazin | 40,0 | 30/43 | 0/40 | 26/30 | Im Aufbau |
| example.comPlatzhalter-Domain ohne Firma | 18,4 | 11/43 | 5/40 | 11/36 | Kaum bekannt |
| zalando.de | 17,6 | 15/43 | 6/40 | 4/30 | Kaum bekannt |
| opal-schmiede.comOnline-Shop, einer meiner Kunden | 14,4 | 15/43 | 0/40 | 5/30 | Kaum bekannt |
| idealo.de | keine Messung: „Die Website ist nicht erreichbar.“ idealo blockt Abrufe von Servern, im Browser ist die Seite erreichbar. | ||||
Die Reihenfolge sagt viel über das Werkzeug. Nach dem EA-Wert kennen Google und KI das Tool selbst, dessen Domain erst seit dem 26.09.2026 registriert ist, besser als OTTO. Zalando, ein börsennotierter Konzern mit eigenem Wikipedia-Artikel und Knowledge Panel, liegt hinter example.com, einer Domain, die nur als Platzhalter für Beispiele existiert. Seorado und mein Food-Magazin pastaweb.de liegen gleichauf mit 40,0 und knapp hinter OTTO.
Wo das Tool danebenliegt
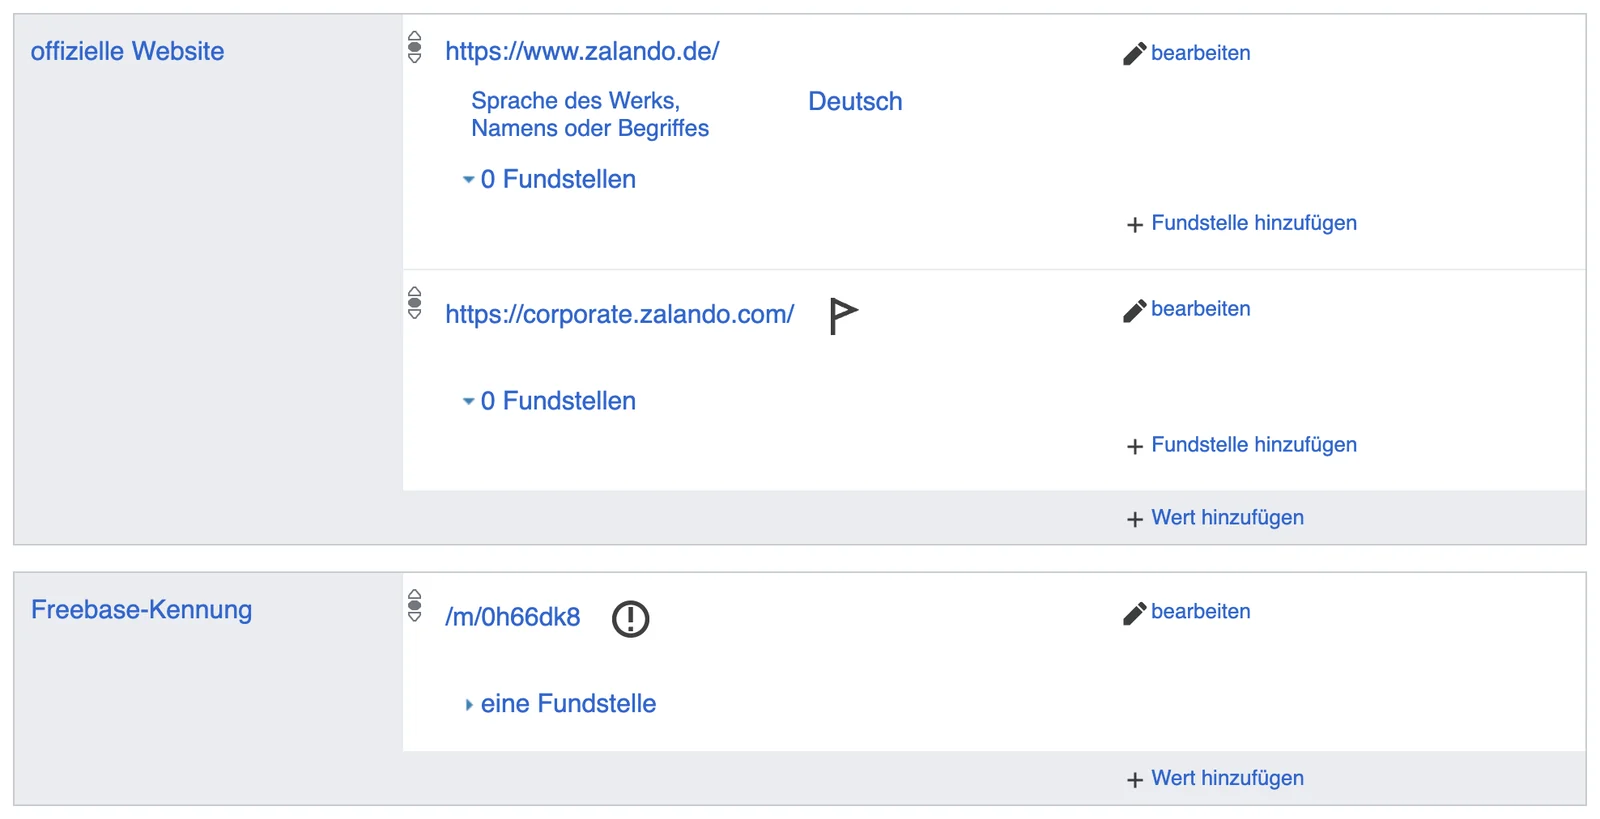
1. Der Knowledge-Graph-Check ist immer rot. In allen acht Messungen stand „Eintrag im Google Knowledge Graph“ auf „fehlt“, auch bei OTTO und Zalando. Dass beide im Knowledge Graph stehen, sieht man an ihren Knowledge Panels und an Wikidata, wo beide eine Freebase-Kennung haben, also eine alte Knowledge-Graph-ID. Mit 9 Punkten ist es eines der schwersten Signale, nur die Entität selbst (12) und sameAs (10) wiegen mehr. Wie das Tool den Knowledge Graph abfragt, ist nicht einsehbar.
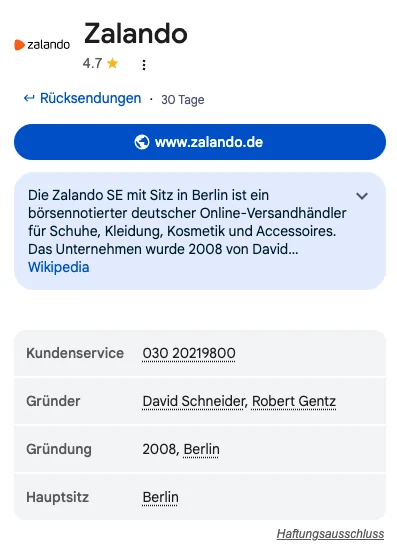
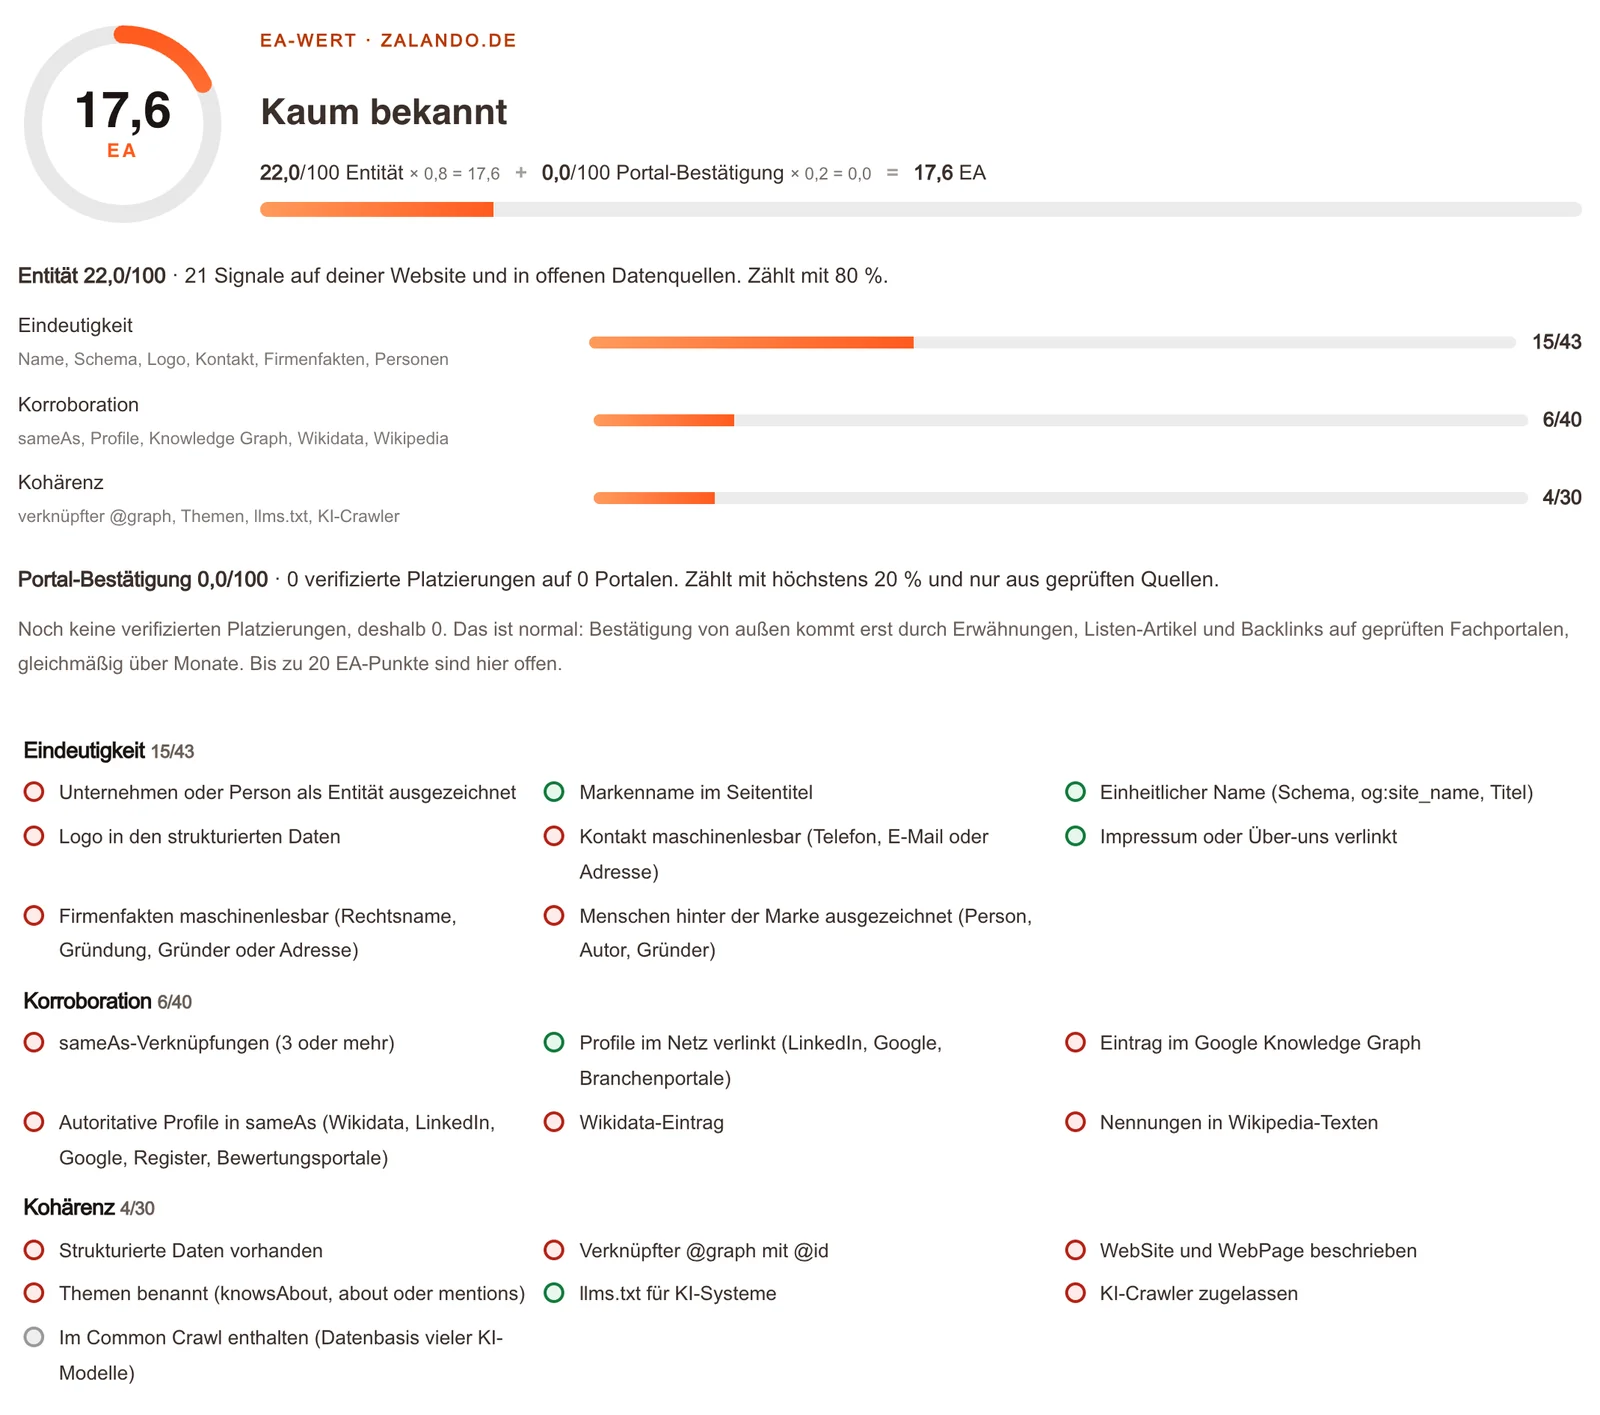
2. Wikidata und Wikipedia werden offenbar über den Namen gesucht. Zalando hat auf Wikidata den Eintrag Q136570 mit zalando.de als offizieller Website und einen eigenen Wikipedia-Artikel. Das Tool zeigt bei beidem „fehlt“, vermutlich weil die Startseite von Zalando keinen Markennamen im Schema hat. Bei OTTO sind beide grün. Die Wikidata-Suche nach „OTTO“ liefert aber zuerst den Vornamen Otto, und „OTTO“ kommt in Wikipedia über 150.000-mal vor. Ein Abgleich über die Domain findet offenbar nicht statt. Bei example.com war „Nennungen in Wikipedia“ grün.
3. Gleiche Website, verschiedene Werte. Answer the Web verspricht: „Gleiche Website, gleicher Wert.“ Das stimmt nur, solange die Common-Crawl-Abfrage gleich ausfällt. In sieben von acht Messungen war sie grau („nicht prüfbar“), einmal grün. Graue Signale fallen aus Zähler und Nenner heraus. Für pastaweb.de heißt das: grau 40,0, grün 41,6, rot 37,6, ohne dass sich an der Seite etwas ändert. Im Rechner weiter unten kannst du das selbst umschalten.
4. Ein Feld zählt, egal was drinsteht. Bei pastaweb.de ist „Themen benannt“ grün, weil die WebPage per about auf die eigene Organisation verweist. Ein Thema steht dort nicht. „Markenname im Seitentitel“ ist rot, obwohl „Pastaweb“ im Titel steht, weil im Schema der längere Name „Pastaweb: Alles rund um gutes Essen“ steht. Gleichzeitig ist „Einheitlicher Name (Schema, og:site_name, Titel)“ grün, obwohl Titel und Schema-Name eben nicht gleich sind. Bei einer weiteren Seite aus meinem Umfeld zählte das Tool eine E-Mail-Angabe ohne @ als Kontakt und eine Person namens „admin“ als Mensch hinter der Marke.
5. Nur JSON-LD auf der Startseite. Microdata, die ältere Form strukturierter Daten, zählt nicht. Ein Shop, der sein Schema als Microdata ausgibt, startet bei „Strukturierte Daten vorhanden“ mit Rot. Seiten mit Bot-Schutz wie idealo misst das Tool gar nicht. Und bei den KI-Crawlern prüft es auch Trainings-Crawler wie GPTBot und Google-Extended. Zalando ist dort rot, weil es GPTBot, ClaudeBot und Google-Extended aussperrt. Für Zitate in ChatGPT und Claude zählen aber die Such-Crawler OAI-SearchBot und Claude-SearchBot, und Google-Extended hat laut Google keinen Einfluss auf die Google-Suche.
Die 20 Prozent von außen
Der zweite Teil des Werts, die Portal-Bestätigung, zählt laut Methode „nur veröffentlichte Platzierungen aus dem verifizierten Answer-the-Web-Portfolio“. Presseberichte, Fachartikel, Bewertungen oder Erwähnungen auf allen anderen Seiten des Internets fließen dort nicht ein. Alle sechs gezeigten Domains haben 0 von 100, auch OTTO und Zalando. Wer die 20 Punkte will, muss Platzierungen bei Answer the Web buchen. Direkt unter dem Ergebnis bietet die Seite dafür den „Entity Authority Boost“ an: drei Monate, 135 Platzierungen, 990 Euro.
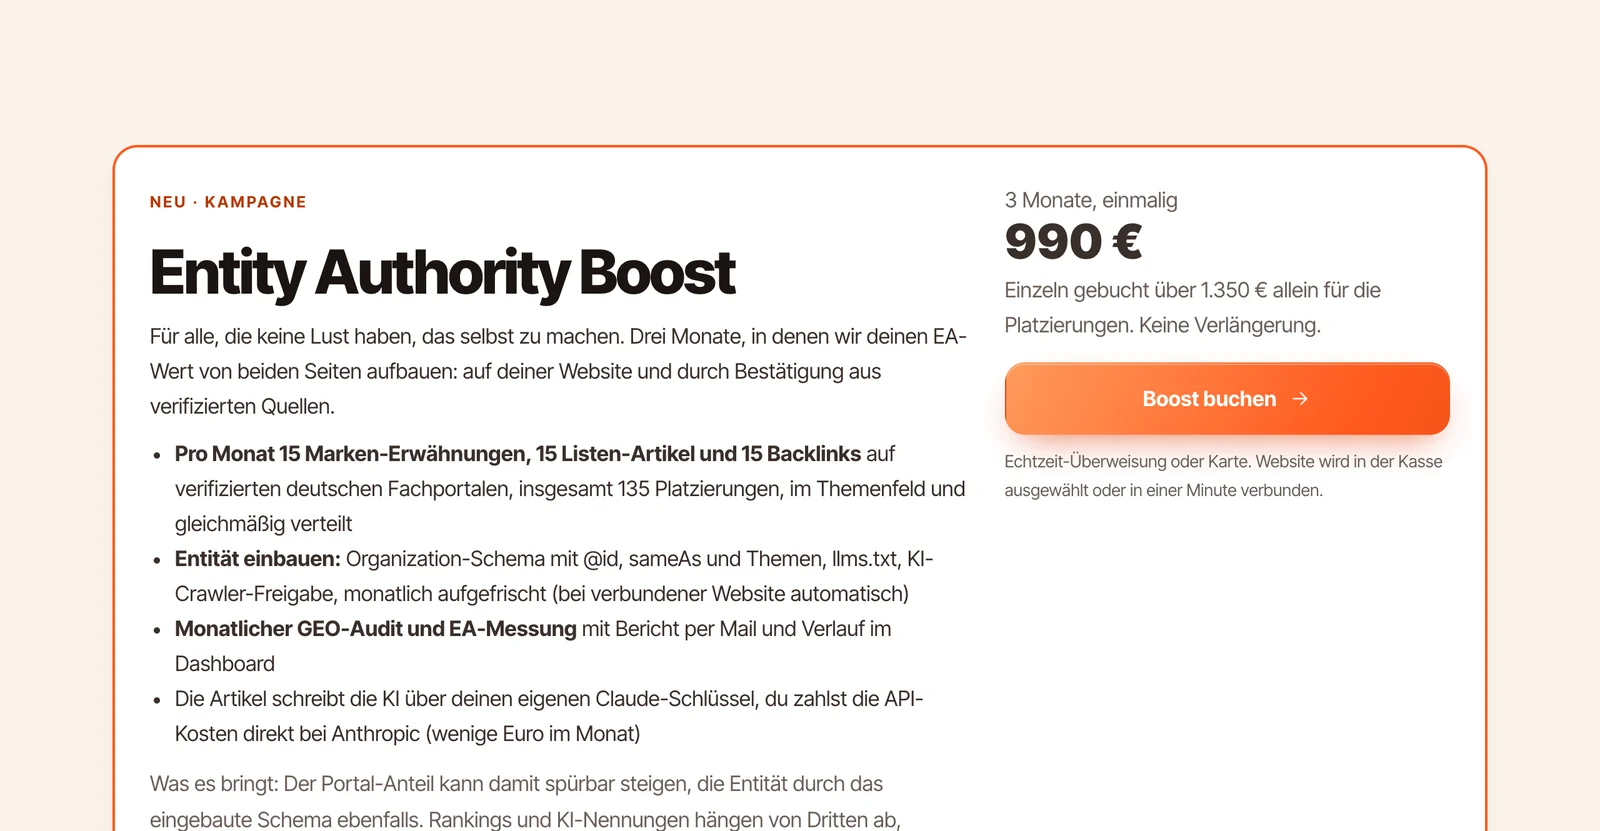
Für die Einordnung des Werts ist das wichtig. Auf der Seite steht: „Deshalb lässt sich der EA-Wert nicht kaufen, nur verdienen.“ Die 80 Punkte für die Entität kannst du tatsächlich selbst erreichen, mit Markup auf deiner Startseite. Die restlichen 20 Punkte gibt es nur für gekaufte Platzierungen. Die Ahrefs-Studie, auf die sich die Seite beruft, misst dagegen Erwähnungen im ganzen Web, und Google schreibt in seinem Leitfaden, unechte Erwähnungen seien nicht so hilfreich, wie es scheint. Answer the Web weist beim Boost fair darauf hin, dass Rankings und KI-Nennungen von Dritten abhängen. In Version 2 sind die Platzierungen nur noch ein Bonus, dazu gleich mehr.
Was an Version 1 schon gut war
Der EA-Wert ist kostenlos, braucht keine Anmeldung und legt seine Formel offen, auch wenn die Gewichte fehlen. Er misst nachvollziehbare Ja-oder-Nein-Dinge statt einer KI-Schätzung, und viele seiner To-dos sind vernünftig: ein Name, der überall gleich geschrieben wird, ein sauberes Organization-Schema, verlinkte Profile mit identischen Firmendaten. Auch der Hinweis, Wikidata erst anzulegen, wenn es unabhängige Belege gibt, ist richtig. Als Checkliste für die Grundlagen taugte Version 1. Als Maß dafür, ob eine Maschine eine Marke kennt, taugte sie nach meinen Messungen nicht.
Version 2: Was Answer the Web nach meinem Test geändert hat
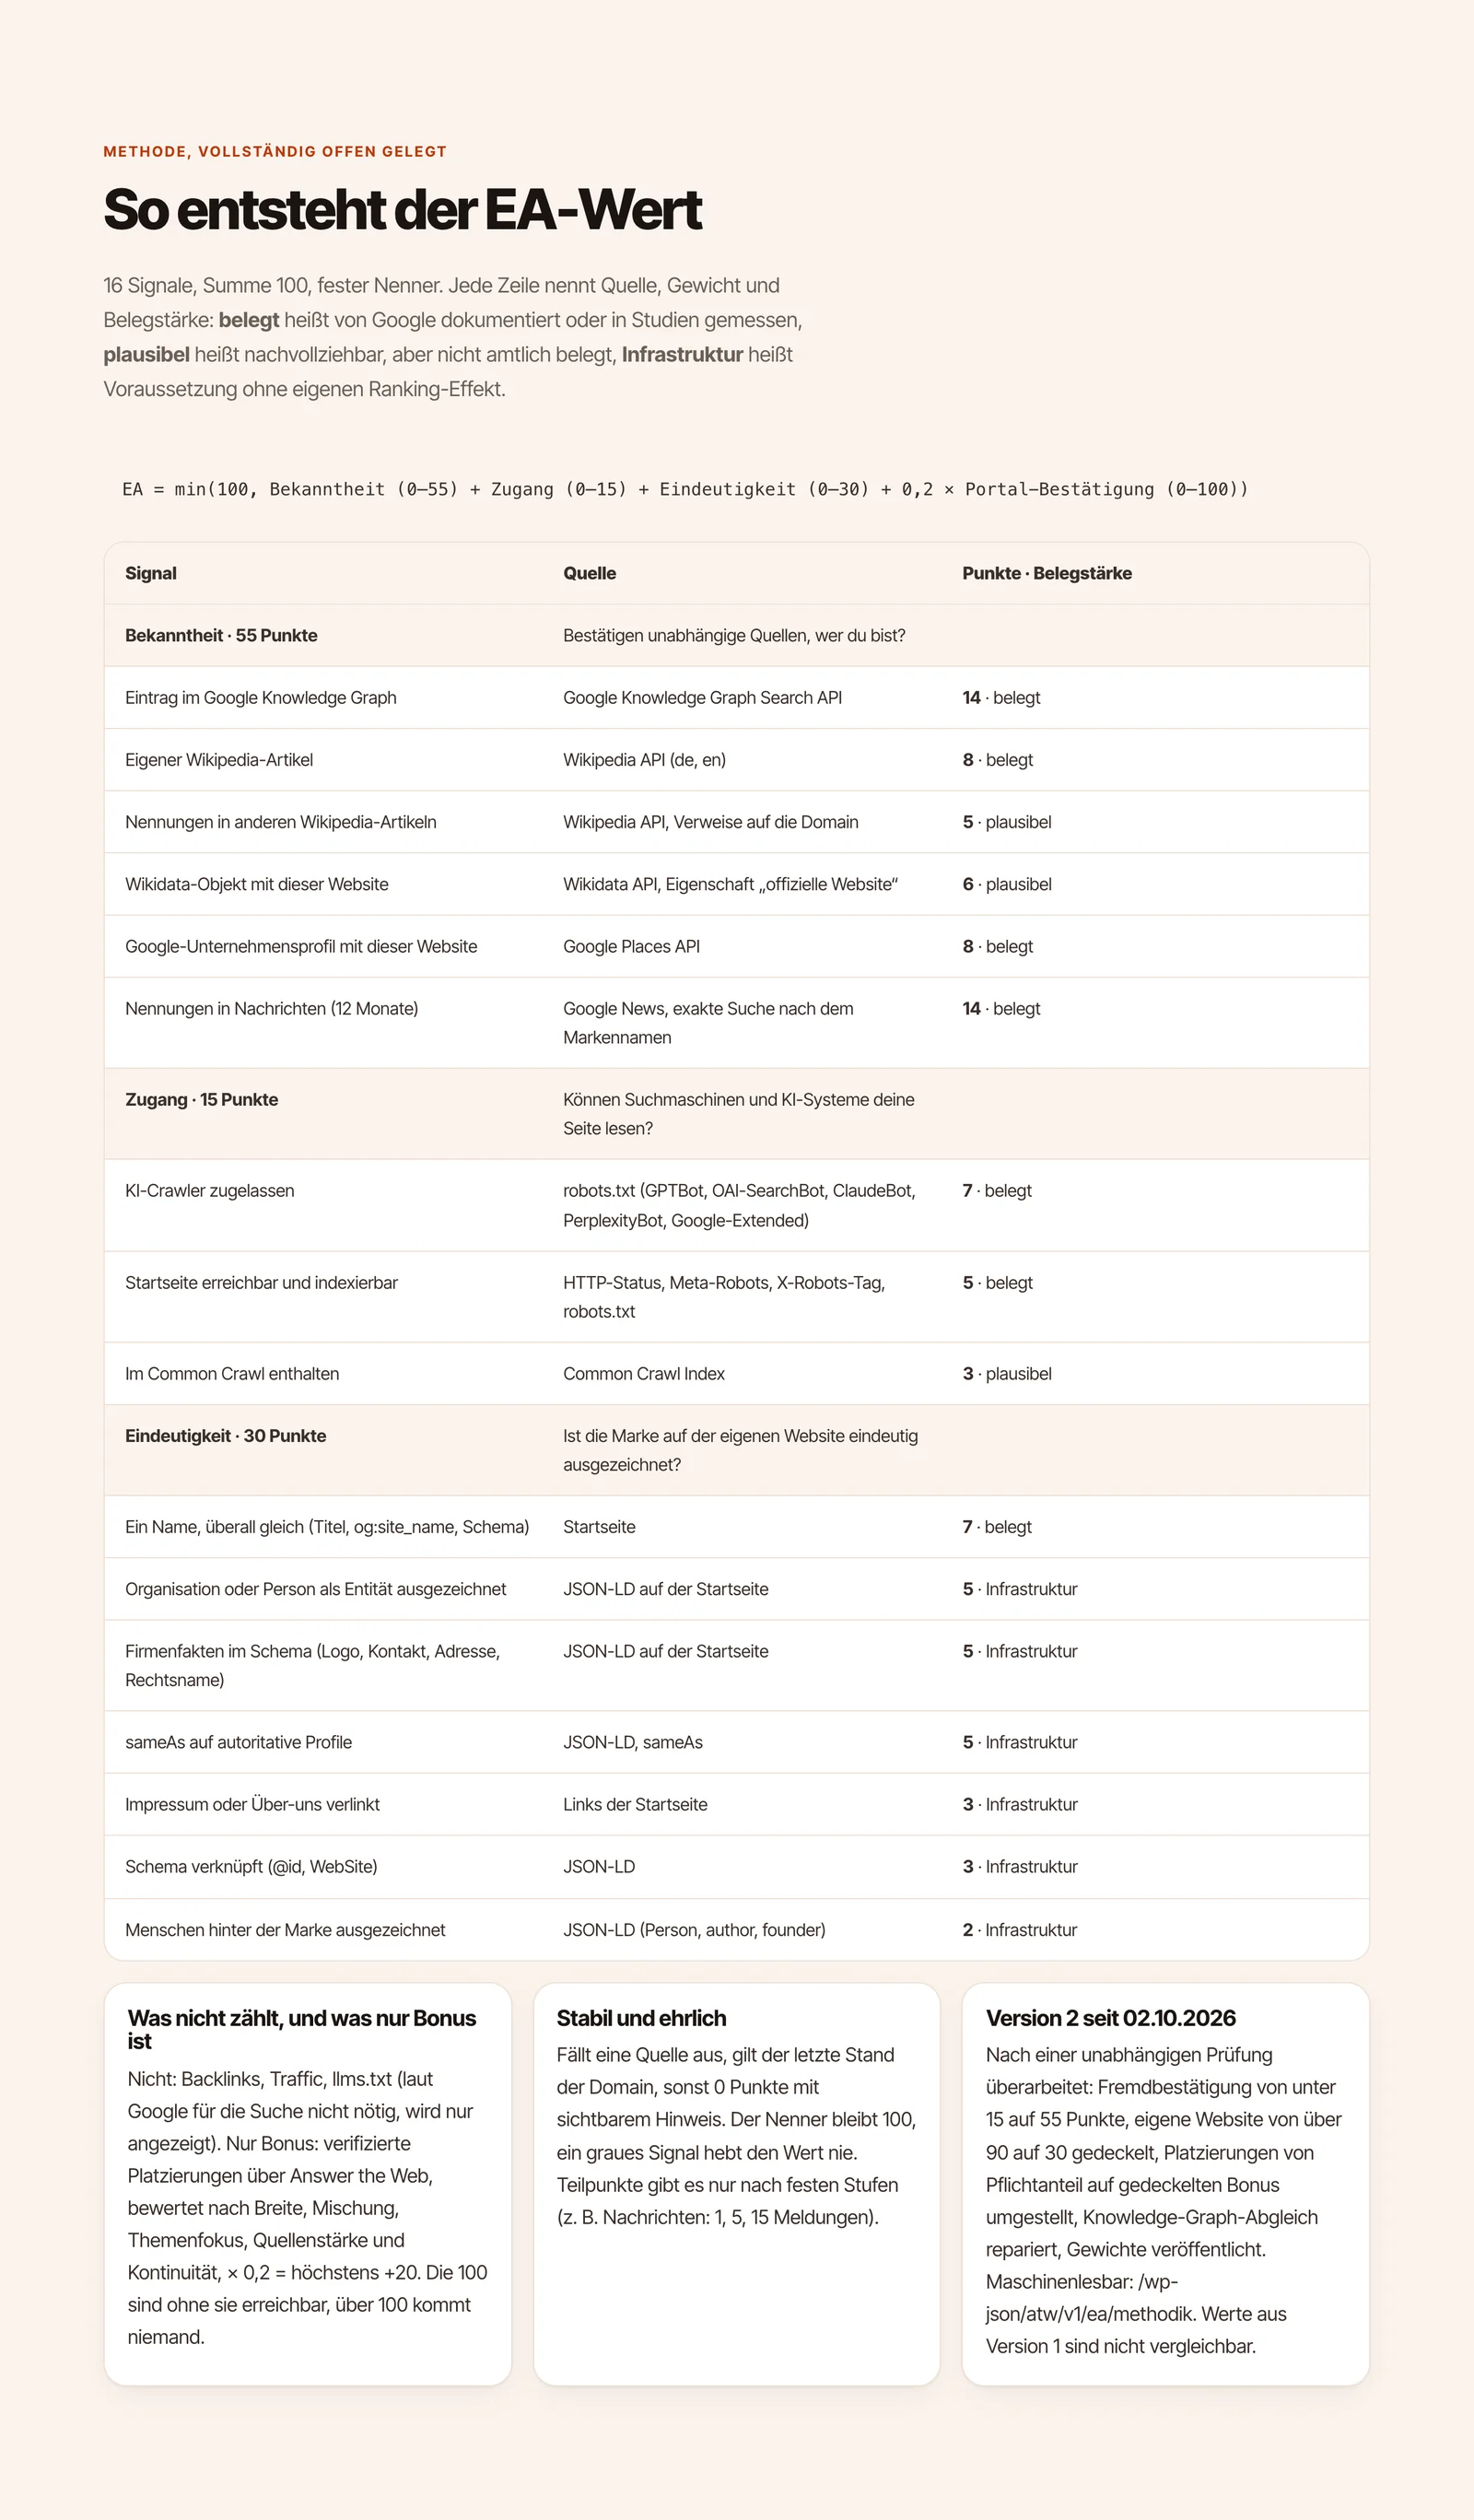
Am Abend des 2. Oktober stand auf answertheweb.com eine neue Fassung. Im Abschnitt zur Methode heißt es: „Version 2 seit 02.10.2026. Nach einer unabhängigen Prüfung überarbeitet“. Die Änderungen decken sich weitgehend mit den Punkten aus meinem Test:
- Bestätigung von außen zählt am meisten: 55 von 100 Punkten statt weniger als 15. Geprüft werden der Knowledge Graph, ein eigener Wikipedia-Artikel, Verweise aus Wikipedia auf die Domain, ein Wikidata-Objekt mit dieser Website als offizieller Website, ein Google-Unternehmensprofil mit dieser Website und Nennungen in Nachrichten der letzten 12 Monate.
- Die eigene Website ist gedeckelt: höchstens 30 Punkte für Name, Schema und Firmenfakten, dazu 15 für den Zugang, also KI-Crawler, Indexierbarkeit und Common Crawl.
- Fester Nenner: Die Summe ist immer 100, ein graues Signal zählt 0 und hebt den Wert nicht mehr. Damit ist die Schwankung durch Common Crawl weg.
- Keine Punkte mehr für llms.txt, mit dem Hinweis, Google brauche sie für die Suche nicht.
- Platzierungen sind nur noch Bonus: höchstens 20 Punkte obendrauf, der Wert bleibt bei 100 gedeckelt, und 100 sind ohne gekaufte Platzierungen erreichbar.
- Alle Gewichte sind offen, auf der Seite und maschinenlesbar als JSON, jedes mit einer Einstufung als belegt, plausibel oder Infrastruktur. Der Knowledge-Graph-Abgleich ist repariert.
Meine Messungen mit Version 2
Ich habe am 02.10.2026 zwischen 19:37 und 21:31 Uhr und am 03.10.2026 um 9:12 Uhr neu gemessen:
| Domain | Version 1 | Version 2 | Bekanntheit (55) | Zugang (15) | Eindeutigkeit (30) |
|---|---|---|---|---|---|
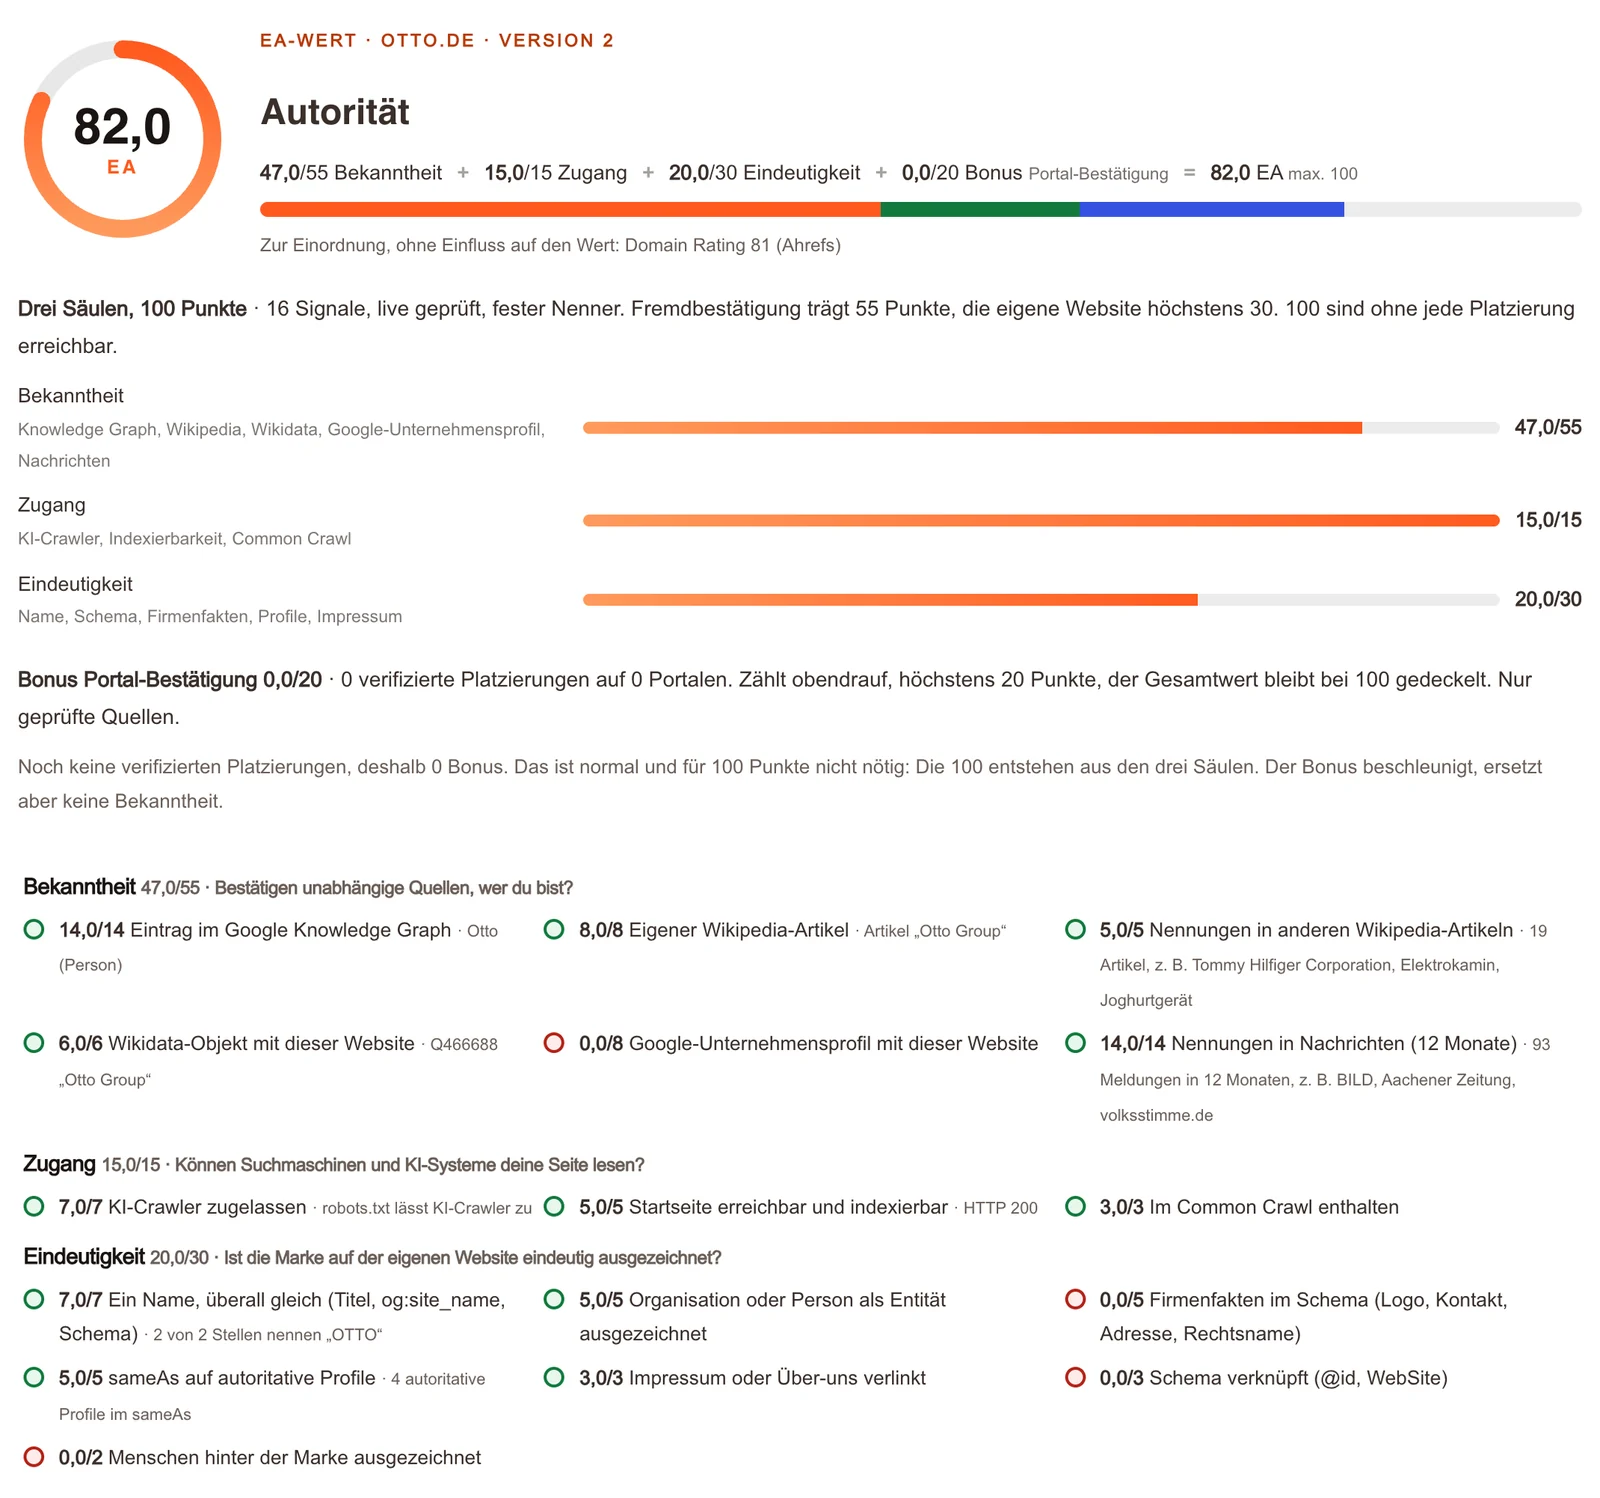
| otto.de | 44,0 | 82,0 Autorität | 47 | 15 | 20 |
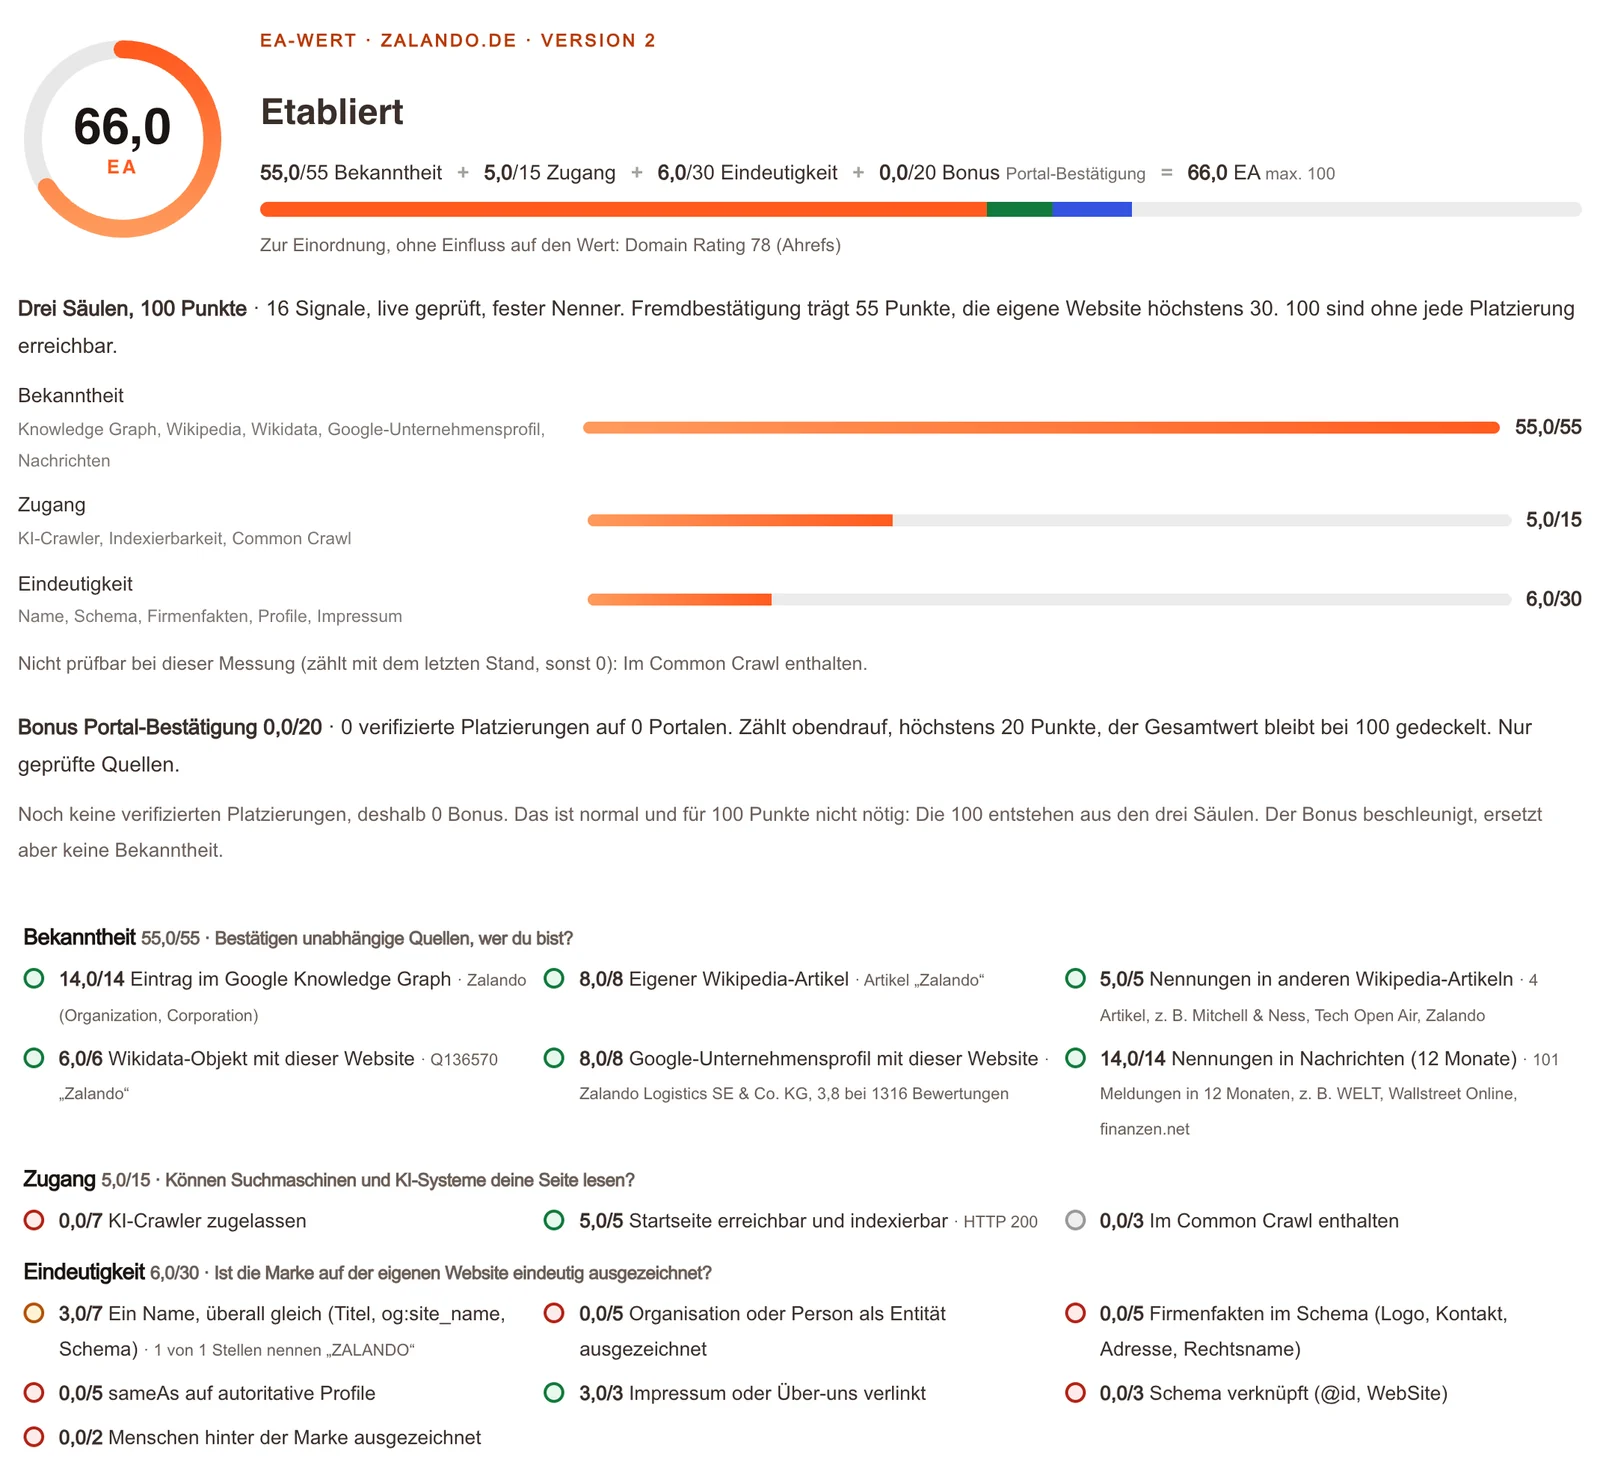
| zalando.de | 17,6 | 66,0 Etabliert | 55 | 5 | 6 |
| seorado.denach der Schema-Änderung | 40,0 | 37,0 Im Aufbau | 0 | 12 | 25 |
| answertheweb.comdas Tool selbst | 48,8 | 35,0 Im Aufbau | 0 | 12 | 23 |
| pastaweb.demein Food-Magazin | 40,0 | 33,0 Im Aufbau | 0 | 12 | 21 |
| chaoshund.deein Projekt von mir | nicht gemessen | 28,0 Kaum bekannt | 0 | 12 | 16 |
| pferdekumpel.deein Projekt von mir | nicht gemessen | 21,0 Kaum bekannt | 0 | 15 | 6 |
| example.comPlatzhalter-Domain ohne Firma | 18,4 | 27,0 Kaum bekannt | 9 | 15 | 3 |
| opal-schmiede.comOnline-Shop, einer meiner Kunden | 14,4 | 33,0 Im Aufbau | 8 | 15 | 10 |
Die Reihenfolge ergibt jetzt Sinn. OTTO und Zalando, die jeder kennt, liegen klar vorn. Zalando hat in der Bekanntheit sogar die vollen 55 Punkte: Knowledge Graph, Wikipedia-Artikel, Wikidata, Google-Profil und über 100 Meldungen in den Nachrichten. Seorado, das Tool selbst und meine kleinen Projekte haben keine Bestätigung von außen und landen zwischen 21 und 37. Kurios bleibt example.com: Die Platzhalter-Domain hat einen Wikidata-Eintrag und wird in zwei Wikipedia-Artikeln erwähnt, das bringt 9 Punkte Bekanntheit und insgesamt 27,0, mehr als mein Projekt pferdekumpel.de. Version 2 misst eben, ob eine Domain bekannt ist, nicht, ob eine Firma dahintersteht. Mein Schema-Umbau bringt seorado jetzt 25 von 30 möglichen Punkten in der Eindeutigkeit, mehr geht über Markup nicht. Genau so sollte es sein.
Spannend ist die Opal-Schmiede, ein Online-Shop für Opale und Edelsteinschmuck, den ich betreue. Sie kommt in Version 2 auf 33,0, und die 8 Punkte Bekanntheit stammen allein aus dem Google-Unternehmensprofil mit 58 Bewertungen und 5,0 Sternen. Trotzdem haben die KIs in meinem GEO-Test die Opal-Schmiede in 23 von 46 Antworten zu Opalen und Edelsteinen genannt oder als Quelle zitiert. Für einen Nischenshop gibt es keine Wikipedia-Artikel und kaum Nachrichten, sichtbar wird er über gute Inhalte, echte Preise und zufriedene Kunden. Das misst auch Version 2 nicht.
Was offen bleibt
- Die Suche über den Namen. Die 14 Punkte für den Knowledge Graph bekam OTTO für einen Treffer namens „Otto (Person)“, also nicht für die Otto Group. Ich habe es mit der Knowledge Graph Search API nachgestellt: Die Suche nach „OTTO“ liefert auf Deutsch zuerst Motorenbenzin, Otto Warmbier und den Film „Ein Mann namens Otto“. Auch die 93 Nachrichten-Treffer für „OTTO“ dürften viele Menschen namens Otto enthalten. Bei Allerweltsnamen bleibt der Wert damit unsicher.
- KI-Crawler. Geprüft werden weiter auch Trainings-Crawler wie GPTBot und Google-Extended. Zalando sperrt sie und bekommt dafür 0 von 7 Punkten, obwohl die Such-Crawler, die für Zitate in ChatGPT oder Claude zählen, zugelassen sind.
- Belegstärke. Answer the Web stuft Nachrichten und Knowledge Graph als „belegt“ ein. Belegt ist aber nur, dass Erwähnungen mit KI-Sichtbarkeit zusammenhängen, etwa in der Ahrefs-Studie. Dass sie die Ursache sind, zeigt keine Studie.
Was jetzt gut ist
Innerhalb eines Tages hat Answer the Web fast alle Punkte aufgegriffen, die ich an Version 1 kritisiert habe, und die Gewichte vollständig offengelegt. Das erlebe ich bei Tool-Anbietern selten. Version 2 fragt jetzt das, was die Studien als stärksten Zusammenhang zeigen: Bestätigen andere, wer du bist? Wer seine Website verbessert, bekommt dafür höchstens 30 Punkte, und das ist ehrlich. Für eine schnelle Einordnung der eigenen Marke ist Version 2 brauchbar, solange du den Knowledge-Graph- und den Nachrichten-Treffer bei einem häufigen Namen selbst prüfst.
Mit dem Rechner kannst du beide Versionen nachvollziehen. Lade eine der echten Messungen oder setz die Haken selbst und schalte zwischen Version 1 und Version 2 um.
Version 2: EA = Summe der 16 Signale, höchstens 100, dazu ein Bonus von bis zu 20 Punkten für Platzierungen bei Answer the Web, der hier immer 0 ist. Gewichte und die Einstufung belegt, plausibel oder Infrastruktur stammen von Answer the Web, die Einordnung dahinter von mir. Teilpunkte für 1 bis 14 Nachrichten-Meldungen sind meine Annahme, die Methodik nennt nur die Stufen 1, 5 und 15. Version 1: Entität = erfüllte Punkte geteilt durch die Punkte aller prüfbaren Signale, auf eine ganze Zahl gerundet, EA = 0,8 × Entität; graue Signale fallen aus der Rechnung. Vorlagen: meine Messungen vom 01. und 02.10.2026, „seorado.de nachher“ in Version 1 ist mein Nachbau nach der Schema-Änderung.
Das Fallbeispiel rund-helden.de
Elci stützt seine These auf einen Fall aus der Praxis: rund-helden.de, ein Hersteller von Rundbogenhallen und Weidezelten aus dem Berchtesgadener Land. Im Februar 2026 lag der Sichtbarkeitsindex bei Sistrix bei 0,018. Laut Elcis Folien waren 15 von 22 Artikeln ohne internen Link, als Autor stand im Schema „admin2025“, und zwei Artikel kannibalisierten sich. Bis September stieg die Sichtbarkeit auf das 7,8-Fache, die Seite steht für „Weidezelt“ und „Rundbogenhalle“ auf Platz 1 und wird in 127 Fragen im KI-Modus zitiert.
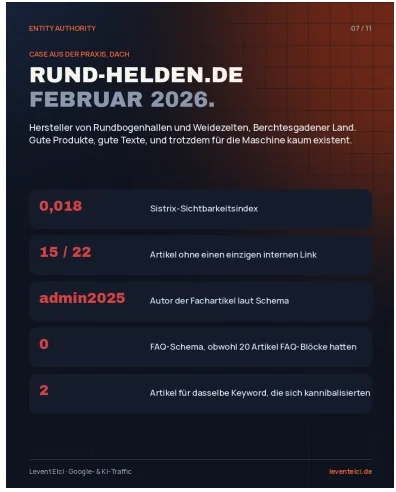
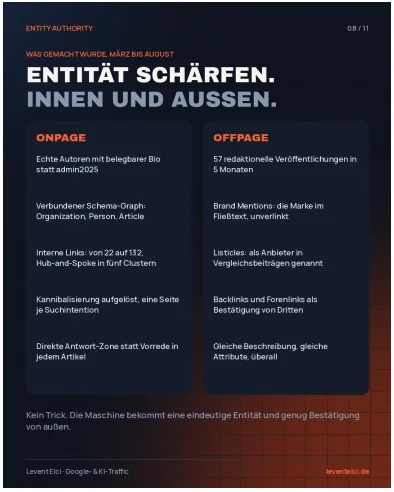
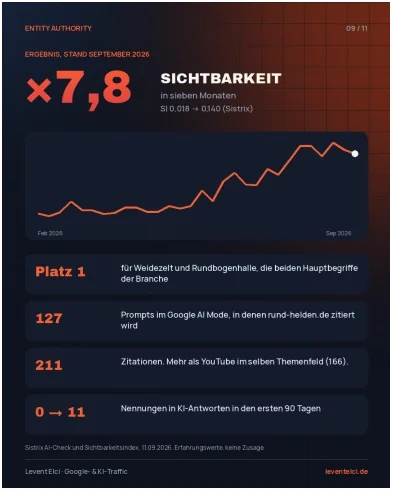
Das ist gute, gründliche SEO-Arbeit, und der Erfolg sei dem Betrieb gegönnt. Schaut man auf Folie 8, stehen dort aber neben dem Schema-Graphen auch 110 neue interne Links, eine neue Struktur in fünf Themenclustern, aufgelöste Kannibalisierung, umgebaute Artikel und 57 redaktionelle Veröffentlichungen in fünf Monaten. Jede dieser Maßnahmen kann eine Seite mit einem Sichtbarkeitsindex von 0,018 nach oben bringen. Welcher Anteil auf die „Entität“ entfällt, lässt sich aus dem Fall nicht ablesen. Elci schreibt selbst: „Erfahrungswerte, keine Zusage.“ Mit meinem Nachbau kommt rund-helden.de heute übrigens auf einen EA-Wert von 56,0: alle Website-Signale grün, bei der Korroboration 6 von 40 Punkten.
Mein Test: Haben die Betriebe, die KIs nennen, einen höheren EA-Wert?
Wenn der EA-Wert misst, ob eine Maschine eine Marke kennt, müssten Betriebe, die KI-Systeme empfehlen, im Schnitt höher liegen als Betriebe, die sie nicht nennen. Das lässt sich prüfen. Für meinen Beitrag Was ist GEO? habe ich am 30.09. und 01.10.2026 115 Fragen an ChatGPT, Gemini, den KI-Modus, Bing, Perplexity und Claude gestellt, darunter lokale Fragen wie „Kannst du mir einen guten Dachdecker in Stade empfehlen?“ oder „Welche freie Werkstatt in Hamburg ist ehrlich und günstig?“. 44 Betriebe wurden dabei genannt oder als Quelle zitiert.
Erster Befund: Keiner davon braucht Wikidata. Ich habe für alle 44 Domains geprüft, ob es einen Wikidata-Eintrag mit dieser Website gibt. Ergebnis: 0 von 44. Einen Eintrag überhaupt hat nur ein Teleshopping-Sender, und der verweist auf eine französische Domain. Alle lokalen Betriebe wurden ohne Wikidata und ohne Wikipedia genannt. Für Elcis These „Wen der Graph nicht kennt, kann er nicht zitieren“ heißt das: Wikidata und Wikipedia sind dafür keine Voraussetzung. Was diese Betriebe haben, ist ein Unternehmensprofil bei Google, und das ist für lokale Betriebe der Eintrag im Knowledge Graph.
Zweiter Befund: Der EA-Wert trennt genannte und nicht genannte Betriebe nicht. Für den Vergleich habe ich am 02.10.2026 in Google Maps die Betriebe gesammelt, die für dieselben Fragen in Stade, Buxtehude und Hamburg erscheinen, ohne Anzeigen, Ketten und Betriebe ohne eigene Website. Dann habe ich den EA-Wert mit eigenen Skripten nachgebaut, um das Tool nicht mit 90 Abfragen zu belasten, zuerst Version 1 und nach dem Umbau auch Version 2. Beide habe ich an echten Messungen geeicht: Der Nachbau von Version 1 bewertete alle 147 Signale genauso wie das Tool, der von Version 2 traf 111 von 112. Abweichend war nur die Common-Crawl-Prüfung, die im Tool selbst oft nicht antwortet. Für den Knowledge Graph nutzt der Nachbau wie das Tool die Knowledge Graph Search API von Google, für die Nachrichten die Google-News-Suche mit dem exakten Namen.
Anzahl Google-Bewertungen, logarithmische Achse
| Branche | EA V1 | AUC V1 | EA V2 | AUC V2 | Bewertungen | AUC Bew. |
|---|---|---|---|---|---|---|
| Dachdecker | 32,8 / 29,6 | 0,58 | 36,0 / 35,0 | 0,50 | 14 / 16 | 0,46 |
| Fahrzeugaufbereiter | 39,2 / 21,6 | 0,65 | 38,0 / 30,0 | 0,64 | 134 / 80 | 0,62 |
| Kfz-Werkstätten | 28,8 / 32,0 | 0,38 | 36,0 / 38,0 | 0,43 | 228 / 120 | 0,72 |
| Alle drei Branchen | 32,8 / 29,6 | 0,56 0,43 bis 0,70 | 36,0 / 35,0 | 0,51 0,37 bis 0,64 | 55 / 51 | 0,52 0,38 bis 0,66 |
Methode: Für jede lokale Frage aus unserem GEO-Test (Dachdecker, Fahrzeugaufbereiter, Kfz-Werkstätten in Stade und Hamburg) habe ich am 02.10.2026 die passenden Google-Maps-Listen abgerufen, ohne Anzeigen, Ketten und Betriebe ohne eigene Website. „Genannt“ heißt: Der Betrieb kam in mindestens einer der 115 KI-Antworten vom 30.09. und 01.10.2026 vor (ChatGPT, Gemini, KI-Modus, Bing, Perplexity, Claude). Beide Versionen habe ich mit eigenen Skripten nachgebaut. Version 1 bewertete bei 7 echten Messungen alle 147 Signale genauso wie das Tool, Knowledge Graph zählt dort wie im Tool als rot, Common Crawl als grau. Version 2 traf bei 7 echten Messungen 111 von 112 Signalen, abweichend nur die im Tool unzuverlässige Common-Crawl-Prüfung. Sie fragt wie das Tool die Knowledge Graph Search API, Wikipedia und Wikidata ab, die Nachrichten über die Google-News-Suche mit dem exakten Namen; das Unternehmensprofil zählt für alle Betriebe, weil sie aus Google Maps stammen. Die Intervalle sind 95-Prozent-Bootstrap-Intervalle. Nicht messbar: 3 Betriebe (leere Startseite, Weiterleitung, fast leere Antwort). Namen der nicht genannten Betriebe zeige ich bewusst nicht.
Die genannten Betriebe liegen im Median bei 32,8, die nicht genannten bei 29,6. Die Trefferquote, also die Wahrscheinlichkeit, dass ein zufällig gezogener genannter Betrieb einen höheren Wert hat als ein zufällig gezogener nicht genannter, liegt bei 0,56. Ein Münzwurf läge bei 0,50, und das Intervall reicht von 0,43 bis 0,70, schließt den Zufall also ein. Bei den Werkstätten ist es sogar umgekehrt: Die genannten Werkstätten haben niedrigere EA-Werte, aber fast doppelt so viele Google-Bewertungen (Median 228 gegen 120).
Mit Version 2 ändert sich daran nichts. Die genannten Betriebe liegen im Median bei 36,0, die nicht genannten bei 35,0, die Trefferquote bei 0,51, mit einem Intervall von 0,37 bis 0,64. Der Grund ist einfach: Für lokale Betriebe ist die neue Säule Bekanntheit fast überall gleich. Alle haben ein Google-Unternehmensprofil, das bringt jedem 8 Punkte. Wikipedia und Wikidata bringen keinem etwas, und nur einer hat einen Treffer im Knowledge Graph, und der wurde von keiner KI genannt. Nachrichten-Treffer gab es nur bei nicht genannten Betrieben, und die meisten davon sind Namensverwechslungen: Ein Dachdecker, dessen Seitentitel mit „Stade“ endet, bekam als Markennamen „Stade“ und damit 100 Meldungen. Rechnet man die Nachrichten heraus, liegt die Trefferquote bei 0,55.
Weitere Zahlen aus dem Test, zu Version 1:
- 56 von 83 Handwerksbetrieben haben einen höheren EA-Wert als Zalando, 7 sogar einen höheren als OTTO.
- 46 von 83 Betrieben haben in der Säule Korroboration 0 Punkte. Kein einziger steht auf Wikidata, keiner wird aus der deutschen Wikipedia verlinkt. Für lokale Betriebe ist diese Säule fast immer leer, sie kann also kaum unterscheiden.
- 18 von 83 Betrieben haben eine llms.txt, meist automatisch von einem WordPress-Plugin erzeugt. Bei den genannten sind es 23 %, bei den nicht genannten 21 %.
- 6 von 83 Websites waren nur über unverschlüsseltes http erreichbar, weil ihr Zertifikat falsch oder veraltet eingerichtet ist. Das ist ein echtes Problem, für Kunden wie für Crawler.
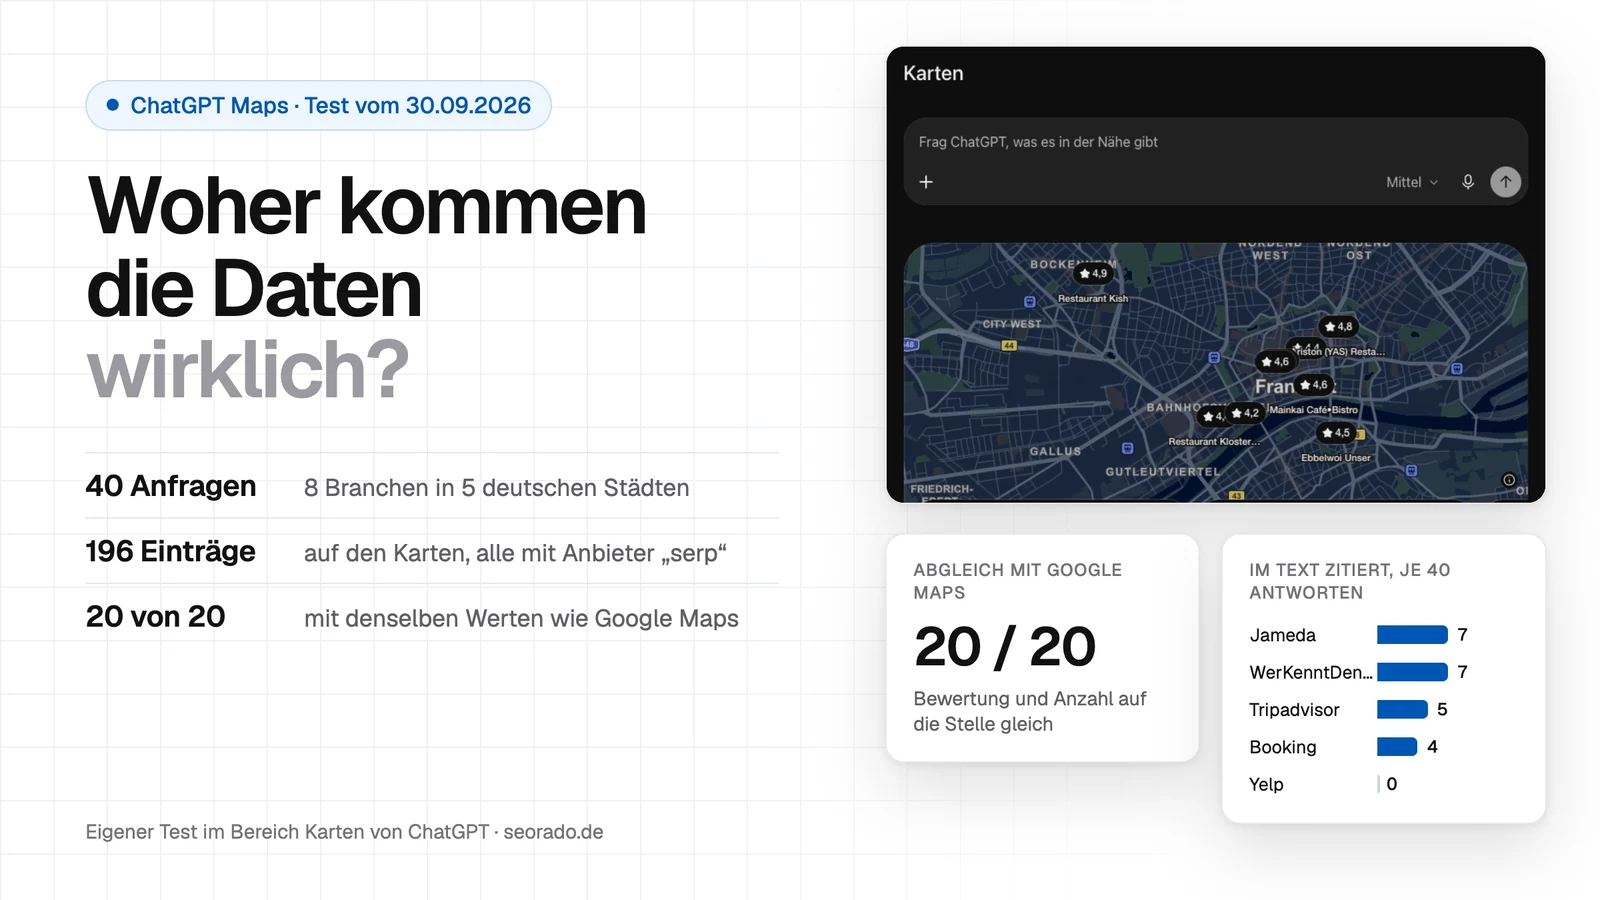
Auch die Google-Bewertungen trennen über alle drei Branchen kaum (Trefferquote 0,52), die Sterne gar nicht. Das ist wenig überraschend, denn alle Betriebe im Vergleich stehen ohnehin in Google Maps für die passende Suche. Welcher davon in einer KI-Antwort landet, hängt an mehr als an einer Zahl: an der Lage, an der Kategorie im Unternehmensprofil, an dem, was in den Bewertungen und auf der Website steht. In meinem Test von ChatGPT Maps stimmten 20 von 20 lokalen Empfehlungen mit Google Maps überein. Und im GEO-Test wurde eine Werkstatt ausdrücklich dafür empfohlen, dass sie ihre Preise auf der Website nennt.
Grenzen des Tests
Die Stichprobe ist klein: 26 genannte und 57 nicht genannte Betriebe, in den einzelnen Branchen teils nur 7 gegen 13. Jede KI-Frage habe ich nur einmal gestellt, und KI-Empfehlungen schwanken stark. Der Nachbau bildet das Tool bei den Website-Signalen genau ab. Wie Version 2 den Markennamen für Knowledge Graph und Nachrichten erkennt, habe ich nur an 7 Seiten geeicht, bei Seiten mit ungewöhnlichem Titel kann das echte Tool einen anderen Namen finden. Das Google-Profil zählt für alle Betriebe, weil sie aus Google Maps stammen. Der Test kann deshalb nicht beweisen, dass Entitäten egal sind. Er zeigt aber, dass der EA-Wert in drei typischen lokalen Branchen nicht erkennt, wen KIs empfehlen.
Mein Selbsttest: seorado vor und nach dem Schema-Umbau
Seorado lag in Version 1 bei 40,0. Rot waren unter anderem „Verknüpfter @graph mit @id“, „WebSite und WebPage beschrieben“ und „Themen benannt“. Ich habe das Schema meiner Startseite daraufhin umgebaut: Organisation, Person, WebSite, WebPage und Angebot sind jetzt über feste Kennungen verbunden, die WebPage verweist auf die Organisation, und die Organisation nennt ihre Themen mit knowsAbout. Das hat etwa 15 Minuten gedauert. In Version 1 hätte das nach meinem geeichten Nachbau 12 Punkte gebracht, von 40,0 auf 52,0. Nachmessen ließ sich das nicht mehr, weil Version 1 inzwischen abgelöst ist.
In Version 2 kommt seorado nach dem Umbau auf 37,0: 25 von 30 Punkten in der Eindeutigkeit, 12 von 15 beim Zugang und 0 von 55 bei der Bekanntheit. Das ist ehrlich. An seorado selbst hat sich durch den Umbau nichts geändert, keine neue Erwähnung, kein neues Profil, keine zusätzliche Bewertung. Mein Google-Unternehmensprofil ist noch nicht freigeschaltet, und über seorado berichtet bisher niemand. Das Schema lasse ich trotzdem drin: Es ist saubere Arbeit, kostet nichts und hilft Google, Name, Logo und Gründer richtig zuzuordnen.
Was wirklich hilft, sortiert nach Belegen
Die gute Nachricht: Vieles, was der EA-Wert abfragt, ist nicht falsch, nur falsch gewichtet. Das hier ist die Reihenfolge, die ich nach der Quellenlage und nach meinen Tests empfehle, für Online-Shops und lokale Betriebe gleichermaßen.
1. Erreichbar sein, für Menschen und für Crawler
Belegt ist: Wer OAI-SearchBot, Claude-SearchBot oder PerplexityBot aussperrt, taucht in deren Suchantworten nicht auf. Für Google reicht der normale Googlebot, Google-Extended steuert nur das Training von Gemini. Prüf deine robots.txt, deine Firewall und dein Zertifikat. Sechs von 83 Betrieben in meinem Test waren nur über http erreichbar.
2. Ein Name, überall gleich
Belegt für den Website-Namen bei Google, plausibel für alles andere: Schreib deinen Namen im Seitentitel, in og:site_name, im Schema, im Impressum, im Unternehmensprofil, bei LinkedIn und in allen Verzeichnissen gleich. Bing beschreibt, dass sein Index Widersprüche zwischen Quellen registriert, statt einfach eine Version zu nehmen. Für lokale Betriebe gilt dasselbe für Adresse und Telefonnummer.
3. Unternehmensprofile pflegen
Google rät in seinem KI-Leitfaden ausdrücklich, Merchant Center und Unternehmensprofil aktuell zu halten, Bing empfiehlt dasselbe für Bing Places. Für lokale Betriebe ist das Profil der Knowledge-Graph-Eintrag, und die Bewertungen darin sind das, was KI-Systeme über dich lesen. Wie du sie aufbaust, steht in meinem Beitrag zu Kundenbewertungen, kostenlose Einträge findest du in meiner Liste der Branchenbücher.
4. Ein sauberes Organization-Schema, als Grundlage
Belegt ist, dass Google Organization-Markup nutzt, um deine Firma zu erkennen und das Logo auszuwählen. Nicht belegt ist, dass es KI-Zitate bringt. Bau es deshalb einmal ordentlich auf die Startseite oder die Über-uns-Seite: Name, Rechtsname, Logo, Kontakt, Adresse, deine echten Profile als sameAs. Mehr braucht es nicht. Der Check hier zeigt dir, was eine Maschine heute auf deiner Startseite sieht, und baut dir die Vorlage.
robots.txt und llms.txt mitprüfen (optional)
Schema-Vorlage für deine Startseite
Werte aus der Prüfung werden übernommen, wenn die Felder leer sind. Trag nur ein, was auch sichtbar auf deiner Website steht. Google verlangt keine Pflichtfelder und empfiehlt, die Angaben auf die Startseite oder die Über-uns-Seite zu setzen.
Der Check bildet nach, wie der EA-Wert die Startseite liest (gezählt wird nur JSON-LD, Microdata nicht). Bei 5 echten Startseiten lieferte er dieselben Ergebnisse wie mein geeichtes Prüfskript, 75 von 75 Signalen. Knowledge Graph, Wikidata, Wikipedia und Common Crawl prüft das Tool in fremden Datenquellen, die kann ein Browser nicht abfragen. Ein grüner Haken heißt nur, dass ein Feld vorhanden ist, nicht, dass es dir bei Google oder in KI-Antworten hilft.
5. Echte Erwähnungen auf fremden Seiten
Am stärksten hängen KI-Nennungen mit dem zusammen, was andere über dich schreiben: Erwähnungen im Web, auf YouTube, in Fachmedien, Vergleichen und Foren. Das ist Korrelation, aber sie zeigt in jeder Studie in dieselbe Richtung, und die Forschung zu Sprachmodellen bestätigt den Kern: Modelle wissen mehr über Dinge, die in ihren Trainingsdaten oft vorkommen. Erwähnungen entstehen durch Arbeit, die Menschen interessiert: eigene Zahlen, ehrliche Vergleiche, gute Antworten in Foren, Pressearbeit. Wie das für einzelne Branchen aussieht, habe ich in Was ist GEO? beschrieben, die Grundlagen zum Markenaufbau in Search Brand Optimierung.
6. Wikidata und Wikipedia erst mit Belegen
Wikipedia ist eine der wichtigsten Quellen für KI-Systeme, für die meisten Firmen aber unerreichbar. Die deutsche Wikipedia hält Unternehmen zum Beispiel ab 1.000 Vollzeitmitarbeitern oder 100 Millionen Euro Jahresumsatz für relevant, und selbst geschriebene Artikel im Interessenkonflikt sind unerwünscht. Wikidata ist offener, aber ein Eintrag über die eigene Firma ohne unabhängige Belege wird gelöscht. The GEO Lab hat dokumentiert, wie ein solcher Eintrag nach 14 Stunden wieder verschwand. Erst Presse und Fachartikel, dann Wikidata.
Was du dir sparen kannst
- llms.txt für Google: Google nutzt sie nicht. Für Coding-Agents kann sie nützlich sein, für deine Sichtbarkeit nicht.
- Themen-Listen im Schema: knowsAbout steht nicht in Googles Doku, und Markup soll nur zeigen, was auch sichtbar auf der Seite steht.
- Gekaufte Erwähnungen in Masse: Google hält unechte Erwähnungen für weniger hilfreich, als es scheint, und Linkkauf ohne Kennzeichnung verstößt gegen Googles Spam-Richtlinien.
- Scores als Ziel: Kein Tool kennt Googles interne Daten. Ein höherer Wert in einem Tool ist kein Beleg für mehr Sichtbarkeit.
Wenn du das für deinen Shop oder Betrieb nicht selbst machen willst: Genau diese Reihenfolge ist Teil meiner Leistung GEO und KI-Sichtbarkeit, ohne Score-Versprechen und mit Messung über die Search Console und eigene Tests.
Was die Community sagt
In Foren und Fachblogs ist die Diskussion um Entitäten nüchterner als auf LinkedIn. Einige Stimmen und Fälle, die mir bei der Recherche aufgefallen sind:
- Knowledge Panels brauchen Geduld. Jason Barnard beschreibt bei Search Engine Land, wie er Danny Goodwin, den Chefredakteur von Search Engine Land, von einem gleichnamigen Baseballspieler getrennt hat: eine einfache Seite als zentrale Quelle mit einem klaren Satz, wer Goodwin ist, und dieselbe Beschreibung auf allen Profilen. Bis zur eigenen Knowledge-Graph-ID dauerte es 4 Monate, bis zu den Panel-Karten 6 und bis zu „Ähnliche Suchanfragen“ 12. Barnard verkauft genau diese Leistung.
- Gleicher Knowledge-Graph-Eintrag, andere Empfehlungen. Eine Studie bei Search Engine Land vom Juni 2026 zeigt: Nike, New Balance und Reebok haben im Knowledge Graph dieselbe Beschreibung, „Footwear company“. Bei Fragen nach Athleisure empfahlen die KI-Systeme Nike in 71 % der Antworten, die beiden anderen in 0 %. Die Autoren führen den Unterschied darauf zurück, wie oft die Marken im Netz gemeinsam mit der Kategorie und mit anderen Marken genannt werden.
- Eine neue Entität im Langzeittest. Ein Nutzer in r/TechSEO hat eine neue Entität mit festen Kennungen und Wikidata aufgebaut und 99 Tage gemessen. Bei direkten Fragen nach dem Namen kam sie in 72 % der Antworten vor, bei Empfehlungsfragen nach Ähnlichem in 0 von rund 700. Entitäts-Arbeit hilft also, wenn jemand nach dir fragt, macht dich aber nicht zur Empfehlung.
- llms.txt in den Logs. Kai Spriestersbach zitiert OtterlyAI: Von 62.100 Abrufen durch KI-Bots gingen 84 an die llms.txt, 0,1 %. SE Ranking fand bei 300.000 Domains keinen Zusammenhang zwischen llms.txt und Zitaten.
- Skepsis gegenüber neuen Etiketten. Lily Ray beschreibt in ihrem Jahresrückblick 2025 einen „Acronym Gold Rush“ rund um GEO, Mark Williams-Cook fasst es so: Schema ist gut, die Grundlagen als magische neue GEO-Formel zu verpacken, ist es nicht.
Häufige Fragen
Was ist Entity Authority?
Ein Begriff aus der SEO-Beratung für das Vertrauen, das Suchmaschinen und KI-Systeme in eine Entität haben, also in eine Firma, Marke oder Person mit eindeutiger Identität. Google verwendet den Begriff nicht. Belegt ist, dass Google Entitäten im Knowledge Graph führt und dass der KI-Modus darauf zugreift.
Ist der EA-Wert eine Kennzahl von Google?
Nein. Der EA-Wert ist eine Metrik der Agentur Answer the Web, gestartet am 01.10.2026, seit dem 02.10.2026 in Version 2. Levent Elci schreibt selbst, es sei kein offizieller Google-Score. Google betont, dass Drittanbieter-Tools keinen Zugang zu internen Daten haben.
Wie aussagekräftig ist der EA-Wert?
Version 2 ist deutlich besser als Version 1: Bekannte Marken liegen vorn, Markup bringt höchstens 30 Punkte, alle Gewichte sind offen. Für eine erste Einordnung der eigenen Marke ist sie brauchbar. Bei häufigen Namen solltest du den Knowledge-Graph- und den Nachrichten-Treffer selbst prüfen. Und für lokale Betriebe sagt der Wert in meinem Test nicht voraus, wen KIs empfehlen.
Brauche ich einen Wikidata-Eintrag, damit KI mich nennt?
Nein. Keiner der 44 Betriebe, die KIs in meinem GEO-Test genannt haben, steht mit seiner Website auf Wikidata. Ein Eintrag ohne unabhängige Belege wird außerdem schnell gelöscht.
Bringt sameAs im Schema etwas?
Google kennt sameAs und nutzt es, um Profile einer Organisation zuzuordnen, ohne Mindestzahl. Trag deine echten Profile ein, wenn du ohnehin ein Organization-Schema hast. Dass das mehr KI-Nennungen bringt, ist nicht belegt.
Brauche ich eine llms.txt für Entity Authority?
Für Google nicht, Google nutzt sie laut eigener Aussage weder positiv noch negativ. Kein KI-Anbieter hat bestätigt, sie für Antworten zu lesen.
Kann man Entity Authority kaufen?
In Version 1 gab es die 20 Prozent Portal-Bestätigung nur für Platzierungen bei Answer the Web. In Version 2 sind sie ein Bonus, 100 Punkte sind ohne sie erreichbar. Echte Bekanntheit lässt sich nicht kaufen. Sie entsteht, wenn andere unabhängig über dich schreiben, dich bewerten und empfehlen.
Wie lange dauert es, bis Google meine Firma als Entität erkennt?
Für lokale Betriebe mit dem bestätigten Unternehmensprofil, das Profil ist der Eintrag. Für ein Knowledge Panel als Marke oder Person können es viele Monate sein, im dokumentierten Fall von Danny Goodwin 4 Monate bis zur Kennung und 12 Monate bis zum vollständigen Panel.
Fazit
Entitäten sind kein Hype. Google denkt seit 2012 in Dingen statt in Wörtern, und der KI-Modus greift auf den Knowledge Graph zu. Die Frage, die der EA-Wert stellt, ist also die richtige: Weiß eine Maschine, wer du bist? Version 1 hat darauf vor allem mit dem Markup der eigenen Startseite geantwortet und dabei die Knowledge-Graph-Einträge von OTTO und Zalando übersehen. Version 2 fragt jetzt das Richtige: Bestätigen andere, wer du bist? Dass Levent Elci das innerhalb eines Tages umgebaut und alle Gewichte offengelegt hat, rechne ich ihm hoch an.
Was der Wert in keiner Version leistet: vorhersagen, welche lokalen Betriebe KIs empfehlen. Da entscheiden Unternehmensprofil, Bewertungen, Lage und das, was auf der Website und bei anderen über dich steht. Was wirklich hilft, ist weniger spektakulär als ein Score: erreichbar sein, deinen Namen überall gleich schreiben, Unternehmensprofile pflegen, ein sauberes Schema einmal richtig einbauen und dann dafür sorgen, dass andere über dich schreiben. Den Rechner und den Entitäts-Check oben kannst du für deine eigene Seite nutzen. Wenn sich am EA-Wert weiter etwas ändert, trage ich das hier nach.
Quellen
- Eigene Messungen mit dem EA-Wert am 01.10.2026 (15:56 bis 16:06 Uhr) und 02.10.2026 (07:59 und 08:50 Uhr), eigener Nachbau der Website-Signale und Test mit 90 Betrieben aus Google Maps am 02.10.2026, Wikidata-Abgleich der 44 im GEO-Test genannten Betriebe am 02.10.2026, Auswertung einer Common-Crawl-Datei (CC-MAIN-2026-39) am 01.10.2026.
- Answer the Web, EA-Wert, Methode und Entity Authority Boost, abgerufen am 01. und 02.10.2026: answertheweb.com/ea-wert
- Levent Elci auf LinkedIn, Start des EA-Werts am 01.10.2026: linkedin.com/
posts/ , Karussell „Entity Authority: Warum KI-Systeme dich zitieren“ vom 11.09.2026: linkedin.com/levent-elci-solutions_liebe-seo-und-geo-familie posts/ , weitere Beiträge vom 21.09. und 01.10.2026 auf seinem Profillevent-elci-solutions_entity-authority-warum-ki-systeme-dich-zitieren - Google Search Central, „Optimizing your website for generative AI features on Google Search“, veröffentlicht 15.05.2026, Stand 10.07.2026: developers.google.com/
search/ docs/ fundamentals/ ai-optimization-guide - Google Search Central, „AI features and your website“: developers.google.com/
search/ docs/ appearance/ ai-features - Google Search Central, Organization-Markup, Stand 08.09.2026: developers.google.com/
search/ , und Website-Namen: developers.google.com/docs/ appearance/ structured-data/ organization search/ docs/ appearance/ site-names - Google Search Central, Hinweise zu SEO-Tools von Drittanbietern, 05.06.2026: developers.google.com/
search/ docs/ fundamentals/ third-party-seo - Amit Singhal, „Introducing the Knowledge Graph: things, not strings“, Google, 16.05.2012: blog.google/
products/ ; Robby Stein, „Expanding AI Overviews and introducing AI Mode“, Google, 05.03.2025: blog.google/search/ introducing-knowledge-graph-things-not products-and-platforms/ products/ search/ ai-mode-search - Google Knowledge Panel Hilfe, „How Google's Knowledge Graph works“: support.google.com/
knowledgepanel/ ; Knowledge Graph Search API: developers.google.com/answer/ 9787176 knowledge-graph - Krishna Madhavan, „Optimizing Your Content for Inclusion in AI Search Answers“, Microsoft, 08.10.2025: about.ads.microsoft.com; Bing Search Blog, „Evolving role of the index“, Mai 2026: blogs.bing.com
- John Mueller auf Reddit r/TechSEO, 01.01.2026: reddit.com/
r/ ; zu llms.txt: Roger Montti, Search Engine Journal, 17.04.2025: searchenginejournal.comTechSEO/ comments/ 1q0mtzh - Louise Linehan, „An Analysis of AI Overview Brand Visibility Factors (75K Brands Studied)“, Ahrefs, 26.05.2025: ahrefs.com/
blog/ , und Folgestudie vom 12.12.2025: ahrefs.com/ai-overview-brand-correlation blog/ ai-brand-visibility-correlations - Louise Linehan, Xibeijia Guan, „We Tracked 1,885 Pages Adding Schema. AI Citations Barely Moved.“, Ahrefs, 11.05.2026: ahrefs.com/
blog/ schema-ai-citations - Mark Williams-Cook, „Schema, LLMs and the Low Bar for "Evidence" in GEO“, 28.05.2026: markwilliamscook.substack.com
- searchVIU, „Schema Markup and AI in 2025: What ChatGPT, Claude, Perplexity & Gemini Really See“, 02.12.2025: searchviu.com
- Daniel Cheung, „Should you bother with schema markup for AI search?“, 06.07.2026: danielkcheung.com
- Stefan Baack, „Training Data for the Price of a Sandwich“, Mozilla Foundation, 06.02.2024: foundation.mozilla.org
- Chen, Wang, Chen, Koudas (University of Toronto), „Generative Engine Optimization: How to Dominate AI Search“, arXiv, 10.09.2025: arxiv.org/abs/2509.08919
- Muck Rack, „Generative Pulse“, Pressemitteilung vom 07.05.2026: globenewswire.com
- Profound, „AI Platform Citation Patterns“, 2025: tryprofound.com/
blog/ , und „ChatGPT's entity update“, 03.11.2025: tryprofound.com/ai-platform-citation-patterns blog/ ; Christian Kunz, SEO Südwest, 06.11.2025: seo-suedwest.dechatgpt-entity-update - Sistrix, Top-Quellen im AI Mode Deutschland, 27.10.2025: sistrix.de
- Rand Fishkin, Studie zur Konsistenz von KI-Empfehlungen, SparkToro, 28.01.2026: sparktoro.com
- Kalicube, „Entity Home“ und „Domain Authority“: kalicube.com/
entity/ , kalicube.com/entity-home entity/ ; Koray Tuğberk Gübür, „Topical Authority“: holisticseo.digitaldomain-authority - Wikidata, Notability und Self-promotion: wikidata.org/
wiki/ , wikidata.org/Wikidata:Notability wiki/ ; Artur Ferreira, „Wikidata Deletion in 14 Hours“, The GEO Lab, 24.06.2026: thegeolab.netWikidata:Self-promotion - Wikipedia, Relevanzkriterien für Wirtschaftsunternehmen: de.wikipedia.org/
wiki/ Wikipedia:Relevanzkriterien - Jason Barnard, „The entity SEO fix that separated two Danny Goodwins“, Search Engine Land, 29.07.2025: searchengineland.com; Studie zu gemeinsamen Erwähnungen, Search Engine Land, 11.06.2026: searchengineland.com
- Reddit r/TechSEO, Langzeitmessung einer neuen Entität über 99 Tage, 19.08.2026: reddit.com/
r/ , gelesen über das Archiv Arctic ShiftTechSEO/ comments/ 1vsr0ge - Kai Spriestersbach, „Die llms.txt ist tot“, 11.02.2026: afaik.de; Search Engine Journal zur Studie von SE Ranking mit 300.000 Domains, 20.11.2025: searchenginejournal.com
- Lily Ray, „A Reflection on SEO, GEO & AI Search in 2025“, 19.01.2026: lilyraynyc.substack.com
Geschrieben von
Mario WormuthSEO, GEO und KI-Automatisierung für Online-Shops. Ich teste, worüber ich schreibe, zuerst auf eigenen Seiten und in Kundenprojekten wie RYMHART und Opal-Schmiede.
Das für deinen Shop umsetzen?
Drei Fragen, sofort eine Einschätzung, danach drei konkrete Punkte von mir persönlich. Kostenlos.
Weitere Artikel
aus dem Magazin.
Alle Artikel
Google Ads vs. Meta Ads vs. ChatGPT Ads: Vergleich 2026
Am 2. Oktober 2026 hat Romano Koch von der Agentur THRE3 auf LinkedIn eine Frage beantwortet, die gerade fast jeder stellt, der Werbung schaltet: Wie schlägt sich ChatGPT Ads gegen Google Ads? Gemeinsam mit dem …
Was ist GEO? KI-Sichtbarkeit erklärt, mit echten Beispielen
Ich habe sechs KI-Diensten dieselben 24 Fragen gestellt: nach Opalen und Edelsteinen, nach einem Dachdecker in Stade, einer Autoaufbereitung, einer ehrlichen Werkstatt in Hamburg und guten Gartenmöbeln. Heraus …
ChatGPT Maps im Test: Woher die Daten wirklich kommen
Wer ChatGPT nach einer guten Pizzeria in Hannover fragt, bekommt seit diesem Sommer mehr als eine Liste. Im Bereich „Karten“ unter chatgpt.com/maps erscheinen die Empfehlungen als Punkte auf einer Karte, jeder mit …